 AIREITER
Gemini 3.5 Flash produce 2,6 volte più token in output al secondo rispetto a Gemini 3.1 Pro, costa il 25% in meno per token e supera di poco Pro nell'Intelligence Index di Artificial Analysis (50 contro 46). Gemini 3.1 Pro conserva però un vantaggio di 5 punti su ARC-AGI-2 (77,1% contro 72,1%), mentre nei test di recupero su contesti lunghi Flash scende dall'84,9% al 77,3% oltre i 128k token. La scelta dipende quindi dal lavoro da svolgere: Flash punta su throughput e latenza nelle chiamate agli strumenti, Pro sulla profondità del ragionamento multi-step. I benchmark aggregati comprimono queste due priorità in un solo punteggio, nascondendo quale delle due serva davvero al vostro carico di lavoro.
Benchmark a confronto: dove vince davvero ciascun modello
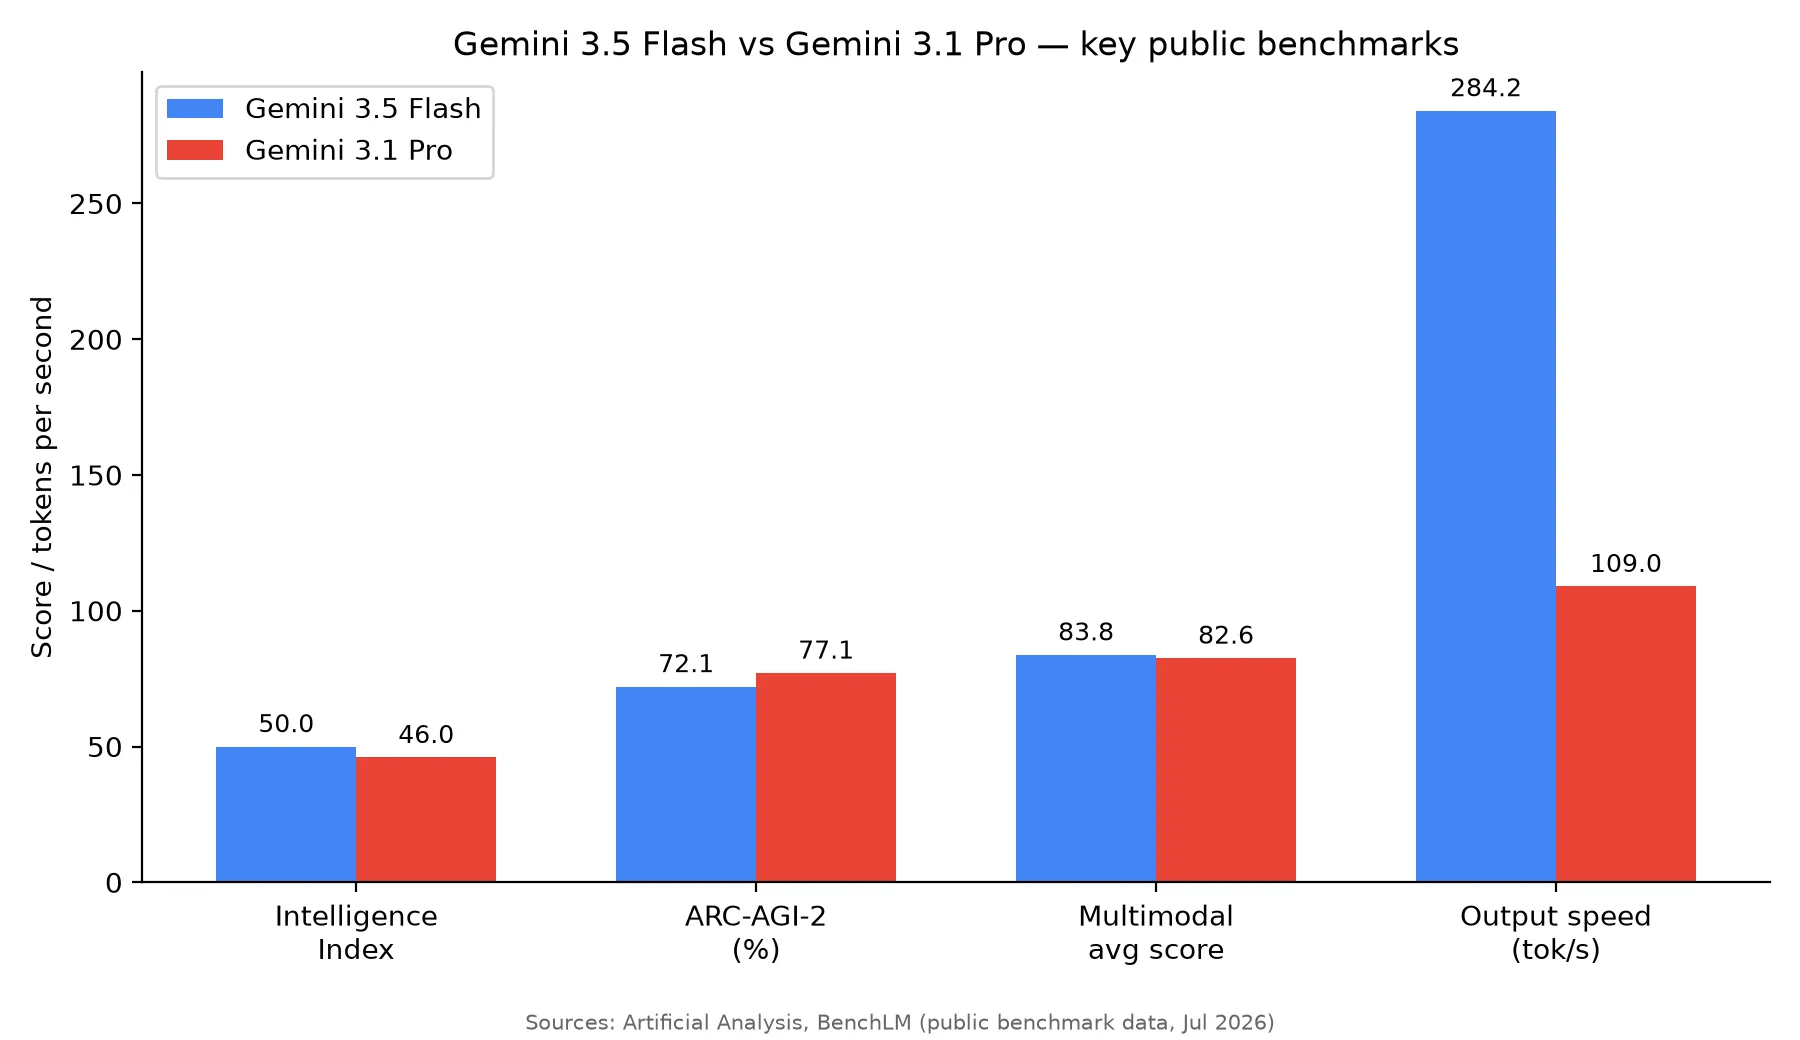
| Metrica | Gemini 3.5 Flash | Gemini 3.1 Pro | Vincitore |
|---|---|---|---|
| Intelligence Index (Artificial Analysis) | 50 | 46 | Flash |
| ARC-AGI-2, ragionamento astratto (BenchLM) | 72,1% | 77,1% | Pro |
| MRCR v2 con contesto da 128k (nxcode) | 77,3% (in calo dall'84,9% con contesti più brevi) | non riportato pubblicamente alla stessa lunghezza | Dati insufficienti |
| Punteggio medio multimodale (BenchLM) | 83,8 | 82,6 | Flash |
| Velocità di output (BenchLM) | 284,2 tok/s | 109 tok/s | Flash (2,6x) |
| GDPval-AA Elo, task agentici reali (apiyi) | 1656 | 1314 | Flash |
Flash prevale nelle metriche che misurano throughput e gestione di task generalisti. Pro vanta invece un vantaggio netto e documentato nella profondità di ragionamento su ARC-AGI-2. Nel recupero su contesti lunghi, Flash mostra una regressione documentata oltre i 128k token, ma non esiste un risultato pubblico equivalente di Pro: è quindi più corretto considerare il confronto inconclusivo, non una vittoria di Pro. Questa distinzione rispecchia direttamente il tipo di task eseguito ed è più utile del singolo valore aggregato dell'Intelligence Index.
Va aggiunta una nota metodologica tratta dal confronto di BenchLM: dei circa 34 benchmark per cui entrambi i modelli hanno risultati pubblicati, solo 3 categorie sono comparabili direttamente. Pro ha risultati esclusivi in 14 benchmark, Flash in 17, e le impostazioni del thinking budget non sono sempre allineate tra i due. La tabella va quindi letta come indicazione affidabile della direzione generale: gli scarti su ARC-AGI-2 e MRCR v2 sono abbastanza ampi da essere significativi, mentre 1-2 punti di differenza su una metrica condivisa non vanno interpretati come decisivi.
I punti in cui Flash perde terreno
Il divario di 5 punti su ARC-AGI-2 è la maggiore differenza in una singola categoria rilevata dal confronto BenchLM. ARC-AGI-2 è progettato proprio per resistere alle scorciatoie basate sul riconoscimento di pattern: per questo, uno scarto di 5 punti qui segnala la profondità di ragionamento in modo più convincente di un divario analogo su benchmark più convenzionali. Il dato MRCR v2 di nxcode fornisce un secondo indizio nella stessa direzione: l'accuratezza di recupero di Flash passa dall'84,9% al 77,3% quando il contesto si avvicina a 128k token. Il punteggio di Pro alla stessa lunghezza non è pubblico, quindi non si tratta di una sconfitta diretta documentata per Pro; è però una regressione documentata per Flash che la tabella dei benchmark di Pro non evidenzia.
Nota aneddotica, non una prova da benchmark: in un thread Reddit su r/GeminiAI che chiedeva quale modello gli utenti preferissero per i task difficili, alcuni commentatori hanno descritto Flash come superiore a Pro "in tutto tranne che nel contesto lungo e nel ragionamento astratto". Si tratta di poche opinioni, non di dati, ma coincidono con le due eccezioni emerse nei benchmark. È un controllo di coerenza appena utile, non una dimostrazione autonoma.
Prezzi e cache: quanto costa davvero usarli
I prezzi base riducono il vantaggio economico più di quanto possa sembrare a prima vista:
- Gemini 3.5 Flash: $1.50 / milione di token in input, $9 / milione di token in output
- Gemini 3.1 Pro: $2 / milione di token in input, $12 / milione di token in output
Sulla carta parliamo quindi di uno sconto del 25%, non del divario da 4-8x che Flash aveva in passato rispetto ai vecchi modelli Pro. La leva più importante è invece la cache:
- Le scritture in cache di Flash sono gratuite; l'input memorizzato in cache costa $0.15/milione di token
- Le scritture in cache di Pro costano $0.38/milione di token; l'input memorizzato in cache costa $0.50/milione di token, oltre 3 volte la tariffa di Flash
In qualunque workflow che invii nuovamente lo stesso system prompt o lo stesso contesto documentale su più turni — agenti conversazionali, assistenti di coding con contesto persistente della codebase, bot di supporto multi-turno — questo divario nella cache si accumula rapidamente. Su una singola richiesta la differenza è modesta; in una sessione agentica di mille turni non lo è affatto.
Inoltre, lo scarto non resta costante. L'analisi dei prezzi di apiyi osserva che oltre circa 200k token di contesto, la differenza di costo tra i due modelli si comprime al 25-50%, perché a quella scala l'economia per token dei due modelli converge. Se il vostro workload è dominato da documenti molto lunghi elaborati in una singola chiamata, anziché da chiamate brevi e ripetute, l'argomento economico a favore di Flash si indebolisce.
Un esempio concreto: un bot di supporto che invia ogni giorno 1M di token in input memorizzato in cache e genera 500K token in output. Con Flash, il costo è $0 per la scrittura in cache più $0.15 x 1 (input in cache) + $9 x 0.5 (output) = $4.65/giorno. Con Pro, lo stesso workload costa $0.38 (scrittura in cache, una tantum) + $0.50 x 1 (input in cache) + $12 x 0.5 (output) = circa $6.88/giorno il primo giorno, per poi stabilizzarsi a $6.50/giorno dopo la prima scrittura. Su un mese, la differenza è tra circa $140 e $195, prima ancora di considerare il ragionamento più profondo di Pro nelle richieste che ne hanno realmente bisogno.
Loop agentici: Flash vince in velocità, non sempre in affidabilità
Il benchmark sui loop agentici di nxcode ha eseguito un loop di 8 passaggi: Flash ha completato l'intera sequenza in circa 25 secondi, contro i 100 secondi di Pro. È una differenza di 4x che cresce a ogni passaggio aggiuntivo. Su GDPval-AA, benchmark dedicato a task agentici di knowledge work nel mondo reale, il punteggio Elo di Flash (1656) supera quello di Pro (1314) di 342 punti: il divario più ampio dell'intera tabella dei benchmark.
C'è però una condizione: il vantaggio in velocità e punteggio presuppone che il loop agentico proceda senza intoppi. Gli stessi scarti su ARC-AGI-2 e MRCR v2 osservati nei task di ragionamento e contesto lungo sono una base ragionevole per aspettarsi che Flash sia meno tollerante anche quando una chiamata a uno strumento restituisce un risultato inatteso a metà loop e l'agente deve ripianificare. È un'inferenza dai dati sulla profondità di ragionamento appena citati, non un'affermazione validata da benchmark separati. Se l'agente opera sotto supervisione, con una persona che controlla l'output tra i passaggi, la velocità di Flash è quasi un vantaggio gratuito. Se invece lavora senza supervisione per molti step e senza un umano nel loop, il margine di ragionamento di Pro è la scelta più prudente, almeno finché non verranno pubblicati dati sui tassi di errore per entrambi.
Quale scegliere: matrice decisionale per tipo di task
| Tipo di task | Modello consigliato | Perché |
|---|---|---|
| Coding quotidiano (test, review di PR, traduzione tra linguaggi) | Flash | Vince su velocità e costo; la profondità di ragionamento non è il collo di bottiglia |
| Refactoring profondi, progettazione di algoritmi nuovi | Pro | Il divario su ARC-AGI-2 emerge direttamente nel ragionamento logico multi-step |
| Recupero da documenti lunghi (contratti, corpus di ricerca oltre 128k token) | Pro | Flash ha una regressione MRCR v2 documentata a questa lunghezza; il valore di Pro non è pubblicato, ma la scelta più prudente è il modello senza un punto debole noto |
| Generazione batch ad alto volume | Flash | Le scritture in cache gratuite e un throughput 2,6x contano di più su larga scala |
| Workflow agentici supervisionati, con controllo umano dell'output | Flash | Vantaggio di velocità senza il rischio di affidabilità dei flussi non supervisionati |
| Catene agentiche ad alto rischio e senza supervisione | Pro | Il margine nella profondità di ragionamento è la scommessa più sicura quando nessun umano intercetta gli errori a metà loop |
| Chiamate multi-turno frequenti che riutilizzano lo stesso contesto | Flash | Il prezzo dell'input in cache è circa un terzo di quello di Pro |
Una regola pratica copre gran parte della matrice: inviate le richieste a Flash, a meno che non ricorra una di tre condizioni — il contesto supera i 128k token e l'accuratezza del recupero è importante; il task richiede ragionamento astratto o multi-step, come algoritmi nuovi o sintesi legale e di ricerca; oppure l'agente opera senza supervisione per più di una manciata di passaggi. Basta una di queste condizioni per orientare la chiamata verso Pro. Se non è presente nessuna delle tre, la velocità di Flash e il prezzo della cache lo rendono l'opzione predefinita meno costosa.
FAQ
Gemini 3.5 Flash è migliore di 3.1 Pro?
Sì, per velocità, costo e benchmark generalisti. Nel ragionamento astratto, misurato da ARC-AGI-2, Gemini 3.1 Pro mantiene un vantaggio di 5 punti. Nel recupero da contesti oltre 128k token, Flash ha una regressione documentata e il punteggio equivalente di Pro non è stato pubblicato: il confronto resta quindi aperto, non è una vittoria confermata di Pro. Quale sia il modello "migliore" dipende dalla categoria in cui rientra il vostro task.
Quanto costa meno Gemini 3.5 Flash rispetto a 3.1 Pro?
Circa il 25% in meno sui prezzi base di input e output ($1.50/$9 contro $2/$12 per milione di token). Il risparmio maggiore emerge però con la cache: le scritture in cache di Flash sono gratuite e l'input memorizzato costa circa un terzo rispetto a Pro, un fattore particolarmente rilevante nei workload multi-turno o ad alto volume.
Gemini 3.5 Flash è adatto al coding?
Sì, per il lavoro quotidiano: generazione di test, review di PR e traduzione del codice tra linguaggi. Per refactoring profondi o progettazione di algoritmi originali, il vantaggio di Pro nei benchmark sul ragionamento astratto tende a riflettersi nella qualità dell'output.
Gemini 3.5 Flash gestisce bene i contesti lunghi?
Sì, con contesti più brevi: l'accuratezza di recupero MRCR v2 resta all'84,9%. Oltre i 128k token scende al 77,3%, uno scarto rilevante per task come la revisione di contratti distribuiti su più documenti. Il punteggio di Gemini 3.1 Pro alla stessa lunghezza non è stato pubblicato, quindi va considerato un limite noto di Flash, non un vantaggio confermato di Pro.
In sintesi
Gemini 3.5 Flash è l'opzione predefinita migliore per la maggior parte del lavoro quotidiano e ad alto volume: è più rapido, più economico con la cache e abbastanza vicino nei benchmark generalisti da rendere raramente rilevante il compromesso. Gemini 3.1 Pro giustifica il costo superiore nel ragionamento astratto e nelle catene agentiche non supervisionate. Sui documenti oltre 128k token, i dati di Flash mostrano un punto debole che quelli di Pro non confermano né escludono: prima di impegnarsi su uno dei due, conviene quindi testarli direttamente sul proprio caso d'uso.
Questo confronto si basa su dati di benchmark pubblici (Artificial Analysis, BenchLM, nxcode e apiyi), non su test API eseguiti in prima persona. Gemini 3.1 Pro è stato lanciato con un posizionamento incentrato sul ragionamento, distinto dal focus di Flash sulla velocità. Al momento della stesura, Gemini 3.5 Pro non è ancora stato distribuito: alcune indiscrezioni indicano un rilascio a luglio 2026. Considerate quindi questo articolo una fotografia del momento: entrambi i modelli, così come il confronto, andranno rivalutati quando arriverà la prossima versione di Pro.