 AIREITER
Eleven v3 è uscito dalla fase alpha il 2 febbraio 2026 e l'ID da usare nel codice per chiamarlo tramite API ElevenLabs è eleven_v3. Sia ElevenLabs sia fal.ai applicano un prezzo di $0,10 ogni 1.000 caratteri: il costo unitario, quindi, non basta per scegliere tra le due piattaforme. A fare la differenza sono piuttosto struttura della fatturazione, concorrenza e accesso alle voci. La versione GA ha inoltre risolto diversi problemi concreti: secondo l'annuncio della GA, gli errori con il testo strutturato sono scesi dal 15,3% al 4,9% in un benchmark su 27 categorie e 8 lingue. Restano però due limiti da mettere in conto: 5.000 caratteri per richiesta e un modello che lo stesso produttore considera ancora inadatto all'uso in tempo reale.
Cosa offre l'API ElevenLabs per Eleven v3
L'API di Eleven v3 espone quattro superfici: creazione e streaming del parlato, più endpoint separati per creare e trasmettere dialoghi con più speaker. Il modello supporta oltre 70 lingue, accetta tag audio inline per indicare emozione e modalità di recitazione e, con il passaggio alla GA, è diventato abbastanza stabile da essere preferito alla build alpha nel 72% dei test interni di ElevenLabs.
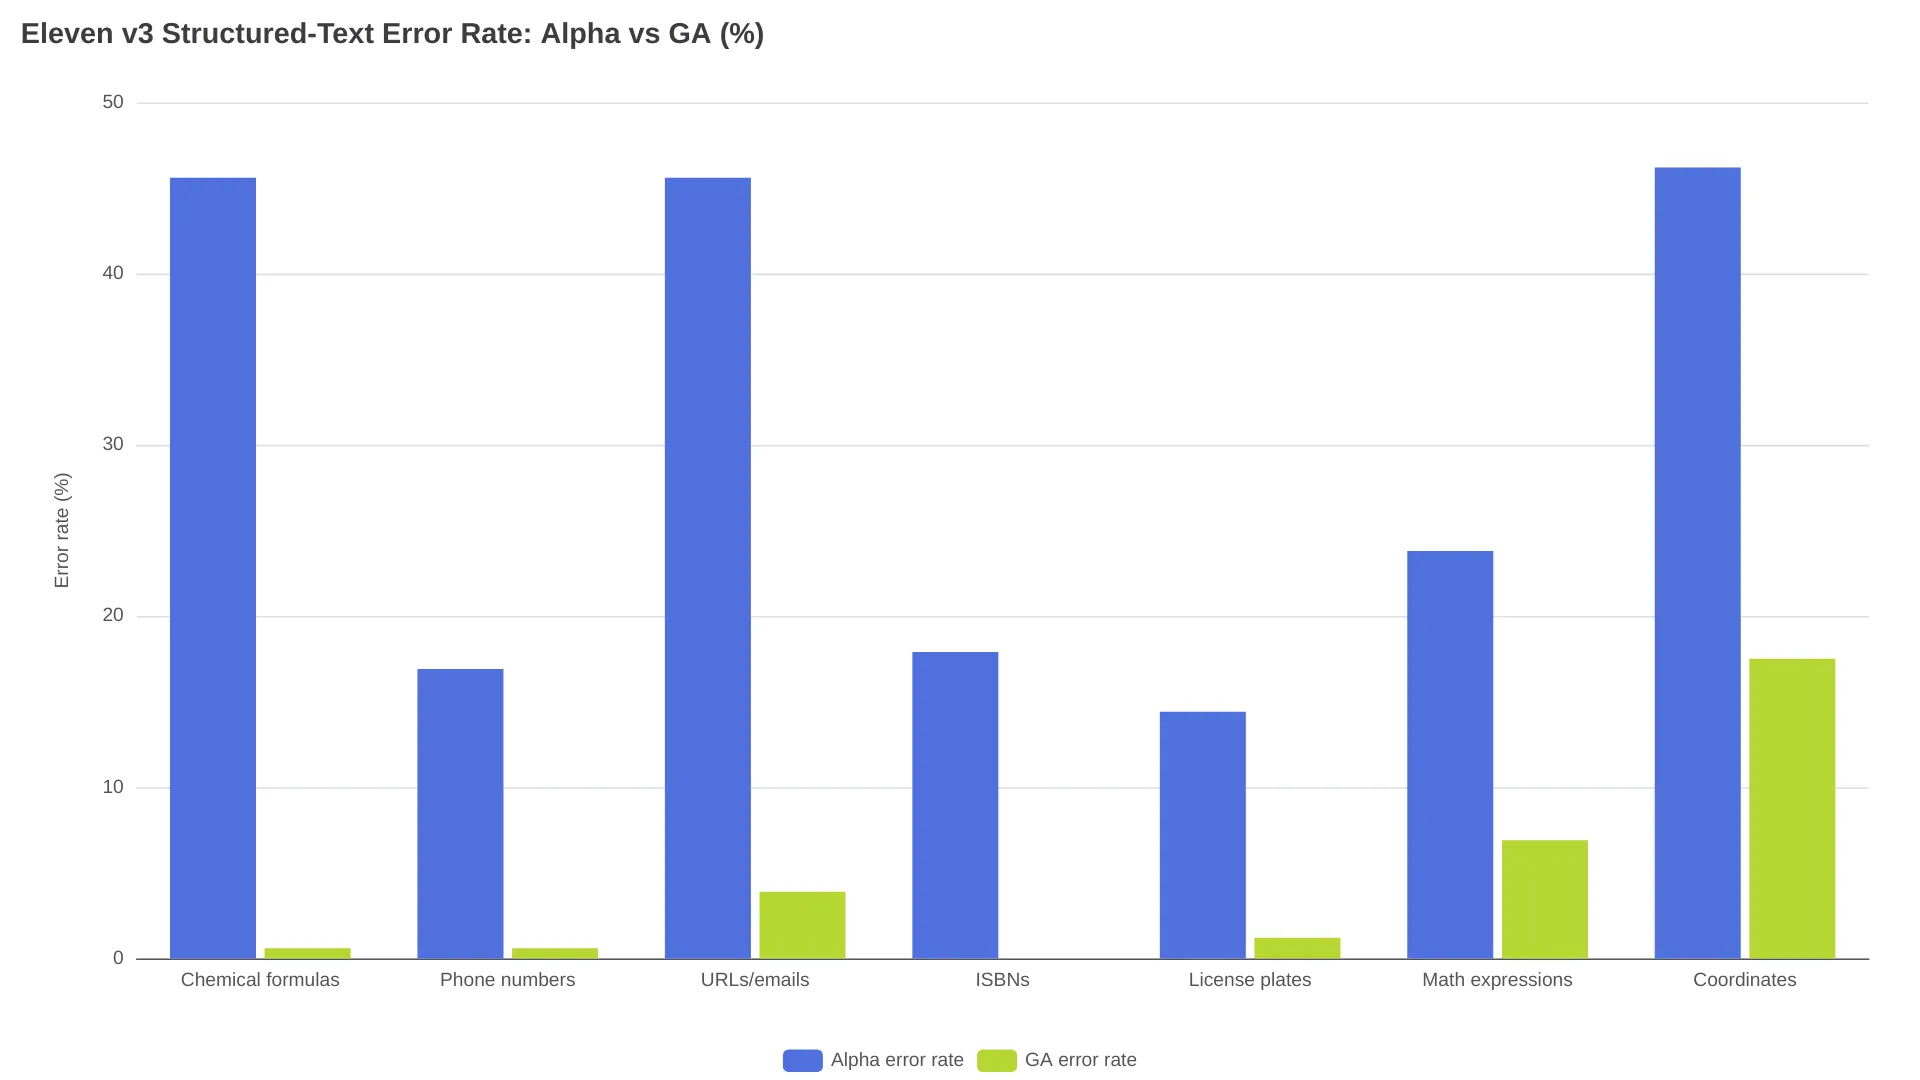
Prima di affidare a v3 testi strutturati, conviene guardare il dettaglio per categoria del benchmark. Le formule chimiche sono passate da un tasso di errore del 45,6% allo 0,6%, i numeri di telefono dal 16,9% allo 0,6% e gli ISBN sono arrivati a zero. Le coordinate geografiche restano il punto debole, con il 17,5%, mentre le espressioni matematiche si fermano al 6,9%: un risultato accettabile per una narrazione, ma rischioso per contenuti ricchi di coordinate.
Questa è la posizione di v3 rispetto agli altri modelli della famiglia, secondo la documentazione ufficiale dei modelli:
| Modello | ID modello | Max caratteri/richiesta | Latenza dichiarata | Prezzo / 1.000 caratteri | |
|---|---|---|---|---|---|
| Eleven v3 | eleven_v3 | 70+ | 5.000 (~5 min) | ~250–300 ms (in base al tier) | $0,10 |
| Eleven v3 Conversational | tramite Text-to-Dialogue WebSocket | 70+ | n/d | ~280 ms | $0,10 |
| Multilingual v2 | eleven_multilingual_v2 | 29 | 10.000 (~10 min) | ~250–300 ms | $0,10 |
| Flash v2.5 | eleven_flash_v2_5 | 32 | 40.000 (~40 min) | ~75 ms | $0,05 |
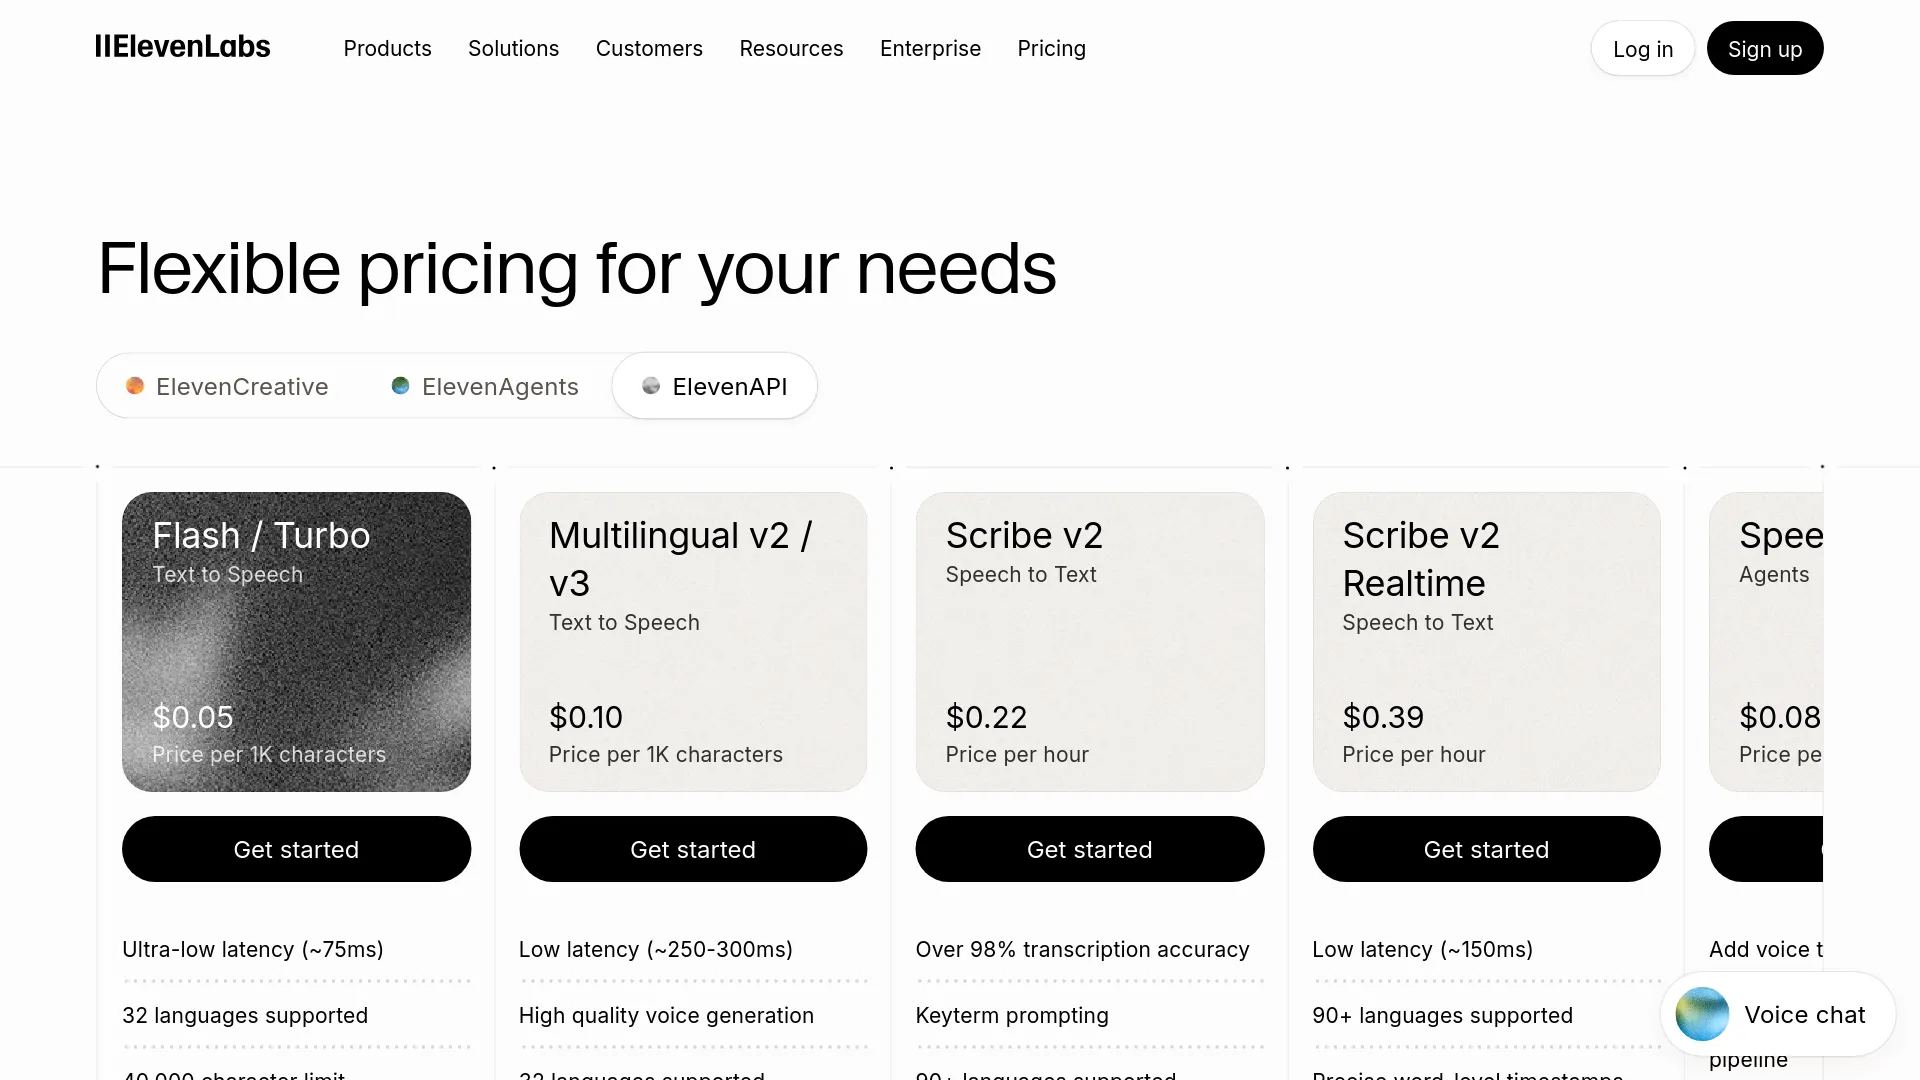
C'è una discrepanza nella documentazione da tenere presente: la pagina dei prezzi raggruppa "Multilingual v2/v3" in un tier con limite di 40.000 caratteri, mentre la documentazione dei modelli fissa a 5.000 caratteri per richiesta il limite di Eleven v3. Per v3 bisogna considerare valido il primo numero: è il dato specifico del modello. Le pipeline long-form progettate dando per scontati 40.000 caratteri andranno quindi in errore.
Prezzi: ElevenLabs ufficiale o fal.ai?
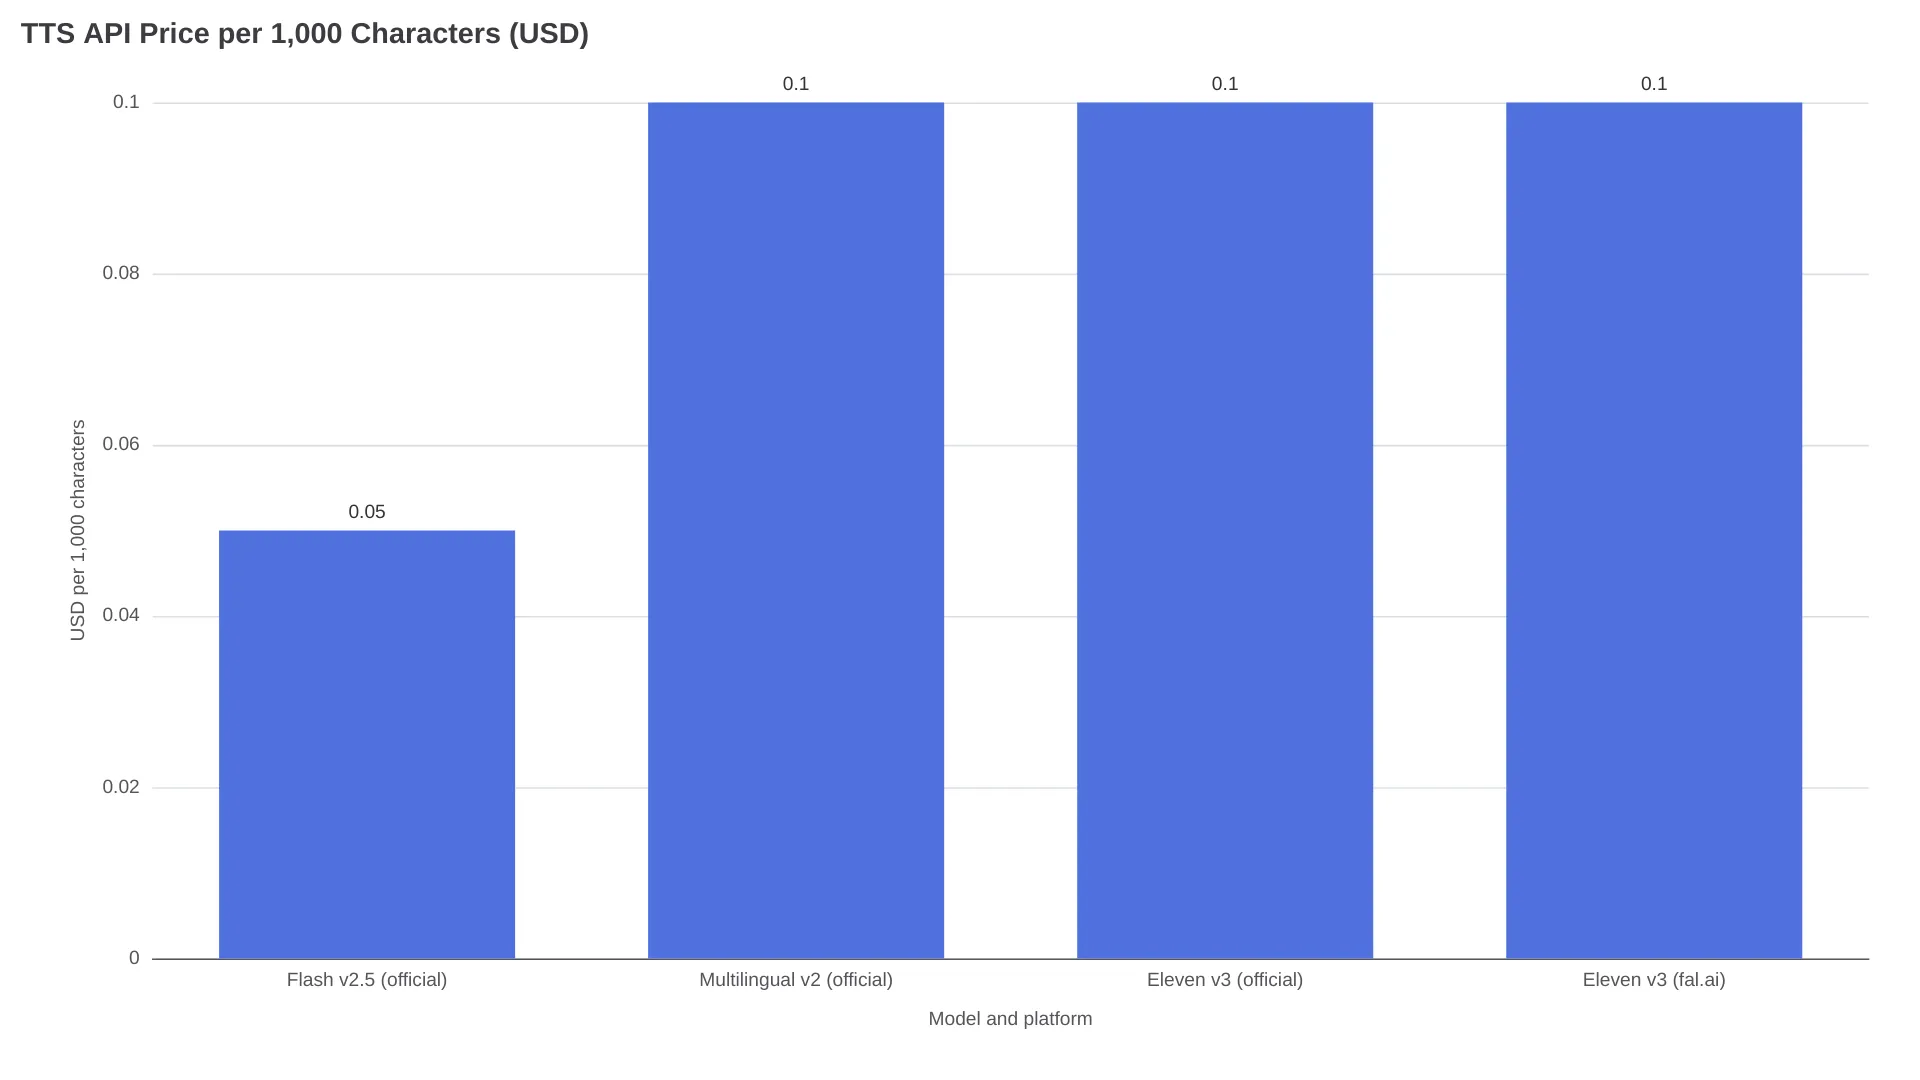
Il prezzo unitario è identico: $0,10 ogni 1.000 caratteri. All'interno della famiglia, solo Flash v2.5 costa meno, con $0,05/1k. Le differenze davvero rilevanti riguardano fatturazione e parallelismo:
| ElevenLabs ufficiale | fal.ai | |
|---|---|---|
| Prezzo unitario (Eleven v3) | $0,10 / 1k caratteri | $0,10 / 1k caratteri |
| Fatturazione | Piani in abbonamento con crediti inclusi oppure pagamento a consumo | Interamente a consumo; "nessuna licenza per postazione, nessun abbonamento, nessun minimo" |
| Piano gratuito | 10k caratteri Multilingual/mese (20k Flash) | Nessuno indicato nella pagina del modello |
| Esempio di piano | Creator $22/mese (primo mese $11), 220k caratteri Multilingual | n/d |
| Piano più alto | Business $990/mese, 9,9M caratteri Multilingual | n/d |
| Concorrenza | In base al piano: 2 richieste Multilingual contemporanee sul Free, 15–30 su Scale/Business, personalizzata su Enterprise | Coda serverless; la pagina del modello non documenta un limite per account |
| Penalità della coda | Superato il limite, le richieste entrano in coda, aggiungendo "in genere" ~50 ms | API di coda con webhook per i job batch |
| Controlli (schema documentato più segnalazioni degli utenti) | Voce tramite ID; stabilità (gli utenti segnalano 3 posizioni su v3) | Voce, stability, similarity_boost, speed, language_code, apply_text_normalization, seed, timestamps, output_format |
| Programma startup | 12 mesi gratuiti, 33M caratteri, concorrenza più alta | n/d |
Nel percorso ufficiale la concorrenza dipende dal piano: una chiave Free che invia chiamate v3 in parallelo può gestire 2 richieste contemporaneamente, un limite che rallenta parecchio i batch. fal, invece, fa passare tutti i job da una coda serverless con callback webhook, un flusso pensato proprio per questo tipo di elaborazione. Nessuna delle due documentazioni sui prezzi chiarisce se spazi bianchi o tag audio tra parentesi quadre vengano conteggiati nei caratteri fatturati: per il budget, è più prudente comportarsi come se lo fossero.
Se ti serve v3 solo ogni tanto e usi già altri modelli tramite fal, il quadro della piattaforma è approfondito nella nostra recensione di fal.ai.
Tag audio: guidare l'interpretazione direttamente nel testo
I tag audio sono istruzioni tra parentesi quadre inserite nel testo. Il modello le interpreta come indicazioni di recitazione e non le pronuncia. Ecco l'esempio minimo riportato nella pagina del modello su fal:
[slowly] Back then... [chuckles] we had no phones.
[whispers] Just dirt roads and [coughs] big dreams.
[sad] Then it happened.| Categoria | Esempi funzionanti |
|---|---|
| Emozioni | [happy], [sad], [excited], [angry], [sarcastically], [nervous], [happily] |
| Modalità di recitazione | [whispers], [shouting], [shouts], [slowly], [quickly], [softly] |
| Suoni non verbali | [laughs], [chuckles], [sighs], [gasps], [coughs], [gulps], [clears throat], [applause] |
| Accenti | [british accent], [southern accent], [strong canadian accent] |
La documentazione ufficiale sul prompting indica tre regole. Non esiste un elenco canonico di tag: sono istruzioni in linguaggio naturale e, secondo ElevenLabs, potrebbero esistere indicazioni più efficaci di quelle pubblicate, quindi conviene sperimentare invece di imparare una lista a memoria. I tag SSML per le pause non sono supportati; per gestire il ritmo bisogna usare punteggiatura, puntini di sospensione e ritorni a capo. Infine, il risultato cambia in base alla voce e al contesto. Ed è proprio qui che possono comparire i problemi:
"V3 is amazing, certainly the most human sounding" "it still feels like a Beta release to me" — u/ConcertNeat8147, entrambe le frasi nello stesso post, resoconto sul campo di v3 su r/ElevenLabs
Nello stesso thread, u/poundingCode, software engineer con vent'anni di esperienza, racconta che l'aggiunta di tag emozionali può occasionalmente cambiare del tutto l'accento dello speaker. Un account dello staff di ElevenLabs ha risposto che "sono tutti aspetti su cui stiamo lavorando".
Nello stesso thread, alcuni creator hanno riportato questi workaround (esperienza della community, non indicazioni ufficiali):
- Frase di riscaldamento. Aggiungi all'inizio una frase di servizio che imposti tono e altezza della voce, poi rimuovila in post-produzione; spesso la voce si "assesta" dopo alcuni secondi di generazione.
end.in coda. Dopo il testo inserisci un ritorno a capo e la parola "end." per ridurre i troncamenti sulle ultime parole, quindi tagliala dall'audio.- Chiudi le frasi con i puntini di sospensione. Secondo alcuni test, i troncamenti a fine parola diminuiscono quando le frasi terminano con "...".
- Imposta la stabilità al massimo. Il controllo della stabilità di v3 ha tre posizioni; quella più alta riduce gli scostamenti della voce all'inizio della generazione.
I limiti che condizionano l'integrazione
- Il limite di 5.000 caratteri è il problema principale. Una richiesta produce al massimo circa 5 minuti di audio, quindi audiobook e pipeline long-form devono suddividere il testo in blocchi. Meglio separare per frase o paragrafo, mai a metà di una proposizione, e lasciare ogni tag nel blocco a cui si riferisce. Multilingual v2 arriva a 10.000 caratteri, se preferisci effettuare meno chiamate ma più lunghe.
- Nell'API ufficiale la concorrenza dipende dal piano. Secondo la documentazione dei modelli, le chiavi Free consentono 2 richieste contemporanee del tier Multilingual (4 con Flash), Scale e Business arrivano a 15–30, mentre Enterprise negozia limiti personalizzati. Le richieste oltre il limite finiscono in coda, con un'aggiunta "in genere" di ~50 ms. La stessa pagina offre anche un parametro indicativo sulla capacità di ElevenLabs: un limite di concorrenza pari a 5 supporta circa 100 trasmissioni audio simultanee in uno scenario conversazionale. La penalità per singola chiamata è contenuta, ma su larga scala può diventare pesante se si configura una capacità insufficiente.
- fal non documenta alcun limite massimo di input. La pagina di Eleven v3 indica endpoint, parametri e formati, ma non specifica dimensione massima dell'input, durata della conservazione in coda o comportamento in caso di retry. Nulla impedisce di inviare testi lunghi; nulla lo garantisce.
- I timestamp variano tra le piattaforme. Lo schema di input di fal include un booleano
timestampsche restituisce dati di allineamento per parola, utili per sottotitoli e lip-sync. Nell'API ufficiale, l'output dei dialoghi v3 arriva senza timestamp, una lacuna segnalata pubblicamente dagli sviluppatori (r/ElevenLabs: "v3 API, no timestamps?"); oggi il parametro di fal è la strada documentata per ottenere i dati di allineamento.
- Il tempo reale resta escluso. ElevenLabs considera v3 inadatto all'uso in tempo reale e alle conversazioni per via della latenza più alta e della consistenza variabile. Le alternative indicate sono Flash v2.5, con ~75 ms per gli agenti, oppure Eleven v3 Conversational, con ~280 ms via WebSocket quando l'espressività è fondamentale in un contesto interattivo. Una variante v3 in tempo reale è nella roadmap ("stiamo lavorando a una versione real-time"), ma non era ancora stata rilasciata al momento dell'annuncio della GA.
- Uso commerciale. Durante l'alpha gli sviluppatori chiedevano pubblicamente se l'output di v3 potesse essere usato commercialmente; l'annuncio della GA ha aperto il modello su tutte le piattaforme e fal indica esplicitamente il proprio endpoint per l'uso commerciale.
La prima richiesta: SDK ufficiale e client fal
Il percorso ufficiale, riportato testualmente dal quickstart:
pip install elevenlabsfrom elevenlabs import ElevenLabs
client = ElevenLabs(api_key="YOUR_ELEVENLABS_API_KEY") # or ELEVENLABS_API_KEY env var
audio = client.text_to_speech.convert(
voice_id="JBFqnCBsd6RMkjVDRZzb", # "George"
text="[whispers] The first move is what sets everything in motion.",
model_id="eleven_v3",
output_format="mp3_44100_128",
)Con fal si usa fal-client sull'endpoint fal.run:
pip install fal-clientimport fal_client
result = fal_client.subscribe(
"fal-ai/elevenlabs/tts/eleven-v3",
arguments={
"text": "[whispers] The first move is what sets everything in motion.",
"voice": "Rachel", # default voice
"stability": 0.5, # 0–1, lower = more expressive variation
"timestamps": True, # per-word alignment data
},
)
print(result["audio"]["url"]) # hosted MP3 URLEntrambe le piattaforme avvertono esplicitamente di non inserire le chiavi API nel codice eseguito lato client: le richieste vanno quindi inoltrate tramite il proprio server. Per lo streaming, l'API ufficiale offre un endpoint stream-speech, mentre fal mette a disposizione fal.stream e un'API di coda con webhook per i job batch.
Quale endpoint scegliere?
| La tua situazione | Endpoint da usare |
|---|---|
| Ti servono voci clonate (PVC/IVC) o voci progettate, identificate tramite ID | Ufficiale: le voci personalizzate sono richiamate tramite ID nel workspace; la pagina di fal documenta solo nomi di voci preimpostate |
| Paghi già un piano ElevenLabs con crediti inclusi | Ufficiale: i caratteri inclusi sono già pagati, mentre ogni chiamata a fal genera una nuova spesa |
| Job batch per audiobook o doppiaggio, senza abbonamento e con webhook al completamento | fal: la coda a consumo e il flusso con webhook sono pensati esattamente per questo caso |
| Una sola chiave API per modelli di immagini, video e TTS nello stesso stack | fal: v3 usa lo stesso client degli altri modelli fal |
| Agenti vocali o qualsiasi scenario vincolato dalla latenza | Nessuno dei due endpoint TTS di v3: usa Flash v2.5 (~75 ms) oppure Eleven v3 Conversational (~280 ms) |
| Esigenze Enterprise (SOC 2, HIPAA BAA, limiti di velocità personalizzati, IP allowlisting) | Ufficiale: queste funzioni del piano Enterprise sono documentate nella pagina dei prezzi; la pagina del modello fal non specifica quali certificazioni coprano il suo endpoint |
FAQ
Qual è l'ID del modello Eleven v3?
eleven_v3, passato come model_id agli endpoint standard text-to-speech. I dialoghi con più speaker usano gli endpoint Text-to-Dialogue separati, non un parametro del modello.
L'API di Eleven v3 supporta lo streaming?
Sì. L'API ufficiale offre un endpoint stream-speech che restituisce l'audio durante la generazione e fal espone fal.stream per lo stesso modello. Lo streaming non rende v3 adatto al tempo reale: le indicazioni ufficiali continuano ad assegnare l'uso conversazionale a Flash v2.5 o a Eleven v3 Conversational.
Qual è il limite di caratteri di Eleven v3?
5.000 caratteri per richiesta, pari a circa 5 minuti di audio, secondo la documentazione ufficiale dei modelli. Il valore di 40.000 caratteri riportato nella pagina dei prezzi riguarda il raggruppamento del tier Multilingual, non v3 nello specifico.
Quanto costa l'API di Eleven v3?
$0,10 ogni 1.000 caratteri su entrambe le piattaforme: $1,00 per una storia da 10.000 caratteri e $100 per un audiobook da 1 milione di caratteri. I crediti dei piani riducono il costo effettivo su ElevenLabs: il piano Creator da $22/mese include 220k caratteri Multilingual; fal non prevede abbonamenti.
Posso usare voci clonate con Eleven v3?
Sull'API ufficiale sì: le voci professionali, clonate e progettate vengono richiamate tramite voice ID. Nella pratica la compatibilità varia; gli utenti di r/ElevenLabs segnalano che alcune Professional Voice Clones esistenti sembrano appartenere a speaker diversi con v3, mentre le PVC i cui creatori indicano la compatibilità con V3 tendono a funzionare meglio. Lo schema di fal accetta un nome o un ID voce, ma documenta soltanto voci preimpostate: gli ID privati di ElevenLabs restano quindi un territorio non documentato.
Eleven v3 è adatto agli agenti vocali in tempo reale?
No. ElevenLabs indica esplicitamente come inadatti a v3 gli usi in tempo reale e conversazionali, a causa della latenza più alta e della consistenza variabile. Le alternative sono Flash v2.5 (~75 ms, 32 lingue) oppure Eleven v3 Conversational (~280 ms, oltre 70 lingue, controllo tramite tag audio).
Perché Eleven v3 suona diversamente tramite API rispetto al sito?
Le anteprime delle voci non rappresentano necessariamente il risultato ottenuto con il proprio testo. È una lamentela ricorrente nei resoconti sul campo di r/ElevenLabs e l'output di v3 può variare sensibilmente da una generazione all'altra. Prima di scegliere una voce, testala con un vero estratto dello script e con l'impostazione di stabilità prevista in produzione.
Articoli correlati: guida all'API TTS di Qwen Audio 3 · prezzi e alternative a Replicate · recensione di fal.ai 2026