 AIREITER
145 miliardi di parametri su un laptop e 80 token al secondo: è la promessa di Edge0-145B. I pesi si possono scaricare, ma i requisiti reali parlano di un desktop NVIDIA con CUDA 13 e circa 105 GB di spazio SSD.
Questa recensione di Edge0-145B mette a confronto le dichiarazioni del lancio con il blog di presentazione, la documentazione del modello e la scheda Q3_K, oltre ai primi test della community. L’obiettivo è capire, prima di occupare oltre 100 GB sul disco, se conviene eseguirlo in locale o usare un’API.
Cosa è stato rilasciato il 12 novembre: pesi, motore e limiti
Edge0 ha pubblicato Edge0-145B ed Edge0-120B il 12 novembre 2026, con i pesi nei repository Edge0-145B-q3k e Edge0-145B-NVFP4 e il motore edge0-strata nel progetto Edge0-AI/Edge0. Edge0-145B è un modello Mixture-of-Experts latente, solo testuale, con contesto da 256K token, derivato da Qwen3.8-Flash-Next e addestrato nativamente a 4 bit. Per ogni token si attivano circa 10,12 miliardi di parametri: i 145 miliardi complessivi, quindi, non devono stare tutti nella VRAM.
Il modello comprende circa 84,6 miliardi di parametri degli esperti, una tabella PLE n-gram da 51,2 miliardi mappata direttamente dall’SSD, una draft head da 1,26 miliardi per la decodifica speculativa e uno scheletro da 6 GB. Q3_K include 40,81 GiB di pesi all’interno di un repository da 105,4 GB; NVFP4 include 47,79 GiB di pesi in 112,9 GB complessivi. Gli esperti instradati si trovano in un pacchetto personalizzato experts.bin, non in un GGUF portabile.
I 29 GB dichiarati non bastano per un download da 29 GB
Nel blog compaiono 29 GB di picco in una sezione e 28 GB in un’altra, insieme a oltre 1.100 token al secondo in prefill, oltre 80 in decode e un consumo di 120 W. La scheda Q3_K indica 23,14 GiB di VRAM più 31,28 GiB di RAM di sistema su una RTX 5090 D; per NVFP4 si sale a 23,25 più 38,27. La libreria degli esperti occupa circa 40 GB di RAM, mentre circa 48 GB di vocabolario vengono letti in streaming dall’SSD.
Gli esperti più utilizzati restano in VRAM, quelli meno attivi vengono mantenuti nella RAM e la tabella PLE da 51,2 GB viene letta dall’SSD quando serve. La memoria attiva può avvicinarsi ai 29 GB se si considera soltanto la residency, ma per archiviazione e streaming serve comunque l’intero repository.
| Cosa indica il numero | Dimensione | Dove si trova |
|---|---|---|
| Picco di memoria dichiarato nel blog | 28-29 GB | Memoria attiva, metodologia non documentata |
| Download del repository Q3_K | 105,4 GB | SSD NVMe, PLE da 51,2 GB + experts.bin da 40,1 GB |
| Download del repository NVFP4 | 112,9 GB | SSD NVMe, PLE da 51,2 GB + experts.bin da 47,6 GB |
| Memoria misurata su 5090 D con Q3_K | 23,14 GiB VRAM + 31,28 GiB RAM | VRAM + RAM di sistema durante l’inferenza |
| Memoria misurata su 5090 D con NVFP4 | 23,25 GiB VRAM + 38,27 GiB RAM | VRAM + RAM di sistema durante l’inferenza |
La configurazione necessaria per eseguire davvero Edge0-145B
Edge0-145B funziona su Linux o Windows con una GPU NVIDIA e CUDA 13, tramite edge0-infer. I file rilasciati non offrono un percorso di caricamento per llama.cpp, Ollama o LM Studio: il GGUF dello scheletro non contiene i pesi degli esperti instradati e la documentazione di Edge0 indica soltanto edge0-infer (vedi le istruzioni del repository). Di conseguenza, la procedura descritta nella guida a llama.cpp v1.0 non è applicabile. Il blog cita macOS e MacBook Pro tra le piattaforme supportate fin dal primo giorno, ma la tabella delle piattaforme elenca soltanto Linux e Windows con CUDA 13 per le versioni 145B e 120B.
La configurazione minima testata è composta da 16 GiB di VRAM e 20 GiB di RAM, con 44,9 token al secondo in agent decode su Q3_K. La dotazione consigliata è una scheda NVIDIA da 24 GB, 32 GB di RAM di sistema — 48 GB lasciano più margine —, 120 GB liberi su NVMe, CUDA 13, CMake, Ninja e uv. Per compilare e avviare il server si seguono le istruzioni del repository:
git clone https://github.com/Edge0-AI/Edge0.git edge0
hf download Edge0/Edge0-145B-q3k --local-dir ./Edge0-145B-q3k   # ~105 GB
export EDGE0_145B=$PWD/Edge0-145B-q3k
build/cpu/bin/edge0-infer serve --model "$EDGE0_145B"  # :8000
Su Windows si può scaricare l’app Edge0 Chat v0.2.0 dalle release di GitHub. Con AMD servono invece correzioni manuali: nel thread su r/LocalLLaMA, u/UghrUghr segnala circa 35 modifiche a build e runtime su una RX 7900 XTX con Windows 11, oltre all’uso di kernel fusi CUDA tramite un fallback più lento.
Q3_K o NVFP4: quale versione scaricare
Q3_K, con i suoi 105,4 GB, è la scelta predefinita e raggiunge 121,2 token al secondo in agent decode su una 5090 D, secondo la tabella di Edge0. NVFP4 occupa 112,9 GB e punta all’accelerazione Blackwell, arrivando a 98,3 sulla stessa scheda. Se non si dispone di hardware Blackwell, conviene iniziare da Q3_K.
Le prestazioni sulle schede reali
I numeri qui sotto sono quelli dichiarati da Edge0 per Q3_K, con prefill da 16K salvo diversa indicazione. Il dato dell’M2 Ultra è una misurazione Metal e non dimostra l’esistenza di una versione macOS rilasciata.
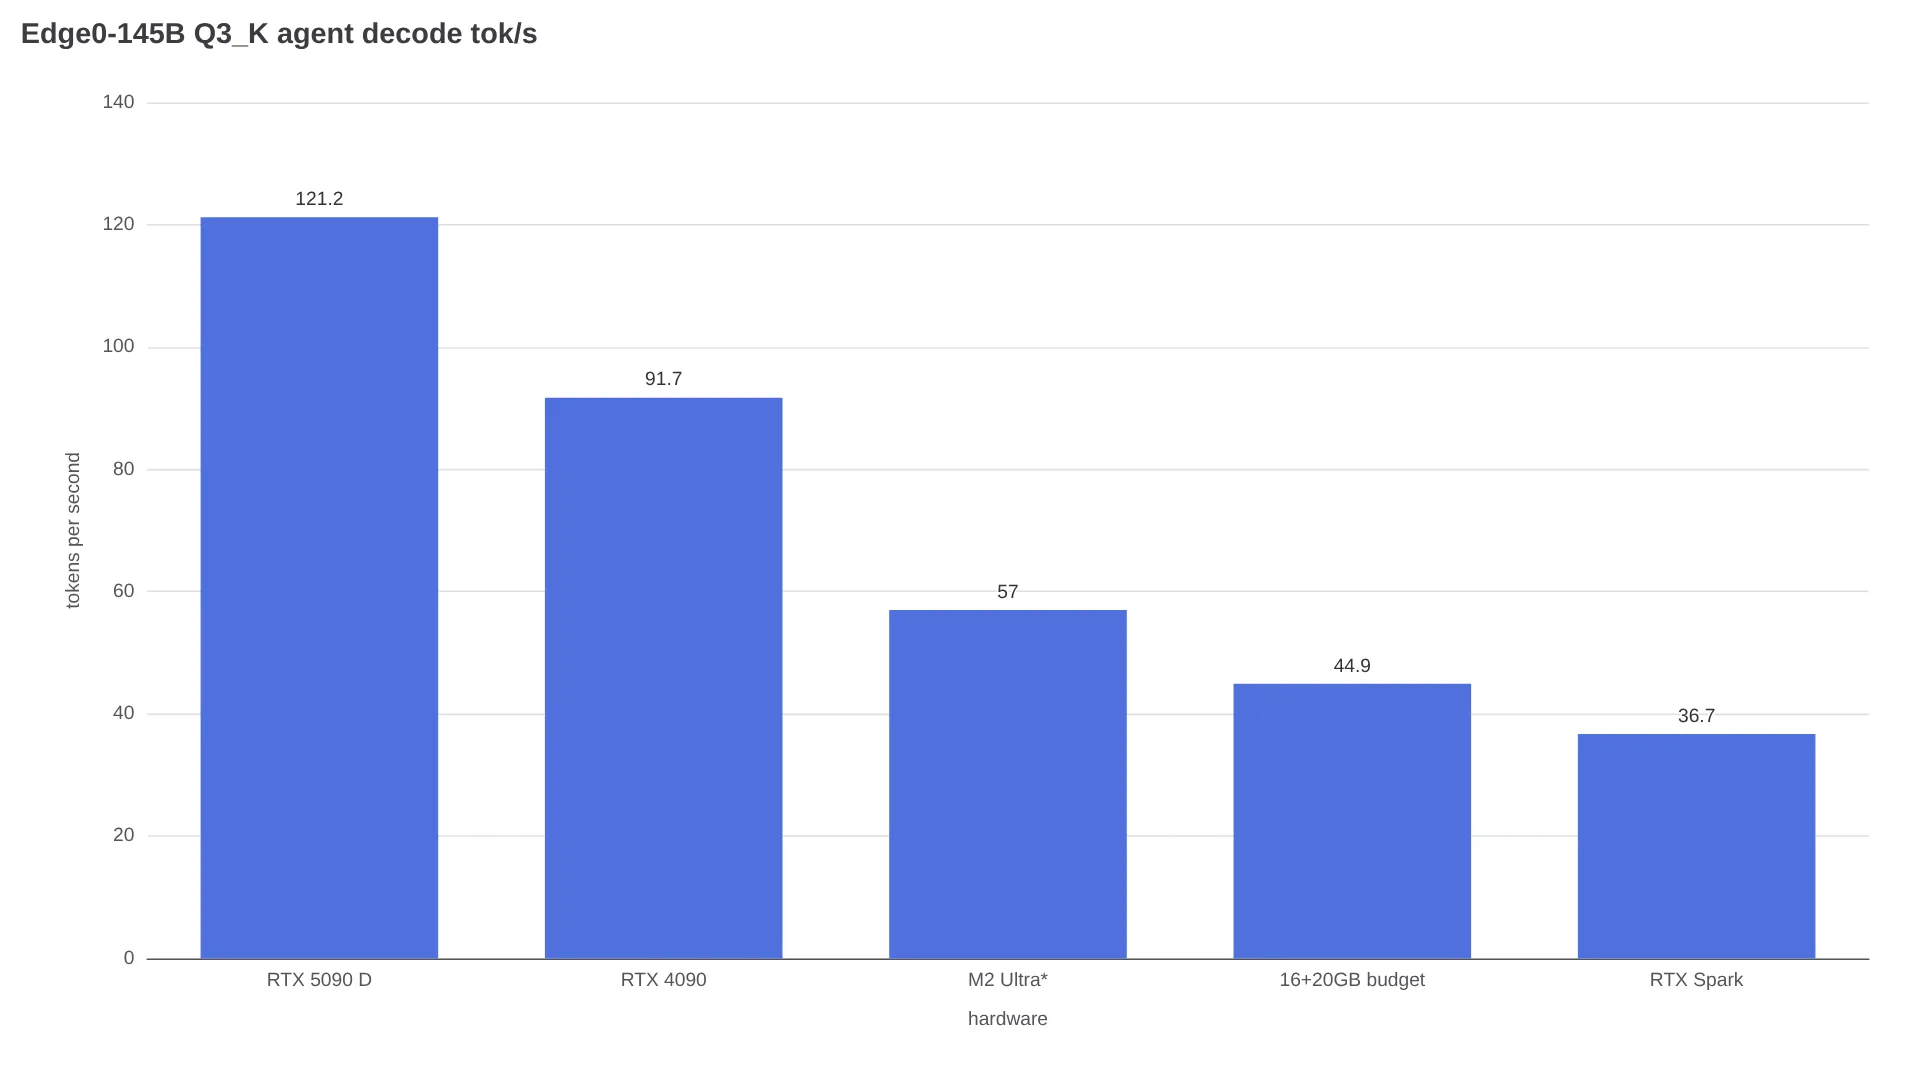
| Hardware | Chat decode | Agent decode | Prefill 16K |
|---|---|---|---|
| RTX 5090 D 24GB Q3_K | 99.7 | 121.2 | 3,554.9 |
| RTX 4090 24GB Q3_K | 69.9 | 91.7 | 3,179.4 |
| Apple M2 Ultra Metal Q3_K | 60.9 | 57.0 | 800.3 |
| Budget 16 GiB VRAM + 20 GiB RAM Q3_K | 36.8 | 44.9 | 335.0 |
| RTX Spark 60GiB Q3_K | 37.7 | 36.7 | 770.3 |
Un utente con RTX 3090 riferisce 20,1 secondi per il primo token, 1.583 token al secondo in prefill e 56,2 in decode su Q3_K: un ritmo inferiore rispetto alle schede di fascia più alta.
L’ho appena provato sulla mia configurazione con 3090: 20,1 s di TTFT, 1583 token/s in prefill e 56,2 token/s in decode per Edge0-145B Q3_K.
— u/LightBrightLeftRight, thread su r/LocalLLM
Sulla configurazione AMD già citata, u/UghrUghr segnala circa 40 in decode, circa 54 con ROUTE_TAIL_SKIP=7 e ROUTE_PRIOR=1.5, e circa 320 nell’elaborazione del prompt. Sono istantanee ottenute da un singolo utente, non riproduzioni controllate, con prestazioni pari a circa metà o due terzi di quelle della 5090 D.
Benchmark: due vittorie e quattro avvertenze
La tabella di Edge0 combina test interni su Edge0, Qwen, DeepSeek e Claude con dati di terze parti per gli altri modelli, come indicato nella documentazione del modello. Edge0-145B è in testa nei due test per coding agent, ma resta dietro al modello Qwen di base nelle prove di conoscenza e instruction following. Al 13 novembre 2026 non ho trovato alcuna riproduzione indipendente collegata, e i punteggi si riferiscono al modello completo, non ai download quantizzati.
| Benchmark | Edge0-145B | Qwen3.8-Flash-Next | DeepSeek V4 Flash | Claude Opus 4.6 Max |
|---|---|---|---|---|
| DeepSWE 1.1 | 64.6 | 58.7 | 54.4 | — |
| Terminal-Bench 2.1 | 86.52 | 83.3 | 82.7 | 78.2 |
| HLE | 35.4 | 35.9 | 33.8 | 40.0 |
| GPQA-Diamond | 90.4 | 91.7 | 90.8 | 91.3 |
| IFBench | 80.6 | 81.3 | 79.2 | 62.5 |
| AA-LCR | 79.3 | 79.1 | 79.7 | 78.0 |
La media calcolata da Edge0 è 72,8 per Edge0-145B, contro 71,7 per Qwen3.8-Flash-Next e 70,1 per DeepSeek-V4-Flash; il modello da 120B arriva a 68,9. La mia conclusione è semplice: a fronte di dichiarazioni simili sul picco di memoria, sceglierei il 145B, a meno che lo spazio su disco non sia un vincolo.
Licenza: pesi aperti non significa open source
Il framework è sotto Apache 2.0 e la base Strata sotto MIT, ma i pesi sono distribuiti con la Edge0 Community Model License 1.0, a cui si applicano anche i termini Qwen. Sono consentiti l’uso personale, di ricerca, aziendale interno e commerciale degli output. Per vendere o integrare il modello in un prodotto, gestire un servizio a pagamento o distribuire un assistente commerciale per coding o lavoro d’ufficio serve un’autorizzazione scritta separata.
Scaricarlo o usare un’API?
Scaricalo se hai l’hardware necessario e vuoi mantenere il codice sul dispositivo. Per una prova occasionale, però, è meglio confrontare prima i prezzi delle API ospitate, invece di acquistare hardware dedicato. Chi sta valutando l’inferenza via cloud può consultare la pagina dell’API DeepSeek V4.1 Flash prima di impegnare 105 GB di spazio.
| La tua situazione | Scelta consigliata |
|---|---|
| NVIDIA da 24 GB + 32-48 GB di RAM + 120 GB NVMe, Linux/Windows | Scarica Q3_K e avvialo con edge0-infer |
| Scheda Blackwell, preferisci il percorso NVFP4 | Scarica la build NVFP4 |
| Solo Mac, laptop da 8-16 GB o necessità di usare Ollama/LM Studio | Per ora non scaricarlo; usa un’API ospitata |
| Vuoi distribuire un’API o un assistente a pagamento basato sui pesi | Fermati e chiedi un’autorizzazione scritta; usa un’API |
| Vuoi quei punteggi senza occuparti della gestione locale | Usa API di classe Qwen o frontier e rivaluta dopo le riproduzioni indipendenti |
Il compromesso è tra provenienza e praticità: lo streaming degli esperti abbassa la soglia di VRAM per i modelli oltre i 100 miliardi di parametri, ma il supporto a laptop e macOS e la narrazione dei 29 GB corrono più avanti del codice effettivamente rilasciato. Inoltre, la tabella pubblicata da Edge0 non fornisce punteggi Q3_K separati sulla qualità.
Domande frequenti
Edge0-145B può funzionare su un laptop?
Solo su un laptop NVIDIA di fascia alta con circa 24 GB di VRAM, almeno 32 GB di RAM e 120 GB di NVMe, usando Linux o Windows con CUDA 13. Un ultrabook da 8 GB o 16 GB non può eseguire la build 145B, che richiede un download da 105,4 GB e oltre 23 GiB di VRAM occupata.
Edge0-145B funziona su Mac?
No: al 13 novembre 2026 nella tabella delle piattaforme non compare una versione macOS supportata. I numeri dell’M2 Ultra sono soltanto misurazioni Metal.
Funziona con Ollama, llama.cpp o LM Studio?
No. Le build standard non possono caricare pacchetti experts.bin personalizzati e il GGUF dello scheletro non contiene i pesi degli esperti instradati. Bisogna usare edge0-infer serve oppure l’app Chat per Windows.
Edge0-145B è migliore di Qwen3.8-Flash-Next?
È avanti in DeepSWE, con 64,6 contro 58,7, e in Terminal-Bench, con 86,52 contro 83,3, nei test di Edge0. È invece indietro in HLE, 35,4 contro 35,9, e GPQA-Diamond, 90,4 contro 91,7. I test indipendenti devono ancora arrivare.
Posso usare Edge0-145B per scopi commerciali?
Gli output sì, ma per vendere il modello, gestire un servizio a pagamento o distribuire un assistente commerciale per coding o lavoro d’ufficio serve un’autorizzazione scritta separata prevista dalla licenza community; si applicano inoltre i termini Qwen.