 AIREITER
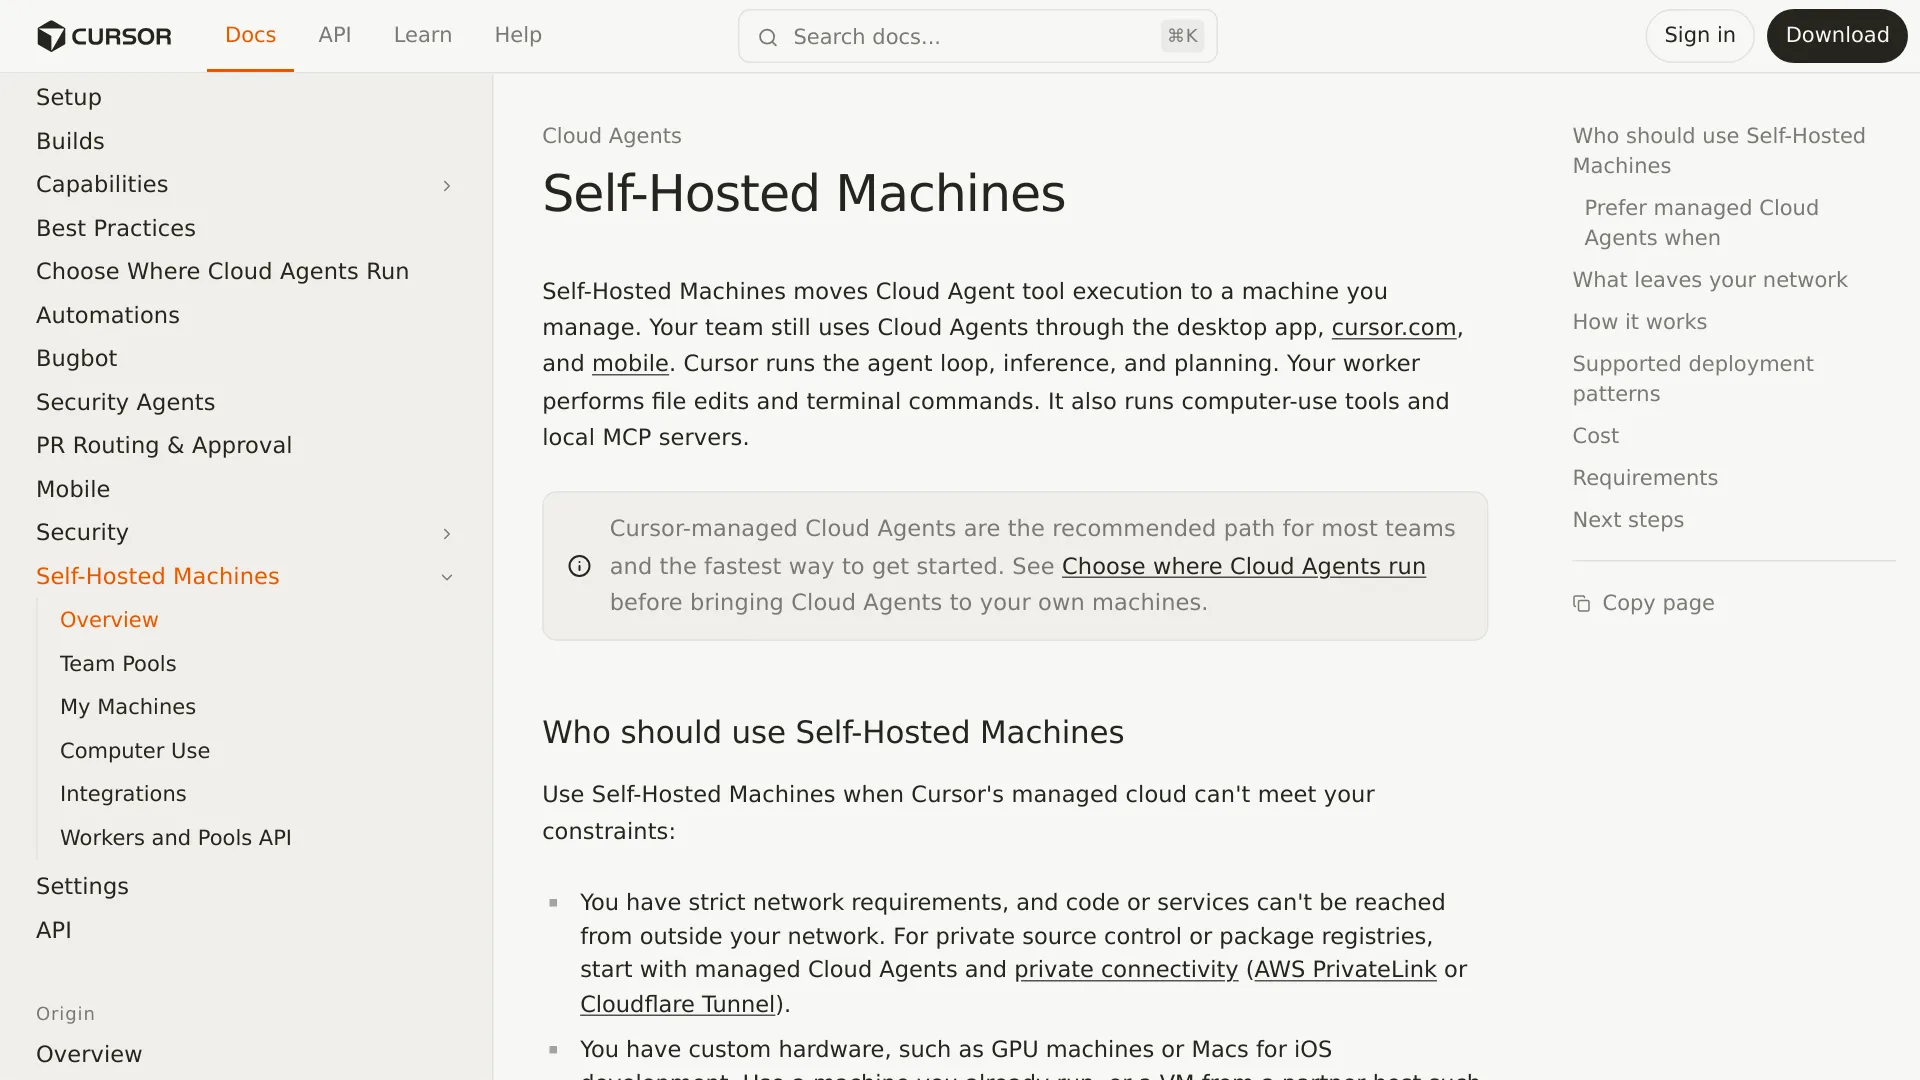
Un worker può trovarsi dietro il firewall aziendale e inviare comunque a Cursor frammenti di codice sorgente, output del terminale, diff e screenshot. Cursor Self-Hosted Machines offre un’esecuzione self-hosted, non un agent self-hosted né un’installazione di Cursor isolata dalla rete.
Questa analisi si concentra su ciò che attraversa il perimetro e su cosa cambiano davvero i controlli disponibili, sulla base dell’annuncio del 2 settembre 2026, della documentazione Self-Hosted Machines e della policy sull’utilizzo dei dati di Cursor.
Il confine dei dati, in una sola tabella
Cursor divide l’esecuzione di una sessione Cloud Agent tra il proprio cloud e un worker gestito dal cliente. “Self-hosted” indica dove vengono eseguiti gli strumenti, non che ogni sistema o flusso di dati resti nella tua infrastruttura.
| Dati o sistema | Dove vengono elaborati o conservati | Possono raggiungere Cursor? | Controllo o limite rilevante |
|---|---|---|---|
| Ciclo dell’agent, inferenza e pianificazione | Cloud di Cursor | Sono già all’interno di Cursor | Self-Hosted Machines non li sposta. |
| Modifiche ai file e comandi del terminale | Il tuo worker | I risultati possono essere restituiti | È il worker a eseguire gli strumenti. |
| Checkout completo e cache di build | Il tuo worker | Non vengono trasferiti automaticamente | La copia di lavoro completa resta locale. |
| Credenziali locali della macchina | Il tuo worker | Non vengono trasferite automaticamente | Tieni i segreti fuori da comandi, output e artefatti. |
| Contenuti dei file e diff | Il tuo worker, poi contesto e risultati dell’agent | Sì, quando necessario | Privacy Mode riguarda l’uso per il training, non il trasferimento. |
| Output del terminale e risultati MCP locali | Il tuo worker, poi risultati degli strumenti | Sì, quando vengono restituiti | I risultati possono contenere codice o dati sensibili. |
| Screenshot e stream del desktop | Il tuo worker, poi Cursor quando vengono prodotti o condivisi | Sì | Le sessioni di computer use possono trasmettere il desktop dell’agent. |
| Video, screenshot e riferimenti ai log | Storage degli artefatti gestito da Cursor | Sì, per impostazione predefinita | Bloccare l’host degli artefatti disabilita gli upload. |
| Richieste ai modelli con chiavi API | Percorso di elaborazione di Cursor | Sì | BYOK non aggira il backend di Cursor. |
La distinzione fondamentale è questa: l’intero repository può restare sulla tua macchina, mentre una parte del contesto necessario all’inferenza attraversa comunque la rete. Hai quindi un controllo parziale sull’esecuzione, non una garanzia di assenza di traffico in uscita.
Cosa trasferisce davvero Cursor nella tua infrastruttura
Self-Hosted Machines sposta l’esecuzione degli strumenti su una macchina controllata dal cliente. Il worker può modificare file, eseguire comandi, accedere a servizi interni, usare un browser e collegarsi a server MCP locali. Il ciclo dell’agent, l’inferenza, la pianificazione e l’orchestrazione della sessione restano invece nel cloud di Cursor.
Il worker viene avviato con il comando della CLI di Cursor agent worker start. Apre una connessione HTTPS in uscita e di lunga durata verso Cursor. Cursor specifica che la connessione parte dal worker: non servono una porta in ingresso, un indirizzo IP pubblico o un tunnel VPN.
Il flusso documentato della sessione è il seguente:
- Una sessione Cloud Agent viene avviata nell’interfaccia di Cursor.
- Il ciclo dell’agent nel cloud di Cursor pianifica l’azione successiva.
- Cursor invia una chiamata allo strumento attraverso la connessione del worker.
- Il worker esegue il comando, la modifica, l’azione nel browser o l’operazione MCP.
- Il worker restituisce il risultato per il passaggio successivo di inferenza.
Il worker deve comunque poter accedere in uscita a api2.cursor.sh e api2direct.cursor.sh; gli aggiornamenti della CLI e alcune configurazioni per il computer use possono richiedere anche downloads.cursor.com. Il modello con sole connessioni in uscita evita l’accesso in ingresso alla rete, ma non trasforma il worker in un runtime offline per i modelli.
Cursor propone questa separazione per repository o servizi privati non raggiungibili dai worker gestiti, hardware specializzato come GPU o Mac e sistemi operativi o immagini di build personalizzati. Se l’unico requisito è la connettività privata, la guida alla scelta del runtime di Cursor suggerisce di valutare prima i Cloud Agents gestiti con allowlist, reti simili a Tailscale, AWS PrivateLink o Cloudflare Tunnel.
Cosa può uscire dal worker e cosa cambia con Privacy Mode
La documentazione di Cursor elenca esplicitamente contenuti dei file, output del terminale, diff, screenshot, risultati MCP locali e metadati di routing tra i dati che il worker può inviare. La questione della privacy va separata in tre domande: cosa viene trasferito, se viene usato per il training e per quanto tempo viene conservato.
Privacy Mode controlla il training, non il traffico in uscita
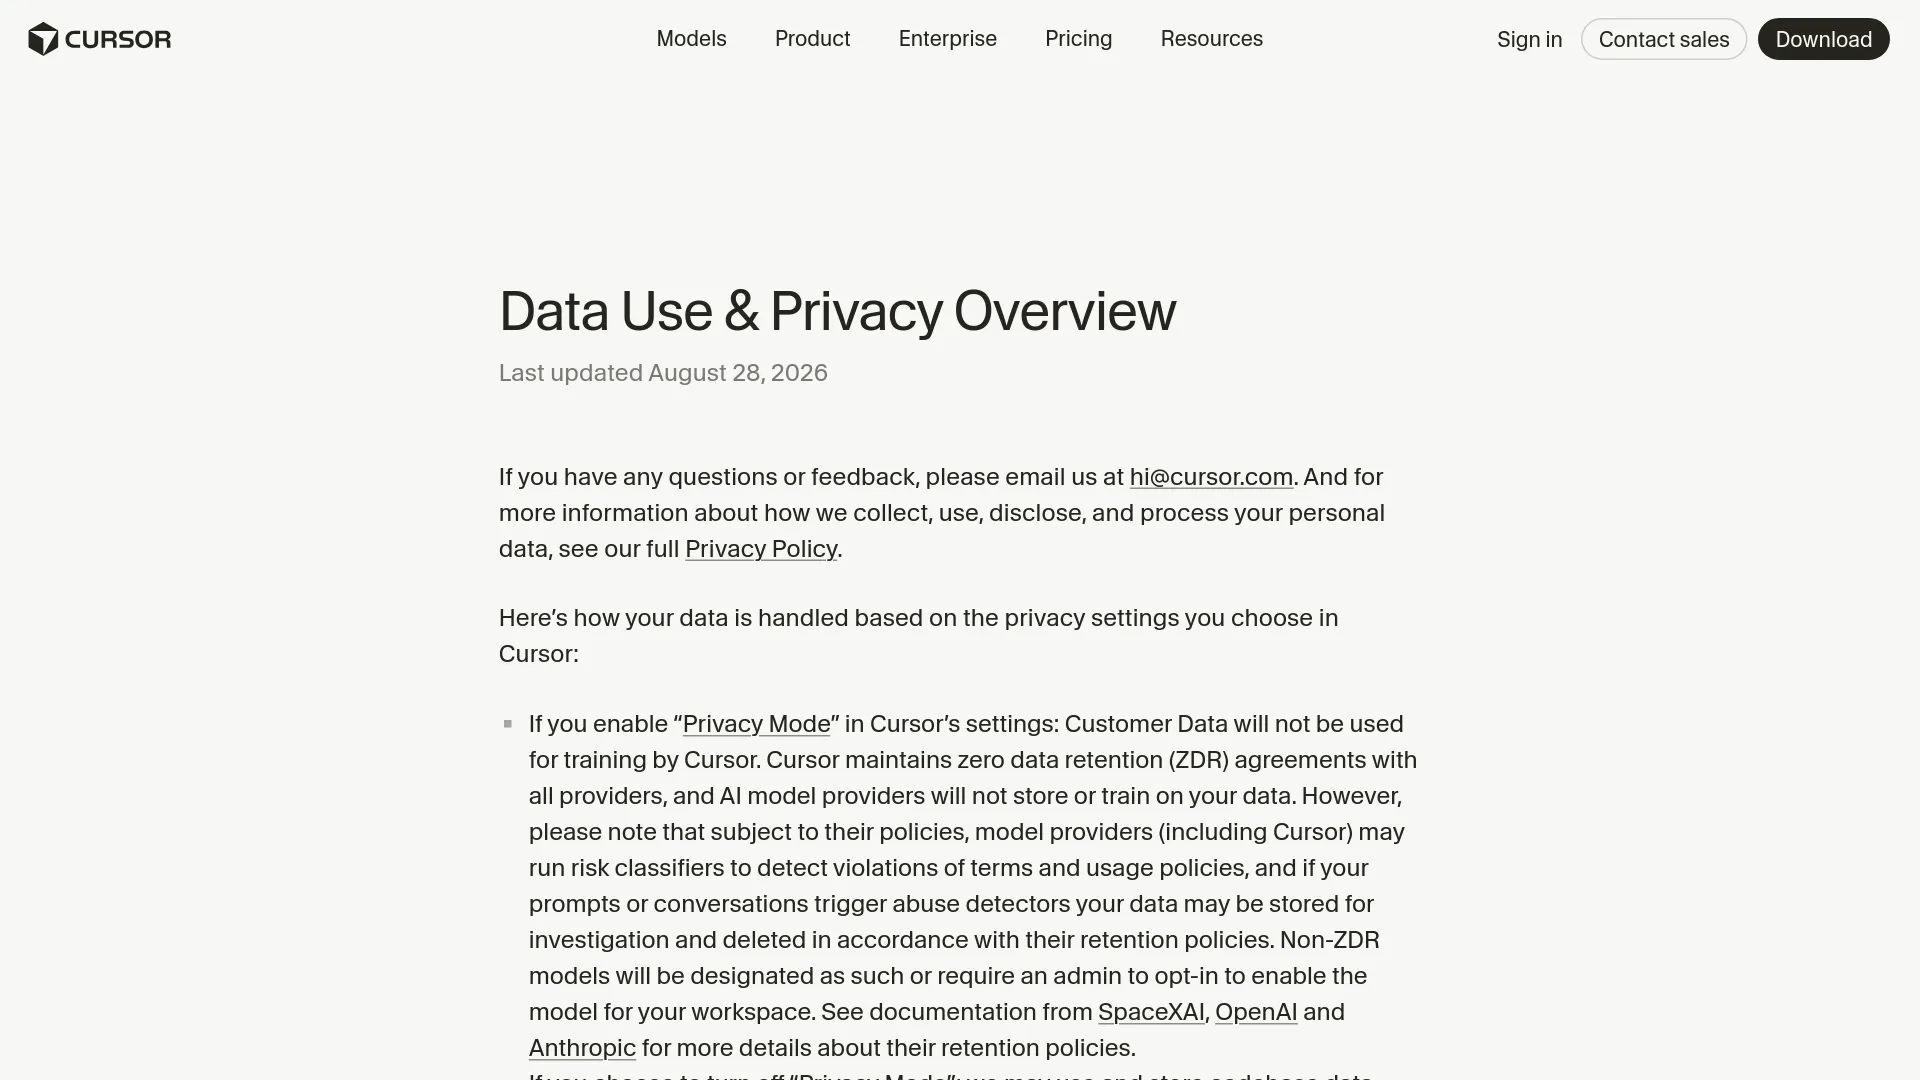
La Data Use & Privacy Overview di Cursor, aggiornata il 28 agosto 2026, afferma che Privacy Mode impedisce a Cursor di usare i Customer Data per il training e che Cursor mantiene accordi di conservazione zero-data-retention con i propri provider. La stessa pagina precisa però che i classificatori di rischio possono conservare prompt o conversazioni per le attività di analisi e che può verificarsi una memorizzazione temporanea dei file per motivi di latenza ed efficienza della rete.
Cursor descrive i file memorizzati nella cache come cifrati con chiavi generate dal client, mantenute sui server di Cursor per la durata della richiesta. È una dichiarazione di Cursor su conservazione e protezione dei dati, non la dimostrazione che la richiesta non raggiunga mai i server di Cursor.
Conta anche il dettaglio relativo alle chiavi API. Cursor afferma che usare la chiave API del proprio provider non aggira il suo backend, perché le richieste passano comunque da Cursor per la costruzione finale del prompt. BYOK può cambiare chi autorizza l’utilizzo del modello, ma non va interpretato come un percorso diretto e privato dal client al provider.
Un utente ha evidenziato la stessa distinzione architetturale nella sua analisi della funzionalità:
“Confine importante: le macchine self-hosted di Cursor spostano l’esecuzione, non l’intero agent. Cursor dice che inferenza e pianificazione restano nel suo cloud; gli output degli strumenti tornano indietro e possono contenere codice. In una revisione della sicurezza, consideratela un’esecuzione self-hosted, non un agent self-hosted.” — @ham_zax, X
Il blocco degli artefatti non crea un air gap
Cursor documenta un metodo specifico per impedire gli upload degli artefatti: bloccare il traffico HTTPS in uscita verso cloud-agent-artifacts.s3.us-east-1.amazonaws.com. Le chiamate agli strumenti e i relativi risultati continuano a funzionare, ma screenshot, video e riferimenti ai log non compariranno nelle pull request o nella dashboard di Cursor.
È una misura utile quando l’organizzazione non ha bisogno degli artefatti visivi. Non è però una soluzione completa per la privacy, perché contenuti dei file, output del terminale, diff, screenshot usati durante l’inferenza e risultati MCP possono comunque essere restituiti attraverso la connessione della sessione agent.
Il trasporto MCP introduce un’ulteriore distinzione pratica. La documentazione Team Pools di Cursor spiega che i server MCP basati su comandi, o stdio, vengono eseguiti sul worker e possono raggiungere reti private. I server MCP HTTP/SSE vengono invece gestiti dal backend di Cursor per OAuth, caching della sessione e autenticazione. Un endpoint MCP privato richiede quindi una verifica del trasporto, non soltanto della posizione dell’host.
Scegli il runtime in base al vincolo, non all’etichetta
Cursor offre tre opzioni di runtime. Il self-hosting è adatto quando il controllo sul perimetro di esecuzione, l’hardware o l’ambiente rappresentano un requisito scritto e non una semplice preferenza.
| Runtime | Dove vengono eseguite le chiamate agli strumenti | Scenario ideale | Responsabilità principale |
|---|---|---|---|
| Cursor-managed Cloud Agents | VM isolata gestita da Cursor | La maggior parte dei team che possono usare il networking gestito e ambienti standard basati su Ubuntu | Cursor gestisce ciclo di vita, capacità, isolamento e dismissione della VM dopo la configurazione dell’ambiente. |
| My Machines | Laptop, devbox, Mac o VM del singolo utente | Un flusso di lavoro personale, un repository con stato locale o una proof of concept rapida | Gestisci uptime, credenziali, dipendenze, pulizia e checkout. |
| Team Pools | Worker gestiti dall’organizzazione | Fleet aziendali, GPU, Mac, Kubernetes, routing basato su etichette e capacità centralizzata | Il team gestisce host, immagini, segreti, scalabilità, monitoraggio, reset e malfunzionamenti. |
Scegli i Cloud Agents gestiti se il requisito è soltanto l’accesso privato
I Cloud Agents gestiti possono essere sufficienti se l’organizzazione riesce a definire il proprio perimetro tramite permessi sui repository, allowlist di rete, un client simile a Tailscale o una connettività privata supportata. La guida ai runtime di Cursor raccomanda l’infrastruttura gestita alla maggior parte dei team e la descrive come l’opzione con meno attività operative.
In questo modo eviti di gestire una flotta di worker, mantenendo il ciclo di vita delle VM gestito da Cursor e la concorrenza elastica. Non significa che gli agent gestiti siano privi di trasferimenti di dati: significa che l’ambiente di esecuzione è gestito da Cursor invece che dal tuo team.
Scegli My Machines per un solo utente e un ambiente controllato
My Machines collega una macchina personale all’account Cursor di un singolo utente. È una soluzione pratica quando uno sviluppatore dispone già di un Mac, devbox o VM remota configurata con dipendenze locali e accesso alla rete, difficile da replicare altrove.
Il compromesso è operativo. La macchina deve restare online durante le sessioni attive e l’utente è responsabile della pulizia, dell’aggiornamento del checkout, dello stato del disco, delle credenziali e del ripristino delle dipendenze. La documentazione self-hosted di Cursor afferma che sulla stessa macchina possono essere eseguiti più agent, ma non si tratta del modello di flotta centralizzata per i team.
Scegli Team Pools solo se il controllo della flotta giustifica la complessità
Team Pools è pensato per i team Enterprise. Utilizza autenticazione tramite service account, capacità condivisa dei worker, etichette e scalabilità basata su controller. Un pool gpu può indirizzare il lavoro verso macchine con GPU; un pool ios può instradarlo verso Mac. Cursor documenta fino a 200 worker per utente e 1.000 worker per team; per installazioni più grandi è necessario discutere la scalabilità.
I pool possono scalare fino a zero e usare worker persistenti, containerizzati, Kubernetes o ospitati da partner. Cursor afferma che il ripristino di un workspace rilasciato può richiedere diversi minuti. Questa flessibilità è utile per carichi variabili, ma gestione delle immagini, reset dei worker, pianificazione della capacità, rotazione dei segreti e monitoraggio ricadono sul cliente.
Il costo comprende infrastruttura e utilizzo dei modelli
La documentazione Self-Hosted Machines e la pagina Cursor Models & Pricing descrivono responsabilità relative a modelli, piani e infrastruttura, ma non indicano una tariffa separata per worker di Self-Hosted Machines. Il modello di costo dichiarato è il seguente: continui a pagare il modello selezionato tramite Cursor e sostieni inoltre i costi della macchina, del container, del cluster, dello storage, della rete, del monitoraggio e delle attività operative che gestisci direttamente.
Per questo il self-hosting è un argomento debole per risparmiare quando non esistono requisiti specifici di rete o hardware. Pool dinamici e ibernazione possono ridurre il calcolo inattivo, ma il punto di pareggio dipende dalla forma del carico di lavoro, dai tempi di avvio e dalla quantità di stato da ricostruire; Cursor non pubblica un valore universale.
La checklist di sicurezza prima dell’attivazione
Usa questa checklist insieme al responsabile della sicurezza, della piattaforma o della compliance. La parola “self-hosted” non dovrebbe essere considerata, da sola, un via libera.
- Definisci con precisione il perimetro. Stabilite se la policy impone che checkout completo, esecuzione degli strumenti, credenziali, richieste di inferenza, artefatti o tutti questi elementi restino all’interno del perimetro. Self-Hosted Machines mette sotto il tuo controllo solo il worker di esecuzione e lo stato locale completo.
- Classifica il contesto restituito. Contenuti dei file, diff, output del terminale, screenshot e risultati MCP possono essere inviati a Cursor. Verifica se tali output possono contenere codice sorgente, dati dei clienti, token, URL interni o risposte provenienti dalla produzione.
- Attiva Privacy Mode consapevolmente. Modifica il comportamento dichiarato da Cursor in materia di training e conservazione presso i provider; non impedisce l’elaborazione delle richieste, la memorizzazione temporanea nella cache o la gestione per il rilevamento dei rischi.
- Interpreta correttamente BYOK. Secondo la pagina sull’utilizzo dei dati di Cursor, una chiave API non rimuove il backend di Cursor dal percorso della richiesta.
- Valuta separatamente il traffico degli artefatti. Consenti o blocca
cloud-agent-artifacts.s3.us-east-1.amazonaws.comin base all’accettabilità di screenshot, video e riferimenti ai log nelle PR e nella dashboard. Quando il firewall lo consente, preferisci una regola applicata all’host esatto. - Usa un’allowlist per il traffico in uscita. Consenti soltanto gli endpoint Cursor documentati e gli eventuali host di aggiornamento o computer use abilitati intenzionalmente. Per il worker non dovrebbe essere necessaria alcuna porta in ingresso né un IP pubblico.
- Esamina il trasporto MCP. Usa MCP stdio lato worker quando un server deve raggiungere un servizio privato e valuta i risultati restituiti. Non dare per scontato che un endpoint MCP HTTP/SSE resti nella tua rete solo perché il servizio è privato.
- Isola e ripristina i worker. Per Team Pools, definite come cancellare o ricreare le macchine tra un agent e l’altro, come iniettare le credenziali e come monitorare i log. Le guide e i template di Cursor sono architetture di riferimento, non una flotta di produzione completamente gestita.
- Verifica i percorsi di errore. Conferma cosa accade quando gli endpoint di Cursor, lo storage degli artefatti, il worker, un registry privato o un server MCP diventano indisponibili. Un host degli artefatti bloccato non equivale a una sessione agent bloccata.
- Escludilo per i carichi air-gapped. Se il requisito è impedire qualsiasi trasferimento verso l’esterno del contesto usato dal modello o eliminare l’inferenza cloud di terze parti, questa architettura non è adatta. Il ciclo dell’agent resta nel cloud di Cursor.
| Il requisito effettivo | Decisione |
|---|---|
| Comandi, stato locale o hardware personalizzato devono essere eseguiti nel tuo ambiente | Usa Self-Hosted Machines, con controlli sul traffico del contesto e degli artefatti. |
| Gli agent devono raggiungere servizi privati, ma l’esecuzione può avvenire in una VM gestita | Parti dai Cloud Agents gestiti e dalla connettività privata supportata. |
| Nessun contesto del modello può uscire dalla rete oppure l’inferenza deve essere offline | Escludi questa architettura: dipende comunque dal cloud di Cursor. |
FAQ sulla privacy di Cursor Self-Hosted Machines
Cursor Self-Hosted Machines è completamente self-hosted?
No. Cursor mantiene nel proprio cloud il ciclo dell’agent, l’inferenza, la pianificazione e l’orchestrazione. La tua macchina ospita l’esecuzione degli strumenti e lo stato di lavoro locale.
Il codice sorgente esce dalla macchina self-hosted?
Alcuni contenuti dei file, diff, output del terminale, screenshot e risultati MCP locali possono lasciare il worker come input o risultato degli strumenti per l’agent. Cursor afferma che il checkout completo e la cache di build restano sul worker, quindi il confine è parziale e non assoluto.
Privacy Mode impedisce ai dati di attraversare la rete?
No. Privacy Mode viene descritto come una funzione che impedisce a Cursor e ai provider dei modelli di usare i dati per il training, secondo gli accordi di conservazione dichiarati da Cursor. Non impedisce al worker di inviare il contesto necessario all’inferenza.
BYOK aggira Cursor?
No. La pagina sull’utilizzo dei dati di Cursor afferma che le richieste con chiavi API passano comunque dal suo backend per la costruzione finale del prompt. BYOK non va considerato una connessione diretta dal worker al provider del modello.
Posso impedire l’upload di screenshot e video?
Puoi bloccare l’accesso in uscita a cloud-agent-artifacts.s3.us-east-1.amazonaws.com. L’esecuzione degli strumenti continua, ma gli artefatti non compariranno nelle pull request o nella dashboard di Cursor. Altri dati della sessione agent possono comunque essere restituiti a Cursor.
Il worker richiede una regola firewall in ingresso o una VPN?
Cursor documenta un modello basato sulle connessioni in uscita. Specifica che non servono una porta in ingresso, un IP pubblico o un tunnel VPN, anche se il worker deve poter raggiungere in uscita gli endpoint Cursor documentati e i servizi che deve utilizzare.
Posso usare Team Pools con un piano personale o di fascia inferiore?
La documentazione di Cursor presenta Team Pools come una funzionalità Enterprise e richiede una chiave API per service account. My Machines è l’opzione per il worker personale; non dare per scontato che una chiave API personale possa avviare un worker Team Pool.
Posso eseguire Cursor Self-Hosted Machines completamente offline?
No. Il ciclo dell’agent e l’inferenza restano nel cloud di Cursor e il worker richiede una connessione in uscita. Un requisito offline o air-gapped richiede un’architettura diversa, con orchestrazione e inferenza dei modelli ospitate localmente.
Usa Cursor Self-Hosted Machines quando il team ha bisogno di un’esecuzione controllata dal cliente, dell’accesso a reti private, di hardware personalizzato o di un ambiente persistente. Se il requisito è tenere il traffico AI fuori dal cloud, serve un altro design: questa funzionalità cambia il luogo in cui vengono eseguiti i comandi, non quello in cui l’agent elabora le richieste.