 AIREITER
"Sonnet 5 è vicino a Opus 4.8, ma più economico" è la stessa argomentazione di Anthropic. Volevamo capire dove questa affermazione smette di essere vera, così abbiamo eseguito quattro attività identiche su entrambi i modelli tramite la Claude Code CLI e registrato il costo reale, la durata e il numero di chiamate agli strumenti da ciascuna risposta API. Quella che contava di più: portare Sonnet 5 allo sforzo xhigh per eguagliare ciò che Opus 4.8 fa per impostazione predefinita, e il divario di prezzo che abbiamo misurato è quasi scomparso — mentre Opus 4.8 ha завершato in circa metà del tempo.
Sonnet 5 vs Opus 4.8 in sintesi
Claude Sonnet 5 | Claude Opus 4.8 | |
|---|---|---|
Rilasciato | 30 giugno 2026 | |
Finestra di contesto | 1M token | 1M token |
Output massimo | 128K token | 128K token |
Prezzi (input/output per 1M token) | $5/$25 | |
Modalità veloce | Non supportata | Supportata (anteprima di ricerca), fino a ~2.5x velocità di output a prezzo premium |
Livelli di effort | low / medium / high / xhigh / max | low / medium / high / xhigh / max |
Posizionamento | Modello di fascia Sonnet più economico, focalizzato sugli agenti | Modello di punta di Anthropic, opzione con la massima accuratezza |
La finestra di contesto e l’output massimo sono identici — qui non fanno la differenza. Una cosa che invece fa la differenza è che Sonnet 5 utilizza un nuovo tokenizer che, secondo Anthropic, produce “circa il 30% di token in più” rispetto a Sonnet 4.6 per lo stesso testo, quindi un budget max_tokens o una stima dei costi ereditata da Sonnet 4.6 non si tradurrà direttamente.
Confronto ufficiale dei benchmark
Secondo le stesse dichiarazioni di Anthropic, compilate insieme all'analisi di terze parti di llm-stats.com, il quadro è coerente: Sonnet 5 vince o pareggia in un paio di benchmark, e Opus 4.8 è in testa nella maggior parte degli altri, di solito con margini a una cifra.
Benchmark | Sonnet 5 | Opus 4.8 | Gap |
|---|---|---|---|
Terminal-Bench 2.1 | 80.4% | 74.6% | Sonnet 5 +5.8 |
Humanity's Last Exam (with tools) | 57.4% | 57.9% | Parità quasi totale |
Humanity's Last Exam (no tools) | 43.2% | 49.8% | Opus +6.6 |
SWE-bench Verified | 85.2% | 88.6% | Opus +3.4 |
SWE-bench Pro | 63.2% | 69.2% | Opus +6.0 |
Toolathlon | 54.3% | 59.9% | Opus +5.6 |
OSWorld-Verified (computer use) | 81.2% | 83.4% | Opus +2.2 |
CursorBench | 61.2% | 63.8% | Opus +2.6 |
USAMO 2026 problems | 79.5% | 96.7% | Opus +17.2 |
Due cose saltano all’occhio. Il vantaggio più grande di Opus 4.8 è nella matematica difficile (USAMO), non nel coding — i divari nel coding (SWE-bench, Terminal-Bench) sono tutti a una cifra, e Sonnet 5 in realtà ne vince uno nettamente. Nel ragionamento generale potenziato dagli strumenti (HLE with tools), i due sono abbastanza vicini da considerarlo un pareggio.
C'è anche un numero relativo alla sicurezza che vale la pena segnalare, anche se non è un benchmark delle capacità: secondo le stesse divulgazioni, negli scenari browser-use senza ulteriori salvaguardie, il tasso misurato di successo degli attacchi di prompt injection di Sonnet 5 era dello 0,93%, contro il 31,5% di Opus 4.8. Anthropic non ha pubblicato una spiegazione dettagliata per quel divario specifico. Se state costruendo qualcosa di agentico che naviga il web aperto senza supervisione, vale la pena testare le vostre stesse salvaguardie invece di presumere che il modello di punta sia automaticamente la scelta predefinita più sicura.
Abbiamo eseguito noi stessi quattro test testa a testa
La maggior parte di ciò che è disponibile in questo momento o compila la tabella ufficiale dei benchmark qui sopra oppure condivide impressioni soggettive di un singolo modello. Non abbiamo trovato un confronto controllato di costo e latenza con lo stesso prompt, quindi ne abbiamo eseguito uno noi.
Metodologia: quattro task, eseguiti il 2026-07-01, stesso prompt inviato a claude-sonnet-5 e claude-opus-4-8 ogni volta tramite la Claude Code CLI (claude -p --model <id> --effort <level> --output-format json). Costi, durata e numero di turni vengono letti direttamente dalla risposta API di ciascuna esecuzione, non stimati in base al conteggio dei token. Ogni configurazione modello/effort è stata eseguita una volta per task — valori reali da una singola esecuzione, non un campione mediato statisticamente. Considera la dimensione di ciascun divario come indicativa piuttosto che esatta; la direzione è stata coerente in ogni test che abbiamo eseguito.
Test 1: Il controllo di inversione dei costi
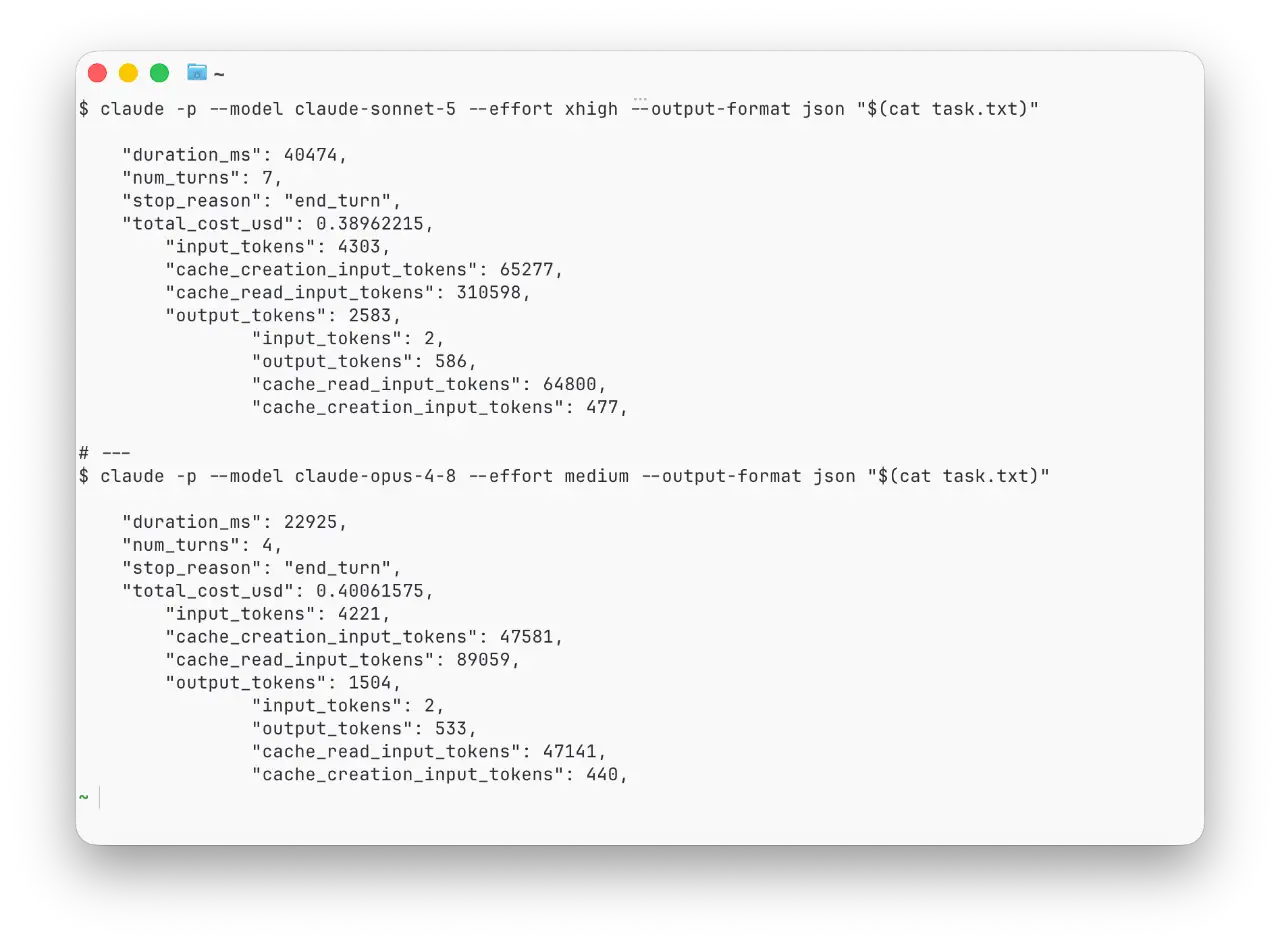
La domanda a cui volevamo rispondere di più: Sonnet 5 resta più economico anche quando si alza il suo livello di effort per compensare un compito più difficile? Abbiamo eseguito lo stesso task di coding del Test 2 (sotto) con Sonnet 5 xhigh contro Opus 4.8 medium.
Configurazione | Costo | Durata | Turni | Risultato |
|---|---|---|---|---|
Sonnet 5, effort | $0.390 | 40.5s | 7 | 8/8 tests pass |
Opus 4.8, effort | $0.401 | 22.9s | 4 | 7/7 tests pass |
Una differenza di costo del 3% — sostanzialmente pari — e Opus 4.8 con l’impostazione di sforzo più bassa ha completato il lavoro nel 57% del tempo usando quasi la metà dei turni. Entrambi hanno prodotto codice corretto e funzionante. Questo è in linea con ciò che le persone stanno già segnalando su Hacker News: un commentatore lì ha stimato che Opus 4.8 costi circa $0.45 con ragionamento medio contro Sonnet 5 a circa $0.52 su xhigh/max per un lavoro comparabile.
Test 2: Attività di programmazione a pari impegno
Stesso prompt, entrambi i modelli con sforzo high: scrivi una funzione efficiente per la sottostringa palindroma più lunga, genera casi di test che coprano i casi limite, eseguili, correggi tutto ciò che fallisce.
Configurazione | Costo | Durata | Turni | Risultato |
|---|---|---|---|---|
Sonnet 5 (high) | $0.378 | 37.4s | 7 | 8/8 pass |
Opus 4.8 (high) | $0.439 | 28.9s | 5 | 8/8 pass |
Entrambi sono arrivati allo stesso approccio di espansione attorno al centro e hanno superato ogni test al primo tentativo. Opus 4.8 ci è arrivato più velocemente e con meno turni, per circa il 16% in più di denaro. Quando la qualità è identica, questa volta il vantaggio va a Opus solo in base alla velocità.
Test 3: Scrittura / Lavoro di conoscenza
Un prompt di giudizio aziendale senza una singola risposta corretta: consiglia un'azienda SaaS di 12 persone su se spendere 3-4 settimane per migrare in una seconda regione AWS per il disaster recovery, sei settimane prima della chiusura della loro Serie A.
Configurazione | Costo | Durata | Turni |
|---|---|---|---|
Sonnet 5 (high) | $0.072 | 14.7s | 1 |
Opus 4.8 (high) | $0.084 | 22.7s | 1 |
Entrambi hanno dato sostanzialmente la stessa raccomandazione — saltare la migrazione completa e pubblicare invece un backup/runbook leggero — con una qualità del ragionamento comparabile. Sonnet 5 ci è arrivato in circa due terzi del tempo e ha costato il 14% in meno. Questo è l’unico test in cui “Sonnet 5 regge bene sul lavoro di conoscenza” è emerso chiaramente.
Test 4: Ricerca agentica — Sonnet 5 “pensa troppo” davvero?
Alcuni thread su Reddit descrivono Sonnet 5 come più incline a complicarsi troppo le cose con richieste semplici rispetto a Opus 4.8. Ne abbiamo testata una davvero semplice: sommare la dimensione in byte di ogni file .py in un albero di directory e indicare quale sottodirectory ne contiene di più.
Configurazione | Costo | Durata | Turni |
|---|---|---|---|
Sonnet 5 (high) | $0.119 | 18.5s | 3 |
Opus 4.8 (high) | $0.120 | 12.1s | 2 |
Entrambi sono arrivati alla stessa identica risposta corretta. Il costo differiva di un errore di arrotondamento, ma Sonnet 5 ha richiesto un turno di tool-call in più e circa il 50% di tempo in più. È un dato reale, seppur modesto, per la critica dell’“overthinking” — e coincide con il Test 1: Sonnet 5 tende a compiere più passaggi per arrivare allo stesso risultato.
Quindi quale dovresti davvero usare?
Scegli Opus 4.8 per attività di coding in cui la velocità conta, workflow agentici con molte chiamate agli strumenti, o qualsiasi situazione in cui altrimenti saresti tentato di spingere l’impegno di Sonnet 5 oltre
highper fidarti dell’output — è esattamente la situazione in cui il vantaggio di costo di Sonnet 5 scompare.Scegli Sonnet 5 per lavori ad alto volume e sensibili al budget, e per attività generali di conoscenza/scrittura, ma mantienilo a un impegno
mediumohigh. Non aumentarlo automaticamente axhigh"solo per sicurezza" — è lì che la storia dei prezzi si sgretola.Entrambi vanno bene per semplici ricerche e richieste a turno singolo; la differenza pratica che abbiamo misurato era un turno in più e qualche secondo, non una risposta sbagliata.
FAQ
Claude Sonnet 5 è davvero più economico di Opus 4.8?
A parità di livello di effort, sì — in modo evidente. Ma spingi Sonnet 5 su xhigh per compensare un task più difficile e il divario può ridursi a pochi punti percentuali, mentre Opus 4.8 con un'impostazione di effort inferiore termina più velocemente. Controlla quale livello di effort stai effettivamente usando prima di dare per scontato di risparmiare denaro. Per l'elenco completo dei prezzi per Haiku, Sonnet e Opus, consulta la nostra guida ai prezzi dell'API Claude.
E Claude Sonnet 5 rispetto a Sonnet 4.6?
Un aggiornamento generazionale, non una scelta di livello del modello — e anche i costi non si muovono nella stessa direzione. Sonnet 5 batte Sonnet 4.6 con un margine a due cifre su Terminal-Bench, ma nei nostri test diretti sui costi, Sonnet 5 è risultato più costoso di Sonnet 4.6 a ogni livello di effort che abbiamo provato, principalmente a causa del nuovo tokenizer. Test completi e numeri in Sonnet 5 vs Sonnet 4.6: È davvero più economico?
Confrontare Claude Sonnet 5 con Opus 4.6 è un confronto equo?
Non proprio — Opus 4.6 è una generazione indietro rispetto a Opus 4.8. Se stai decidendo cosa usare oggi, confrontalo con Opus 4.8, non con il suo predecessore.
La finestra di contesto è diversa tra i due?
No — entrambi offrono una finestra di contesto da 1M token e un output massimo di 128K.
Perché il tasso di prompt injection di Opus 4.8 è molto più alto nell'uso del browser?
In base alle divulgazioni di Anthropic, il 31,5% senza ulteriori misure di salvaguardia rispetto allo 0,93% di Sonnet 5, in particolare negli scenari di browser-use non supervisionati. Anthropic non ha pubblicato una spiegazione dettagliata. Consideralo un motivo per testare le tue specifiche misure di salvaguardia invece di assumere che il modello di punta sia automaticamente l’impostazione predefinita più sicura.
Appendice: Prompt esatti e output grezzo
Per chiunque voglia riprodurre questo, ecco i prompt esatti che abbiamo inviato per ogni test (il Test 1 e il Test 2 hanno usato lo stesso prompt di programmazione, solo a livelli di sforzo diversi).
Test 1 & 2 — prompt di programmazione:
Scrivi una funzione Python `longest_palindromic_substring(s: str) -> str` che restituisca
la sottostringa palindroma più lunga di s, usando un approccio più efficiente di
brute-force O(n^3) (ad es. expand-around-center o l'algoritmo di Manacher). Salvala
in solution.py.

Poi scrivi test_solution.py con almeno 6 casi di test che coprano: stringa vuota,
singolo carattere, tutti i caratteri uguali, nessun palindromo più lungo di 1, un
palindromo di lunghezza pari e un palindromo di lunghezza dispari.

Esegui i test con pytest e assicurati che tutti passino. Se qualcuno fallisce, correggi il
codice ed esegui di nuovo finché tutti non passano. Riporta l'output finale di pytest.
Test 3 — prompt di scrittura/lavoro intellettuale:
Stai consigliando una piccola azienda SaaS (12 dipendenti, 80k MRR, attualmente su una
singola regione AWS) sul fatto di espandersi in una seconda regione AWS per il disaster
recovery prima della loro raccolta di Serie A, che si chiude tra 6 settimane.
L’ingegneria stima che la migrazione richieda 3-4 settimane e consumerebbe la maggior parte
della capacità del team durante quella finestra, ritardando due funzionalità richieste dai clienti.

Scrivi una raccomandazione esecutiva di ~350 parole: dovrebbero farlo ora, rimandarlo,
o trovare una via di mezzo? Giustifica con i compromessi. Niente premessa, solo la
raccomandazione.
Test 4 — prompt di ricerca agentica:
Nell'albero della directory corrente, trova tutti i file con estensione .py, somma la loro
dimensione totale in byte e dimmi quale singola sottodirectory (figlia immediata della
directory di lavoro) contiene il maggior numero di file .py per conteggio. Solo i due
numeri/la risposta, non c'è bisogno di scrivere nuovi file.
Ecco la risposta API effettiva per l'esecuzione Sonnet 5 (xhigh) del Test 1, limitata ai campi rilevanti per costo e tempistiche:
{
  "duration_ms": 40474,
  "num_turns": 7,
  "stop_reason": "end_turn",
  "total_cost_usd": 0.38962215,
  "usage": {
    "input_tokens": 4303,
    "cache_creation_input_tokens": 65277,
    "cache_read_input_tokens": 310598,
    "output_tokens": 2583
  }
}
Questi sono l' total_cost_usd, duration_ms e i conteggi dei token non modificati che la CLI di Claude Code ha restituito per quella esecuzione — i numeri nella tabella del Test 1 sopra provengono direttamente da campi come questi, una risposta JSON per esecuzione.