 AIREITER
Far girare un modello da 27 miliardi di parametri su uno smartphone non è più soltanto una demo da laboratorio. Bonsai 27B, la versione quantizzata in ternario di Qwen3.6 27B realizzata da PrismML, porta il modello a 3,9GB e raggiunge circa 11 token al secondo su iPhone 17 Pro. I pesi sono gratuiti con licenza Apache 2.0 e la variante ternaria conserva oltre il 95% del punteggio nei benchmark rispetto al modello full precision. Il risultato, però, non è uniforme: matematica e programmazione restano molto vicine all'originale, mentre tool calling e visione perdono terreno. Bonsai 27B è quindi una proposta concreta per ragionamento e codice in locale, ma meno affidabile per flussi agentici ricchi di strumenti. Vediamo come ottiene questa compressione, come interpretare i dati, dove eseguirlo e per chi ha davvero senso.
Come un modello da 27B entra in meno di 6GB
Un normale modello da 27B in FP16 richiede all'incirca 54GB di memoria: ben oltre ciò che può offrire qualunque telefono. Bonsai 27B scende sotto i 6GB sostituendo i pesi ad alta precisione con valori discreti molto più compatti.
Nella variante ternaria, ogni peso può assumere soltanto tre valori: -1, 0 o +1. In teoria corrisponde a circa 1,58 bit di informazione per peso. PrismML aggiunge un sistema di scaling per gruppi in FP16, che memorizza un fattore di scala ad alta precisione per ogni gruppo di pesi affinché i valori compressi mantengano la giusta grandezza. Il costo reale arriva così a circa 1,71 bit effettivi per peso. La variante binaria a 1 bit è ancora più aggressiva: elimina lo zero, conserva solo -1 e +1 e si ferma vicino a 1,125 bit effettivi.
Ci sono due aspetti importanti. Primo: la quantizzazione riguarda l'intero modello, dagli embedding all'attenzione, dai blocchi MLP alla testa del language model; non rimangono componenti full precision a compensare. Secondo: la base è Qwen3.6 27B, un modello causale ad attenzione ibrida da 27,8B parametri. Bonsai eredita quindi la finestra di contesto da 262K token e l'input multimodale del modello di partenza.
Versione ternaria o 1 bit: quale scaricare
PrismML distribuisce due build. Scegliere quella sbagliata significa sacrificare inutilmente memoria oppure qualità: il compromesso è lineare, con file più piccoli che portano a una precisione inferiore.
| Build | Bit effettivi/peso | Dimensione | Qualità conservata | Ideale per |
|---|---|---|---|---|
| Ternaria (-1, 0, +1) | ~1,71 | 5,9GB | >95% di FP16 | Desktop e attività sensibili alla qualità |
| Binaria a 1 bit (-1, +1) | ~1,125 | 3,9GB | >90% di FP16 | Telefoni e sistemi con poca memoria |
Su smartphone, la build a 1 bit è quella che rientra nel margine di memoria di un iPhone 17 Pro. Con un laptop o un desktop più capiente, la variante ternaria recupera diversi punti di accuratezza in cambio di due gigabyte aggiuntivi: una scelta sensata ogni volta che la qualità dell'output conta più dell'ingombro.
Benchmark: dove Bonsai 27B convince e dove cede
I dati ufficiali riguardano la build ternaria, che totalizza una media di 80,49 su 15 benchmark in thinking mode. I risultati più significativi sono questi:
| Benchmark | Punteggio | Cosa misura |
|---|---|---|
| MATH-500 | 99,20 | Matematica dal livello scolastico alle competizioni |
| AIME 2025 | 90,84 | Matematica agonistica avanzata |
| HumanEval+ | 93,90 | Generazione di codice |
| BFCL v3 | 74,41 | Chiamate a funzioni e strumenti |
Guardando questi numeri insieme, il profilo di Bonsai 27B è abbastanza netto. Matematica e codice viaggiano sui 90 punti, mentre il tool calling resta nei 70. È il dato più importante da capire prima di affidargli un compito: la quantizzazione conserva ragionamento e programmazione molto meglio del comportamento strutturato e multi-step su cui si basano i workflow agentici.
Si tratta comunque di dati pubblicati da PrismML, quindi vanno considerati un punto di partenza e non una sentenza definitiva finché non arriveranno benchmark indipendenti. Conviene guardare i punteggi per singolo compito anziché fermarsi alla media di 80,49, e soprattutto prestare attenzione ai problemi riscontrati nell'uso reale. I primi tester hanno segnalato che la build ternaria può occasionalmente bloccarsi in loop di ragionamento; inoltre, una quantizzazione così estrema tende a indebolire la stabilità sui contesti lunghi più di quanto lasci intuire un benchmark a compito singolo. Prima di usarlo in modo serio, vale la pena provarlo con i propri prompt.
Velocità e hardware supportato
Una compressione così spinta ha valore solo se l'inferenza rimane abbastanza veloce da essere utilizzabile. Su hardware adeguato, lo è. Questi sono i valori dichiarati da PrismML:
| Dispositivo | 1 bit | Ternaria |
|---|---|---|
| iPhone 17 Pro | 11 tok/s | — |
| Apple M5 Max | 87 tok/s | 58 tok/s |
| NVIDIA RTX 5090 | 163 tok/s | 134 tok/s |
Gli 11 token al secondo su telefono sono sufficienti per chat e ragionamenti brevi, anche se non possono definirsi fulminei. Su M5 Max, gli 87 token al secondo sono abbastanza da permettere all'inferenza locale di superare una chiamata API cloud per prompt corti, una volta considerati i tempi di andata e ritorno della rete. PrismML descrive il risultato anche in termini di densità d'intelligenza, cioè punteggio nei benchmark per gigabyte: Bonsai arriva intorno a 0,53, circa dieci volte una baseline full precision.
Quattro modi per usare Bonsai 27B oggi
Dato che i pesi sono aperti, non esiste un solo percorso di installazione. Queste sono le quattro opzioni già disponibili, da quella senza configurazione a quella con il massimo controllo.
Su iPhone
L'app iOS Locally AI esegue direttamente sul dispositivo la build a 1 bit da 3,9GB, senza richiedere account o server. È la strada che mantiene davvero la promessa di un modello da 27B sul telefono e, dopo il download dei pesi, funziona interamente offline.
Dal browser
PrismML pubblica kernel WebGPU che eseguono il modello a 1 bit direttamente in una scheda del browser, senza installare nulla. È il modo più rapido per provare Bonsai 27B prima di occupare spazio sul disco, purché il computer disponga di una GPU compatibile con WebGPU.
Sul proprio computer
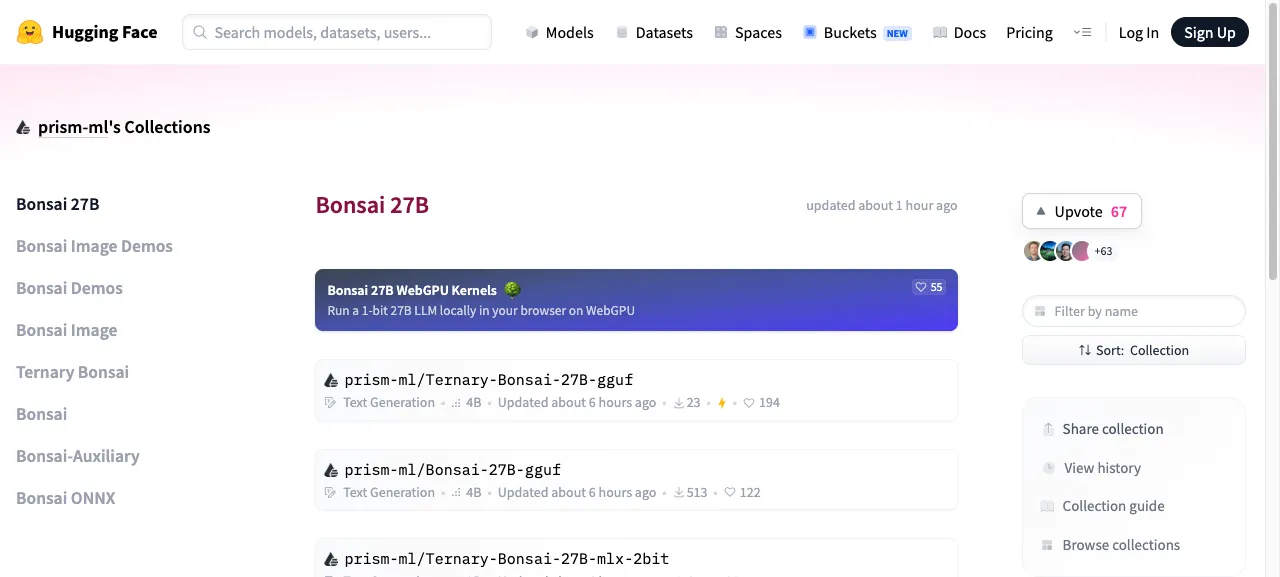
I pesi in formato GGUF, MLX e ONNX sono disponibili su Hugging Face e GitHub con licenza Apache 2.0. I repository principali sono prism-ml/Bonsai-27B-gguf per la versione a 1 bit e prism-ml/Ternary-Bonsai-27B-gguf per quella ternaria; sono presenti anche build MLX a 2 bit e ONNX. Per la build a 1 bit bisogna prevedere circa 4GB di spazio libero e RAM, mentre per la ternaria servono 6GB. C'è però una nota: la maturità degli strumenti non è ancora al passo con il rilascio. I pesi si caricano in vari runtime, ma al lancio mancava ancora il supporto completo nelle app locali più diffuse come LM Studio, quindi può essere necessaria qualche configurazione manuale.
Attraverso un'API gestita
Per chi preferisce non gestire i pesi in proprio, Together.ai offre la build ternaria dietro un'API standard, con finestra di contesto completa da 262K, input visivo e modalità JSON. Durante la promozione di lancio, il prezzo dell'input era indicato come $0.00 per milione di token; prima di pianificare un budget va verificata la tariffa attuale, perché i prezzi promozionali possono cambiare.
Bonsai 27B contro Gemma 4 12B QAT
Il confronto che ricorre più spesso è quello con Gemma 4 12B QAT, il modello di Google addestrato con quantization-aware training, che occupa circa 7GB: solo poco più della build ternaria di Bonsai.
I due modelli eccellono in ambiti diversi. Grazie alla base da 27B, Bonsai 27B supera chiaramente Gemma nei benchmark di matematica e codice. Gemma tende invece a reggere meglio su visione e tool calling, e i suoi pesi leggermente più grandi e meno compressi ne fanno una scelta generalista più stabile sul telefono. Per carichi locali incentrati su ragionamento e programmazione, Bonsai è la scelta più forte; se il lavoro dipende da immagini o chiamate di funzioni, Gemma 4 12B QAT è l'opzione più prudente.
A chi conviene davvero Bonsai 27B
Bonsai 27B ha senso per chi cerca assistenza privata, offline e in locale per ragionamento o codice, e dispone di un dispositivo di classe iPhone 17 Pro oppure di un laptop valido. È anche un caso di studio molto interessante per chi segue la quantizzazione estrema: far girare un modello da 27B in una scheda del browser è un traguardo concreto, e la licenza Apache 2.0 aperta semplifica la sperimentazione. Può affiancare naturalmente altri modelli open e gratuiti da usare per programmare quando serve un'opzione locale.
Non è invece, almeno per ora, la scelta giusta per sistemi agentici di produzione che richiedono tool calling affidabile, per attività in cui la visione è critica o per qualunque scenario in cui un loop di ragionamento avrebbe costi elevati. In questi casi resta più sicuro un modello meno compresso, oppure un modello full precision accessibile via API.
Domande frequenti
Bonsai 27B è gratuito?
I pesi sono gratuiti con licenza Apache 2.0, quindi è possibile scaricare ed eseguire il modello senza costi. L'accesso gestito tramite Together.ai segue invece il proprio listino API, che al lancio indicava $0.00 per milione di token di input: conviene controllare la tariffa aggiornata.
Bonsai 27B gira davvero su uno smartphone?
Sì. La build a 1 bit pesa 3,9GB e gira su iPhone 17 Pro a circa 11 token al secondo tramite l'app Locally AI, completamente offline dopo il download.
Bonsai 27B è valido quanto Qwen3.6 27B completo?
Ci si avvicina, ma non è identico. La build ternaria conserva oltre il 95% delle prestazioni nei benchmark del modello full precision, quella a 1 bit oltre il 90%. La tenuta è migliore su matematica e codice, mentre il tool calling è l'area più debole.
Quale file di Bonsai 27B devo scaricare?
Su telefono o su una macchina con poca memoria, scegli la build a 1 bit (prism-ml/Bonsai-27B-gguf, circa 3,9GB). Su desktop o GPU con memoria disponibile, la build ternaria (prism-ml/Ternary-Bonsai-27B-gguf, circa 5,9GB) offre qualche punto di accuratezza in più. Esistono inoltre varianti MLX a 2 bit e ONNX per Apple Silicon e runtime multipiattaforma.
Che cos'è la quantizzazione ternaria?
È una tecnica che memorizza ogni peso del modello come uno di tre valori, -1, 0 o +1, invece che come un numero ad alta precisione. È questo che permette una riduzione così drastica delle dimensioni. I fattori di scala FP16 mantengono i pesi compressi approssimativamente alla giusta grandezza.
Bonsai 27B supporta le immagini?
Sì, accetta immagini insieme al testo e restituisce output testuale, ereditando la capacità multimodale della base Qwen3.6 27B. Con questa compressione, però, la qualità nella visione regge meno bene rispetto a matematica e codice.