 AIREITER
Un Mac mini a généré 38,5 secondes d’audio en 2,81 secondes, en local et sans facture cloud. C’est la promesse associée au ZONOS3-Mini de Zyphra, un modèle de synthèse vocale à mixture of experts de 800 millions de paramètres, lancé le 9 novembre 2026, dont environ 100 millions seulement sont actifs à chaque étape. Mais les premiers testeurs le rappellent : la démonstration est en anglais et réalisée sur une machine puissante. Dans la pratique, vos textes, votre langue et votre GPU détermineront si vous approchez réellement ces chiffres.
ZONOS3-Mini : fonctionnement et modes d’utilisation
Le ZONOS3-Mini est un modèle TTS de clonage vocal zero-shot signé Zyphra. Fournissez-lui un texte et un court extrait de référence : il parlera avec cette voix. Vous pouvez aussi sélectionner l’une des 27 voix incluses et ajuster l’âge, l’accent ou le timbre. Les poids sont sous licence Apache 2.0 et le code d’exécution sous licence MIT, ce qui autorise les usages locaux et commerciaux. Évidemment, ne clonez que des voix dont vous détenez les droits ou l’autorisation.
Techniquement, le modèle repose sur un MoE parcimonieux de 64 experts avec routage top-2, réparti sur 11 couches selon un ratio de 3:1 entre Gated DeltaNet et attention globale. Il utilise aussi le nouveau Zyphra Audio Codec 1 (ZAC-1), à 15 images par seconde, contre 86 Hz pour le DAC du ZONOS2. Selon Zyphra, ce changement fait passer le nombre de tokens audio de 774 à 150 par seconde et permet, à données comparables, un taux d’erreur de mots environ 10 fois inférieur à celui du DAC.
Les principales caractéristiques : sortie en 44,1 kHz, générations pouvant aller jusqu’à 10 minutes, références de clonage brut limitées à 60 secondes et références par embedding limitées à 120 secondes. L’entraînement a mobilisé 112 GPU NVIDIA H100 pendant 2,5 jours.
Cinq façons de l’utiliser :
- Le playground WebGPU dans le navigateur, sans installation
- Le runtime natif C++/ggml sur CPU, CUDA, Metal ou Vulkan
- Un serveur Apple MLX
- SGLang ou vLLM sur des serveurs NVIDIA
- L’API hébergée de Zyphra avec
zyphra/zonos3-mini, via un endpoint/v1/audio/speechcompatible OpenAI
Les chiffres de latence annoncés par le fabricant parlent de moins de 570 ms avant le premier audio dans le navigateur d’un Pixel 9 et de moins de 150 ms sur un MacBook Air M3. Avec SGLang, un seul H100 atteindrait une médiane de 57 à 80 ms et jusqu’à 457 secondes audio par seconde en débit de pointe. Prenez les résultats sur téléphone et ordinateur portable comme des cas idéaux. Dans son propre fil de lancement, Zyphra citait des valeurs plus prudentes : moins de 800 ms et moins de 450 ms sur ces mêmes appareils. Testez donc votre matériel avant de promettre ces performances.
Deux points restent flous dans les documents de lancement. Le billet technique parle de 800 millions de paramètres au total, contre 886 millions sur la page du modèle. Aucun des deux ne précise non plus les mécanismes de watermarking, les protections contre les abus ou la conservation des extraits vocaux de référence envoyés au service.
Commencez par le navigateur avant d’installer quoi que ce soit
Le playground effectue l’inférence sur votre propre GPU via WebGPU, sans serveur ni installation. Le détail moins visible concerne la première visite : un des premiers testeurs a constaté que la page téléchargeait environ 920 Mo de modèle et de codec avant de pouvoir générer le moindre son. Le navigateur met ensuite ces fichiers en cache.
Le playground est donc un excellent point de départ gratuit. Testez le clonage et le contrôle par segments, puis mesurez la latence sur l’appareil le moins puissant que vous comptez prendre en charge : le comportement de WebGPU varie selon le navigateur, les pilotes et le GPU.
« Ne vous réjouissez pas de la “mort du TTS cloud” chaque fois qu’un petit modèle fonctionne dans un navigateur ! La compatibilité WebGPU entre navigateurs et pilotes est pleine de pièges. Une démo en anglais qui fonctionne bien ne dit absolument rien de la capacité du modèle à traiter vos textes de production ! » — @GKev1n, un utilisateur qui recommande de ne pas remplacer un TTS hébergé sur la seule base d’une démonstration
Si vos utilisateurs disposent d’anciens téléphones, de circuits graphiques intégrés ou de navigateurs non Chromium, ne transposez pas le résultat du Pixel 9 sans effectuer vos propres tests.
Ce que le modèle permet : clonage sans transcription et réglages mot par mot
- Clonage zero-shot : jusqu’à 60 secondes d’audio de référence, sans transcription nécessaire. Le mode par extrait brut vise le rendu le plus naturel ; l’embedding vocal peut être réutilisé et ajusté par la suite.
- Conception de voix : âge cible, registre masculin à féminin, accents américain, britannique et australien, ainsi que des réglages de texture combinables comme doux, rauque, clair ou profond.
- Direction de l’interprétation : rythme, émotion, projection, vivacité, niveau d’activation et chuchotement, jusqu’à l’échelle du mot. Vous pouvez faire chuchoter uniquement « I didn’t say » tout en conservant un ton neutre sur le reste de la phrase.
- Édition après génération : un modèle de type VoiceCraft modifie certains mots après génération tout en conservant la voix et les réglages. Une mauvaise prononciation de nom ne nécessite donc pas de recalculer tout le fichier.
La réserve formulée par Zyphra vaut pour l’ensemble de ces commandes : les valeurs d’émotion et d’interprétation sont des objectifs, pas des garanties. Le réglage du rythme peut aussi modifier le volume et la hauteur, tandis que la vivacité peut influer sur la hauteur et la durée.
Tests matériels publiés : vitesse, VRAM et deux pièges sous Windows
| Configuration | Résultat mesuré | Source |
|---|---|---|
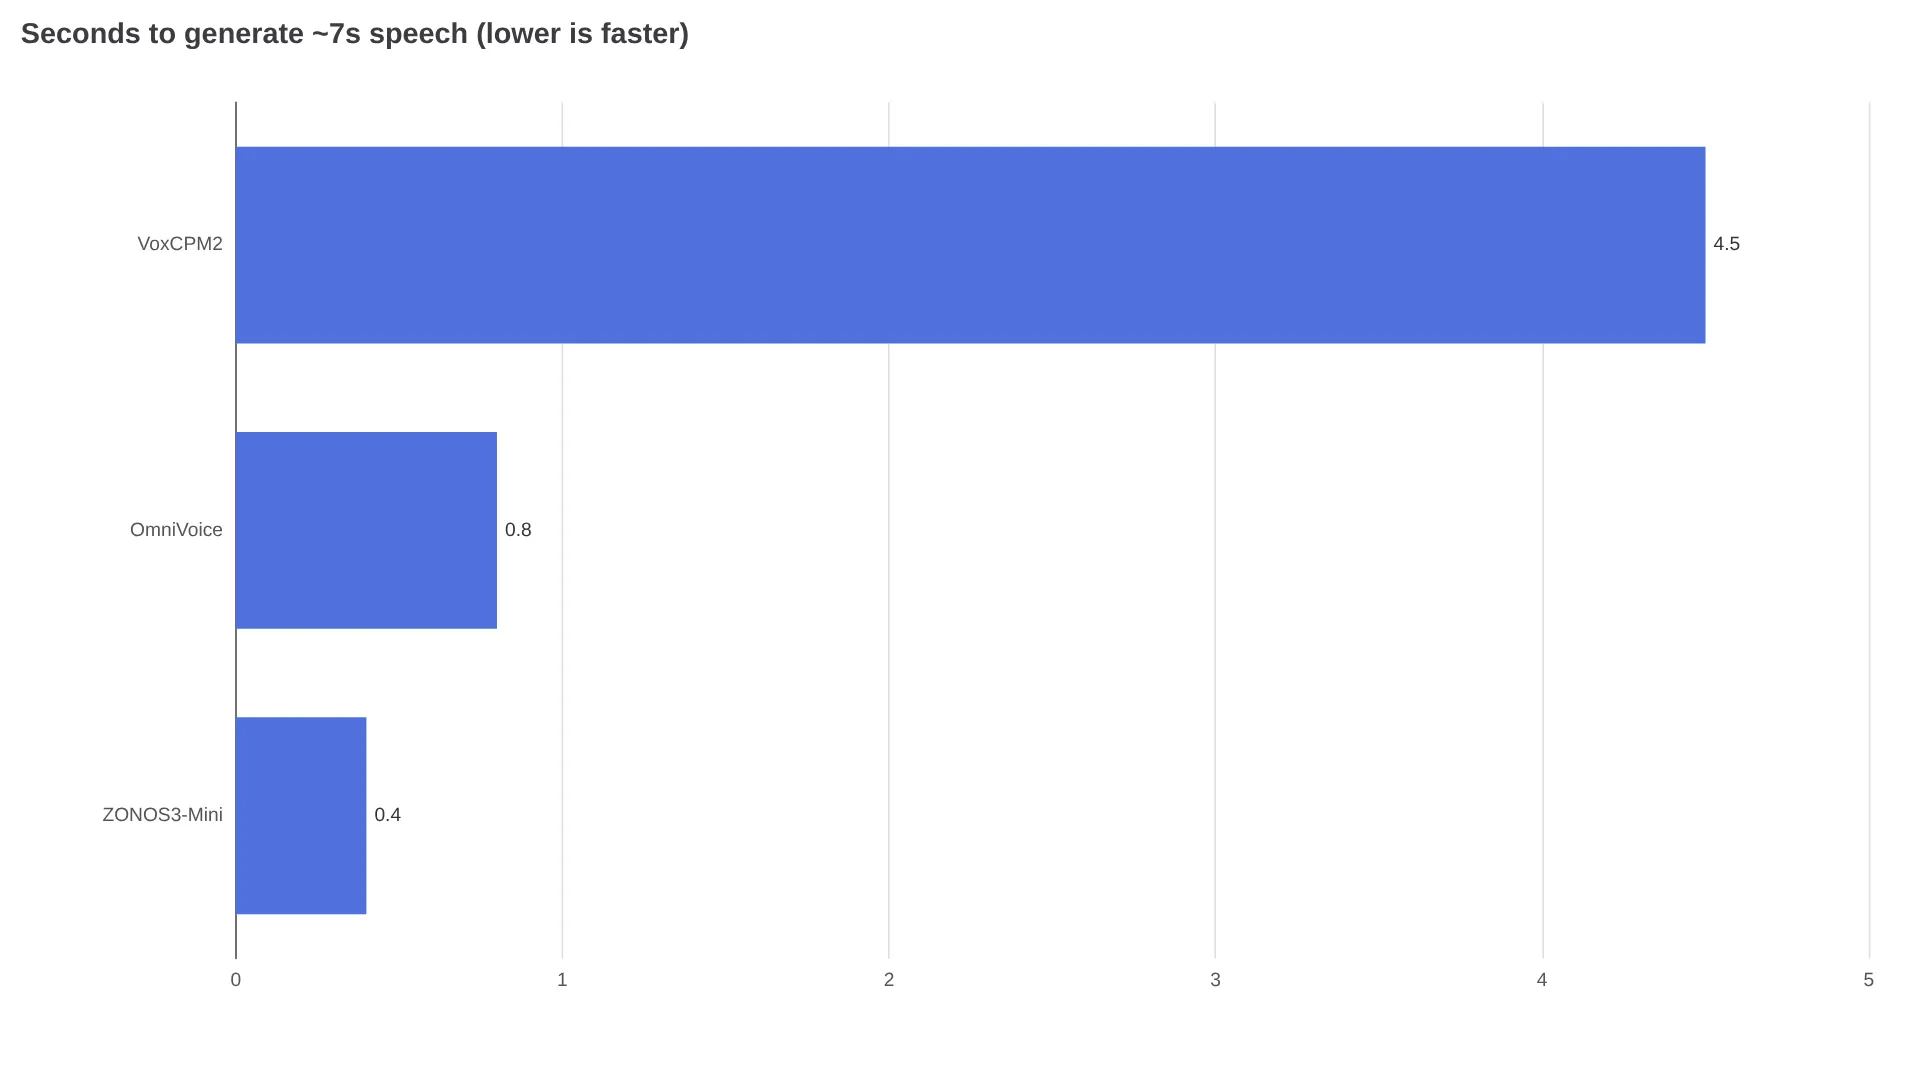
| RTX 5080, ggml quantifié (backbone de 0,66 Go + décodeur de 0,45 Go) | Environ 7,1 s de parole japonaise en 0,40 s ; 2,4 Go de VRAM au total — facteur temps réel de 0,056, soit environ 18 fois plus rapide que le temps réel | Benchmark VRAM16 |
| Même configuration : passage de 31 s ; extrait de 7,2 s en CPU uniquement | 1,50 s à 2,5 Go sur GPU ; le CPU a nécessité 1,45 s de calcul (2,38 s entre le lancement et la fin) | Benchmark VRAM16 |
| Mac mini M5 Pro de 64 Go, serveur MLX | 38,5 s d’audio en 2,81 s ; 75 à 100 ms avant le premier audio ; environ 16 Go au maximum lors du premier clonage | @pratikg |
Le résultat sur GPU est environ deux fois plus rapide que la précédente mesure d’OmniVoice réalisée dans le même benchmark, et très largement devant le facteur 0,63x mesuré pour VoxCPM2.
Avec le décodeur complet de 2,2 Go, la consommation atteint 4,2 Go, sans différence audible que le testeur aurait pu confirmer. Les transcriptions produites par Whisper large-v3 correspondaient au texte japonais et anglais attendu. Cela démontre l’intelligibilité, pas le naturel du rendu ni sa ressemblance avec la voix de référence.
Le résultat local le plus rapide publié à ce jour vient d’un testeur utilisant un Mac mini M5 Pro de 64 Go et le serveur MLX :
« BENCHMARK : ... fonctionne jusqu’à 13,7 fois plus vite que le temps réel. Test réalisé sur mon Mac mini M5 Pro de 64 Go, entièrement en local avec leur serveur MLX : environ 75 à 100 ms avant le premier audio avec les voix incluses. Génération d’un extrait audio de 38,5 s en 2,81 s. Clonage d’une nouvelle voix à partir d’un extrait de 11 à 13 s, qui a ensuite parlé après environ 1,3 s. ... WER de 0 à 4 %. Seulement quelques Go de mémoire utilisés, avec un pic d’environ 16 Go lors du clonage vocal initial. » — @pratikg, utilisateur ayant publié le jeu de données et ses notes
Un détail important se cache dans ce résultat : le clonage initial atteint près de 16 Go de mémoire, tandis que les voix déjà mises en cache s’exécutent aussi vite que les voix incluses. Si vous prévoyez de cloner de nombreux intervenants en batch, dimensionnez votre machine pour le pic, pas pour la consommation en régime établi.
Les utilisateurs qui compilent sous Windows ont rencontré deux pièges documentés par le testeur de VRAM16, avec des correctifs. Le compilateur de Microsoft refusait une structure contenant un membre également nommé head, alors que GCC et Clang l’acceptaient. Avec le correctif de renommage fourni, il faut donc compiler uniquement zonos3-cli, zonos3-server et spk-encoder-cli. Par ailleurs, Windows japonais transmet les textes de la CLI en CP932 plutôt qu’en UTF-8, ce qui produit un audio incohérent jusqu’à ce que le programme relise la ligne de commande via GetCommandLineW. Les requêtes JSON envoyées à zonos3-server devraient déjà être en UTF-8, mais cela n’a pas été vérifié.
Pour une installation sans mauvaise surprise, utilisez un chemin sans espaces ni caractères non ASCII, comme C:\zonos3. Installez Visual Studio 2022 avec les outils C++, ainsi que Git et FFmpeg. Une configuration CUDA propre prend environ cinq minutes et nécessite environ 1,2 Go de poids par défaut, auxquels s’ajoutent environ 2 Go pour CUDA en local (instructions d’installation).
Calcul du coût de l’API hébergée : que représentent 10 $ par million d’octets UTF-8 ?
Le service hébergé expose un endpoint de synthèse vocale compatible OpenAI, https://api.zyphracloud.com/api/v1/audio/speech, appelé avec le modèle zyphra/zonos3-mini et un bearer ZYPHRA_API_KEY. L’extrait ci-dessous démarre un serveur SGLang-Omni local (cookbook SGLang) en utilisant le même format de requête que l’API cloud. C’est tout l’intérêt : développez contre localhost, puis remplacez l’URL de base par celle de Zyphra Cloud.
sgl-omni serve --model-path Zyphra/ZONOS3-Mini --port 8000

curl -X POST http://localhost:8000/v1/audio/speech \
  -H "Content-Type: application/json" \
  -d '{"input": "Hello from ZONOS3-Mini!"}' \
  --output output.wav
La facturation dépend du nombre d’octets, et non du nombre de caractères ou de minutes audio : 10,00 $ par million d’octets UTF-8, avec 1 requête simultanée, 100 générations par jour, un nombre illimité de caractères en entrée et les limites de clonage de 60/120 secondes indiquées plus haut. Pour de l’anglais courant, en comptant environ un octet par caractère et environ 800 à 900 caractères par minute parlée, 10 $ correspondent à environ 1 100 à 1 250 minutes, soit moins d’un centime par minute. Le même calcul pénalise les textes CJK, car chaque caractère coûte environ trois octets : environ 3 fois plus par caractère. Utilisez vos propres scripts pour obtenir un coût à la minute en chinois, japonais ou coréen.
L’inférence locale ou dans le navigateur a un coût marginal presque nul une fois le matériel acheté. L’offre hébergée convient au prototypage et aux pics de charge, mais elle ne peut pas absorber une production à grande échelle avec 1 requête simultanée et 100 générations par jour. Les équipes qui ont besoin de débit devraient chiffrer un déploiement SGLang ou vLLM auto-hébergé plutôt que d’extrapoler le tarif de 10 $.
Face à ElevenLabs, Fish, Qwen et au badge « numéro 1 »
Les pages de Zyphra comparent le ZONOS3-Mini à Fish Audio, Qwen, Cartesia, ElevenLabs et OmniVoice sur trois scripts : un monologue de bande-annonce dramatique, un long passage comique autour de « straight to jail » destiné à tester la cohérence, et un dialogue au format podcast. Un graphique de Pareto met également en regard latence et débit. Écoutez vous-même ces exemples. Les pages proposent des lecteurs audio, mais aucun vainqueur explicite, aucune version précise des modèles concurrents, aucune seed et aucune indication confirmant l’utilisation de réglages identiques.
Le classement chiffré mérite la même prudence. Le ZTTS2-Eval couvre 35 langues propres et 20 langues en conditions réelles, sur 420 combinaisons de métriques, jeux de données et langues. Son Capability Index place le ZONOS3-Mini en tête des modèles ouverts, devant Fish S2 Pro et MOSS TTS v1.5. Mais c’est le fabricant qui évalue son propre modèle avec un test qu’il a lui-même conçu. La méthode est publique, mais cette analyse n’a trouvé aucune reproduction indépendante au moment de sa publication. Les comparaisons avec les modèles fermés reposent uniquement sur l’écoute, sans score commun.
Faute de scores détaillés par langue ou de validations indépendantes à l’écoute, la précision des tons en mandarin, l’accent tonique japonais, les caractères polyphoniques et l’émotion sur de longs passages restent à démontrer. Testez-les avant de vous engager. La conclusion la plus honnête est la suivante : le ZONOS3-Mini se distingue par son efficacité et sa souplesse de déploiement, mais sa supériorité en qualité n’est pas établie.
Qui devrait passer au ZONOS3-Mini dès maintenant ?
| Équipe | Verdict | Pourquoi |
|---|---|---|
| Usage hors ligne, embarqué ou sensible à la confidentialité (jeux, lecteurs, bornes) | À tester maintenant | Apache 2.0, téléchargement par défaut de 1,2 Go, 2,4 Go de VRAM, fonctionnement possible sur CPU, aucun compteur à la minute |
| Pipeline d’audiobook ou de PNJ nécessitant de nombreuses voix | À piloter | Le contrôle mot par mot et l’édition après génération réduisent le coût des nouveaux rendus, mais vérifiez la similarité du clonage pour chaque intervenant |
| Production non anglophone, notamment en chinois | Attendre votre propre évaluation | Aucun score fournisseur par langue ; les affirmations sur le taux d’erreur et la prosodie restent orientées vers l’anglais tant que vous n’avez pas testé les caractères polyphoniques et les tons |
| TTS hébergé à forte concurrence | Auto-héberger ou rester en place | L’offre cloud est limitée à 1 requête simultanée et 100 générations par jour ; SGLang/vLLM constitue la vraie voie pour la production |
| Équipes ayant besoin d’un watermarking ou d’une traçabilité | Mettre en attente | Les documents de lancement ne décrivent ni watermarking ni politique de conservation des extraits de référence |
Procédez dans cet ordre : playground dans le navigateur, compilation locale sur l’appareil le moins puissant, puis API hébergée. Ne basculez que si votre matériel passe les seuils de 2,4 Go de VRAM et de compatibilité WebGPU, et si votre langue réussit un test d’écoute en aveugle. Dans le cas contraire, conservez votre API propriétaire et réévaluez la situation lorsque des benchmarks multilingues indépendants seront disponibles.
FAQ
De combien de VRAM le ZONOS3-Mini a-t-il besoin ?
Environ 2,4 à 2,5 Go au total sur la configuration RTX 5080 testée (4,2 Go avec le décodeur complet ; pic d’environ 16 Go lors du clonage initial sur Mac).
Peut-il fonctionner dans un navigateur ou sur CPU ?
Oui : WebGPU nécessite un téléchargement d’environ 920 Mo lors de la première visite, et la synthèse sur CPU uniquement a pris environ un tiers du temps réel, lancement compris, lors du seul test publié.
Quelle est la qualité du clonage vocal ?
Le clonage zero-shot fonctionne avec jusqu’à 60 secondes d’audio, sans transcription. Un test indépendant a rapporté un taux d’erreur de mots de 0 à 4 %, mais la similarité propre à chaque voix doit être vérifiée par vos soins.
Peut-on l’utiliser commercialement ?
Les poids sont sous licence Apache 2.0 et le code sous licence MIT, mais vous devez disposer des droits ou du consentement nécessaires pour toute voix clonée.
Quel est l’endpoint de l’API et combien coûte-t-elle ?
POST https://api.zyphracloud.com/api/v1/audio/speech compatible OpenAI, avec le modèle zyphra/zonos3-mini, au tarif de 10 $ par million d’octets UTF-8 (1 requête simultanée, 100 par jour).
À lire également : Meilleure API de synthèse vocale, Meilleure API de clonage vocal en 2026, Guide du TTS local Kokoro 82M