 AIREITER
Le fichier de configuration fourni avec le modèle de Baidu fixe max_position_embeddings à 32 768. C'est là que le terme « Unlimited » cesse d'être littéral — et c'est surtout le point à retenir avant tout déploiement. Unlimited OCR remplace une chaîne OCR traitant les pages une à une par un seul passage avant, mais uniquement pour les documents tenant dans un budget de 32K tokens et pour des scans d'une qualité correcte.
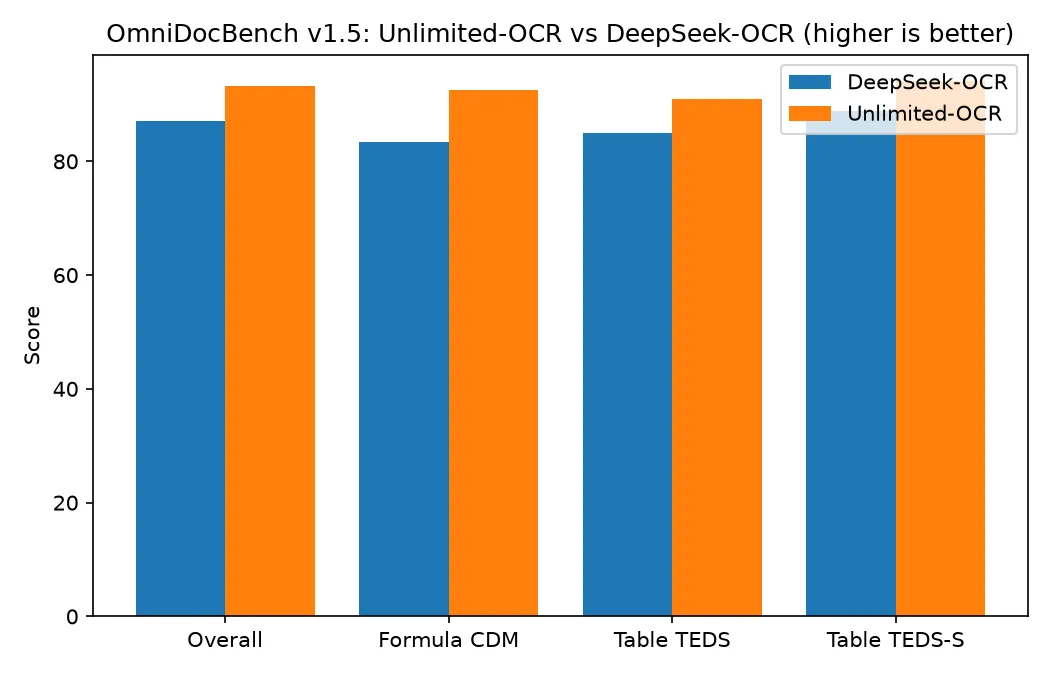
Le reste de la sortie mérite toutefois davantage d'attention que cette réserve ne le laisse penser. Les poids sont sous licence MIT, les métadonnées safetensors indiquent 3 336 106 240 paramètres en BF16, et le modèle obtient 93,23 au total sur OmniDocBench v1.5, contre 87,01 pour DeepSeek-OCR, le modèle de référence dont il est issu. Au 2026-07-29, Hugging Face affichait 2 694 935 téléchargements sur les 30 derniers jours et 3 389 likes.
« Unlimited » s'arrête au contexte de 32K
En mode multipage, chaque page est encodée en 1024×1024 puis compressée par 16, pour atteindre environ 256 tokens visuels. On peut donc calculer son budget par page avant même d'écrire une ligne de code.
| Pages en un passage | Tokens visuels (prefill) | Tokens restants pour la sortie | Budget par page |
|---|---|---|---|
| 10 | ~2 560 | ~30 200 | ~3 020 |
| 20 | ~5 120 | ~27 600 | ~1 380 |
| 40 | ~10 240 | ~22 500 | ~560 |
Une présentation ou un contrat peu dense peut passer confortablement sur 40 pages. Une page de journal dense sur deux colonnes peut, à elle seule, dépasser 560 tokens Markdown : dans ce cas, la limite pratique tombe bien en dessous de 40 pages. Le papier le dit explicitement : avec une longueur de contexte finie, l'analyse ne peut pas être réellement illimitée, puisque le prefill augmente toujours avec le nombre de pages. La feuille de route annoncée par Baidu prévoit une version à 128K de contexte et un « prefill pool » chargeant les fragments de pages à la demande. Le nom fait référence à une longueur de décodage illimitée par rapport à la taille du cache, pas à un nombre illimité de pages.
R-SWA : le vrai changement par rapport à DeepSeek-OCR
Deux éléments évoluent par rapport à DeepSeek-OCR. La pile de vision DeepEncoder — une cascade SAM-ViT-B et CLIP-L — a été conservée et gelée pendant l'entraînement. Toutes les couches d'attention du décodeur ont en revanche été remplacées par Reference Sliding Window Attention : chaque token généré accède à l'ensemble des tokens de référence, c'est-à-dire les tokens visuels et le prompt, mais seulement aux 128 derniers tokens produits. Le config.json le confirme : sliding_window_size: 128, 12 couches de décodeur, 64 experts routés dont 6 actifs par token.
Les progrès ne se limitent pas à une métrique isolée et concernent les éléments d'une page qui bénéficient le plus d'une génération longue. Sur OmniDocBench v1.5, le CDM des formules passe de 83,37 à 92,61, le TEDS des tableaux de 84,97 à 90,93, et la distance d'édition de l'ordre de lecture est divisée par deux, de 0,086 à 0,045. Comme l'encodeur n'a pas été réentraîné, ces écarts proviennent du décodeur, et non d'une pile de vision plus performante.
Corollaire direct : ce que l'encodeur lisait mal auparavant reste mal lu. Une génération plus longue n'améliorera pas la reconnaissance des caractères sur un fax effacé.
Le gain de vitesse apparaît surtout sur les sorties longues
À 256 tokens de sortie, les deux modèles font jeu égal : 7 229,52 contre 7 229,32 tokens par seconde. L'écart se creuse avec la longueur générée. À 6 144 tokens, le modèle de référence est retombé à 5 822,87, tandis qu'Unlimited OCR maintient 7 847,71 tokens par seconde, soit environ 35 % de plus.
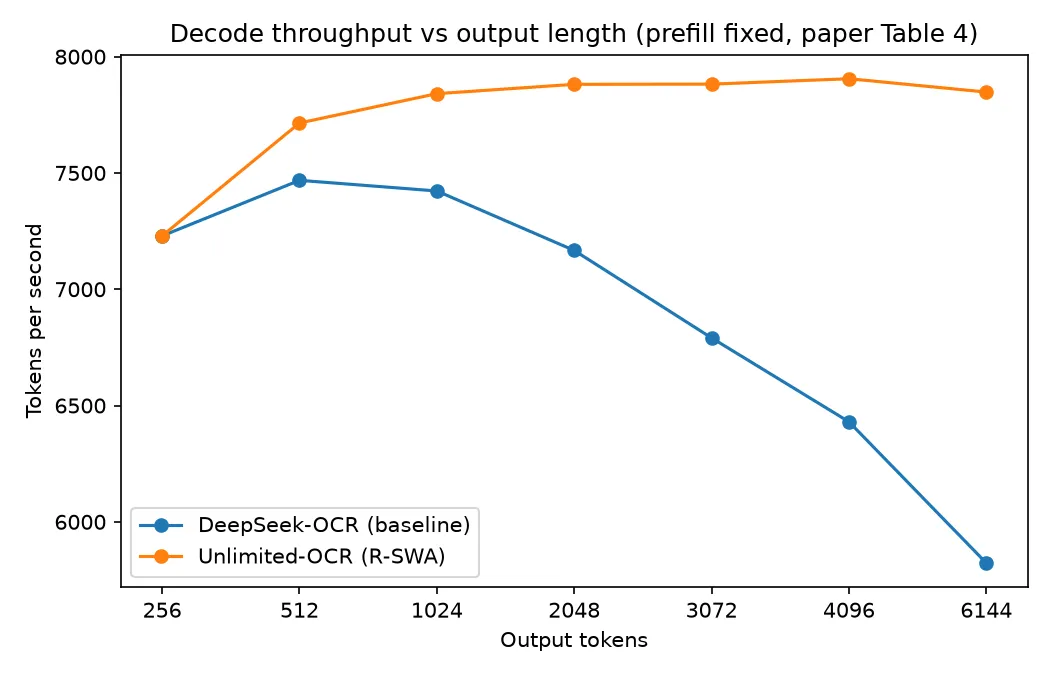
Sur le test OmniDocBench complet en mode base, avec une concurrence de 512, l'avantage revient à 12,7 % : 5 580 contre 4 951 tokens par seconde. Le batching masque déjà une bonne partie du coût d'attention à chaque étape. Pour traiter des factures d'une page à forte concurrence, R-SWA apporte donc presque rien.
La précision tient jusqu'à 40 pages, puis se dégrade
Le papier mesure la distance d'édition selon le nombre de pages traitées en un seul passage, et la courbe n'est pas plate.
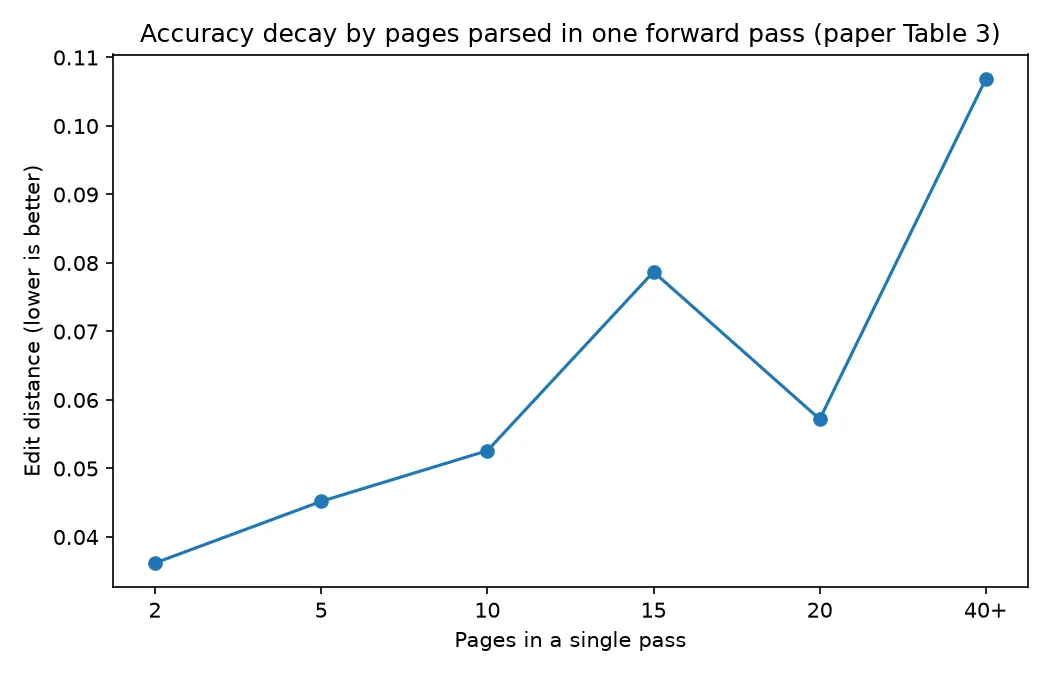
Sur deux pages, elle atteint 0,0362 ; sur dix, 0,0526. À partir de 40 pages, elle monte à 0,1069, tandis que Distinct-35 passe d'environ 99,9 % à 96,90 % : des n-grammes répétés commencent alors à apparaître dans la sortie. La mesure à 15 pages, à 0,0787, est moins bonne que celle à 20 pages, à 0,0572. Mieux vaut donc lire cette courbe comme une tendance, pas comme une garantie page par page. Baidu attribue surtout les répétitions aux petits caractères avec la résolution de base 1024×1024, plutôt qu'à une dérive de l'attention. C'est cohérent avec le compromis retenu : les entrées multipages et les PDF ne peuvent pas utiliser le mode crop plus détaillé disponible pour les images seules.
Pourquoi « 8 Go suffisent » est trompeur
La recette vLLM affirme qu'un seul GPU doté d'au moins 8 Go suffit pour l'inférence BF16. Les retours de la communauté ne concordent pas avec cette affirmation, et la configuration du modèle explique l'écart.
L'unique fichier safetensors pèse 6,673 Go. Le coût du cache découle de quatre champs dans config.json : num_hidden_layers: 12, num_attention_heads: 10, num_key_value_heads: 10, v_head_dim: 128, avec use_mla: false. Les nombres identiques de têtes de requête et de clé/valeur indiquent une MHA classique, sans partage GQA ou MQA pour réduire le volume. Le cache par token vaut donc 2, pour K et V, × 12 couches × 10 têtes × 128 dimensions × 2 octets = 61 440 octets, soit 60 KiB. On obtient ainsi trois ordres de grandeur :
- Un prefill complet de 32K : 32 768 × 60 KiB = 1,875 GiB de cache
- Le cache côté décodage avec R-SWA, plafonné par
sliding_window_size: 128: 7,5 MiB, constant - Le même décodeur sans R-SWA à 6 144 tokens de sortie : 360 MiB, avec une croissance linéaire
Il s'agit de tailles de cache théoriques, pas de l'allocation maximale : les activations de l'encodeur de vision, la fragmentation de l'allocateur et les blocs de cache préalloués par le moteur s'y ajoutent. C'est pourquoi les poids additionnés à un long prefill saturent vite une carte de 8 Go. Une exécution locale avec SGLang sur une RTX 4070 Ti Super de 16 Go a signalé environ 12 Go utilisés, ce qui concorde avec ce calcul sans pour autant le prouver. Il faut considérer les 8 Go comme un minimum pour une page courte, et non comme une spécification pour 40 pages.
Ces chiffres replacent aussi le bénéfice de R-SWA dans son contexte : à cette taille de modèle, plafonner le cache de décodage économise des centaines de mégaoctets, pas des gigaoctets. Le vrai gain visible en pratique est que le coût d'attention à chaque étape cesse de croître, exactement ce que mesure la courbe de débit.
Pas d'API officielle : voici les options de déploiement
La page Hugging Face du modèle indique : « This model isn't deployed by any Inference Provider. » Il n'existe ni endpoint propriétaire ni grille tarifaire Baidu pour ce modèle. Pour le servir soi-même, trois voies sont possibles : Transformers avec trust_remote_code, SGLang ou la recette vLLM. Cette dernière exige vLLM 0.25.0 ou plus récent depuis le conteneur dédié vllm/vllm-openai:unlimited-ocr, car l'architecture n'est pas encore intégrée à une roue pip stable.
Quatre réglages déterminent si vous obtenez une sortie ou non :
- Enregistrer le processeur de logits n-gram (
NGramPerReqLogitsProcessor). Sans lui, les documents longs bouclent sur les tokens de coordonnées<|det|>. - Régler la fenêtre n-gram :
ngram_size: 35avecwindow_size: 128pour les images seules, et1024pour les entrées multipages ou PDF. - Commencer le contenu textuel par le token littéral
<image>, comme dans<image>Multi page parsing.. Le modèle ne fournit aucun template de chat. - Passer
skip_special_tokens: False. En conservant la valeur par défaut, vous récupérerez des chaînes vides.
Les générations brutes contiennent un balisage de grounding. Pour obtenir un Markdown propre, conservez le texte compris dans <|ref|> et supprimez les boîtes englobantes <|det|>. Les séparations entre pages ne sont pas non plus générées nativement : demandez des libellés de pages dans le prompt si vous en avez besoin pour une piste d'audit.
Voici le serveur et la requête validés par la recette :
docker run --rm --gpus all --network host --ipc host \
  vllm/vllm-openai:unlimited-ocr baidu/Unlimited-OCR \
  --trust-remote-code \
  --logits_processors vllm.model_executor.models.unlimited_ocr:NGramPerReqLogitsProcessor \
  --no-enable-prefix-caching --mm-processor-cache-gb 0
client.chat.completions.create(
model="baidu/Unlimited-OCR",
messages=[{"role": "user", "content": [
{"type": "text", "text": "<image>Multi page parsing."},
{"type": "image_url", "image_url": {"url": page_data_url}},
]}],
max_tokens=8192, temperature=0.0,
extra_body={"skip_special_tokens": False,
"vllm_xargs": {"ngram_size": 35, "window_size": 1024}},
)Sur les cartes Hopper, utilisez le tag d'image unlimited-ocr-cu129. Notez aussi que plusieurs images dans une même requête basculent en mode base sans crop : c'est précisément le cas qui nécessite window_size: 1024.
Coût pour 1 000 pages : auto-hébergement ou API gérée
Les poids ouverts sont gratuits, mais leur exécution ne l'est pas. L'un des rares chiffres de débit publiés en conditions réelles vient d'un praticien dans le fil Hacker News : environ 200 pages par heure converties depuis un PDF de grammaire japonaise sur une RTX 4090 avec Transformers. Comparons cela au tarif Community de RunPod, soit 0,34 $ par heure pour une 4090.
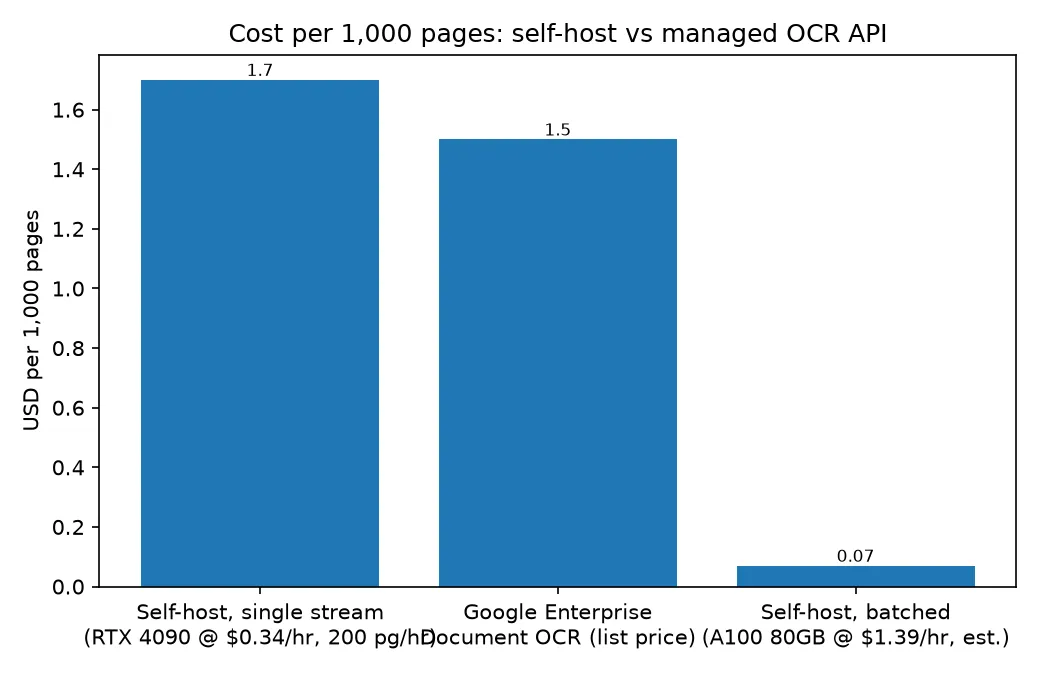
| Option | Coût pour 1 000 pages |
|---|---|
| Auto-hébergement, flux unique (4090 à 0,34 $/h, 200 pages/h) | ~1,70 $ |
| Google Enterprise Document OCR, de 1K à 5M pages/mois | 1,50 $ (tarif catalogue) |
| Google Layout Parser, même volume de pages | 10,00 $ (tarif catalogue) |
| Auto-hébergement, plancher batch saturé (A100 80GB à 1,39 $/h, modélisé) | ~0,07 $ |
Tarifs catalogue au 2026-07-29. Les 1 000 premières pages mensuelles de Google sont gratuites, puis le tarif tombe à 0,60 $ au-delà de 5 millions de pages. La dernière ligne est un plancher modélisé, non une mesure, et elle dépend de la longueur de sortie. Avec les 5 580 tokens par seconde du papier à une concurrence de 512, une sortie de 700 tokens par page représente environ 28 700 pages par heure, soit 0,05 $ pour 1 000 pages ; 1 000 tokens donnent environ 20 000 pages, soit 0,07 $ ; une page dense de 2 000 tokens, environ 10 000 pages, soit 0,14 $. Ce débit a été mesuré sur le cluster d'évaluation de Baidu, pas sur une A100 louée : cette ligne combine donc un débit de benchmark avec un prix de location. Les déploiements réels seront au-dessus de ces trois chiffres une fois intégrés la capacité inutilisée, les nouvelles tentatives sur les pages en échec, le prétraitement et le stockage.
En flux unique sur une carte grand public, le coût est à peu près équivalent à l'OCR géré de Google. L'auto-hébergement se justifie donc par la concurrence et la résidence des données, pas par la licence. Et l'analyse n'est que la moitié du travail : extraire des champs de ce Markdown demande encore un appel à un modèle de texte à long contexte. Vous revenez alors à une facturation au token, et non à la page, que cette étape tourne sur votre propre infrastructure ou via une offre comme l'API GPT-5.6.
Les cas où le modèle échoue
Les défauts remontés correspondent à ce qu'on attend d'un encodeur gelé. La même exécution sur 4070 Ti Super a produit du texte déformé, des zones oubliées et une structure instable sur des reçus, de l'écriture manuscrite et des scans complexes, alors que les pages imprimées propres passaient correctement. Des praticiens du fil Hacker News décrivent aussi une famille d'erreurs VLM-OCR particulièrement critique pour les usages réglementés : des mots étrangers traduits silencieusement en anglais, ou un nom manuscrit « corrigé » vers une orthographe jugée plus probable. Il ne s'agit que de deux anecdotes : considérez-les comme des comportements à tester, non comme des taux mesurés.
Le positionnement du modèle compte également. Unlimited OCR ne domine pas les tableaux de précision. Dans les listings OmniDocBench agrégés, PaddleOCR-VL-1.6 affiche 96,33, chiffre auto-déclaré par son fournisseur, contre 93,92 sur v1.6 pour le modèle de Baidu. Le modèle n'apparaît pas non plus dans olmOCR-Bench. Sa concurrence ne se joue pas sur la précision page par page.
Faut-il l'utiliser ?
Le modèle est pertinent si votre pipeline boucle aujourd'hui sur chaque page avant de recoller les textes, si vos documents sont nativement numériques ou scannés proprement, et si les structures transversales — par exemple des tableaux coupés par un saut de page — dégradent votre sortie actuelle.
Il convient moins si vous traitez des milliers de factures d'une page par jour, car les pipelines par page se batchent mieux et coûtent moins cher ; si les documents manuscrits ou les reçus photographiés représentent une part significative de vos entrées ; ou si vous avez besoin dès maintenant d'un SLA et d'une piste d'audit, plutôt que d'un GPU et d'un tag de conteneur.
Dans tous les cas, testez-le avant de vous engager. Un minimum raisonnable : 50 documents issus de votre corpus, répartis par longueur — 1 à 5 pages, 6 à 20, 20 ou plus — et par qualité d'entrée — documents nativement numériques, scans propres, photos. Faites saisir manuellement la vérité terrain pour 10 d'entre eux ; mesurez séparément le taux d'erreur de caractères, la distance d'édition de l'ordre de lecture et le TEDS des tableaux, au lieu de les moyenner ; puis notez le temps réel par page sur le GPU que vous comptez louer. Comparez avec votre solution actuelle sur les mêmes 50 fichiers et fixez le seuil là où votre étape aval échoue réellement : pour l'extraction de champs, ce sera souvent la structure des tableaux plutôt que le CER brut. Pour situer l'effet possible de l'optimisation, une équipe traitant des volumes de PDF à l'échelle entreprise a indiqué un taux d'erreur de caractères de 0,94 % après avoir réécrit la couche d'inférence en Rust.
FAQ
Unlimited OCR est-il gratuit ?
Les poids sont sous licence MIT et peuvent être téléchargés gratuitement depuis Hugging Face ou GitHub, y compris pour un usage commercial. L'inférence, elle, n'est pas gratuite : prévoyez environ 0,07 $ à 1,70 $ pour 1 000 pages selon l'efficacité de votre batching, auxquels s'ajoute le temps d'ingénierie.
Existe-t-il une API officielle pour Unlimited OCR ?
Non. La page du modèle ne montre aucun déploiement par un Inference Provider. Tout endpoint disponible est donc un service tiers exposant les poids ouverts, avec ses propres tarifs et limites de débit, et non ceux de Baidu.
Unlimited OCR est-il actuellement le meilleur modèle OCR ?
Pas dans les tableaux de précision : PaddleOCR-VL-1.6 revendique 96,33 sur OmniDocBench, contre 93,92 sur v1.6 pour Baidu, et le modèle n'a pas encore d'entrée dans olmOCR-Bench. Sa cohérence entre benchmarks reste donc à démontrer. Son avance mesurée porte sur le traitement en un passage de 40 pages, à une distance d'édition de 0,1069.
Puis-je exécuter Unlimited OCR dans Ollama ?
La fiche officielle ne documente que Transformers, vLLM et SGLang, et l'architecture personnalisée nécessite trust_remote_code. Des quantifications communautaires existent sur Hugging Face, mais toute version Ollama doit être considérée comme non vérifiée tant que vous n'avez pas comparé sa sortie au chemin de référence sur vos propres fichiers.