 AIREITER
Le 25 août 2026, ModelScope, la plateforme d’Alibaba, a lancé un compte à rebours pour Qwen3.8-Flash-Next. Particularité : ce modèle inaugure une nouvelle architecture avant même que la famille de produits à laquelle elle est destinée n’existe. Au moment de la rédaction, la publication des poids était prévue pour le 26 août à 23:00 UTC+8. L’objectif est clair : laisser le temps à l’écosystème open source de préparer les kernels, les quantifications et la prise en charge côté serveurs avant l’arrivée de Qwen4.
Qwen3.8-Flash-Next : ce que l’on sait vraiment
Qwen3.8-Flash-Next est un modèle multimodal Mixture-of-Experts (MoE), basé sur l’architecture prévue pour la future famille Qwen4. Ce n’est pas Qwen4. Il faut plutôt le voir comme un démonstrateur technologique fonctionnel : il expose les nouveaux mécanismes d’attention, la structure des couches et les schémas de sparsité afin que les frameworks d’inférence puissent les prendre en charge avant le lancement complet de Qwen4.
La page Hugging Face de l’équipe Qwen le présente comme une « Upcoming release » et comme un « A Preview of the Qwen4 Architecture ». De son côté, le compte à rebours de ModelScope affichait le slogan « Onward to the Next-Gen — Lightning-Fast. » Ces deux annonces proviennent de canaux officiels de Qwen. La sortie est donc bien confirmée, même si elle n’était pas encore finalisée au moment de la rédaction.
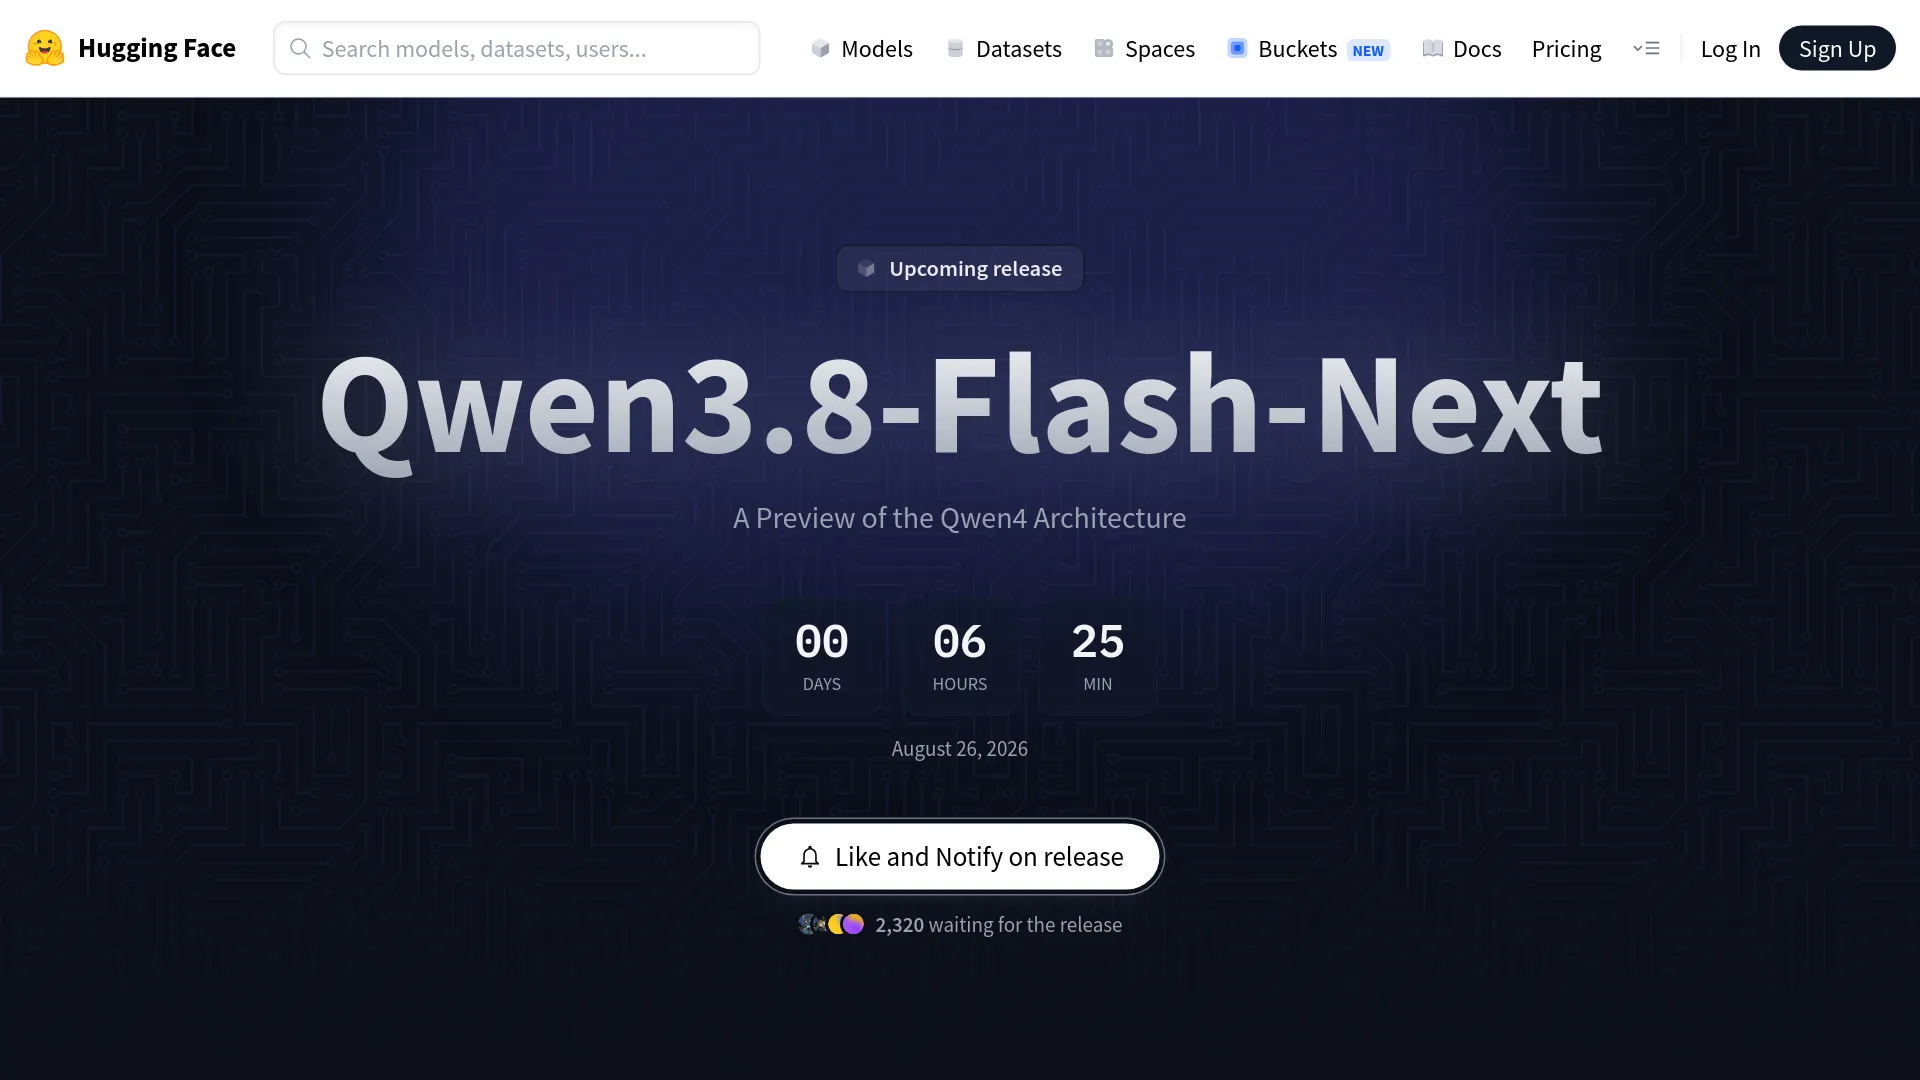
Voici la distinction entre les informations confirmées et les éléments qui restent à vérifier :
| Confirmé par les canaux officiels | Encore non confirmé |
|---|---|
| Publication des poids sur ModelScope et Hugging Face | Nombre final de paramètres (125B/6B/51B) |
| Modèle multimodal (vision + texte) | Licence (probablement Apache 2.0, par analogie avec les précédents) |
| Architecture hybride GDN et Qwen Sparse Attention | Résultats de benchmarks, quels qu’ils soient |
Variante FP8 (Qwen/Qwen3.8-Flash-Next-FP8) | Tarifs ou disponibilité via API |
| Aperçu de l’architecture de Qwen4 | Longueur du contexte (256K en natif, extensible jusqu’à 1M selon les spéculations) |
Les chiffres repris partout — 125B paramètres au total, 6B actifs par token et 51B pour les embeddings n-gram — viennent d’une fiche ModelScope brièvement affichée avant d’être raccourcie par l’équipe Qwen. Ils sont plausibles et cohérents d’un observateur indépendant à l’autre, mais ne constituent pas une documentation officielle pérenne. Comme l’a résumé ghosty, fondateur de SaaSCity :
« Toute personne qui publie aujourd’hui un graphique de benchmarks pour ce modèle l’a inventé. »
Une architecture qui va obliger les frameworks d’inférence à évoluer
Trois composants distinguent nettement Qwen3.8-Flash-Next du reste de la gamme Qwen actuelle. Chacun demande un véritable travail sur les kernels, et pas seulement l’ajustement d’un fichier de configuration.
Couches GDN : un état récurrent de taille fixe pour réduire le coût des longs contextes
Le Gated Delta Network (GDN) remplace l’attention standard dans la plupart des couches. Dans un transformer classique, le cache KV grossit avec la longueur de la séquence. Le GDN s’appuie au contraire sur un état récurrent de taille fixe. Dans ces couches, la mémoire reste donc constante quelle que soit la longueur du contexte, tandis que le coût de calcul évolue de manière linéaire plutôt que quadratique. Les couches à attention complète de cette architecture hybride conservent malgré tout un cache KV pour les recherches précises.
En pratique, les traitements impliquant de très longs contextes deviennent nettement moins coûteux. Une conversation de 100K tokens n’a pas besoin de réserver l’équivalent de 100K tokens en mémoire KV. D’après l’analyse communautaire de la fiche ModelScope, brièvement visible, la répartition annoncée pour l’architecture Qwen3.8 serait de 69 couches GDN pour 23 couches à attention complète, soit un ratio proche de 3:1. Les couches à attention complète préservent la qualité de récupération globale, tandis que les couches GDN assurent l’essentiel du traitement séquentiel.
Qwen n’en est pas à sa première expérience dans ce domaine. Qwen3-Next (septembre 2025) avait introduit Gated DeltaNet avec 80B paramètres au total et 3B actifs. Les familles Qwen3.5/3.6/3.7 auraient ensuite conservé un schéma hybride similaire. La nouveauté de Flash-Next tient à l’échelle : 125B paramètres au total avec cette architecture, auxquels s’ajoutent les deux composants suivants.
QSA : une attention clairsemée dont les détails restent à découvrir
Qwen Sparse Attention (QSA) est mentionnée sur la fiche, mais aucune explication détaillée n’a encore été fournie. Selon le consensus de la communauté, elle remplacerait l’attention dense par un schéma clairsemé : chaque token ne regarderait qu’un sous-ensemble des autres tokens, au lieu de parcourir toute la séquence. On ignore encore si le QSA repose sur une sparsité apprise, une organisation par blocs, des fenêtres glissantes ou une combinaison de ces approches. Le rapport technique permettra de déterminer s’il s’agit d’une amélioration progressive ou d’une véritable nouvelle primitive d’attention.
La table n-gram de 51B : du décodage spéculatif sans modèle brouillon séparé
La fonctionnalité la plus atypique est une table d’embeddings n-gram de 51B paramètres. L’hypothèse actuellement avancée par la communauté est qu’elle servirait de mécanisme rapide de recherche de tokens — en quelque sorte un modèle brouillon intégré pour le décodage spéculatif. Plutôt que d’exécuter un petit modèle distinct pour proposer les prochains tokens avant de les faire vérifier par le modèle principal, la table n-gram fournirait directement des candidats à faible coût.
Les inconnues restent nombreuses : la table doit-elle résider en VRAM ou peut-elle être projetée depuis la mémoire ? Quel sera son comportement une fois quantifiée ? Est-elle incluse dans les 125B paramètres ou comptée à part ? En attendant le rapport technique ou les premiers benchmarks communautaires, mieux vaut considérer le chiffre de 51B comme une variable de planification du déploiement, pas comme un coût définitif.
La place de Flash-Next dans la famille Qwen
Flash-Next suit une trajectoire parallèle plutôt qu’une progression linéaire :
| Modèle | Sortie | Paramètres totaux | Paramètres actifs | Rôle |
|---|---|---|---|---|
| Qwen3-Next | Sep 2025 | 80B | 3B | Premier test de l’architecture GDN |
| Qwen3.8-27B | Août 2026 | 27B (dense) | 27B | Modèle dense polyvalent de milieu de gamme |
| Qwen3.8-Max | Août 2026 | ~2.4T | ~95B | Modèle phare à poids ouverts |
| Qwen3.8-Flash-Next | 26 août 2026 | ~125B | ~6B | Aperçu de l’architecture de Qwen4 |
| Qwen4 | À déterminer (dans plusieurs mois) | Inconnu | Inconnu | Famille complète de nouvelle génération |
La règle empirique retenue par la communauté est la suivante : sqrt(125B x 6B) = 27B. Si elle se vérifie, Flash-Next pourrait offrir une qualité proche de celle d’un modèle dense de 27B, tout en mobilisant à l’inférence une puissance de calcul davantage comparable à celle d’un modèle de 6B. Comme l’a souligné Lucas Souza de Beer And Code, ce n’est qu’une règle de pouce, pas un théorème : la qualité du routage, celle des données et la contribution de la table n-gram n’ont pas encore été mesurées.
La stratégie, décrite dans plusieurs analyses communautaires comme un « platform play, not a benchmark play », consiste à permettre à des frameworks comme llama.cpp, vLLM et SGLang d’ajouter la prise en charge des kernels avant la sortie de Qwen4. Unsloth a annoncé travailler sur une prise en charge dès le premier jour.
Peut-on vraiment le faire tourner ? Le point sur le matériel nécessaire
| Format | Mémoire approximative pour les poids |
|---|---|
| BF16 / FP16 | ~250 Go |
| FP8 | ~125 Go |
| Q4 / 4 bits | ~65–70 Go |
Ces estimations concernent uniquement les poids, sans compter le contexte, le cache KV ni la surcharge du runtime. En Q4, le modèle demanderait environ 65–70 Go pour ses poids principaux, auxquels il faudrait ajouter la mémoire nécessaire à la table n-gram de 51B. Si cette table doit rester en VRAM, la configuration totale dépassera les capacités de la plupart des machines individuelles. Si elle peut être projetée depuis la RAM système, une machine dotée de 128 Go ou plus de mémoire unifiée — Mac Studio (M2 Ultra / M3 Ultra au maximum), AMD Strix Halo, NVIDIA DGX Spark — pourrait convenir. Une seule RTX 4090 ou 5090 ne suffira pas.
Sur Reddit, u/KURD_1_STAN a contesté l’idée d’un modèle « local-friendly » : « Avec des prix de la RAM aussi élevés, comment peut-on dire qu’il est adapté à un usage local ? » L’écart entre la communication autour des « 6B actifs » et les 250 Go de mémoire requis est bien réel. Sur X, @Dicklong1999 estime que le schéma d’activation clairsemé pourrait permettre une vitesse de génération raisonnable aux utilisateurs suffisamment équipés, mais ajoute qu’avec « 125B, les gens ordinaires peuvent pratiquement oublier l’exécution en local ».
Disponibilité et tarification via API : à quoi s’attendre
Au moment de la publication, ni le prix ni la disponibilité de Qwen3.8-Flash-Next via API n’avaient été annoncés. Qwen3.8-Max est facturé $2.00/M en entrée et $6.00/M en sortie, selon la page tarifaire officielle de Qwen ; avec 6B paramètres actifs, Flash-Next devrait être nettement moins cher. La variante FP8, qui divise par deux la mémoire nécessaire aux poids par rapport au BF16, constitue un format naturel pour le service via API. La disponibilité dépendra du niveau de prise en charge par les frameworks d’inférence : consultez les catalogues des fournisseurs après la publication des poids.
Que préparer avant la publication des poids
Si vous êtes développeur ou chercheur et que vous cherchez à déterminer l’intérêt de Qwen3.8-Flash-Next pour votre stack, voici la checklist à suivre :
1. Vérifiez votre matériel. Pour une exécution locale, assurez-vous de disposer d’au moins 128 Go de mémoire unifiée ou d’une configuration multi-GPU. Dans le cas contraire, prévoyez un accès via API.
2. Surveillez le dépôt Hugging Face. La fiche du modèle sera la première source fiable concernant les spécifications réelles, la licence et la longueur du contexte. Ajoutez huggingface.co/Qwen/Qwen3.8-Flash-Next à vos favoris.
3. Préparez votre pipeline d’évaluation. Gardez vos prompts de benchmark et vos scripts d’évaluation prêts avant la publication des poids. Les benchmarks communautaires des 24 premières heures en diront davantage que n’importe quel chiffre officiel.
4. Ne basculez pas vos workloads de production. Aucun benchmark indépendant n’existe encore. L’architecture est nouvelle, la prise en charge par les runtimes reste immature et la licence n’est pas confirmée. Utilisez-le pour l’évaluation, pas pour une tâche dont l’échec aurait un coût financier.
5. Si vous maintenez un outil d’inférence, commencez dès maintenant. La combinaison GDN + QSA demande un travail sur les kernels, pas une simple modification de configuration. Plus tôt vous comprendrez l’architecture, plus vite vous pourrez publier une prise en charge.
FAQ
Quand les poids seront-ils disponibles ?
Le compte à rebours de ModelScope indiquait le 26 août 2026, vers 23:00 UTC+8. Les miroirs Hugging Face apparaissent généralement dans les heures qui suivent une sortie sur ModelScope. L’équipe Qwen a confirmé le calendrier via ses canaux officiels : @Alibaba_Qwen a évoqué « la surprise que nous allons publier ce soir », tandis que @QwenDevs a nommé directement le modèle.
Est-ce Qwen4 ?
Non. Il s’agit d’un aperçu de l’architecture de Qwen4, publié sous la nomenclature Qwen3.8. Qwen4 lui-même est attendu dans plusieurs mois, et non dans quelques semaines. Flash-Next doit permettre à l’écosystème de préparer la prise en charge des runtimes avant l’arrivée de la famille complète.
Quelle licence sera utilisée ?
Ce n’est pas confirmé. Les récentes sorties Qwen à poids ouverts (Qwen3.8-27B, Qwen3.8-Max) utilisent la licence Apache 2.0, ce qui constitue l’issue la plus probable. Vérifiez la fiche du modèle lorsque les poids seront disponibles.
Puis-je l’exécuter sur une RTX 4090 ?
Non. Même en quantification Q4, les poids principaux nécessitent à eux seuls environ 65–70 Go. Une seule RTX 4090 dispose de 24 Go. Il faut une machine dotée d’au moins 128 Go de mémoire unifiée (Mac Studio, Strix Halo) ou plusieurs GPU disposant d’une grande quantité de VRAM.
Est-il plus performant que Qwen3.8-27B ?
Impossible à dire pour le moment. Aucun benchmark n’est disponible. L’heuristique sqrt(125B x 6B) = 27B laisse penser que la qualité pourrait être comparable à celle d’un modèle dense de 27B, mais il s’agit d’une estimation, pas d’une mesure. Attendez les évaluations indépendantes correspondant à votre cas d’usage.
À quelle vitesse fonctionnera-t-il ?
Le nombre de 6B paramètres actifs par token laisse penser que la génération sera plus proche de celle d’un petit modèle que de celle d’un mastodonte de 125B. Mais le schéma d’accès mémoire de la table n-gram et l’efficacité des kernels GDN restent inconnus. Les premiers benchmarks communautaires permettront de trancher.
Sera-t-il disponible sur les plateformes d’API ?
Presque certainement. La variante FP8 semble conçue pour le service via API. AIReiter et les autres plateformes ajoutent généralement les modèles Qwen dans les jours qui suivent la publication des poids. Le principal obstacle sera la prise en charge des nouveaux mécanismes d’attention par les frameworks.
Qu’est devenu Qwen3-Next, sorti l’an dernier ?
Qwen3-Next a été lancé en septembre 2025 avec 80B paramètres au total et 3B actifs, et a introduit Gated DeltaNet. Il s’agissait d’un test d’architecture à plus petite échelle, qui a montré que l’approche hybride GDN fonctionnait. Flash-Next en est la suite, avec un changement d’échelle. Sur X, un utilisateur, @LufzzLiz, a estimé que la série Next de l’an dernier « avait été une déception » — une raison de plus d’attendre les benchmarks avant de tirer des conclusions cette fois-ci.