 AIREITER
À l’approche de l’arrêt prévu par OpenAI le 26 août 2026, l’erreur la plus risquée serait de voir cette migration comme un simple changement de nom. L’abandon de l’Assistants API avait pourtant été annoncé un an à l’avance, dans l’avis de dépréciation du 26 août 2025, et son remplaçant est la Responses API. Sur le papier, les objets se correspondent assez bien. En pratique, l’orchestration change en profondeur, et certains développeurs ayant suivi le guide officiel ont tout de même introduit des régressions. Voici ce qui disparaît, ce que les correspondances masquent et quoi faire selon le délai dont vous disposez.
Le 26 août 2026 : ce qui s’arrête, ce qui reste
Toutes les familles d’endpoints Assistants renverront des erreurs après l’échéance. Cela couvre /v1/assistants, /v1/threads, les messages de thread, les runs et les run steps, ainsi que tout flux envoyant encore l’en-tête OpenAI-Beta: assistants=v2. Les configurations d’assistants et l’historique des threads ne seront plus accessibles via l’API.
Tout ce qui était rattaché à une intégration Assistants ne disparaît pas pour autant :
| Indisponible le 26 août 2026 | Toujours disponible |
|---|---|
Endpoints CRUD /v1/assistants | Vector stores et fichiers importés, réutilisables avec la recherche de fichiers de Responses |
/v1/threads, messages de thread | Chat Completions API, qui n’est pas concernée par cet arrêt |
| Runs et run steps | Responses API et Conversations API |
Flux OpenAI-Beta: assistants=v2 | Realtime API |
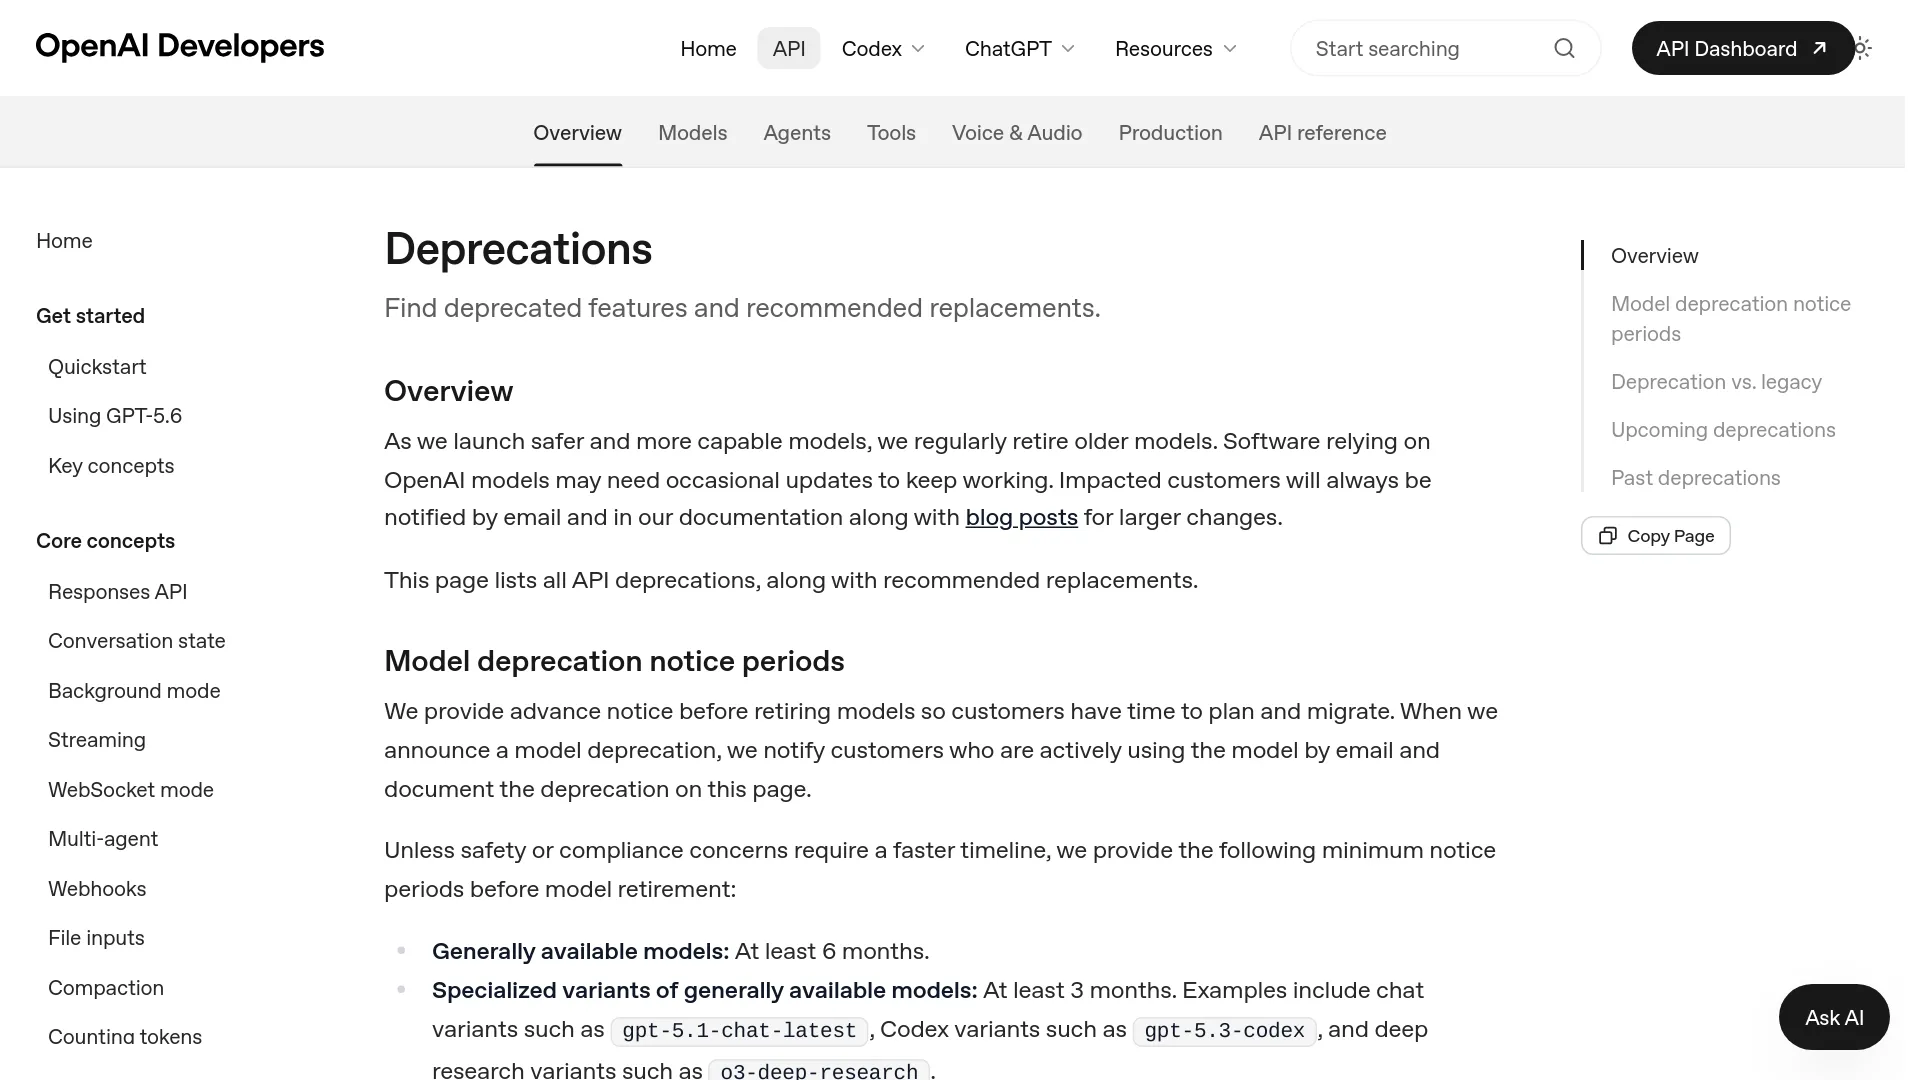
Le propre suivi des dépréciations d’OpenAI désigne Responses et Conversations comme les remplaçants prévus :
Les correspondances d’objets, et les deux détails qui changent tout
Le guide de migration d’OpenAI fait correspondre quatre concepts d’Assistants à leurs équivalents dans Responses :
| Assistants API | Remplacement | Ce qui change réellement |
|---|---|---|
Assistants | Prompts | La configuration devient un objet versionné créé depuis le tableau de bord |
Threads | Conversations | Stocke des items génériques — messages, appels d’outils, résultats — et pas seulement des messages |
Runs | Responses | La boucle création du run, polling et récupération devient un seul appel responses.create |
Run steps | Items | Un type union qui couvre les messages, appels de fonctions et résultats |
Cette simplification de la boucle apparaît dans les exemples officiels : un run terminé sur gpt-4.1 indique 34 tokens de prompt et 130 tokens de complétion, tandis qu’une response terminée sur gpt-5.5 indique 17 tokens d’entrée et 150 tokens de sortie. La charge de travail est comparable, mais les noms de champs ne le sont pas.
C’est le premier détail à ne pas négliger. Les tableaux de bord de facturation et parseurs de payloads fondés sur les anciens champs d’usage peuvent cesser de fonctionner sans bruit lorsque les noms changent :
| Champ Assistants | Champ Responses |
|---|---|
usage.prompt_tokens | usage.input_tokens |
usage.completion_tokens | usage.output_tokens |
max_completion_tokens / max_prompt_tokens | max_output_tokens |
truncation_strategy | truncation |
object: "thread.run" | object: "response" |
Le second détail relève de l’architecture. Les Prompts ne peuvent être créés que depuis le tableau de bord, pas par API. Cette contrainte casse les systèmes qui créent dynamiquement un Assistant par client, espace de travail ou ensemble de documents. Le guide officiel recommande lui-même de vérifier le calendrier de dépréciation des prompts avant d’adopter ces objets dans une intégration pérenne, car les objets de prompt réutilisables présentent leur propre risque d’obsolescence. Le modèle durable consiste à conserver les instructions, schémas d’outils et choix de modèle dans votre propre contrôle de source, puis à les transmettre à chaque requête. Concernant l’historique des threads, la position d’OpenAI tient en une phrase : « We will not provide an automated tool for migrating Threads to Conversations. »
Faire migrer les trois outils intégrés
Chaque outil Assistants possède une destination précise dans Responses, mais une part du travail bascule vers votre application :
| Outil Assistants | Son équivalent dans Responses | Ce que votre application doit désormais gérer |
|---|---|---|
| File search | Les vector stores sont conservés ; fournissez vector_store_ids dans la définition de l’outil au moment de la requête | Résoudre les bons identifiants de stores avant chaque appel |
| Code interpreter | Conteneur configuré avec type: "auto" | Cycle de vie du conteneur |
| Functions | La clé imbriquée function disparaît ; name, description et parameters remontent d’un niveau | La boucle d’outils : exécuter l’appel, renvoyer le résultat avec le call_id correspondant, décider s’il faut boucler |
Pour les applications multi-tenant, la ligne consacrée à la recherche de fichiers constitue le changement d’architecture le plus discret. Auparavant, un vector store par tenant était associé à l’objet Assistant lors de la configuration. Désormais, le tenant propriétaire de la session entrante doit être résolu vers les bons identifiants de store avant l’envoi de la requête.
Ce qui a cassé chez les équipes déjà migrées
OpenAI justifie ce changement par l’atteinte de la parité fonctionnelle par Responses. Les retours de migration ci-dessous montrent une parité au niveau des objets, mais une véritable refonte sous-jacente. Le propriétaire d’un SaaS de chatbot multi-tenant a documenté deux semaines de migration sur r/aiagents ; les problèmes ont subsisté malgré une lecture fidèle du guide officiel :
J’ai dû modifier chaque champ optionnel en
["type", "null"], ce qui ressemble à un contournement du système de types. — u/aidenclarke_12
Les schémas d’outils stricts imposent de déclarer les propriétés optionnelles comme nullable et de les conserver dans required. Les schémas s’allongent, et chaque handler qui interprétait une propriété absente comme absente doit être revu. Le même développeur a identifié le point où se situe le changement le plus profond :
Le changement dans le raccordement des vector stores est la véritable évolution architecturale. — u/aidenclarke_12
Le streaming est le deuxième point de rupture silencieux. Le streaming des runs Assistants ne s’adapte pas directement à Responses : il faut le réécrire autour d’événements server-sent typés comme response.created, response.output_text.delta, response.completed et response.function_call_arguments.delta / .done. Les événements de fin sont explicites et les appels d’outils suivent de nouveaux formats ; leurs noms sont recensés dans cette couverture de la migration. Les proxies SSE comme les handlers côté client doivent être réécrits, logique de reconnexion comprise.
Le troisième frein tient davantage au retard de l’écosystème qu’à l’API elle-même :
L’API Responses existe depuis longtemps, mais beaucoup de frameworks et de SDK ne la prennent toujours pas en charge. — u/zhlmmc
Si votre pile repose sur un framework d’agents qui suppose encore le modèle Threads/Runs, comme celui auquel u/zhlmmc s’est heurté, prévoyez du temps pour cette couche autant que pour votre propre code d’intégration.
Gérer l’état : chaînage, Conversations ou relecture manuelle
Responses offre trois façons de conserver le contexte sur plusieurs tours, qui ne sont pas interchangeables :
| Stratégie | Adaptée à | Point de vigilance |
|---|---|---|
previous_response_id | Chaînage le plus simple, avec un minimum de réécriture | Le contexte antérieur reste facturé comme entrée |
| Conversations API | Équivalent le plus proche de Threads ; historique côté serveur | Vous devez développer vous-même le backfill ; aucun outil fournisseur n’est prévu |
Relecture manuelle, store: false | ZDR et exigences strictes de conservation | Vous gérez tout l’état ; les reasoning items doivent être retransmis |
Pour l’historique, OpenAI recommande la séquence suivante pour convertir un ancien thread :
- Listez les messages du thread dans l’ordre croissant.
- Convertissez chaque message texte utilisateur en
input_text. - Convertissez chaque message texte assistant en
output_text. - Convertissez les contenus d’URL d’image en
input_image, en conservantimage_urletdetail. - Créez la Conversation avec les
itemsconvertis.
Une erreur de correspondance des rôles entraîne un comportement précis : le modèle interprète ses propres réponses passées comme de nouvelles instructions utilisateur. Les responses stockées ont une durée de conservation par défaut de 30 jours, sauf si vous passez store: false. Les conversations ne sont pas soumises à ce TTL des responses et aucune durée distincte n’était publiée à la fin juillet 2026, selon la couverture de migration qui a suivi le sujet. C’est un détail important si vos engagements de confidentialité promettent un délai de suppression.
L’impact de la migration sur votre facture de tokens
Deux éléments de facturation comptent particulièrement.
D’abord, previous_response_id apporte de la simplicité, pas une remise. Le guide de migration vers Responses d’OpenAI précise que les tokens d’entrée des réponses précédentes dans la chaîne restent facturés comme tokens d’entrée. Les conversations longues voient donc leur coût progresser linéairement sans mécanisme d’élagage.
Ensuite, les entrées mises en cache coûtent nettement moins cher que les entrées non mises en cache : environ un dixième du tarif d’entrée sur les gammes GPT-5.x telles qu’elles étaient listées en juillet 2026, ainsi qu’une utilisation du cache supérieure de 40 à 80 % avec Responses par rapport à Chat Completions lors de tests internes rapportés par OpenAI, d’après la couverture compilée. Considérez cette fourchette d’utilisation comme une donnée fournisseur tant que vos propres tableaux de bord ne l’ont pas confirmée. La comparaison qui compte est votre nombre de tokens par session, avant et après le basculement.
Si cette migration est aussi l’occasion de revoir la tarification de la charge GPT-5.x elle-même, le détail des tarifs de GPT-5.6 explique le calcul par token, tandis que des endpoints compatibles OpenAI comme la page API de GPT-5.6 exécutent les mêmes charges de travail de type Responses pour une comparaison directe.
Un plan de migration selon le temps qu’il vous reste
Il reste 1 à 6 jours. Commencez par la sauvegarde : listez les assistants et vector stores avec limit=100, récupérez vos fichiers, sérialisez les objets SDK avec model_dump(). Les guides privilégiant la sauvegarde signalent une limite importante : il n’existe pas d’endpoint pour lister les threads. Vous ne pouvez donc exporter que les identifiants de thread déjà enregistrés par votre application. Basculez ensuite derrière un flag : les nouvelles sessions passent immédiatement à Responses, tandis que les anciens threads ne sont migrés à la demande que lorsqu’un utilisateur les rouvre.
Une semaine ou plus. Migrez de bout en bout un flux à faible risque avant de toucher au reste. Reconstruisez la boucle d’outils et vérifiez que chaque résultat de fonction porte le call_id correspondant ; remplacez la gestion du streaming par une logique de branchement selon le type d’événement ; comparez ensuite comportement, latence, consommation de tokens et taux d’erreur avec la référence Assistants avant d’augmenter le trafic.
Après l’échéance. Les endpoints renverront des erreurs et les configurations d’assistants auront disparu côté API. La récupération consistera à reconstruire depuis ce que conservent votre base de données applicative et vos sauvegardes ; les vector stores et fichiers resteront accessibles via la recherche de fichiers.
Le compromis non résolu est le suivant : vous échangez un cycle de vie géré par le serveur — polling, troncature, boucle d’outils — contre un modèle à appel unique dont l’orchestration est visible et testable. Un développeur ayant livré des produits avec les deux approches le résume ainsi :
L’API Responses est le compromis idéal : elle gère les tâches lourdes tout en restant assez flexible pour prendre en charge ses propres fonctionnalités. — u/landongarrison
FAQ sur l’arrêt de l’OpenAI Assistants API
La Chat Completions API s’arrête-elle aussi ?
Non. Chat Completions ne fait pas partie de l’arrêt du 26 août 2026, et les recommandations d’OpenAI prévoient une migration vers Responses flux par flux, sans échéance imposée.
OpenAI migrera-t-il automatiquement mes threads existants ?
Non. Le guide officiel l’indique sans ambiguïté : « We will not provide an automated tool for migrating Threads to Conversations. » Le backfill relève du code de votre application, en suivant la séquence de conversion des items décrite plus haut.
Puis-je continuer à utiliser l’Assistants API après le 26 août 2026 ?
Non. Les assistants, threads, messages, runs et run steps renverront tous des erreurs après cette date, y compris les flux assistants=v2. Exportez tout ce dont vous avez besoin avant l’échéance.
Les responses stockées expirent-elles ?
Oui. Les responses stockées ont une fenêtre de conservation par défaut de 30 jours, sauf si vous passez store: false. Les conversations restent hors de ce TTL, d’après les informations publiées en juillet 2026.
Dois-je transférer la configuration de mon assistant vers Prompts ?
Non, et vous ne devriez pas le faire pour des assistants générés dynamiquement. Les Prompts ne peuvent être créés que depuis le tableau de bord, et le guide officiel invite lui-même à examiner la dépréciation des objets de prompt réutilisables. Conserver les instructions et schémas d’outils dans votre contrôle de source, puis les transmettre à chaque requête, constitue l’approche pérenne.