 AIREITER
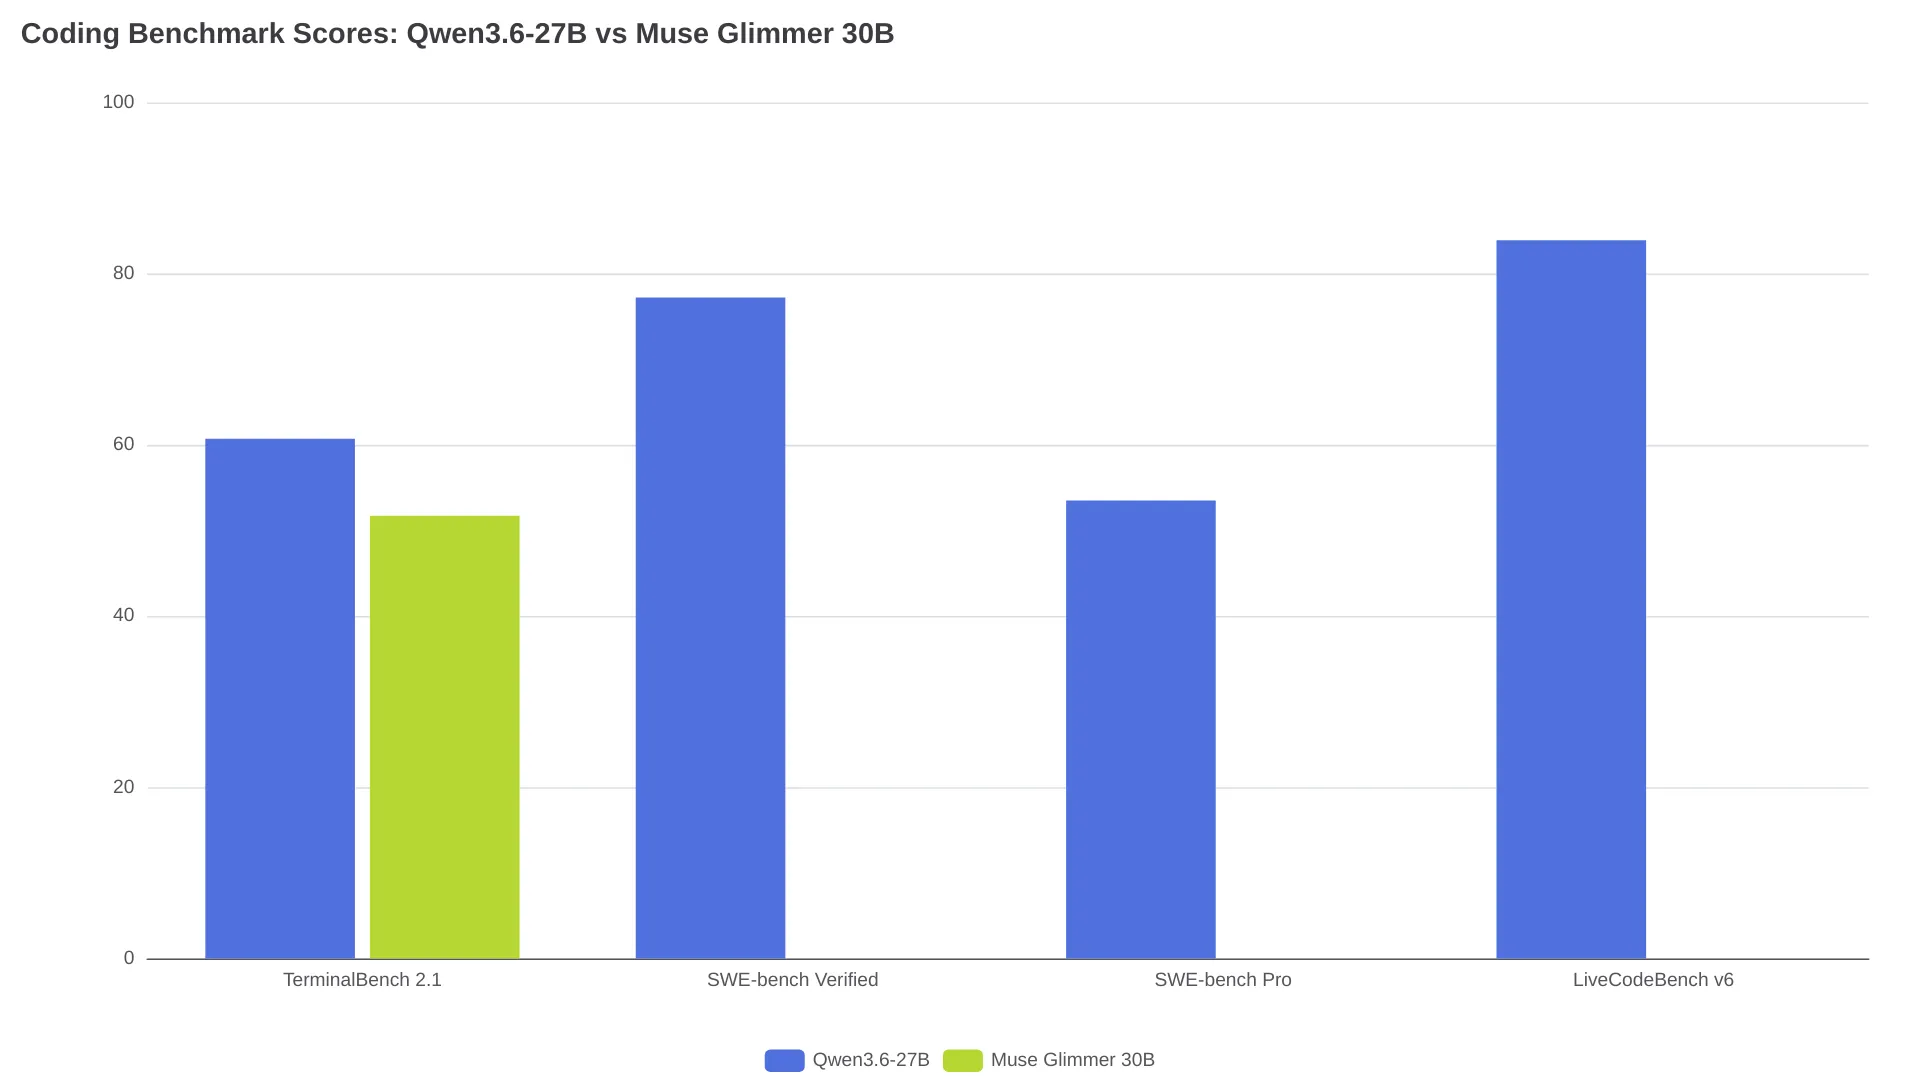
Lancé en avril 2026, Qwen3.6-27B est arrivé avec une table complète de résultats sur sa model card Hugging Face. Muse Glimmer 30B lui a emboîté le pas en août 2026, sous la forme d'une publication Meta à poids ouverts, puis la communauté des LLM locaux a rapidement commencé les comparatifs directs. Les chiffres bruts favorisent Qwen : 60,7 sur TerminalBench 2.1, contre 51,7 pour Glimmer, ainsi qu'un score officiel de 77,2 sur SWE-bench Verified. Mais Glimmer dispose d'un atout VRAM qui peut faire toute la différence si vous n'avez qu'un seul GPU.
TerminalBench 2.1 : Qwen conserve 9 points d'avance
TerminalBench évalue la fiabilité d'un agent en ligne de commande sur des tâches à étapes multiples : usage d'outils, maintien du contexte et exécution sur des sessions prolongées. Dans les discussions communautaires liées, TerminalBench 2.1 est régulièrement cité comme le résultat disponible pour comparer les deux agents de code.
Scores TerminalBench 2.1 rapportés par la communauté dans les échanges r/LocalLLaMA des 10 et 11 août 2026 :
| Modèle | TerminalBench 2.1 | Type de source |
|---|---|---|
| Qwen3.6-27B | 60.7 | Rapporté par la communauté |
| Muse Glimmer 30B | 51.7 | Rapporté par la communauté |
| Gemma 4 31B | 43.4 | Rapporté par la communauté |
Une réserve importante : TerminalBench évalue l'ensemble modèle + harness, et non le modèle de base isolément. La fiche officielle de Qwen3.6-27B indique un harness Harbor/Terminus-2 avec un délai maximal de 3 heures, 32 CPU, 48 GB de RAM, 80K tokens de sortie au maximum, 256K de contexte et une moyenne sur cinq exécutions. Le score de Glimmer peut provenir d'une configuration de harness différente ou moins optimisée. L'écart de 9 points peut donc se resserrer, ou au contraire s'accentuer, selon votre configuration d'agent.
Benchmarks de code publiés : Qwen documenté, Glimmer encore absent
Qwen3.6-27B affiche des scores officiels sur sa model card. Dans les sources examinées pour cette comparaison, aucun résultat officiel SWE-bench, LiveCodeBench ou benchmark comparable de code agentique n'a été trouvé pour Muse Glimmer en août 2026. Qwen s'appuie donc sur un dossier de preuves publiées plus solide, mais il n'existe pas encore de confrontation officielle parfaitement comparable entre les deux modèles.
Les benchmarks de code officiels de Qwen :
| Benchmark | Qwen3.6-27B (officiel) |
|---|---|
| SWE-bench Verified | 77.2 |
| SWE-bench Pro | 53.5 |
| SWE-bench Multilingual | 71.3 |
| Terminal-Bench 2.0 | 59.3 |
| LiveCodeBench v6 | 83.9 |
Ces résultats sont publiés par l'éditeur. La model card précise que les évaluations SWE-bench utilisent le scaffold interne de Qwen pour bash et l'édition de fichiers, avec une température de 1.0, un top-p de 0.95 et une fenêtre de contexte de 200K. Les résultats SWE-bench Pro ont été calculés sur un ensemble de tâches affiné, dans lequel Qwen a corrigé des éléments problématiques : la comparaison directe avec les classements publics n'est donc pas forcément strictement équivalente. Une analyse tierce de morphllm souligne par ailleurs que ces scores reposent sur le scaffold agentique de Qwen, avec peu de reproductions indépendantes.
Tests de code en conditions réelles : les retours en local
Test OpenCode en Q4 sur M5 Pro
Un développeur a testé Muse Glimmer en quantification Q4 (build Unsloth) sur un M5 Pro doté de 48 GB de RAM, via OpenCode. Le modèle occupait environ 20 GB de RAM et générait 17 tokens par seconde. Sa conclusion :
"Globalement, il reste en dessous de Qwen3.6 27B" - u/curiousily_
Les productions de code frontend et backend ont été jugées inférieures à celles de Qwen. L'auteur relève toutefois un point positif : Muse Glimmer n'a échoué sur aucun appel d'outil pendant le test. Aucune boucle de raisonnement ni réflexion étendue n'était configurée, ce qui a pu brider ses performances.
Le piège de max_tokens
Un autre testeur, sur r/LocalLLM, a constaté que Muse Glimmer pouvait paraître bien moins performant qu'il ne l'est lorsque le budget de tokens de sortie est trop faible. Le modèle consomme alors ce budget pendant son raisonnement avant de produire une réponse visible, ce qui aboutit à des réponses vides ou tronquées. En augmentant max_tokens, son harness est passé de 6/13 à 11/13 tâches réussies, soit presque le double, sans changer de modèle. Avec les limites de sortie par défaut, vous risquez donc de mesurer votre configuration plutôt que Glimmer.
Des boucles terminal avec Hermes
Un autre utilisateur a signalé que Muse Glimmer s'enlisait dans un nombre excessif de commandes terminal lorsqu'il était associé au framework d'agent Hermes, un comportement qu'il n'avait pas rencontré avec Qwen3.6-27B dans la même configuration. Cette anecdote va dans le même sens que l'écart observé sur TerminalBench, sans pour autant permettre d'isoler la responsabilité du modèle de celle de la configuration Hermes.
Efficacité en tokens : un avantage encore qualitatif
Le post de galerie de benchmarks de u/NoFaithlessness951 soulève une autre piste, celle de l'efficacité :
"Un peu moins intelligent que Qwen, mais beaucoup moins de tokens par tâche." - u/NoFaithlessness951
Il s'agit d'une observation qualitative de la communauté, et non d'une mesure contrôlée du nombre de tokens par tâche réussie. Aucune étude directe n'a encore quantifié l'avantage de Glimmer sur Qwen en utilisant les mêmes tâches, taux de réussite et données de latence. Il faut donc considérer cette efficacité comme une piste prometteuse, pas comme un fait établi.
VRAM et contexte : l'avantage matériel de Glimmer
C'est sur ce terrain que Muse Glimmer prend clairement l'avantage. Un testeur sur r/LocalLLaMA a montré que Muse Glimmer 30B en Q4_K_XL, avec décodage spéculatif DFlash, projecteur multimodal et cache KV F16 complet, tenait dans environ 22-23 GB sur une seule RTX 3090, avec une fenêtre de contexte configurée à 262 144 tokens.
Même RTX 3090, même quantification Q4_K_XL :
| Modèle | Contexte KV F16 | Contexte KV Q8 | VRAM utilisée |
|---|---|---|---|
| Muse Glimmer 30B | 262,144 | N/A | ~22-23 GB |
| Qwen3.6-27B | 70,000 | 125,000 | Tient dans 24 GB |
| Gemma 4 31B | 52,000 | 81,000 | Tient dans 24 GB |
L'auteur qualifie les 70K de contexte F16 de Qwen de "à la limite de l'inutilisable" pour les flux de travail qui injectent dans le prompt le contexte d'un vaste dépôt de code.
Débits rapportés pour Muse Glimmer sur cette RTX 3090 :
- Génération : 64-124 tokens/seconde, selon qu'il s'agit de code ou de prose
- Traitement du prompt : ~1,400 tokens/seconde
- Récupération en long contexte : test two-needle haystack réussi dès le premier essai à ~150K tokens
Sur le même matériel, Qwen3.6-27B nécessite soit la compression du cache KV en Q8, au prix de la fidélité de sortie pour gagner en contexte, soit un déport sur une machine plus puissante. Le testeur indique avoir basculé Qwen sur son DGX Spark lorsqu'il avait besoin du contexte complet, un appareil nettement plus coûteux.
Sur du matériel haut de gamme, un build Qwen3.6-27B NVFP4 sur DGX Spark a atteint 28-33 tokens par seconde en session unique, avec des contextes allant jusqu'à 128K, selon l'analyse de benchmarks de kie.ai. Un build Unsloth Muse Glimmer Q5_K_M sur RTX 5090 aurait quant à lui atteint 220-253 tokens par seconde pour la génération de correctifs de code, par le biais d'un chemin DFlash llama.cpp modifié.
Quel modèle choisir selon votre usage ?
| Votre scénario | Choix | Pourquoi |
|---|---|---|
| Code uniquement, génération ponctuelle | Qwen3.6-27B | Des preuves plus solides dans les benchmarks de code publiés ; en tête dans la comparaison communautaire disponible sur TerminalBench 2.1 |
| Code agentique à très grand contexte sur un seul GPU de 24 GB | Muse Glimmer 30B | 262K de contexte F16 contre 70K pour Qwen sur le même matériel, avec la configuration Q4_K_XL/DFlash |
| Tâches terminal de longue durée | Qwen3.6-27B | 60.7 contre 51.7 sur TerminalBench 2.1 ; signalement communautaire de boucles dans un framework d'agent avec Glimmer |
| Travail à gros volume sensible aux coûts | Muse Glimmer 30B (potentiellement) | Un retour communautaire suggère moins de tokens par tâche ; aucune comparaison équivalente du coût par réussite |
| Code à l'échelle d'un dépôt avec gros contexte | Muse Glimmer 30B (si la VRAM est limitée) | Qwen requiert une compression KV Q8 ou plusieurs GPU pour un grand contexte avec 24 GB |
| Précision de code maximale, matériel sans contrainte | Qwen3.6-27B | Benchmarks publiés plus solides et scores officiels |
FAQ
Muse Glimmer a-t-il un score SWE-bench officiel ?
Aucun score officiel SWE-bench, LiveCodeBench ou TerminalBench pour Muse Glimmer 30B n'a été trouvé dans les sources examinées pour cette comparaison en août 2026. Le score de 51.7 sur TerminalBench 2.1 provient de tests communautaires dans des fils Reddit, et non d'une évaluation officielle de Meta.
Les deux modèles peuvent-ils tourner sur une seule RTX 3090 ?
Oui. Muse Glimmer 30B en Q4_K_XL tient avec 262K de contexte et un cache KV F16 complet dans ~22-23 GB. Qwen3.6-27B en Q4_K_XL tient également, mais se limite à 70K de contexte F16, ou 125K avec compression du cache KV en Q8, sur ce même GPU.
Muse Glimmer est-il censuré pour les tâches de code ?
Un utilisateur a rapporté que Muse Glimmer refusait d'aider à déboguer du code Python de contrôle de souris, en l'interprétant comme un possible problème de sécurité. Il s'agit d'un seul témoignage anecdotique, dont le prompt système et la configuration ne sont pas précisés. Cela ne suffit pas à déterminer si ce comportement vient du modèle lui-même ou du dispositif d'inférence.
Quel modèle est le meilleur pour les workflows de code agentique ?
Qwen3.6-27B semble plus fiable pour les tâches d'agent terminal sur la durée, d'après les scores TerminalBench et les retours de la communauté. Muse Glimmer 30B est plus adapté à du matériel contraint grâce à son efficacité VRAM et pourrait utiliser moins de tokens par tâche, ce qui pourrait réduire les coûts et la latence dans des boucles d'agents à fort volume. Aucune comparaison contrôlée ne l'a toutefois encore quantifié.
Quelle valeur de max_tokens utiliser pour coder avec Muse Glimmer ?
Prévoyez un budget de sortie généreux. Un testeur a constaté que des limites max_tokens trop strictes poussaient Glimmer à épuiser son budget durant le raisonnement avant de produire une réponse visible, donnant des réponses vides ou tronquées qui ressemblaient à des échecs. En relevant la limite, son harness est passé de 6/13 à 11/13 tâches réussies. La model card de Qwen3.6-27B recommande 32,768 tokens pour les requêtes générales et 81,920 pour les tâches de benchmark difficiles ; en attendant que Meta publie ses propres recommandations, ce même budget de sortie constitue un point de départ raisonnable pour Glimmer.