 AIREITER
Peut-on remplacer Qwen 3.6 27B par un modèle multimodal dense de 30B paramètres sur une machine grand public ? Depuis l’arrivée de Muse Glimmer, le 10 août 2026, la communauté de l’IA locale s’est empressée de le mettre à l’épreuve. Le bilan est nuancé : il tient sur une seule RTX 3090 avec l’intégralité de ses 262K de contexte, atteint 236 tok/s sur RTX 5090 avec DFlash, mais reste 9 points derrière Qwen 3.6 27B dans TerminalBench 2.1 et refuse volontiers les tâches d’automatisation au niveau du système d’exploitation.
Muse Glimmer 30B : de quoi parle-t-on ?
Muse Glimmer est un modèle multimodal dense de 30B paramètres, publié par Meta Superintelligence Labs sous licence Apache 2.0. Son objectif n’est pas de dominer les classements de programmation, mais de servir d’agent local et persistant. Il associe un décodeur texte de 27,9B paramètres, un encodeur visuel ViT de 1,9B et un projecteur multimodal fondé sur GELU, ce qui lui permet de traiter texte et images. Les détails d’architecture ci-dessous proviennent du billet de prise en charge Day-0 de SGLang.
L’architecture en bref
| Caractéristique | Détail |
|---|---|
| Paramètres totaux | 30B |
| Décodeur texte | 27,9B dense |
| Encodeur visuel | ViT 1,9B |
| Couches Transformer | 52 |
| Attention | Grouped-query (32 têtes de requête, 2 têtes KV - GQA 16:1) |
| Feed-forward | SwiGLU |
| Fenêtre de contexte | 128K+ (testée jusqu’à 262K) |
| Licence | Apache 2.0 |
L’architecture repose sur un schéma d’attention hybride : trois couches d’attention à fenêtre glissante de 2 048 tokens, puis une couche d’attention sur la séquence complète toutes les quatre étapes. Les couches locales utilisent RoPE, tandis que l’attention globale s’appuie sur NoPE, ce qui autorise une extension du contexte au-delà de la limite d’entraînement. Le ratio GQA de 16:1 réduit fortement le cache KV : une mesure de la communauté relève environ 1,8 GiB pour 131K tokens en F16. C’est ce qui permet au modèle de conserver le contexte complet sur un GPU de 24 GB, là où Qwen 3.6 27B plafonne à 70K tokens dans la même configuration F16.
Votre matériel peut-il faire tourner Muse Glimmer ?
Tout dépend surtout de la quantification choisie. SGLang propose des checkpoints officiels en BF16, NVFP4+MXFP8, GGUF Q4_K_M, GGUF Q4K-Dynamic et MLX 4-bit. Des testeurs de la communauté ont également descendu le modèle jusqu’au GGUF 2 bits pour les configurations à VRAM très limitée.
VRAM nécessaire selon la configuration
| Configuration | VRAM approximative | Matériel visé |
|---|---|---|
| BF16 | ~60 GB | H100 seule |
| NVFP4 + MXFP8 | ~19,5 GB | RTX 5090 / DGX Spark |
| NVFP4 + BF16 DFlash | 18 GB + 5 GB pour le speculator | RTX 5090 |
| Q4_K_XL + DFlash + mmproj + contexte 262K | ~22-23 GB | RTX 3090 (24 GB) |
| GGUF 2 bits | ~14 GB | RTX 4060 Ti / entrée de gamme |
| MLX Q4 (Apple Silicon) | Mémoire unifiée | Mac mini / MacBook Pro |
Un utilisateur de Reddit a démontré que Muse Glimmer en Q4_K_XL, avec décodage spéculatif DFlash, fichier de projection multimodale et cache KV F16, tient confortablement dans 22-23 GB sur une seule RTX 3090, avec le contexte complet de 262 144 tokens activé. Il a retrouvé deux aiguilles dans une botte de foin d’environ 150K tokens dès le premier essai.
À titre de comparaison, Qwen 3.6 27B ne monte qu’à 70K tokens sur cette même RTX 3090 avec cache KV F16, ou 125K avec cache KV Q8. Gemma 4 31B atteint 52K en F16, ou 81K en Q8. L’efficacité du cache KV liée au ratio GQA 16:1 de Muse Glimmer explique principalement cet avantage de contexte à matériel égal.
Options d’installation : sur NVIDIA, utilisez SGLang ou llama.cpp avec le checkpoint NVFP4 ou GGUF, puis activez --speculative-algorithm DFLASH. Sur Apple Silicon, passez par le backend MLX, DFlash n’y étant pas disponible. Un utilisateur de M3 Max avec 96 GB de mémoire unifiée a rapporté 17 tokens/s et indiqué que Muse Glimmer était plus rapide que Qwen comme Gemma sur sa machine.
Quelle vitesse attendre de Muse Glimmer ?
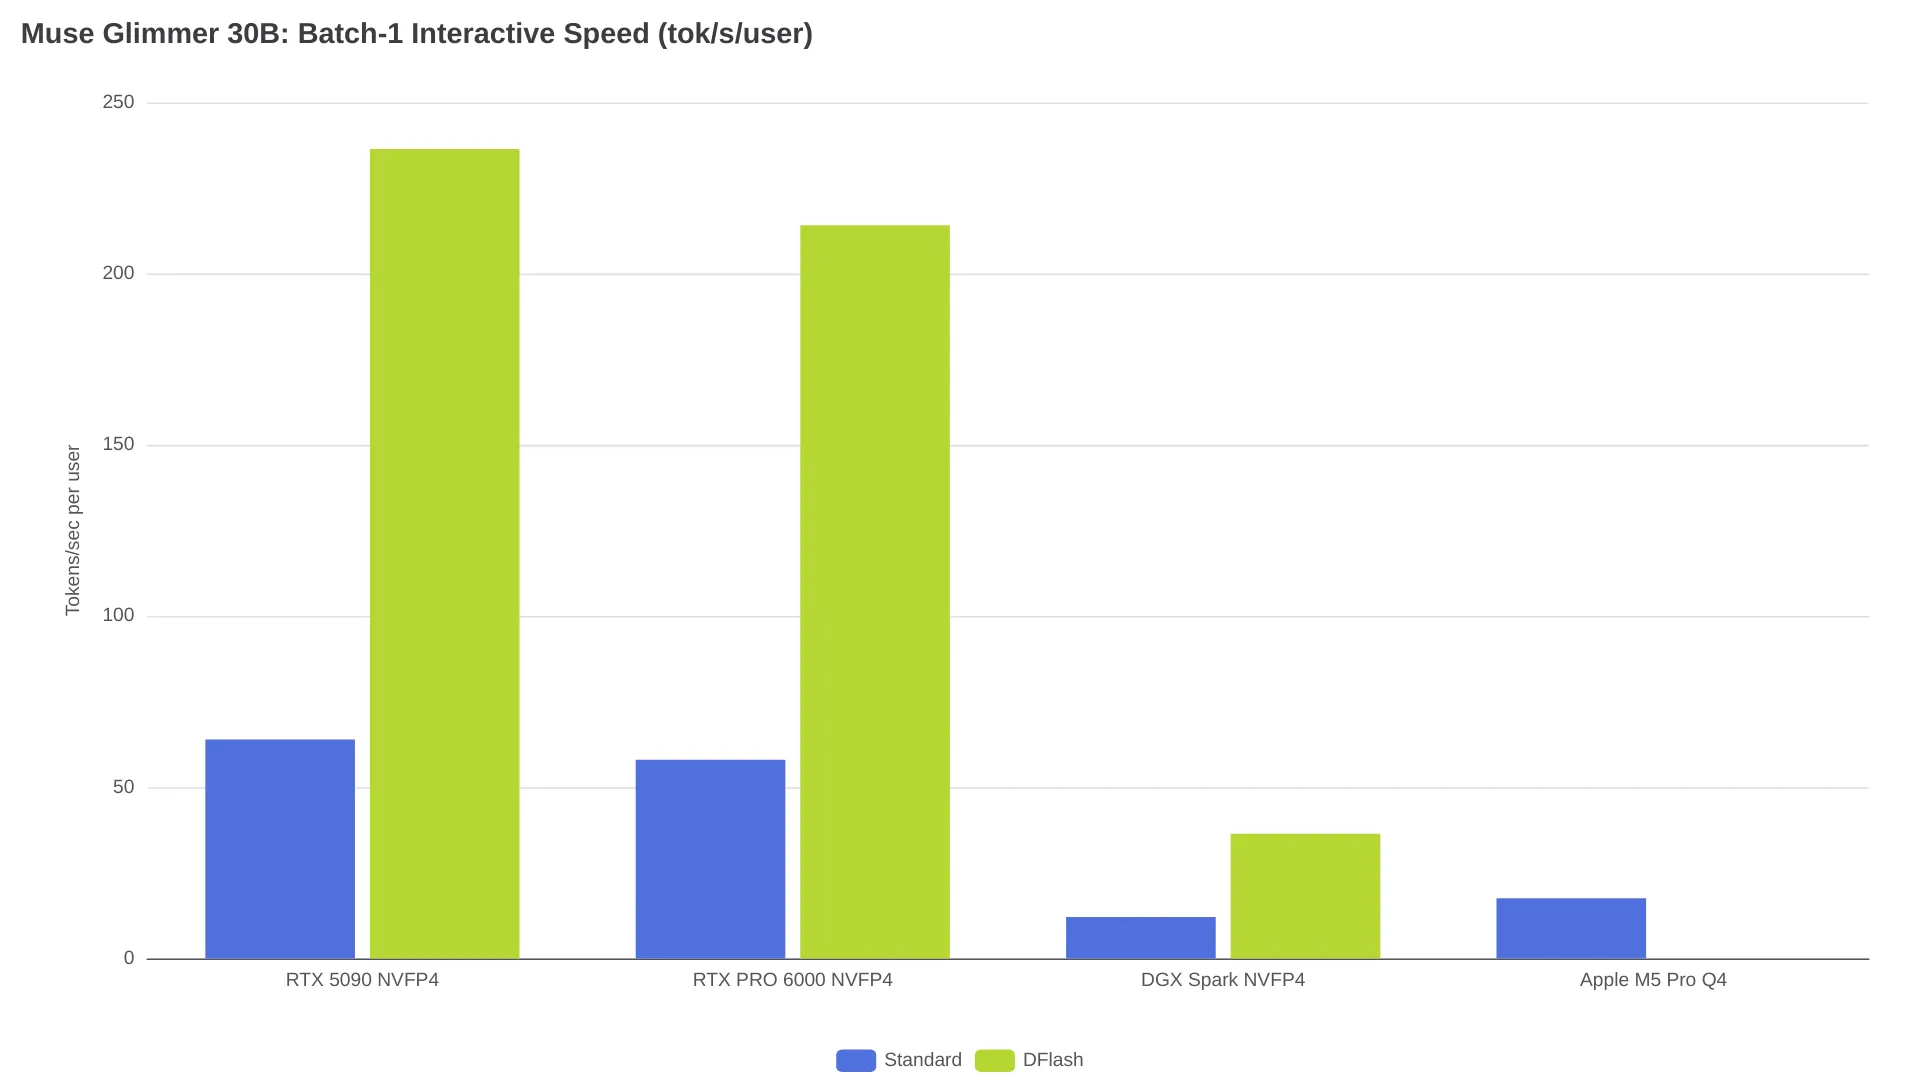
SGLang a publié un tableau de benchmarks sur sept configurations matérielles, avec des tailles de batch de 1 à 8. Le décodage spéculatif DFlash, activé avec --speculative-algorithm DFLASH, apporte un gain de 1,9x à 4,3x sur le débit interactif en batch 1 sur les plateformes NVIDIA.
Les chiffres SGLang à retenir
| Plateforme | Précision | Décodage | tok/s/utilisateur en batch 1 | tok/s en batch 8 |
|---|---|---|---|---|
| NVIDIA B300 | BF16 | DFlash | 308,51 | 261 |
| RTX 5090 | NVFP4 | DFlash | 236,4 | 1 452 |
| RTX 5090 | Q4_K_M | DFlash | 140,7 | 332 |
| RTX PRO 6000 | NVFP4 | DFlash | 214,11 | 403 |
| DGX Spark | NVFP4 | DFlash | 36,4 | 301 |
| Apple M5 Pro | Q4 | Standard | 17,6 | 56,9 |
Les 1 452 tokens de sortie/s en batch 8 sur RTX 5090 correspondent à un débit agrégé. Pour l’inférence locale mono-utilisateur, le chiffre pertinent est donc 236 tok/s avec DFlash en NVFP4. Sans DFlash, cette même configuration tombe à 63,9 tok/s. Les retours de la communauté vont dans le même sens : un utilisateur de RTX 5090, avec la quantification Q5_K_M d’Unsloth, a mesuré 220 à 253 tokens/s.
Les performances de DFlash dépendent du taux d’acceptation des propositions du modèle brouillon : des utilisateurs sur Vulkan/RX 7900 XTX et SYCL/B70 ont tous deux signalé une faible acceptation et un débit global plus lent.
Muse Glimmer ou Qwen 3.6 27B : lequel choisir ?
Résultats dans TerminalBench 2.1
| Modèle | TerminalBench 2.1 | Contexte sur RTX 3090 (KV F16) |
|---|---|---|
| Qwen 3.6 27B | 60,7 | ~70K tokens |
| Muse Glimmer 30B | 51,7 | ~262K tokens |
| Gemma 4 31B | 43,4 | ~52K tokens |
Scores TerminalBench 2.1 cités dans une discussion communautaire. Chiffres de contexte issus de tests sur RTX 3090.
Qwen 3.6 27B conserve 9 points d’avance dans TerminalBench 2.1, le benchmark que la communauté considère le plus déterminant pour juger la capacité d’un modèle à exécuter des commandes de terminal fiables sur des tâches longues. L’écart se retrouve dans les essais directs de programmation : la suite d’évaluation privée d’un utilisateur a attribué 12/13 à Qwen contre 11/13 à Glimmer. Qwen a aussi généré correctement, dès le premier essai, une page de tourisme sur Tokyo de 953 lignes, quand Glimmer en a produit moins de 200 (fil complet).
« Même pas comparable à Qwen 3.6 27B » — utilisateur Reddit BarberIcy366, après que Glimmer n’a généré que 220 lignes de HTML pour un jeu de billard américain à 8 billes tout en consommant 21 000 tokens (r/LocalLLaMA). Le même fil rapporte que Qwen 3.6 27B a réalisé une implémentation de Tetris 1,7x plus vite avec MTP activé.
Glimmer garde toutefois de vrais atouts dans certains cas :
- Capacité de contexte : 262K tokens sur une RTX 3090 unique, contre 70K pour Qwen avec le même réglage KV F16, soit un avantage de 3,7x pour les grands codebases.
- Efficacité du cache KV : son ratio GQA 16:1 réduit considérablement le cache KV et libère davantage de VRAM pour le contexte.
- Vision intégrée : Glimmer est multimodal dès l’origine ; Qwen 3.6 27B est uniquement textuel dans sa version de base.
- MCP et questions-réponses avec outils : un utilisateur indique que, s’il est derrière Qwen pour le code dans le terminal, Glimmer semble prometteur pour la recherche dans un codebase et les flux de questions-réponses assistés par MCP.
- Qualité rédactionnelle : plusieurs utilisateurs préfèrent les réponses en langage naturel de Glimmer à celles de Qwen.
Un commentaire résume ainsi le compromis : Glimmer, c’est « Qwen 3.6 27B avec 5 % de style rédactionnel en plus et 5 % de capacité agentique en moins ».
Le verdict
Si votre charge principale repose sur le code produit en une seule passe ou les agents autonomes en terminal, Qwen 3.6 27B reste le meilleur choix : il obtient 9 points de plus dans TerminalBench 2.1 et ne souffre pas des refus de sécurité qui handicapent Glimmer pour l’automatisation au niveau de l’OS. Si vous avez besoin de recherche en contexte long, d’entrées multimodales ou de flux assistés par MCP sur un seul GPU grand public, Muse Glimmer mérite un essai. Pour une automatisation terminal fiable, mieux vaut attendre les fine-tunes de la communauté.
Points de vigilance et problèmes connus
Le piège de max_tokens
Muse Glimmer consacre une part importante de son budget de tokens à son raisonnement interne avant de fournir sa réponse. Avec un paramètre max_tokens trop bas, il peut épuiser son budget en pleine réflexion et renvoyer une réponse vide. Un utilisateur lui avait d’abord attribué 6/13 dans sa suite d’évaluation ; en augmentant le budget de tokens de sortie, le score est passé à 11/13 (fil source). Réglez max_tokens suffisamment haut pour absorber ce surcoût de raisonnement, faute de quoi les réponses risquent de s’interrompre en cours de route.
Des refus pour l’automatisation au niveau de l’OS
Plusieurs utilisateurs signalent que Muse Glimmer refuse les tâches impliquant le contrôle de la souris, l’automatisation du clavier ou d’autres appels d’outils au niveau du système d’exploitation. Le modèle les présente comme des risques de sécurité potentiels, même lorsque la demande se limite à l’usage classique de bibliothèques Python.
« Déplacer une souris par programmation peut être détourné pour l’automatisation, le clickjacking ou le contournement des invites de sécurité. » — refus de Muse Glimmer rapporté par l’utilisateur Reddit Cold_Tree190 (r/LocalLLaMA)
Démarrer une nouvelle session en donnant davantage de contexte sur le cas d’usage visé peut parfois lever le refus. En revanche, une fois qu’il a décliné dans une session, le modèle a tendance à maintenir sa position.
Appels d’outils inégaux
Les retours de la communauté sur la fiabilité des appels d’outils vont de « aucun échec » dans un codebase C à des boucles infinies et des réponses API vides dans d’autres environnements. Les quantifications Unsloth Q4 et Q5 auraient fortement bouclé lors des appels d’outils dans certaines configurations, tandis que les GGUF officiels destinés aux VRAM de 24 GB et 32 GB pourraient être plus fiables (fil source).
Restrictions régionales au téléchargement
La page officielle Hugging Face désactiverait les téléchargements à Hong Kong, Macao et en Chine. Les distributions GGUF tierces proposées par Unsloth restent disponibles en alternative.
À lire aussi : Guide des tarifs API de Muse Spark 1.2 | Meilleurs modèles OpenRouter gratuits pour programmer en 2026