 AIREITER
Un point de NDCG@10 de mieux, pour un index qui peut peser 42 fois plus lourd : c’est le compromis très concret des modèles d’embeddings multi-vecteurs. Sentence Transformers les intègre désormais comme citoyens de première classe avec sa version 6.0, annoncée le 18 août 2026, via MultiVectorEncoder, aux côtés des modèles denses, sparse et rerankers. Les benchmarks de lancement de Hugging Face tempèrent l’enthousiasme : la late interaction devance son jumeau dense sur 9 des 13 jeux NanoBEIR, mais l’écart moyen tourne autour d’un point de NDCG@10. Dans l’exemple détaillé, l’index brut atteint 42x la taille du baseline MiniLM en 384 dimensions, et reste 21x plus volumineux qu’un modèle dense de catégorie comparable. Tout dépend donc de la nature de vos requêtes.
Comprendre les embeddings multi-vecteurs et la late interaction
Au lieu de résumer un document dans un unique vecteur agrégé, un modèle multi-vecteurs conserve un vecteur par token. Dans la gamme prise en charge par Hugging Face, ces vecteurs de tokens font généralement 128 dimensions, contre 384, 768 ou 1 024 dimensions pour un embedding dense classique. Lors du scoring, l’opérateur MaxSim retient, pour chaque token de la requête, le meilleur produit scalaire avec n’importe quel token du document, puis additionne ces maxima : MaxSim(Q,D) = Σᵢ maxⱼ(qᵢ · dⱼ). Ces modèles étant normalisés en L2, chaque composante se situe dans [-1, 1] et le score final augmente avec la longueur de la requête.
La late interaction se place ainsi à mi-chemin entre les deux architectures dont elle reprend certains principes :
| Architecture | Côté document | Scoring | Profil de coût |
|---|---|---|---|
| Bi-encodeur dense | Un vecteur agrégé, précalculé | Un seul produit scalaire | Recherche la plus rapide ; l’agrégation perd le détail des tokens |
| Late interaction | Un vecteur par token, précalculé | MaxSim sur les paires de tokens | Appariement riche ; l’index croît avec la longueur des documents |
| Cross-encoder | Rien n’est précalculé | Passage complet du modèle pour chaque paire requête-document | Classé comme le plus précis par paire dans l’article de lancement de Hugging Face ; trop coûteux en première étape |
L’article fondateur de ColBERT a formalisé cette approche sous le nom de « contextualized late interaction ».
Son intérêt apparaît au niveau des tokens. Dans l’exemple de Hugging Face avec lightonai/mLateOn, le token de requête « live » est associé au token « inhabit » du document avec une similarité de 0.94 : un rapprochement sémantique sans aucun recouvrement lexical.
Les cas où le multi-vecteur fait vraiment la différence
Les benchmarks sur passages courts minimisent les situations dans lesquelles ces modèles justifient leur coût. Les cinq sources comparées pour cet article — le billet de lancement de Hugging Face, TopK, l’analyse technique de Qdrant, le guide de production de Data AI Hub et la comparaison de recherche en production par Suhas Bhairav — font ressortir les mêmes cas :
- Des identifiants précis dans une recherche sémantique. Codes produit, noms de fonctions, patronymes, messages d’erreur ou numéros de clauses. Un vecteur agrégé les dilue ; des vecteurs par token les laissent directement interrogeables.
- Des requêtes à plusieurs contraintes. « X avec Y et Z » : chaque token de la requête peut trouver indépendamment le token du document qui l’étaye, sans qu’une contrainte soit noyée dans une moyenne.
- Des documents longs dont la réponse se cache dans un passage secondaire. Sur le benchmark multilingue de documents longs MLDR, le modèle multi-vecteurs
mLateOnobtient 77.92 contre 51.59 pourmDenseOn, un écart d’un ordre de grandeur supérieur aux moyennes observées sur passages courts. - Des PDF, tableaux et pages numérisées. Les modèles de la famille ColPali indexent directement les images de pages à partir de requêtes textuelles, sans OCR. Le billet de lancement de Hugging Face présente la recherche visuelle dans les documents comme le terrain d’excellence de la late interaction ; l’analyse de TopK rapporte qu’un retriever multi-vecteurs compact surpasse de +34% en recall, sur ViDoRe v3, un modèle mono-vecteur 80x plus grand, avec un recall sur documents industriels qui passe d’environ 42% à 76%.
- Un vocabulaire hors domaine. Le billet de lancement de Hugging Face rapporte des gains sur des données hors domaine, là où la compression apprise d’un modèle dense peut éliminer des détails indispensables aux requêtes de production.
Les chiffres de Hugging Face donnent une idée de l’adéquation avec la recherche visuelle : une page rendue produit environ 755 vecteurs de tokens avec colqwen2.5-v0.2, contre environ 125 pour un passage textuel moyen. Plus une page est riche — graphiques, mise en page, tableaux — plus un vecteur agrégé unique devrait abandonner d’information.
Un gain de qualité réel, mais moins spectaculaire que le discours ambiant
La comparaison la plus propre est celle de la paire appariée de LightOn : LateOn et DenseOn partagent le même backbone ModernBERT de 149M de paramètres ainsi que les mêmes données d’entraînement. Seule leur tête diffère : des vecteurs de tokens en 128 dimensions d’un côté, un unique vecteur de document en 768 dimensions de l’autre.
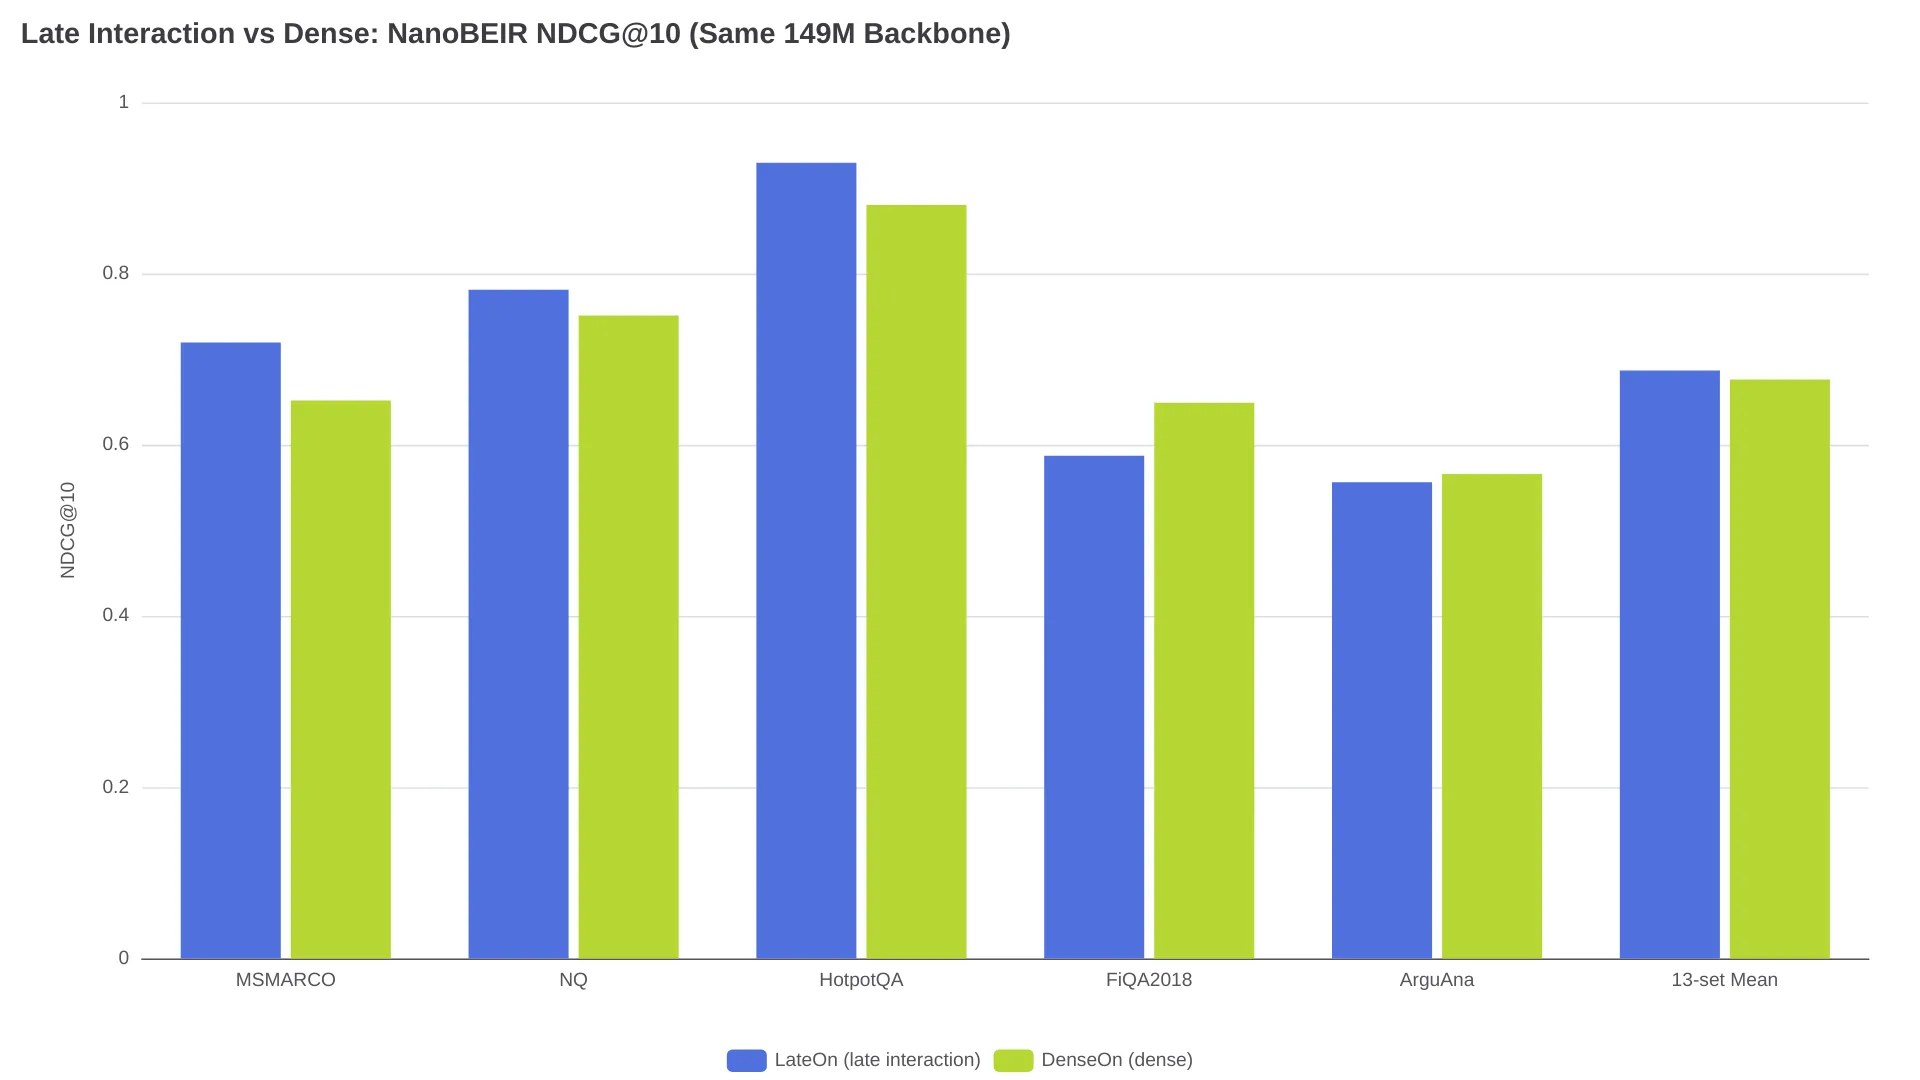
LateOn gagne sur 9 des 13 jeux NanoBEIR, ainsi que sur la moyenne : 0.6868 contre 0.6764 en NDCG@10. Sur l’ensemble BEIR de 15 jeux, il atteint 57.22 contre 56.20. DenseOn reste toutefois devant sur ArguAna, FiQA2018, SCIDOCS et SciFact. C’est la lecture honnête du résultat : un gain moyen significatif à taille de modèle identique, pas un changement de catégorie.
Après l’annonce de la v6.0 par le mainteneur Tom Aarsen, le développeur @saen_dev a formulé la question que se posaient de nombreux praticiens : « How does it benchmark against bi-encoders on domain-specific corpora? » (thread). La réponse honnête est d’environ un point en moyenne, avec les gros gains concentrés sur les documents longs. Le propre billet de lancement de Hugging Face recommande d’évaluer sur sa tâche de retrieval, car les gains varient selon les jeux de données.
Le coût de stockage : 42x avant compression
L’exemple chiffré de Hugging Face porte sur un index de 4 874 passages Natural Questions. lightonai/LateOn y génère 608 414 vecteurs de tokens, soit 124.8 vecteurs par passage en moyenne.
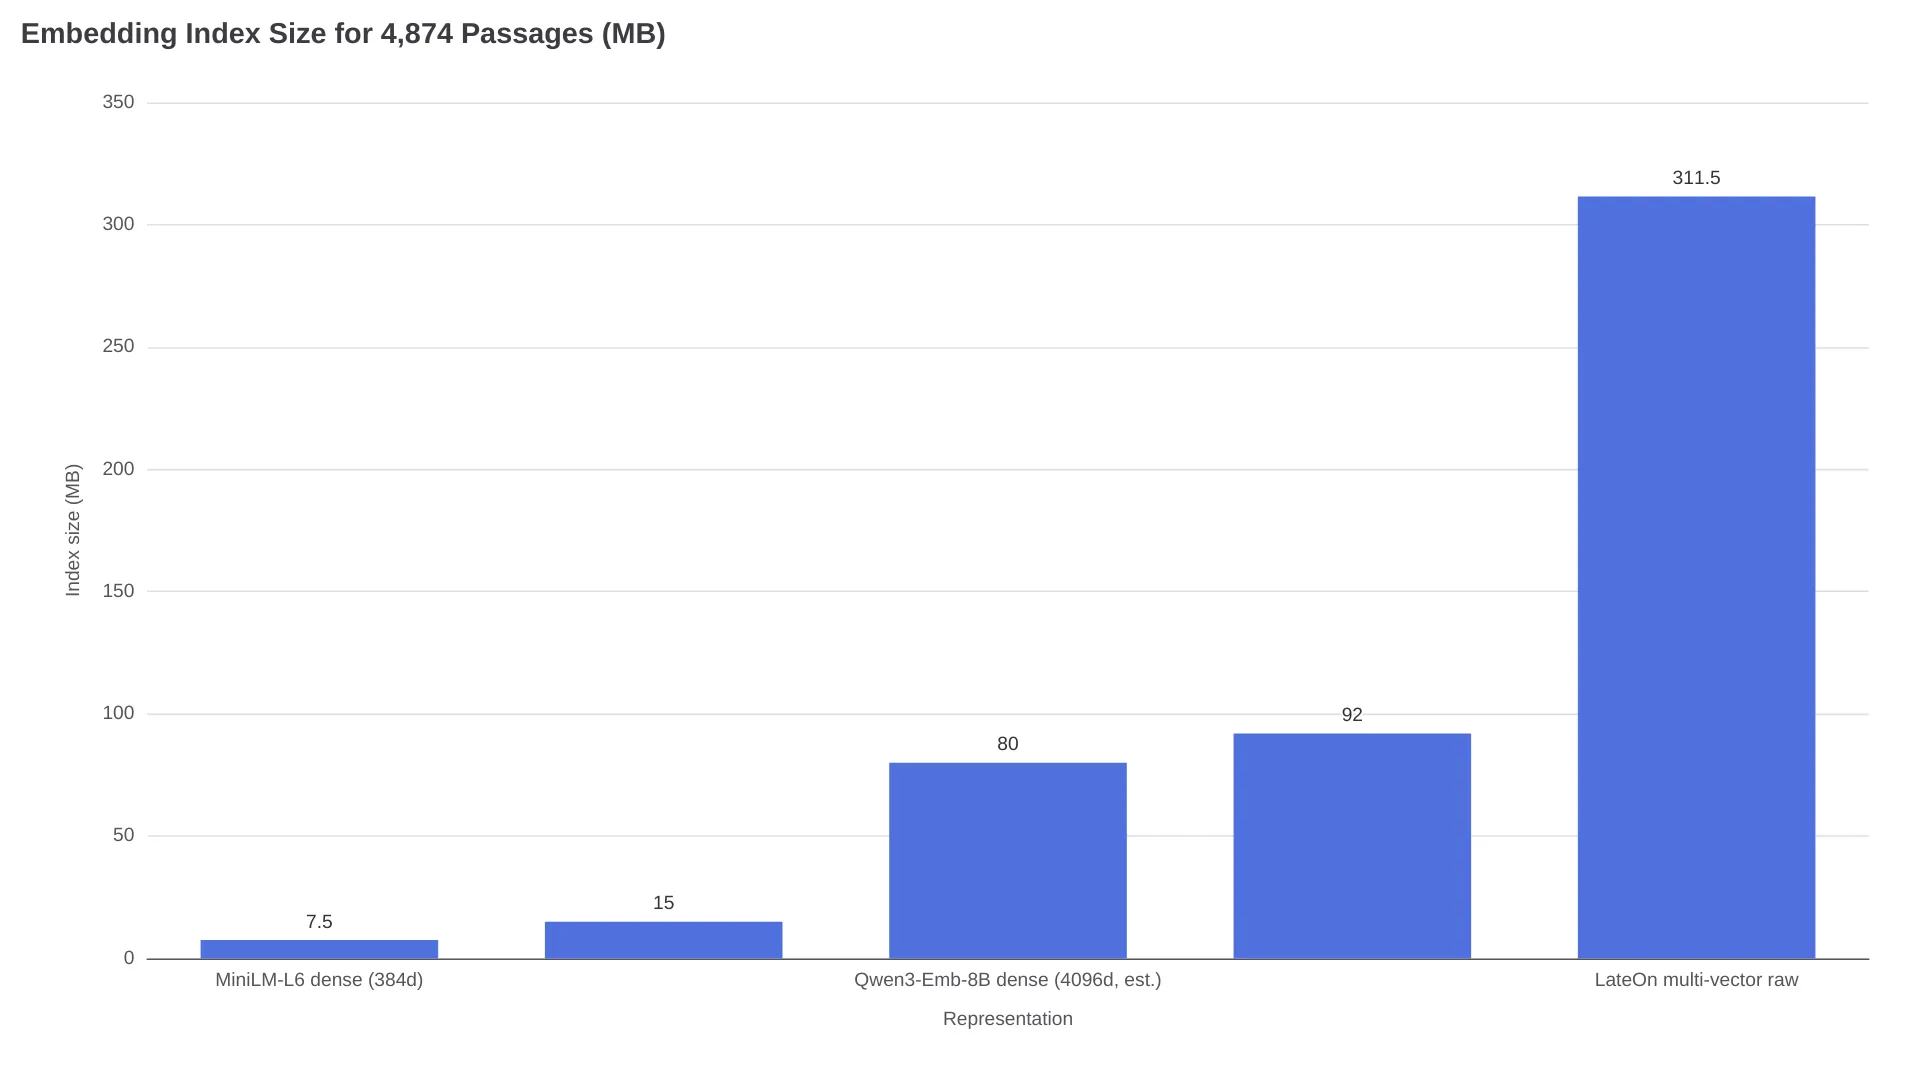
L’index multi-vecteurs brut en float32 occupe 311.5 MB. Pour les mêmes passages, l’index dense de all-MiniLM-L6-v2 demande 7.5 MB, soit un facteur 42, ou 62 KiB par passage. Face à gte-modernbert-base, un modèle dense comparable en 768 dimensions, l’écart reste de 21x (15 MB). TopK évoque une fourchette de 10–100x selon la longueur des documents et la précision, et estime que chaque requête exige des milliers de fois plus de calcul qu’une comparaison mono-vecteur.
Le jour de la sortie, un développeur a résumé sans détour la préoccupation de production :
Le pooling des tokens est ce qui décide si cela partira en production. La late interaction échoue généralement sur la taille de l’index et la mémoire, pas sur la précision. - @JudeJobs on X
Pour donner une échelle : un index dense Qwen3-Embedding-8B en 4 096 dimensions sur le même corpus représente environ 80 MB, soit presque les 92 MB de l’index de late interaction compressé ci-dessous.
Trois leviers pour réduire la taille de l’index
1. Le pooling des tokens. Sentence Transformers v6.0 embarque HierarchicalTokenPooling, qui regroupe les vecteurs de tokens des documents par liaison de Ward sur la distance cosinus et remplace chaque cluster par sa moyenne. Par défaut, le pooling ne s’applique qu’aux documents : les requêtes sont courtes et sensibles à la distorsion. Sur le corpus de 608 414 vecteurs :
| Facteur de pooling | Vecteurs de tokens | Index float32 | Rétention de retrieval rapportée |
|---|---|---|---|
| 1 (aucun) | 608,414 | 311.5 MB | 100% |
| 2 | 305,438 | 156.4 MB | 100.6% |
| 3 | 204,407 | 104.7 MB | 99.0% |
| 4 | 153,936 | 78.8 MB | tendance à ~98% |
Le pooling de l’ensemble du corpus a pris environ 6 secondes. La variante régularisée de LightOn rapporte 99.4% de qualité à une compression 5x dans le billet de Hugging Face ; Hugging Face précise toutefois que l’entraînement avec ce régularisateur n’était pas encore intégré à la bibliothèque lors de la sortie de la v6.0.
2. Les index compressés. Un index fast-plaid (PLAID en Rust) constitué des mêmes vecteurs occupe 92 MB. Il est construit en 5 secondes et répond en 11 ms sur une RTX 3090 + i7-13700K. Il est approximatif : dans le test de Hugging Face, les meilleurs scores passent de 11.92 à 11.88, mais le classement reste inchangé. Le MUVERA de Weaviate a accéléré l’ingestion d’un facteur 3 et les requêtes d’un facteur 1.8, au prix d’un résultat correct perdu dans le top 50 de leur corpus de test.
3. La quantification et l’optimisation de l’inférence. Dans les expériences de Qdrant, la quantification scalaire uint8 des embeddings de tokens réduit la mémoire par 4, tandis que le NDCG@10 sur SciFact passe de 0.70724 à 0.70297, un impact négligeable. Hugging Face indique que fp16 associé à Flash Attention apporte un débit d’encodage 2.44x supérieur au fp32 sans perte de qualité mesurée ; sur CPU, int8 coûte environ 0.4% de précision.
En combinant un pooling de facteur 2–3 et un index compressé, l’écart effectif avec le dense tombe de 42x à un chiffre, au prix de deux paramètres supplémentaires à régler.
En production, le reranking est l’architecture par défaut
Un MaxSim exhaustif sur les 4 874 documents prend 98 ms, ou 122.7 ms de bout en bout, sur une seule RTX 3090 : c’est tout à fait acceptable pour quelques milliers de documents, mais le coût linéaire devient désastreux à l’échelle de millions. Les trois guides de déploiement comparés ici convergent vers la même architecture : une première étape dense ou sparse, peu coûteuse, récupère les candidats ; la late interaction les reranke.
- L’exemple de Hugging Face récupère les 50 meilleurs résultats denses, puis les reranke avec MaxSim. Les documents sont encodés une seule fois par lot et évalués par multiplication matricielle, ce qui coûte bien moins cher qu’un passage de cross-encoder pour chaque paire.
- Qdrant, qui propose un support multi-vecteurs natif depuis la v1.10, recommande surtout la late interaction pour reranker quelques centaines de candidats, et non pour des scans complets.
- Le guide de production de Data AI Hub préconise une recherche hybride sur les 150 premiers résultats, un reranking de late interaction jusqu’à 20, puis éventuellement un cross-encoder pour les 5 derniers envoyés au LLM.
Le reranking seul a une limite incontournable : il ne peut pas retrouver les documents ratés par la première étape. Et le reste du pipeline est loin d’être stabilisé :
il n’existe pratiquement pas de stratégie universellement bonne pour le chunking, le retrieval et le re-ranking. - u/gamerx88, r/MachineLearning
Quelles bases de données le prennent en charge, et dans quelles conditions ?
Le billet de lancement de Hugging Face compare les principaux moteurs sur le même corpus de 4 874 passages. Les chiffres qui suivent sont les résultats de leur test, et non des données marketing d’éditeurs :
| Moteur | Support multi-vecteurs natif depuis | Ingestion / requête (leur test) | Points d’attention |
|---|---|---|---|
| Qdrant | v1.10 | 26.3 s / 18 ms | MAX_SIM exact ; serveur recommandé |
| Weaviate | v1.29 | 41 s / 17 ms | MUVERA est plus rapide mais a perdu un résultat correct ; pas de mode embarqué sous Windows |
| Vespa | « for years » | ~80 s / 75 ms à chaud | MaxSim sous forme d’expression tensorielle ; la seconde phase par défaut ne reranke que 100 candidats et a raté 2 des 3 meilleurs résultats corrects |
fast-plaid | - | 5 s / 11 ms | Pas de serveur ; scores approximatifs, classement préservé |
| LanceDB | v0.15.0 | non benchmarké | MaxSim natif |
| Milvus | v2.6.4 | non benchmarké | Stockage en array-of-structs |
| VectorChord | - | non benchmarké | Opérateur MaxSim pour PostgreSQL |
| Elasticsearch / OpenSearch | - | - | Rescore uniquement ; la fonctionnalité ES est un aperçu technique dans l’offre Enterprise |
Dans le tableau comparatif de Hugging Face, l’indexation de late interaction de turbopuffer était indiquée comme étant en bêta privée.
Ce que change Sentence Transformers v6.0
Avant le 18 août 2026, utiliser des modèles de la famille ColBERT impliquait de passer par des frameworks distincts : PyLate, le dépôt Stanford ColBERT ou colpali-engine. La version 6.0 fait de MultiVectorEncoder le quatrième type de modèle pris en charge nativement par la bibliothèque, avec entraînement, inférence et outils d’interprétabilité. Elle charge les checkpoints Sentence Transformers, PyLate, Stanford ColBERT et ColPali ; un transformer nu peut aussi être chargé, mais sa projection aléatoire exige un entraînement. Les prérequis sont transformers v5.x, torch 2.2+ et huggingface-hub v1.x.
Trois pièges relevés dans la documentation de lancement :
- Les requêtes et les documents ne sont pas symétriques.
encode_query()etencode_document()appliquent des prompts, plafonds de longueur et masques de scoring différents. Appelerencode()de façon générique sur les deux est le moyen le plus rapide de dégrader silencieusement les résultats. - La troncature ne prévient pas. Un passage de 662 tokens envoyé avec le plafond de 300 tokens de document de LateOn a produit 273 vecteurs ; le reste a été écarté. Relever la limite à 512 fonctionne, mais éloigne le modèle de sa distribution d’entraînement et augmente l’index.
- Flash Attention comporte des exceptions. Les modèles dotés d’une expansion de requête non-attend, dont
colbert-ir/colbertv2.0etanswerai-colbert-small-v1, doivent utiliser"sdpa"à la place.
D’après les scores publiés par Hugging Face, la sélection de modèles compatibles couvre deux ordres de grandeur :
| Segment | Exemple de modèle (paramètres) | Score (NDCG@10 moyen) |
|---|---|---|
| Texte embarqué | mxbai-edge-colbert-v0-17m (17M) | 0.6407 NanoBEIR |
| Petit modèle texte | answerai-colbert-small-v1 (33M) | 0.6550 NanoBEIR |
| Leader texte | LateOn family (149M) | 0.6868–0.6897 NanoBEIR |
| Document visuel | colqwen2.5-v0.2 (3.8B) / webAI-ColVec1.1-8b (8.4B) | 0.5402 / 0.6580 NanoViDoRe |
Quand les vecteurs denses uniques restent le meilleur choix
L’erreur à éviter consiste à adopter le multi-vecteur pour des charges qui n’en ont pas besoin. Mieux vaut s’en passer si les requêtes sont larges et thématiques (« articles sur les chaînes d’approvisionnement »), si les textes sont courts — titres, paires de FAQ, tweets — ou si l’on cherche à faire du clustering, de la déduplication ou de la recommandation, c’est-à-dire tout ce qui requiert une similarité sur l’objet entier. Même conclusion si un pipeline dense plus reranker atteint déjà vos SLO de recall et que le coût est la contrainte déterminante. Le guide de Data AI Hub ajoute que des checkpoints ColBERT centrés sur l’anglais peuvent faire moins bien qu’un bi-encodeur multilingue associé à un reranker sur des corpus multilingues ; les corpus à mises à jour fréquentes et en temps réel se prêtent également mal aux index au niveau du token.
Questions fréquentes, avec les chiffres à l’appui
Peut-on utiliser un modèle dense classique comme modèle multi-vecteurs ?
Parfois, et les résultats peuvent être étonnamment bons. Les expériences de Qdrant ont récupéré les embeddings de tokens en sortie de BAAI/bge-small-en, un modèle dense de 33M, et les ont scorés avec MaxSim : 0.73696 de NDCG@10 sur SciFact, devant colbert-ir/colbertv2.0 à 0.69579 et le vecteur agrégé natif de bge-small à 0.68213. Sur ArguAna, l’ordre s’inverse et le dense agrégé l’emporte. C’est une technique valable pour ajouter une étape de reranking sans changer de modèle, pas une garantie.
Quel gain de vitesse apporte un index multi-vecteurs compressé ?
Sur le corpus de 4 874 passages : 98 ms pour MaxSim exhaustif, contre 11 ms pour fast-plaid, avec 92 MB au lieu de 311.5 MB.
Les modèles multi-vecteurs remplacent-ils les rerankers cross-encoder ?
Du point de vue économique, oui : les représentations des documents sont précalculées et scorées par multiplication matricielle au lieu d’un passage avant pour chaque paire requête-document. Le billet de lancement de Hugging Face classe toutefois toujours le cross-encoder comme l’option la plus précise par paire ; les pipelines exigeants le conservent donc pour les 5–20 derniers résultats.
La late interaction vaut-elle le coup pour le RAG ?
Comme étage de reranking sur des candidats hybrides ou denses, oui : c’est le schéma recommandé par les trois guides de déploiement cités plus haut. Comme retriever de première étape, seulement si le recall mesuré de cette première étape est votre problème et si l’index de vecteurs de tokens entre dans votre budget.
Tableau de décision
| Votre charge de travail | Recommandation |
|---|---|
| Requêtes riches en identifiants ou à plusieurs contraintes, documents longs, textes juridiques ou techniques | Retrieval ou reranking multi-vecteurs : c’est le terrain du gain de +26 points sur MLDR |
| PDF, pages numérisées, tableaux et graphiques sous forme d’images de pages | Multi-vecteurs de la famille ColPali ; aucun pipeline OCR nécessaire |
| Recherche thématique large, textes courts, clustering/déduplication/systèmes de recommandation | Vecteurs denses uniques ; les pertes dues au pooling ne comptent pas ici |
| Qualité presque suffisante, budget serré | Conserver une première étape dense, puis ajouter un reranking MaxSim sur les 50–150 premiers résultats |
| Millions de documents, contrainte de coût | Dense + reranker cross-encoder, ou late interaction compressée (pooling facteur 2–3 + fast-plaid) après mesure |
Le compromis non résolu signalé par @JudeJobs reste le même : la rétention après compression est mesurée sur des benchmarks, pas sur des corpus de production désordonnés. Commencez par un pooling de facteur 2, puis laissez le recall mesuré sur vos propres données déterminer jusqu’où descendre sur la courbe de compression.