 AIREITER
Avec Modal, un job multi-nœuds est facturé sur la base de l’allocation complète, pas via un abonnement cluster séparé. Modal Clusters est généralement disponible, mais la facture dépend toujours des GPU, du CPU, de la mémoire, du stockage et du réseau consommés par chaque conteneur.
Modal Clusters : l’essentiel des tarifs en une minute
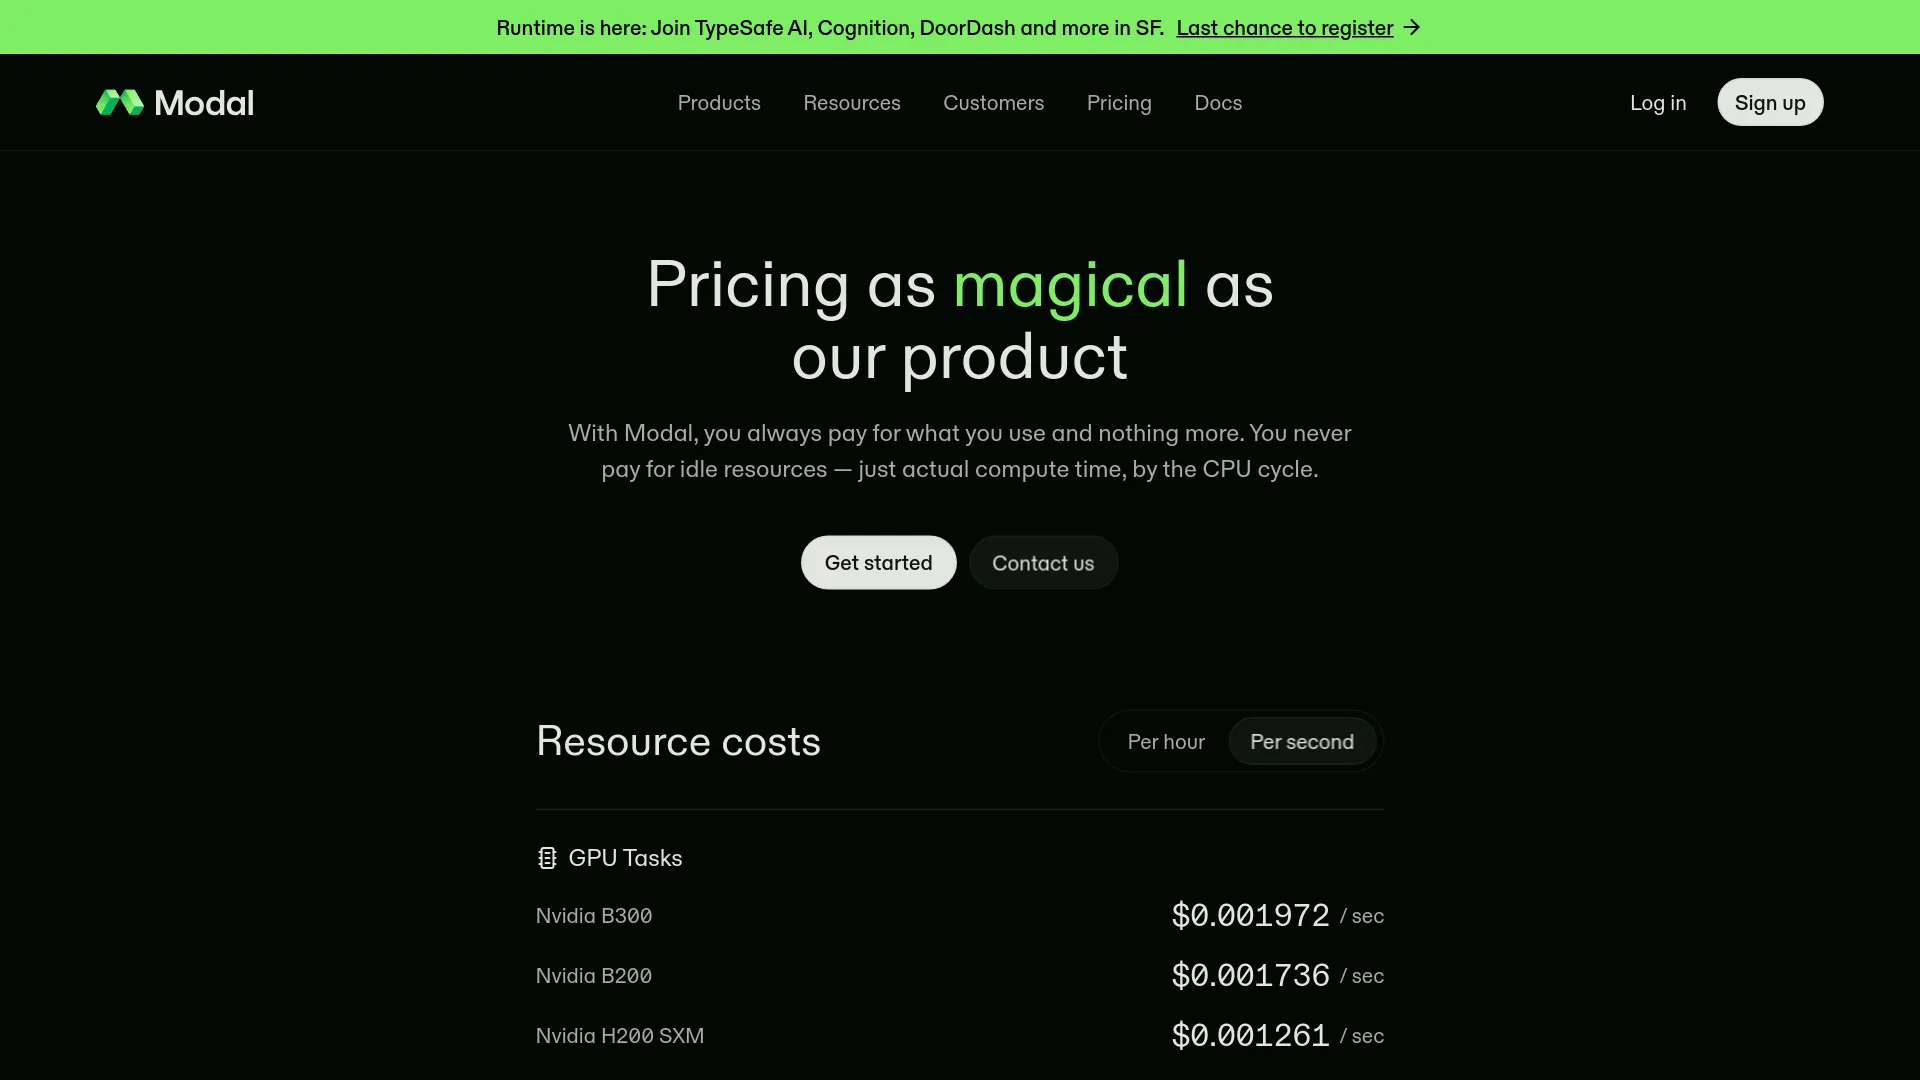
La page officielle des tarifs de Modal et l’annonce de disponibilité générale décrivent une facturation à l’usage ainsi que le point d’entrée @modal.clustered, qui permet de lancer plusieurs conteneurs ensemble. Le RDMA est optionnel : il modifie le chemin de communication, mais pas la formule de base.
nombre de GPU × secondes GPU × tarif GPU + secondes CPU + GiB-secondes de mémoire + stockage + éventuel trafic sortant
Cette formule est importante, car un cluster multiplie l’allocation complète de chaque nœud. Un job qui demande quatre nœuds équipés chacun de huit GPU H100 est facturé pour 32 H100, pas pour un coordinateur accompagné de workers « gratuits ».
Ce que Modal Clusters ajoute à la grille tarifaire
La mise à disposition générale de Modal Clusters, annoncée le 1er octobre 2026, transforme l’exécution multi-nœuds en primitive gérée. Le paramètre size définit le nombre de conteneurs, tandis que rdma=True active le canal de communication haut débit lorsqu’il est pris en charge (annonce de Modal).
La documentation décrit un ordonnancement en groupe : Modal tente de placer l’ensemble des conteneurs demandés au même moment, plutôt que de lancer un job partiel incapable de progresser. Les cas d’usage pris en charge comprennent l’entraînement distribué, le fine-tuning, l’inférence parallèle sur plusieurs modèles et les architectures prefill/decode nécessitant des communications GPU synchronisées.
La documentation des clusters fixe aussi plusieurs limites pratiques : les GPU sont alloués par nœud complet, les clusters uniquement CPU ne sont pas pris en charge et la défaillance ou la préemption d’un conteneur peut faire échouer l’appel clusterisé. Seule la sortie du rank 0 est renvoyée : pour les jobs longs, les checkpoints doivent donc être stockés en dehors du conteneur.
Les tarifs GPU qui composent une facture Modal Clusters
Les tarifs publics ci-dessous constituent un bon point de départ pour établir une estimation. Les montants horaires sont calculés à partir des prix à la seconde et n’incluent ni le CPU, ni la mémoire, ni le stockage, ni les éventuels multiplicateurs régionaux.
| GPU | Par seconde | Environ par GPU-heure |
|---|---|---|
| B300 | $0.001972 | $7.10 |
| B200 | $0.001736 | $6.25 |
| H200 SXM | $0.001261 | $4.54 |
| H100 SXM5 | $0.001097 | $3.95 |
| A100 80 GB | $0.000694 | $2.50 |
| L4 | $0.000222 | $0.80 |
Modal facture également le CPU $0.0000131 par cœur physique-seconde et la mémoire $0.00000222 par GiB-seconde. Les volumes coûtent $0.09 par GiB et par mois, avec un premier 1 TiB gratuit. Le trafic réseau sortant est facturé $0.04 par GiB au-delà du quota inclus. Vérifiez les montants en vigueur sur la grille tarifaire officielle avant de lancer un gros job.
Exemple concret : quatre nœuds avec huit H100
Imaginons un job d’entraînement distribué qui demande size=4 et H100:8 sur chaque nœud.
- Quatre nœuds × huit GPU = 32 GPU H100.
- 32 × $3.95 par heure = environ $126.40 par heure de coût GPU.
- Considérez $126.40 comme un plancher limité aux GPU ; le CPU, la mémoire, le stockage et le trafic sortant s’ajoutent à la facture.
C’est ce montant qu’il faut comparer à une capacité réservée ou dédiée. L’avantage du serverless est de pouvoir réduire le cluster après le pic de charge ; cela ne rend pas un cluster entièrement occupé bon marché pour autant.
Les limites du forfait peuvent compter davantage que les tarifs
Une fonctionnalité disponible en général ne signifie pas que la capacité est illimitée. Les forfaits workspace publiés par Modal incluent des limites de concurrence et de plateforme susceptibles de bloquer un gros cluster avant même que le prix ne devienne le principal problème.
| Forfait | Frais de plateforme | Crédit de calcul inclus | Concurrence GPU publiée |
|---|---|---|---|
| Starter | $0/month | $30/month | 10 GPU |
| Team | $250/month | $100/month | 50 GPU |
| Enterprise | Custom | Custom | Custom / higher limits |
Une expérimentation avec 32 H100 consomme déjà 32 GPU : le forfait Starter ne peut donc pas prendre en charge l’exemple ci-dessus avec une limite de concurrence fixée à 10 GPU. Le forfait Team peut accueillir ce nombre de GPU sur le papier, mais la disponibilité réelle, le choix de la région et le matériel demandé influencent toujours l’ordonnancement.
Ne confondez pas le crédit Starter de $30 avec 30 heures-GPU gratuites. Au tarif H100 indiqué, cela représente environ 7.6 heures-GPU H100, avant même de compter les autres ressources du job.
Dans quels cas Modal Clusters est-il rentable ?
Modal Clusters est surtout intéressant lorsque le job est volumineux, intermittent et pénible à maintenir sur une infrastructure provisionnée en permanence. Un pic d’entraînement de quelques heures, suivi d’une extinction complète, tire davantage parti du scale-to-zero qu’un cluster qui tourne sans interruption pendant plusieurs semaines.
La solution est adaptée aux cas suivants :
- Fine-tuning distribué nécessitant le démarrage simultané de tous les nœuds.
- Courtes phases d’entraînement mobilisant une capacité GPU coûteuse.
- Inférence multi-nœuds ayant besoin du RDMA ou du parallélisme de modèles.
- Équipes Python qui préfèrent éviter d’administrer Kubernetes, SLURM ou une configuration RDMA manuelle.
Une fonction Modal sur un seul nœud est préférable lorsque le modèle tient sur une seule machine. Une infrastructure dédiée ou réservée mérite une vraie comparaison lorsque l’utilisation est prévisible, que le workload exige un SLA fixe ou que l’objectif principal est de minimiser le coût GPU-heure sur la durée.
Une discussion entre utilisateurs permet aussi de mieux cerner la frontière. Dans un fil consacré à la vision par ordinateur, u/Substantial_Camel735 recommande de conserver la recherche vectorielle sur un VPS plutôt que d’exécuter cette partie sur les workers Modal (discussion Reddit). Il s’agit d’une préférence d’architecture exprimée par un praticien, pas d’un benchmark valable pour toute la plateforme.
« Nous sommes sur le point de quitter Modal, mais cette architecture me paraît cohérente. Je n’utiliserais pas les workers Modal pour effectuer la recherche ; je ferais simplement la recherche sur votre VPS, directement sur votre base vectorielle. » — u/Substantial_Camel735, r/computervision
Les vérifications opérationnelles à faire avant un gros lancement
- Multipliez l’allocation complète. Vérifiez
size × nombre de GPU par nœud, puis comparez le total à la limite de concurrence du workspace. - Commencez par le plus petit cluster utile. Un test à deux nœuds peut révéler des problèmes d’image, de NCCL, de rank ou de rendezvous avant qu’un lancement à 32 GPU ne multiplie la facture.
- Ne mélangez pas le RDMA et le débogage applicatif. Validez le job distribué sans RDMA si le workload le permet, puis activez
rdma=Trueet mesurez le chemin sensible aux communications. - Enregistrez les checkpoints sur un stockage durable. La défaillance ou la préemption d’un rank peut faire échouer l’appel complet ; relancer sans checkpoint risque de répéter toute l’exécution coûteuse.
- Prévoyez le CPU, la mémoire et le trafic sortant. Le calcul GPU n’est que la première ligne de la facture, notamment lorsque les jeux de données ou les résultats traversent les régions.
- Déterminez si un ancrage régional est nécessaire. Restreindre le placement peut modifier le pool disponible pour l’ordonnancement et le multiplicateur de prix ; traitez la localité comme une exigence à mesurer et vérifiez-la dans la documentation actuelle sur les tarifs régionaux.
Le RDMA n’apparaît pas comme un coût séparé dans la tarification officielle de Modal. Sa valeur tient aux performances : l’entraînement synchronisé et les transferts importants de caches KV peuvent être limités par le réseau sur du TCP classique. En contrepartie, le matériel compatible RDMA et les contraintes de placement peuvent réduire la disponibilité.
FAQ sur Modal Clusters
Existe-t-il des frais API spécifiques à Modal Clusters ?
Aucun supplément cluster distinct n’est publié. Modal facture les ressources utilisées par chaque conteneur : GPU, CPU, mémoire, stockage et trafic réseau applicable.
Quelle est la taille maximale d’un cluster ?
Les documents liés à la disponibilité générale mentionnent des clusters publics allant jusqu’à 32 nœuds ou 256 GPU, les besoins supérieurs devant être traités avec Modal (annonce de disponibilité générale). Les limites de concurrence du workspace et la capacité disponible s’appliquent toujours.
Modal Clusters peut-il exécuter de l’inférence ?
Oui, à condition que le workload corresponde au modèle d’exécution clusterisé. L’inférence multi-nœuds ou parallèle sur plusieurs modèles constitue un meilleur cas d’usage qu’un endpoint HTTP classique ; les fonctions web clusterisées ont certaines limites, notamment le fait que le trafic est envoyé au rank 0 (documentation des clusters).
La décision pratique
| Votre workload | Meilleur point de départ |
|---|---|
| Le modèle tient sur un GPU ou un nœud | Fonction Modal classique |
| Pic court d’entraînement multi-nœuds synchronisé | Modal Clusters, après un petit test |
| Utilisation complète, prévisible et prolongée | Comparer une capacité GPU dédiée ou réservée |
| Recherche ou base de données à proximité d’une inférence GPU | Conserver le service de données séparé, sauf si les mesures justifient la colocalisation |
| Exigence stricte de réseau privé ou d’auto-hébergement | Évaluer un autre modèle de déploiement |
Modal Clusters simplifie le démarrage d’une orchestration GPU multi-nœuds ; il ne la rend pas moins chère par définition. Le placement serverless et l’ergonomie Python peuvent faire gagner du temps aux équipes, tandis que l’utilisation continue, les contraintes régionales et les relances d’un cluster entier peuvent peser lourd dans la facture. Commencez par calculer le nombre total de nœuds ; vous pourrez ensuite seulement comparer le prix de la simplicité avec celui d’une capacité dédiée.