 AIREITER
Depuis le 19 août 2026, le dépôt LFM2.5-2.6B de Liquid AI contient deux fichiers Q4_0 de 1,59 Go. Leur nom est presque identique, leur taille aussi, mais l'un est un ancien modèle et l'autre bénéficie de QAD. Cette distillation tenant compte de la quantification récupère une grande partie de la qualité perdue lors du passage en 4 bits. Téléchargez le mauvais fichier et vous exécuterez tout simplement la version non corrigée.
Ce que QAD change réellement
QAD signifie quantization-aware distillation, ou distillation consciente de la quantification. Liquid AI a entraîné quatre modèles — LFM2.5-230M, LFM2.5-350M, LFM2.5-1.2B-Instruct et LFM2.5-2.6B — en intégrant l'arrondi Q4_0 dès l'entraînement. Un modèle enseignant en haute précision distille alors ses connaissances vers l'élève quantifié : les poids apprennent à composer avec l'erreur de quantification au lieu de la subir après coup.
Les anciens fichiers Q4_0 présents dans les mêmes dépôts reposent sur de la quantification après entraînement, ou PTQ : un modèle BF16 finalisé est arrondi, sans mécanisme pour compenser les erreurs introduites. D'après le billet de lancement de Liquid AI, les quatre checkpoints QAD « atteignent environ 97 % de leurs moyennes BF16 » sur une suite couvrant le raisonnement, le suivi d'instructions, l'usage d'outils et les comportements agentiques, avec une moyenne sur cinq exécutions. QAD n'introduit pas un nouveau format : la sortie reste un GGUF Q4_0 standard, déjà pris en charge par llama.cpp.
Le piège des noms de fichiers — et les commandes à utiliser
Le dépôt LFM2.5-2.6B propose à la fois LFM2.5-2.6B-Q4_0.gguf et LFM2.5-2.6B-QAD-Q4_0.gguf, tous deux affichés à 1,59 Go. Les exemples par défaut du dépôt visent Q4_K_M, pas QAD : un simple copier-coller ne récupère donc aucun des deux Q4_0. Il faut indiquer explicitement le nom du fichier.
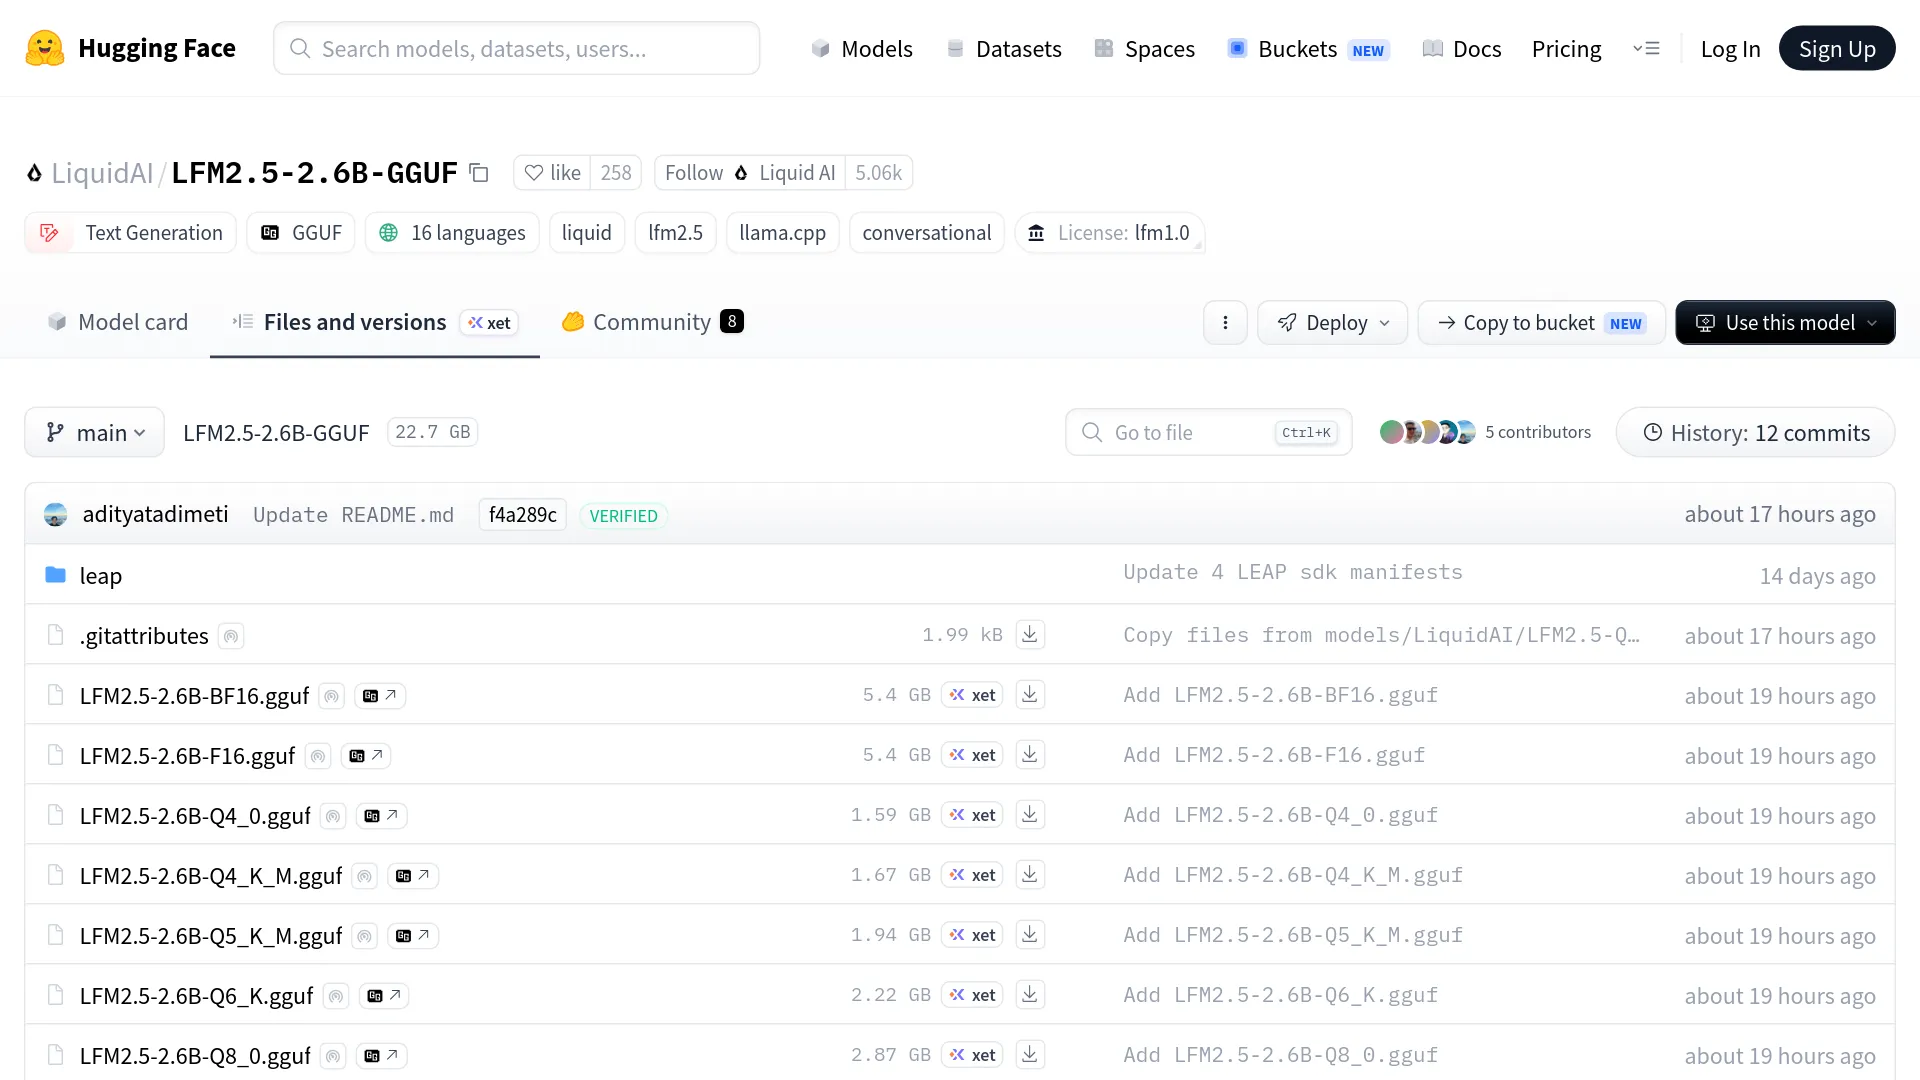
La confusion est apparue dans les heures suivant la sortie :
« Où le télécharger ? Je le vois sur Hugging Face, mais je ne sais pas si c'est la version normale ou QAD. Pouvez-vous m'indiquer laquelle prendre ? » — @Chitacc72 sur X
Un utilisateur précoce, @MarMarLabs, a comparé les fichiers du dépôt : les anciennes et nouvelles versions Q4_0 ne diffèrent que d'environ 4 Ko, impossible à distinguer dans un gestionnaire de fichiers. La solution consiste à cibler le fichier QAD exact avec --hf-file :
# official example from Liquid AI's release post
llama-cli -hf LiquidAI/LFM2.5-350M \
  --hf-file LFM2.5-350M-QAD-Q4_0.gguf \
  -p "What is C. elegans?"

# 2.6B, with the sampling flags from the official model card
llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-QAD-Q4_0.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1
Le même schéma avec --hf-file vaut pour les dépôts 230M et 1.2B-Instruct. Pour un usage serveur, @nicolasembleton a publié le raccourci fonctionnel après avoir constaté que les commandes générées par HF étaient incomplètes : llama serve -hf LiquidAI/LFM2.5-2.6B-GGUF:QAD-Q4_0. C'est le suffixe après les deux-points qui sélectionne la build QAD.
Ce que disent les chiffres officiels — et ce qu'ils ne disent pas
Selon le tableau de benchmarks de Liquid AI, chaque checkpoint QAD conserve entre 96,5 % et 97,4 % de son niveau BF16 de référence. La suite comprend GPQA Diamond, MMLU-Pro, IFEval, IFBench, Multi-IF et BFCLv4, auxquels s'ajoutent GSM8K pour les deux petits modèles et AIME25 pour les deux plus grands. Les résultats sont moyennés sur cinq exécutions.
| Checkpoint | Qualité BF16 conservée | Positionnement qualité | Débit de décodage |
|---|---|---|---|
| LFM2.5-230M | 97,1 % | équivaut à Q5_K_M dans la marge de variation | +4 à +33 % face à Q5_K_M |
| LFM2.5-350M | 96,5 % | équivaut à Q5_K_M dans la marge de variation | +4 à +33 % face à Q5_K_M |
| LFM2.5-1.2B-Instruct | 97,4 % | équivaut à Q4_K_M | +3 à +14 % face à Q4_K_M |
| LFM2.5-2.6B | 96,6 % | équivaut à Q4_K_M | +3 à +14 % face à Q4_K_M |
Le débit a été évalué sur quatre cibles : MacBook Pro et NucBox EVO-X2 côté GPU, Samsung Galaxy S26 Ultra et Raspberry Pi 5 sur CPU Arm. Pour les modèles 230M et 1.2B, Liquid AI indique également que QAD Q4_0 rejoint UD-Q4_K_XL d'Unsloth, présenté dans le billet comme un solide checkpoint PTQ externe.
Le billet ne fournit ni scores par benchmark, ni valeurs brutes en tokens par seconde selon l'appareil, ni tailles de fichier, ni besoins en RAM, ni barres de variance. Il ne donne que des fourchettes en pourcentage et des affirmations de parité. La communauté a rapidement fait le calcul sur les tailles :
« Vous me dites donc que je peux remplacer mon LFM2.5-2.6B local de F16 par QAD Q4_0 et passer de : 5,4 Go -> 1,6 Go, 21 -> 64 tok/s… tout en gardant environ 97 % des performances BF16 ? » — @firedUp_Neyu, à partir des graphiques de lancement de Liquid
La partie liée à la taille des fichiers est exacte : le dépôt officiel affiche 5,4 Go pour F16 et 1,59 Go pour QAD Q4_0. Les valeurs en tok/s sont son interprétation des graphiques, pas des chiffres écrits noir sur blanc par Liquid AI.
Les zones d'ombre du lancement
Trois limites comptent si vous envisagez de redéployer ces fichiers.
Quatre checkpoints, pas davantage. À la sortie, aucune build QAD n'existe pour LFM2.5-VL-450M ou LFM2.5-8B-A1B. Des utilisateurs demandent d'ailleurs à Liquid AI une version 8B dans le fil de lancement sur X. Si vous ciblez l'un de ces modèles, QAD ne change rien pour l'instant.
La question de l'imatrix reste entière. Les fichiers QAD ont été entraînés pour Q4_0, mais produits sans matrice d'importance. Les observateurs de la quantification l'ont aussitôt relevé :
« Le GGUF QAD Q4_0 a été créé sans imatrix, qui aurait aussi pu améliorer la qualité des modèles entraînés avec QAD. » — u/Chromix_, r/LocalLLaMA
Un modèle de moins de 3B reste un modèle de moins de 3B. La récupération liée à la quantification ne relève pas le plafond de capacités du modèle, comme le montre le fil LocalLLaMA. Témoignage d'un utilisateur de NPU :
« Je viens d'implémenter LFM2.5 2.6B sur mon NPU pour des résumés de réunions et — même s'il est impressionnant pour sa taille — les résumés sont nettement moins bons que ceux de modèles plus grands. » — u/DerDave
Cette limite vient du modèle, pas de la quantification : le rapport de quantification de KikoCis a relevé 0/6 instances SWE-bench Verified résolues en Q8_0. Des utilisateurs du 1.2B rapportent aussi une qualité très variable selon le runtime : du charabia sur 9 prompts sur 10 dans une configuration Ollama, mais un fonctionnement productif sous 5 W sur un ordinateur monocarte dans une autre. Si une qualité de pointe est importante pour une tâche donnée, confronter vos sorties locales à celles d'un grand modèle via une API LLM à bas coût ne coûte que quelques centimes pour une batterie de tests complète.
QAD Q4_0 ou Q4_K_M : quel fichier choisir ?
Pour les déploiements llama.cpp serrés en RAM sur ces quatre checkpoints, QAD Q4_0 est le format 4 bits recommandé par le fournisseur à tester en premier. Il occupe les mêmes 1,59 Go que le Q4_0 classique, tout en étant entraîné pour rejoindre la qualité de Q4_K_M sur les modèles 1.2B et 2.6B, ou de Q5_K_M sur les 230M et 350M. Le décodage est respectivement 3 à 14 % ou 4 à 33 % plus rapide. Si vous utilisez déjà Q4_K_M et avez de la RAM disponible, ne changez rien : 80 Mo ne sont pas le problème à résoudre.
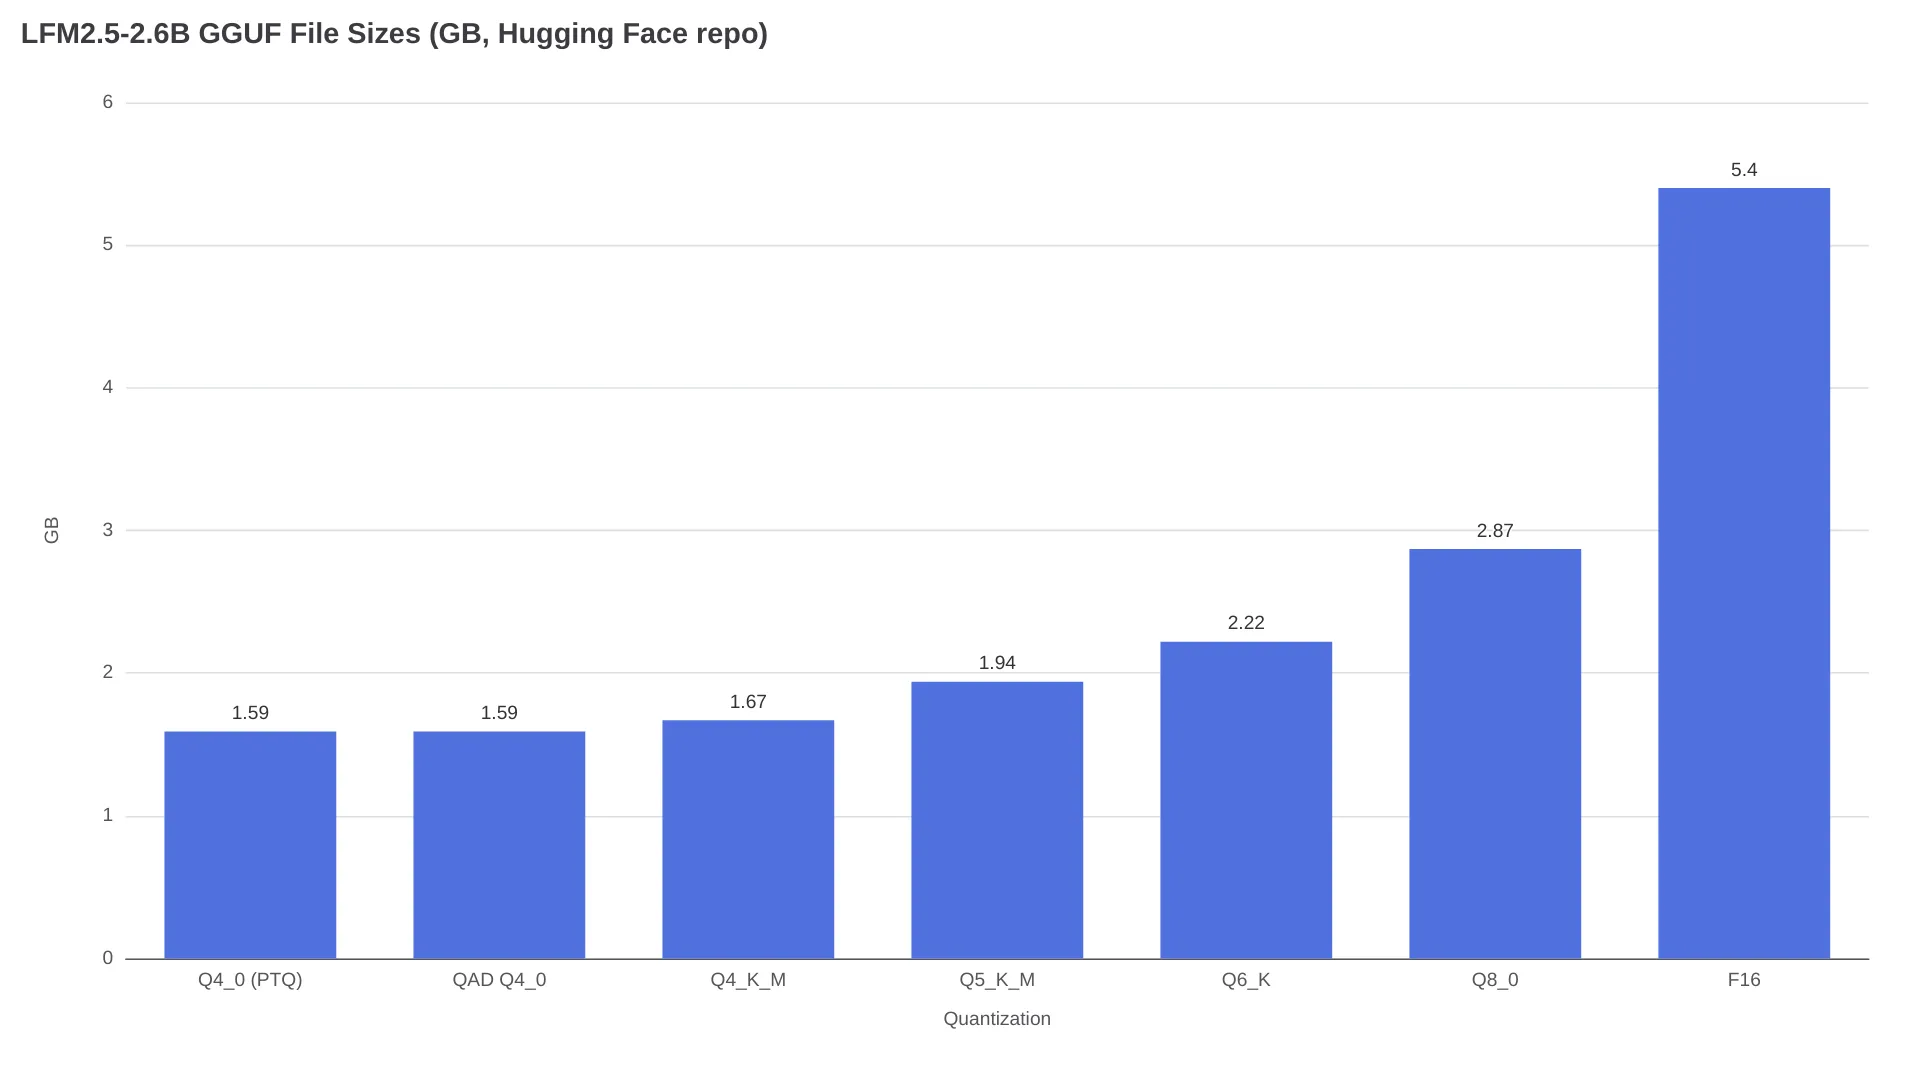
| Fichier (2.6B) | Taille | Positionnement | À choisir si |
|---|---|---|---|
| Q4_0 (ancien PTQ) | 1,59 Go | référence non corrigée | à éviter, QAD existe désormais |
| QAD Q4_0 | 1,59 Go | 96,6 % du BF16, équivaut à Q4_K_M | budget de 3 à 4 Go de RAM, décodage CPU, téléphones, Pi |
| Q4_K_M | 1,67 Go | choix par défaut de la documentation Liquid | votre runtime ne permet pas de sélectionner le fichier QAD |
| Q5_K_M | 1,94 Go | 91,4 % de top-1 face à F16, selon KikoCis | 6 Go+ de RAM |
| Q6_K / Q8_0 | 2,22 / 2,87 Go | perte quasi nulle | 8 Go+, priorité à la qualité |
Pour situer ces affirmations de parité, l'échelle PTQ de KikoCis mesure un accord top-1 par token de 84,36 % pour Q4_K_M face à F16 sur ce modèle, contre 95,07 % pour Q6_K et 98,23 % pour Q8_0. Liquid affirme que QAD comble cet écart de fidélité à 4 bits sans augmenter le nombre d'octets. Ce sont leurs chiffres, obtenus sur cinq exécutions, sans réplication indépendante à ce jour. Une précision utile issue des discussions du jour de sortie :
« Ce n'est pas “Q4_0 bat les K-quants”. Ces quatre checkpoints ont été entraînés pour Q4_0. » — @MarMarLabs
Ne généralisez pas ce résultat : les fichiers Q4_0 des autres modèles restent de la PTQ ordinaire.
Côté mémoire, le billet de lancement ne fournit aucun chiffre de RAM. Il faut donc s'appuyer sur les calculs du dépôt KikoCis : le cache KV du 2.6B consomme environ 16 Ko par token en f16, soit approximativement 0,54 Go à 32K de contexte et 2,15 Go dans la fenêtre native de 128K. L'option --cache-type-k q8_0 --cache-type-v q8_0 divise ce cache par deux. Les poids QAD Q4_0 à 1,59 Go, ajoutés à une fenêtre 32K, représentent environ 2,13 Go avant le surcoût du runtime ; à 128K, on dépasse 3,7 Go. Considérez donc 4 Go comme une configuration limite et vérifiez l'allocation avec votre runtime cible.
FAQ
QAD Q4_0 est-il meilleur que Q4_K_M ?
Pour ces quatre checkpoints, les chiffres de Liquid AI indiquent que QAD Q4_0 égale la qualité de Q4_K_M — ou de Q5_K_M pour les deux plus petits modèles — avec un décodage plus rapide dans un fichier plus petit. Avec un budget RAM serré, la réponse est donc oui. Ces données proviennent toutefois du fournisseur, sur cinq répétitions, sans réplication indépendante à ce jour.
Ollama ou LM Studio détectent-ils automatiquement le fichier QAD ?
Non. La commande documentée pour Ollama est ollama run hf.co/LiquidAI/LFM2.5-2.6B-GGUF:Q4_K_M, selon la page officielle du dépôt, et les exemples par défaut de Hugging Face ciblent aussi Q4_K_M. Tout runtime compatible GGUF peut charger le fichier QAD, mais vous devez le désigner explicitement par son nom ou avec le qualificatif :QAD-Q4_0.
Quelle quantité de RAM faut-il pour LFM2.5-2.6B QAD Q4_0 ?
Les poids occupent 1,59 Go. Les calculs de KikoCis estiment le cache KV f16 à environ 0,54 Go pour un contexte de 32K et à environ 2,15 Go à 128K. Le total poids plus cache atteint ainsi près de 2,13 Go à 32K et 3,74 Go à 128K, avant le surcoût du runtime. La quantification du cache KV en Q8_0 en divise le coût par deux.
Quels modèles LFM2.5 disposent de checkpoints QAD ?
Au 19 août 2026, seuls LFM2.5-230M, LFM2.5-350M, LFM2.5-1.2B-Instruct et LFM2.5-2.6B en disposent. Les variantes VL-450M et 8B-A1B n'en ont pas, même si des utilisateurs ont demandé à Liquid AI une build QAD 8B dans le fil de lancement.
Puis-je utiliser commercialement les checkpoints LFM2.5 QAD ?
Les dépôts sont étiquetés LFM Open License v1.0. Des dépôts communautaires résument les conditions comme autorisant l'usage commercial pour les entités dont le chiffre d'affaires annuel est inférieur à 10M USD, une licence commerciale Liquid AI distincte étant requise à partir de ce seuil (résumé de KikoCis). Lisez le texte de licence lui-même avant toute mise en production.
L'affirmation des 97 % a-t-elle été vérifiée indépendamment ?
Pas encore. Les chiffres de rétention de 96,5 à 97,4 % sont les moyennes sur cinq exécutions publiées par Liquid AI avec le lancement. Aucun benchmark tiers des fichiers QAD n'était disponible au moment de la rédaction, et la question de l'imatrix reste ouverte sur r/LocalLLaMA.
Faites votre propre A/B dès ce soir
Ce qui compte est le taux d'erreur sur votre tâche, pas une moyenne de benchmarks. Prenez dix prompts réels — JSON d'appels d'outils, votre schéma d'extraction, votre langue — et exécutez les deux fichiers avec des paramètres identiques :
llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-QAD-Q4_0.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1 \
  -p "<your prompt>"

llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-Q4_K_M.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1 \
  -p "<your prompt>"
Comptez les échecs de parsing et les mauvais choix d'outils pour chaque fichier, pas les impressions. Le compromis reste concret : sur le papier, QAD Q4_0 offre une meilleure qualité par gigaoctet en moyenne, mais les modes d'échec de votre déploiement — réponses vides quand le raisonnement épuise le budget de tokens, dérive de format selon la température — dépendent du runtime et de la tâche. Seuls vos dix prompts permettent d'en mesurer le coût.