 AIREITER
Faire tourner Kimi K3 dans OpenCode ne demande que trois commandes. Son tarif affiché le place au niveau de Sonnet, à 3 $/15 $ par million de tokens, mais une session OpenCode revient en moyenne à seulement 1,79 $ grâce à un cache de prompts très efficace.
Installer Kimi K3 dans OpenCode en trois étapes
OpenCode est un agent de développement open source en ligne de commande. Son authentification intégrée avec Kimi évite de renseigner une URL de base ou de modifier un fichier de configuration. Les étapes ci-dessous correspondent à OpenCode 1.18.3 et au guide d’intégration officiel de Kimi.
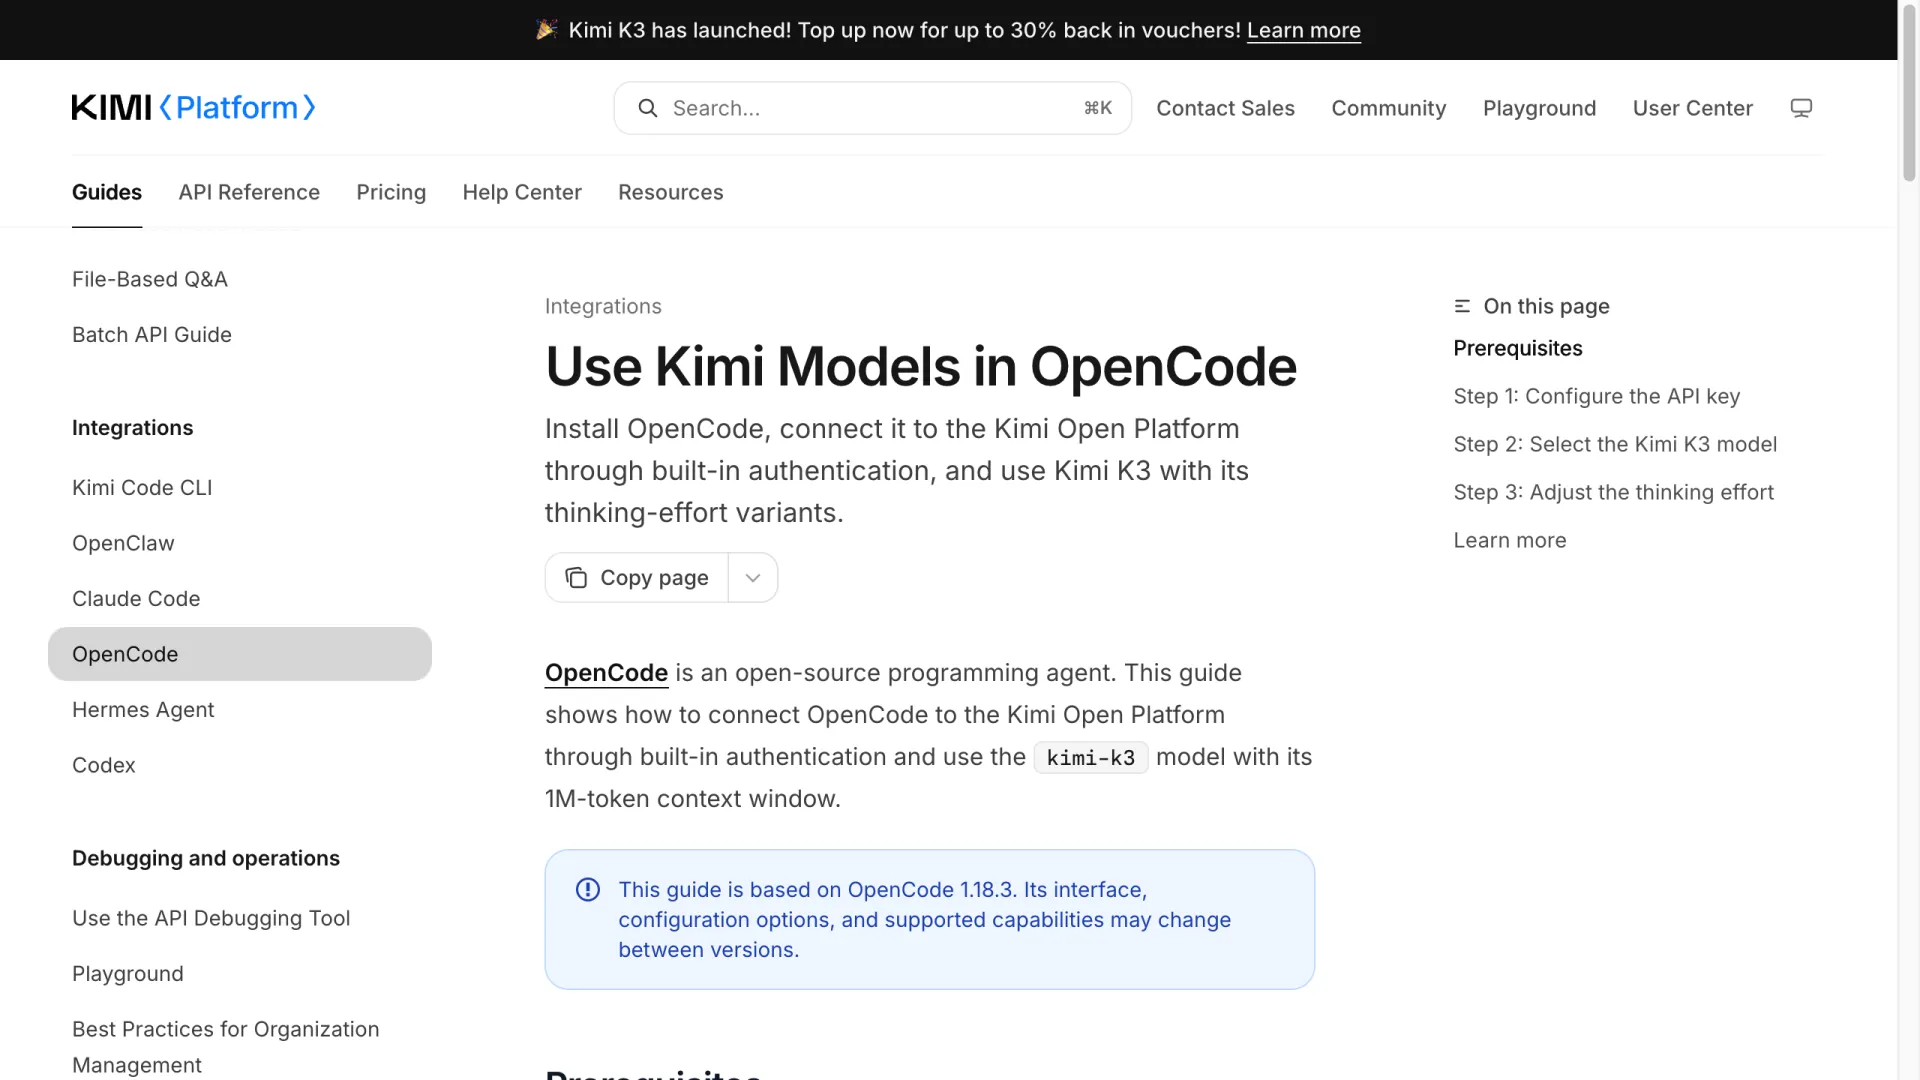
1. Ajouter votre clé API
Lancez opencode auth login, choisissez Moonshot AI comme fournisseur, puis collez la clé obtenue sur la Kimi Open Platform. Deux points méritent attention : votre compte doit disposer d’un solde réel, car les coupons réservés aux nouveaux utilisateurs ne fonctionnent pas avec K3. Et ne placez jamais cette clé dans un fichier de configuration, une capture d’écran ou un dépôt git : OpenCode la conserve dans son propre système d’identifiants, et ce n’est pas un hasard.
2. Choisir le modèle kimi-k3
Dans OpenCode, exécutez /models, puis sélectionnez kimi-k3. Vous activez alors le modèle avec sa fenêtre de contexte complète de 1M de tokens ; chaque réponse est plafonnée à 131K tokens. La barre d’état doit ensuite afficher « Kimi K3 » et « Moonshot AI ».
3. Régler l’effort de raisonnement
La commande /variants permet de définir l’intensité de raisonnement de K3 avant sa réponse. Le réglage par défaut est max, mais vous pouvez passer à high ou low. C’est le principal levier pour maîtriser la facture, comme le montrent les chiffres ci-dessous.
Le coût concret d’une session Kimi K3
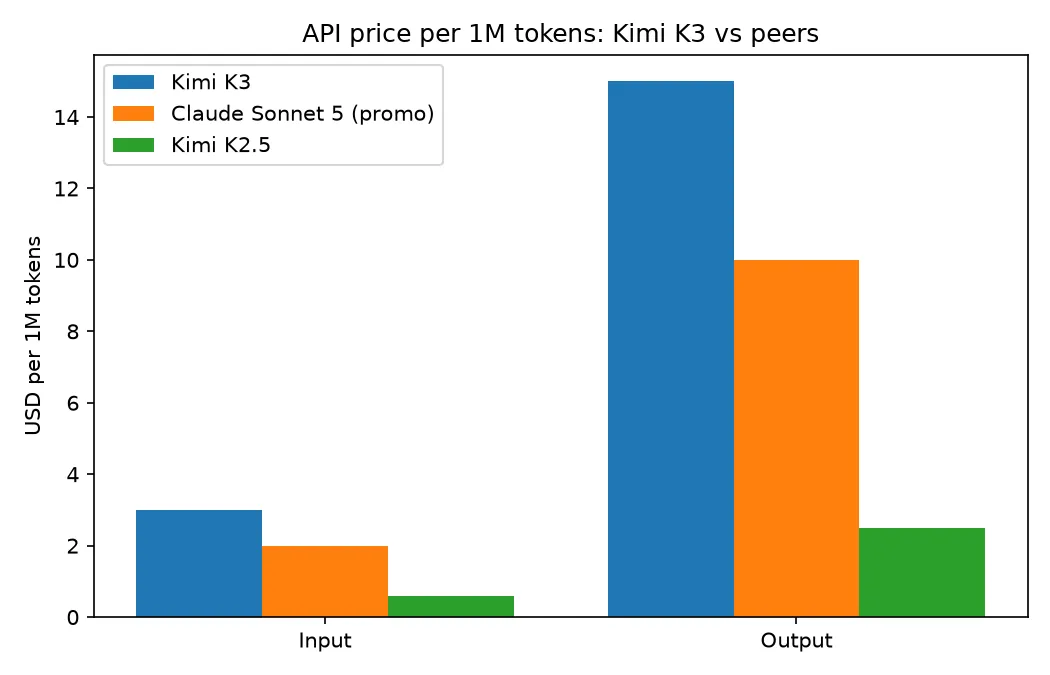
Les tarifs catalogue de K3 sont de 3 $ par million de tokens en entrée et 15 $ par million en sortie, soit davantage que le tarif promotionnel de Claude Sonnet 5 à 2 $/10 $.
Dans les faits, K3 coûte nettement moins cher : la majorité des tokens proviennent de lectures de cache bon marché. Les données d’usage publiques d’OpenCode, visibles sur sa page par modèle ci-dessous, établissent le coût moyen d’une session Kimi K3 à 1,79 $. Ce calcul porte sur 66 379 sessions terminées, qui consomment chacune 2,9M de tokens. On arrive ainsi à environ 0,62 $ par million de tokens réellement utilisés, très loin du tarif affiché de 3 $. L’explication est simple : 93 % des tokens d’entrée sont servis depuis le cache. Un cache hit coûte 0,30 $ par million, contre 3,00 $, soit 90 % de réduction. Artificial Analysis avance un tarif mixte de 2,31 $ par million, mais son estimation suppose seulement 70 % de cache ; le taux réel de 93 % observé dans OpenCode explique le coût inférieur des sessions.
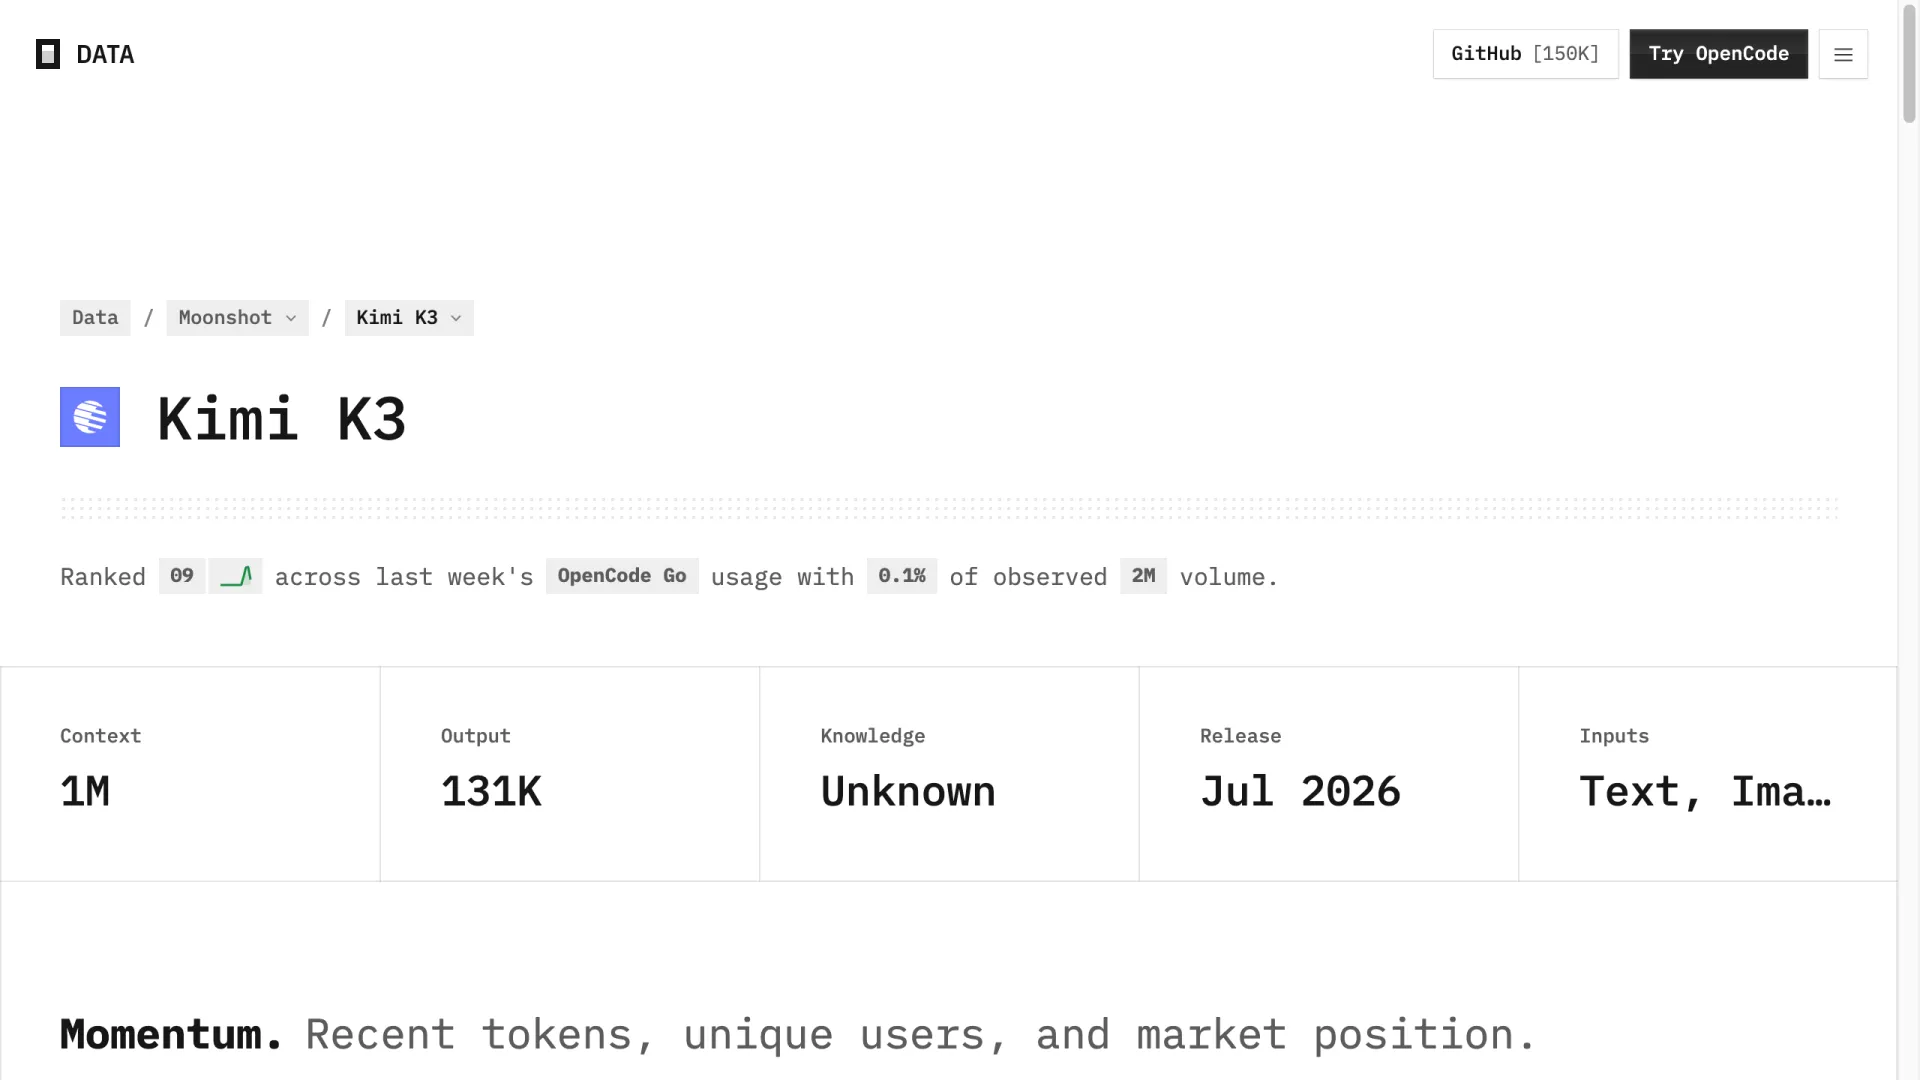
Le tarif catalogue reste donc comparable à Sonnet. La publication open-weight, avec les poids complets disponibles d’ici le 27 juillet 2026, change les possibilités d’auto-hébergement, pas le prix payé via l’API. Voici comment se comparent les tarifs au million de tokens :
K3 occupe la 9e place d’OpenCode Go en volume de tokens, et son utilisation a doublé durant les huit semaines précédant le 20 juillet, selon les données de dynamique d’OpenCode. Sur le papier, il est coûteux ; pour les tâches difficiles, la demande reste pourtant forte.
Pourquoi K3 consomme autant de tokens — et comment le canaliser
Le reproche le plus fréquent ne concerne pas le prix unitaire des tokens, mais leur volume. Réglé par défaut sur l’effort de raisonnement max, K3 réfléchit longuement avant d’agir. Pour une modification simple, ce raisonnement devient une dépense inutile. En juillet 2026, un utilisateur d’OpenCode résumait crûment le problème sur X : le modèle peut consommer énormément de tokens « without accomplishing much » sur des tâches qu’un modèle plus léger terminerait plus vite.
Trois réglages permettent de garder la situation sous contrôle :
- Réduire la variante. Passez par
/variantset choisissezlowouhighpour le travail courant. Le modemaxse justifie pour l’architecture et les refactorings multi-fichiers, pas pour renommer une fonction. - Profiter du cache. Le taux de cache hit de 93 % est précisément ce qui maintient le coût des sessions à un niveau bas. Préférez une longue session continue à plusieurs redémarrages : chaque nouvelle session renvoie du contexte non mis en cache, facturé au tarif plein.
- Alléger le harnais de l’agent. K3 a tendance à suranalyser lorsque le scaffold de l’agent est trop bruyant. Réduisez les fichiers d’instructions toujours chargés, les serveurs MCP inutilisés et les descriptions d’outils trop verbeuses. Il fera moins d’allers-retours avec les outils et aura moins d’occasions de s’enfermer dans une spirale.
Il faut toutefois accepter un compromis : dans OpenCode, K3 paraît plus lent que les modèles légers, en raison de ce coût du raisonnement. Si la latence compte davantage que la profondeur d’analyse, mieux vaut changer de modèle.
Kimi K3 ou Kimi K2.7 Code : dans quels cas le moins cher suffit
K3 coûte environ trois fois plus cher que Kimi K2.7 Code. La vraie question est donc de savoir à partir de quel besoin cette différence de prix se justifie.
Pour vérifier ce que vaut l’option économique, j’ai appelé K2.7 Code via son API le 2026-07-20 avec une petite tâche : écrire une fonction Python merge_intervals accompagnée d’une analyse de complexité. Le modèle a renvoyé en 10,7 secondes un code correct et idiomatique — tri, puis fusion linéaire, avec une complexité temporelle O(n log n) et spatiale O(n) — en utilisant 52 tokens de prompt et 341 tokens de complétion. Pour le développement quotidien, comme les corrections de bugs, les petites fonctions ou le squelette de tests, cela suffit à la plupart des utilisateurs, pour une facture de tokens qui ne représente qu’une fraction de celle de K3.
Gardez K3 pour ses domaines de prédilection : les tâches de contexte long qui remplissent sa fenêtre de 1M, le raisonnement complexe à travers plusieurs fichiers et les cas où un modèle plus léger échoue systématiquement. Le comparatif entre K2.7 Code et GLM 5.2 constitue une bonne référence si vous cherchez un modèle de tous les jours plutôt qu’un outil pour les charges lourdes.
API directe, OpenRouter ou abonnement : réduire la facture
La manière dont vous accédez à K3 influe à la fois sur le coût et sur la fiabilité.
API Kimi directe. Se connecter directement à la Kimi Open Platform est l’option la plus fiable. Sur OpenRouter, K3 est servi par un unique fournisseur et peut renvoyer fréquemment des erreurs 429, liées aux limites de débit, en période de charge. Le passage en direct contourne ce goulot d’étranglement.
Abonnement OpenCode Go. Un forfait mensuel, autour de 10–19 $, transforme K3 en une « seconde réserve » à tarif fixe, à utiliser quand votre modèle principal cale. Plusieurs utilisateurs l’emploient exactement ainsi : comme solution de repli lorsqu’une session Claude s’interrompt en plein travail, et non comme modèle utilisé en continu.
Passerelle API. Si vous faites déjà transiter plusieurs modèles par une seule clé, une passerelle compatible Anthropic et OpenAI comme AIReiter permet d’appeler K3 aux côtés d’autres modèles, avec une facturation à l’usage et la même économie de cache qui réduit le coût par session. Le détail des tarifs Kimi K3 présente les calculs par token pour comparer les options avant de vous engager.
Faut-il utiliser Kimi K3 dans OpenCode ?
Deux profils ont intérêt à y réfléchir à deux fois. Pour des boucles d’agents nombreuses et peu coûteuses, K2.7 Code ou un modèle plus léger fera économiser de l’argent avec peu de perte de qualité. Et si vous avez besoin de réponses immédiates, le raisonnement en effort max de K3 semblera lent tant que vous n’aurez pas réduit la variante.
Pour les autres, oui. Vous obtenez un modèle en tête des classements, doté d’un contexte de 1M de tokens, configuré en trois commandes et facturé moins de 2 $ pour une vraie session — avec un contrôle complet si vous cherchez à remplacer un assistant qui s’interrompt au milieu d’une tâche.
FAQ
Kimi K3 est-il gratuit dans OpenCode ?
Non. K3 est facturé à l’usage et nécessite un solde approvisionné sur la Kimi Open Platform ; les coupons pour nouveaux utilisateurs ne s’y appliquent pas. OpenCode est lui-même gratuit et open source : vous ne payez que les tokens de K3.
Quel est le prix de Kimi K3 par million de tokens ?
Le tarif affiché est de 3 $ par million de tokens d’entrée et de 15 $ par million de tokens de sortie. En pratique, le montant payé est bien inférieur : les cache hits coûtent 0,30 $ par million, et les sessions réelles dans OpenCode atteignent en moyenne 1,79 $ grâce à un taux de cache hit de 93 %.
Kimi K3 est-il open source ?
Il est open-weight. Moonshot publie les poids complets du modèle d’ici le 27 juillet 2026, ce qui en fait le premier modèle ouvert de la catégorie des 3 trillions de paramètres. L’API hébergée reste payante.
Kimi K3 code-t-il aussi bien que Claude ?
Dans le classement de programmation d’Arena, K3 est actuellement en tête et obtient un score de 57 dans l’Artificial Analysis Intelligence Index, soit la 4e place sur 187 modèles. En pratique, il rivalise avec les modèles propriétaires de pointe sur les tâches de code difficiles, pour un tarif catalogue similaire.
Pourquoi Kimi K3 renvoie-t-il des erreurs 429 ?
Les erreurs 429 fréquentes viennent généralement d’un routage via OpenRouter, où K3 est servi par un seul fournisseur. Se connecter directement à la Kimi Open Platform avec l’authentification intégrée d’OpenCode permet d’éviter cette limite.