 AIREITER
Sur le papier, les tarifs de l’API GPT Image 2.6 n’ont pas bougé. En pratique, les brouillons bon marché ont pris un sérieux coup de chaud. OpenAI applique les mêmes tarifs par token à gpt-image-2.6-flare et gpt-image-2.6-sunburst, mais la consommation mesurée en basse qualité est 4,2 fois supérieure à celle de GPT Image 2.5. Premier réflexe pour éviter les mauvaises surprises : définir explicitement la qualité.
Une image 1:1 coûte de 0,025 à 0,211 $, et la basse qualité n’est plus économique
En 1:1, le coût d’une image GPT Image 2.6 va d’environ 0,025 $ en basse qualité à 0,211 $ en qualité maximale, lorsque les tokens sont mesurés avec le même prompt. TrezaLabs a généré le même prompt 1:1 selon cinq niveaux de qualité le 5 novembre 2026, avec une facturation de 0,00003 $ par token d’image en sortie.
| Qualité | Tokens de sortie mesurés | Coût approximatif par image 1:1 |
|---|---|---|
| Basse | 824 | 0,025 $ |
| Moyenne | 1 449 | 0,043 $ |
| Élevée | 1 756 | 0,053 $ |
| Très élevée | 3 122 | 0,094 $ |
| Maximale | 7 024 | 0,211 $ |
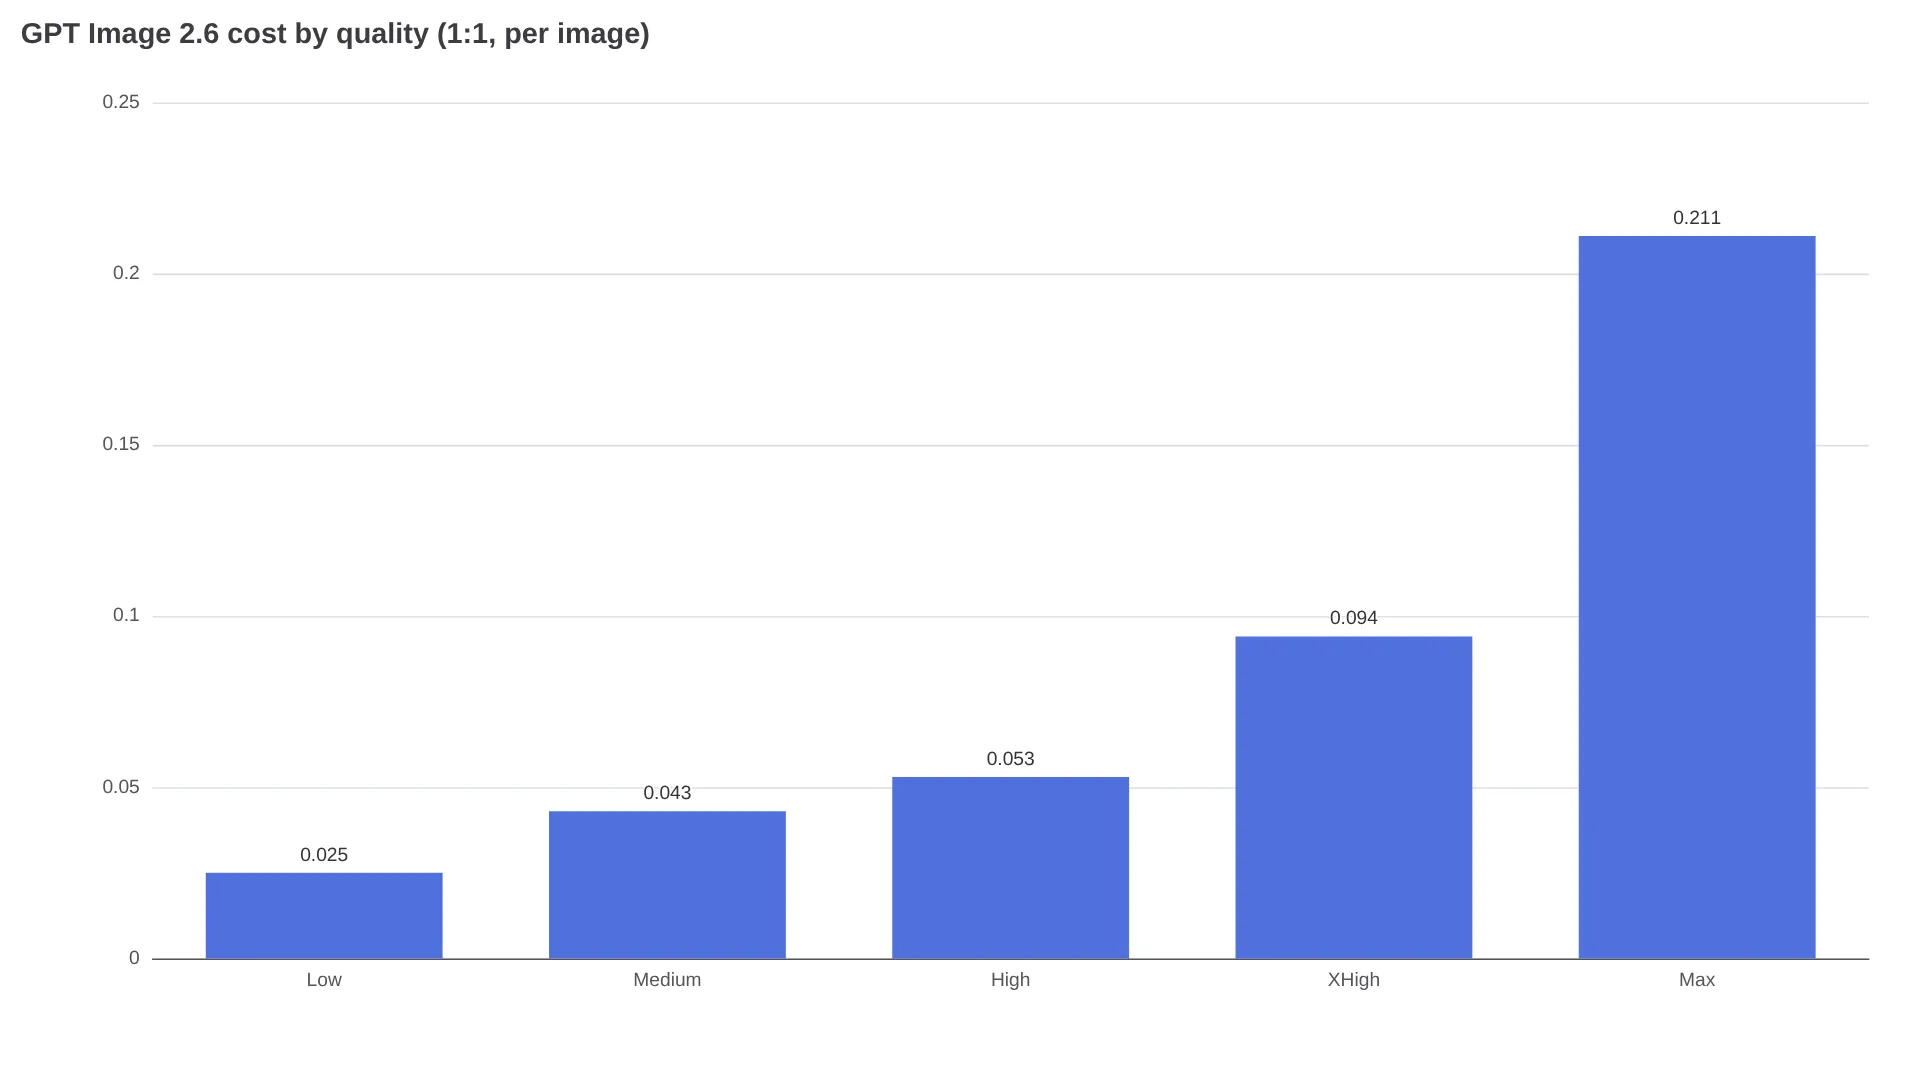
Le piège, c’est de passer à 2.6 sans revoir ses réglages de qualité. La basse qualité de GPT Image 2.6 n’est plus le mode brouillon à moins d’un centime proposé par GPT Image 2.5. Comptez 2,47 $ de génération, hors entrées, pour 100 brouillons en basse qualité, et environ 21 $ pour 100 rendus finaux en qualité maximale : ce ne sont clairement pas les mêmes postes budgétaires.
Les tarifs officiels par token expliquent les écarts entre les trois grilles
La tarification de l’API OpenAI indique les mêmes montants pour GPT Image 2.6 Flare et Sunburst : 5 $ pour 1 million de tokens de texte en entrée, 1,25 $ pour 1 million de tokens de texte en entrée mis en cache, 8 $ pour 1 million de tokens d’image en entrée, 2 $ pour 1 million de tokens d’image en entrée mis en cache, et 30 $ pour 1 million de tokens d’image en sortie. La page tarifaire officielle reste la référence en cas de changement. Les pages OpenAI consacrées à Flare et à Sunburst confirment les mêmes prix par token.
Trois façons de lire les tarifs circulent, mais elles ne mesurent pas la même chose :
- Les tarifs officiels par token donnent le prix unitaire, pas le coût total par image. La consommation varie selon la qualité et la taille ; les références ajoutent par ailleurs leurs propres tokens d’image en entrée.
- La facturation mesurée en tokens convertit un prompt fixe en montant réel. TrezaLabs a relevé entre 824 et 7 024 tokens de sortie, de la basse qualité à la qualité maximale, en 1:1, auxquels s’ajoute un faible coût de tokens texte. Mockingbird a mesuré environ 1 600 tokens de sortie pour une publicité 1088x1360 en haute qualité, soit environ 0,048 $ de sortie avant les entrées.
- Les grilles fixes de prestataires tiers simplifient la planification. HiAPI publie une grille de 15 cases allant de 0,023 $ en basse qualité 1K à 0,636 $ en qualité maximale 4K. Yir estime le coût entre environ 0,0367 et 0,2227 $ pour du 1K, de la basse qualité à la qualité maximale, via la route officielle.
Utilisez les tarifs officiels pour les contrats, les tokens mesurés pour vos propres prompts et dimensions, et les grilles fixes uniquement pour une estimation grossière de capacité. Un devis fixe de 0,04 $ par image suppose une qualité, une résolution et un nombre de références précis, qui peuvent ne pas correspondre à votre pipeline.
Les niveaux de qualité sont low, medium, high, xhigh, max, ainsi que auto. La résolution peut être de 1K, 2K ou 4K. Une qualité supérieure augmente le niveau de détail interne, pas le nombre de pixels : TrezaLabs a obtenu du 1024x1024 à chaque niveau de qualité en 1:1. Le paramètre complexity (low/medium/high, avec high par défaut) agit sur l’effort de planification, pas sur le niveau de détail visuel, et n’entraîne aucun frais supplémentaire.
Pourquoi le budget GPT Image 2.5 dérape avec 2.6
GPT Image 2.6 conserve le même prix par token que GPT Image 2.5. Pourtant, dans les mesures 1:1 citées de TrezaLabs, le modèle 2.6 a consommé davantage de tokens de sortie en basse et moyenne qualité, à format 1:1 identique.
| Qualité | Tokens GPT Image 2.5 | Tokens GPT Image 2.6 | Effet sur le coût |
|---|---|---|---|
| Basse | 196 | 824 | ~4,2 fois plus |
| Moyenne | 439 | 1 449 | ~3,3 fois plus |
| Élevée | 1 756 | 1 756 | inchangé |
| Très élevée | 3 122 | 3 122 | inchangé |
| Maximale | 7 024 | 7 024 | inchangé |
La basse qualité passe de moins de 0,01 $ sur 2.5 à environ 0,025 $ sur 2.6, tandis que la qualité moyenne grimpe d’environ 0,013 à environ 0,043 $. Le fil de discussion de facturation r/codex confirme cette hausse de 4,2 fois en basse qualité (discussion). Pour les brouillons en volume, mieux vaut donc conserver GPT Image 2.5 et définir quality explicitement afin d’éviter les variations liées à auto (TrezaLabs).
Flare ou Sunburst : même tarif, pas le même temps d’attente
Flare et Sunburst partagent les mêmes tarifs officiels et leurs résultats se situent à moins de 3 % d’écart dans de petits tests. Le choix se joue donc d’abord sur la latence : mesurez votre propre charge de travail. TrezaLabs a relevé des nombres de tokens identiques, à l’exception d’une différence de deux tokens en haute qualité. De son côté, Mockingbird a constaté environ 3 % de tokens de sortie supplémentaires avec Flare sur des publicités, pour un écart inférieur ou égal à 0,001 $ par image.
C’est sur la vitesse que les deux déclinaisons se distinguent. TrezaLabs a chronométré le même prompt à chaque niveau de qualité le 5 novembre 2026, avec un seul rendu par niveau : ces chiffres donnent une tendance, pas un benchmark formel.
| Qualité | Durée avec Flare | Durée avec Sunburst |
|---|---|---|
| Basse | 6 s | 17 s |
| Moyenne | 10 s | 27 s |
| Élevée | 10 s | 50 s |
| Très élevée | 23 s | 82 s |
| Maximale | 41 s | 166 s |
Pour des publicités 1088x1360 en haute qualité, Mockingbird a mesuré 16 à 26 secondes avec Flare, contre 51 à 55 secondes avec Sunburst 2.6, pour des coûts respectifs de 0,089-0,108 $ et 0,088-0,107 $. OpenAI annonce une génération 50 % plus rapide et un délai pouvant descendre à six secondes avec Flare en basse qualité (annonce). Mockingbird confirme l’avantage de Flare, mais a trouvé Sunburst 2.6 plus lent que Sunburst 2.5 dans ses deux tests publicitaires. OpenAI présente Flare comme le modèle de l’itération rapide et Sunburst comme celui de la cohérence des détails (annonce).
Les premiers retours d’utilisateurs sont plutôt sceptiques sur le compromis entre qualité et vitesse, comme le montrent la discussion r/singularity et les fils r/OpenAI :
J’aimerais vraiment qu’ils corrigent le modèle pour qu’il arrête d’ajouter ces vilaines marbrures.
— u/lyeeedar, fil de test GIF de r/OpenAI
GIF, SVG et images de référence ajoutent leurs propres frais
Les formats et options supplémentaires sont facturés en dehors de la grille de base par niveau de qualité. Chacun obéit à une règle de facturation et à une contrainte principale.
| Fonctionnalité | Coût ajouté | Règle de facturation | Contrainte principale |
|---|---|---|---|
| GIF | 0,070 $ en basse qualité à 0,598 $ en qualité maximale (HiAPI) | Selon la qualité uniquement, pas la résolution ; 2 à 16 images, 9 par défaut, 20 à 2 000 ms par image | Limites de la planche : 3840 px sur le plus grand côté, 8 294 400 px de surface maximale, ratio maximal de 3:1 |
| SVG | +0,030 $ par rapport au tarif du niveau (HiAPI) | Supplément fixe ; 0,053 $ en basse qualité 1K, 0,666 $ en qualité maximale 4K | Texte-vers-image uniquement ; image-vers-image reste limité à PNG, JPEG, WebP |
| Images de référence | Exemple : +0,012 $ par image ; varie selon les tokens | Tarif de base + 0,012 $ x le nombre dans l’exemple cité, de 1 à 16 références (HiAPI) | Une photo de produit a utilisé 1 523 tokens en entrée (TrezaLabs) ; 16 références ajoutent 0,192 $ dans cet exemple |
Les calques mask et markup n’entraînent aucun frais supplémentaire (HiAPI).
Les limites de Batch et de Responses modifient la facture
Au lancement, GPT Image 2.6 fonctionne uniquement via les endpoints de génération et d’édition de l’Images API, sans Responses API ni Batch API (comparatif). GPT Image 2.5 conserve l’accès à Responses et Batch, avec notamment un tarif Batch de 15 $ par million de tokens de sortie.
- Aucune remise Batch de 50 % n’existe pour 2.6 : les équipes qui génèrent en volume ne peuvent donc pas programmer des lots 2.6 de nuit à moitié prix.
- Les agents fondés sur Responses doivent rester sur 2.5 ou séparer leur architecture entre le raisonnement Responses et les appels à l’Images API, avec un suivi distinct des nouvelles tentatives.
- Les abonnements ChatGPT ne couvrent pas l’utilisation de l’API. ChatGPT et Codex incluent Images 2.6 dans toutes les formules, y compris la version gratuite (annonce), mais les appels API sont facturés au token. Par ailleurs, ChatGPT ne propose aucun sélecteur Flare/Sunburst documenté : définissez donc explicitement l’identifiant du modèle pour obtenir des tests reproductibles.
Un workflow maîtrisé qui permet quand même de livrer
Pour contenir les coûts, utilisez Flare en basse qualité pour les brouillons, puis réservez Sunburst en haute ou maximale qualité aux rendus finaux.
- Générez 100 variantes en 1:1 avec Flare en basse qualité, pour environ 2,47 $ de sortie, hors entrées. Évaluez la composition, pas la texture.
- Sélectionnez 10 variantes et passez-les en haute qualité avec Flare, à environ 0,053 $ chacune, soit environ 0,53 $ pour cette étape. Vérifiez le texte, les mains et les libellés produits.
- Finalisez 2 ou 3 visuels avec Sunburst en haute ou maximale qualité. Deux images finales 1:1 en qualité maximale coûtent environ 0,42 $ de sortie.
- Limitez les références. Six mood boards inutilisés ajoutent environ 0,072 $ à chaque rendu dans l’exemple cité, soit davantage qu’une image 1:1 en basse qualité.
- Définissez explicitement
qualityetcomplexity; OpenAI recommande une complexité faible pour les retouches ciblées (Mockingbird).
| Usage | Réglage | Coût approximatif de sortie pour 100 images |
|---|---|---|
| Brouillons en volume | Flare basse qualité 1:1, mesuré | 2,47 $ |
| Revue avant finalisation | Flare haute qualité 1K, proxy 1:1 mesuré | ~5,30 $ |
| Rendus finaux payants | Sunburst qualité maximale 1:1, mesuré | 21,10 $ |
Réservez GPT Image 2.6 aux menus, libellés, affiches et retouches qui préservent les produits, lorsque la qualité de son rendu de texte justifie 0,05 à 0,21 $ par image.
FAQ
Flare et Sunburst coûtent-ils le même prix ?
Oui. OpenAI affiche les mêmes tarifs par token pour gpt-image-2.6-flare et gpt-image-2.6-sunburst. Les tokens de sortie mesurés sont restés dans une fourchette de 3 % entre les différents tests, ce qui limite l’écart à environ 0,001 $ par image. Choisissez selon la vitesse et la cohérence des retouches, pas selon le prix.
Pourquoi n’y a-t-il pas de tarif fixe par image ?
OpenAI facture 30 $ par million de tokens d’image en sortie, auxquels s’ajoutent les tokens d’entrée. Or le nombre de tokens de sortie varie d’environ 824 à 7 024 par image en 1:1, selon la qualité. Tout montant fixe suppose donc une qualité, une résolution et un nombre de références donnés.
GPT Image 2.6 est-il plus cher que GPT Image 2.5 ?
En basse et moyenne qualité, oui : environ 824 contre 196 tokens en basse qualité, et 1 449 contre 439 en qualité moyenne. À partir de la haute qualité, les tokens mesurés sont identiques. Les pipelines qui produisent beaucoup de brouillons ont intérêt à conserver 2.5 pour les variantes économiques.
Comment les GIF et les SVG sont-ils facturés ?
La facturation des GIF dépend uniquement de la qualité, d’environ 0,070 $ en basse qualité à 0,598 $ en qualité maximale, pour 2 à 16 images. Le SVG ajoute environ 0,030 $ au tarif du niveau et ne fonctionne qu’en texte-vers-image.
Quels tokens font réellement grimper la facture ?
Les tokens d’image en sortie, facturés 30 $ par million, dominent la facture ; un prompt texte de 1 000 tokens coûte 0,005 $ au tarif de 5 $ par million. Les tokens texte mis en cache à 1,25 $ et les tokens d’image en entrée à 2 $ réduisent le coût des retouches répétées avec des références partagées, mais les tokens de sortie ne sont pas mis en cache.