 AIREITER
La plupart des développeurs peuvent-ils réellement appeler GPT-6 Cyber aujourd’hui ? Non. D’après la documentation d’OpenAI, les benchmarks des fournisseurs et les retours d’utilisateurs, GPT-6 Cyber est un spécialiste de l’exploitation particulièrement performant, mais son accès reste soumis à l’approbation Daybreak Red. Pour la majorité des tâches défensives, GPT-6 Astra fait le travail à moitié prix.
Lancé le 5 novembre 2026 sous le nom de gpt-6-cyber, le modèle est issu d’un post-entraînement de GPT-6 Astra axé sur la découverte de vulnérabilités autorisée, la validation d’exploits et le développement de correctifs. Son accès est réservé à Daybreak Red, selon Kingy et la généalogie présentée par BenchLM.
Red ou Blue ? Le choix en 30 secondes
Le routage vers GPT-6 Cyber dépend d’abord de la mission, pas seulement du compte utilisé. Daybreak Blue convient aux tâches défensives avec les modèles principaux, tandis que Daybreak Red s’adresse aux opérations offensives autorisées et donne accès au modèle gpt-6-cyber.
| Votre mission | Niveau à viser | Modèle à appeler | Ce qui change |
|---|---|---|---|
| Revue de code sécuritaire, analyse de malwares, réponse à incident, validation de correctifs | Daybreak Blue | gpt-6-sol, gpt-6-luna, gpt-5.6-sol | Moins de refus que sur l’accès standard, mais pas d’autorisation de développer des exploits |
| Pentest autorisé, red team, validation d’exploits à grande échelle | Daybreak Red | gpt-6-cyber (+ gpt-5.5-cyber, gpt-5.6-cyber) | Approbation distincte, valeur daybreak_red, liste blanche d’adresses IP, SSO/MFA |
| Développement général avec quelques revues de sécurité | Standard ou Blue | gpt-6-sol, gpt-6.1-sol | Le surcoût de Cyber n’est pas justifié |
| Recherche sur des cibles durcies ou des zero-day avec une forte exigence de reproductibilité | Daybreak Red (si vous êtes éligible) | gpt-6-cyber | Prévoyez une revue humaine et un environnement en sandbox |
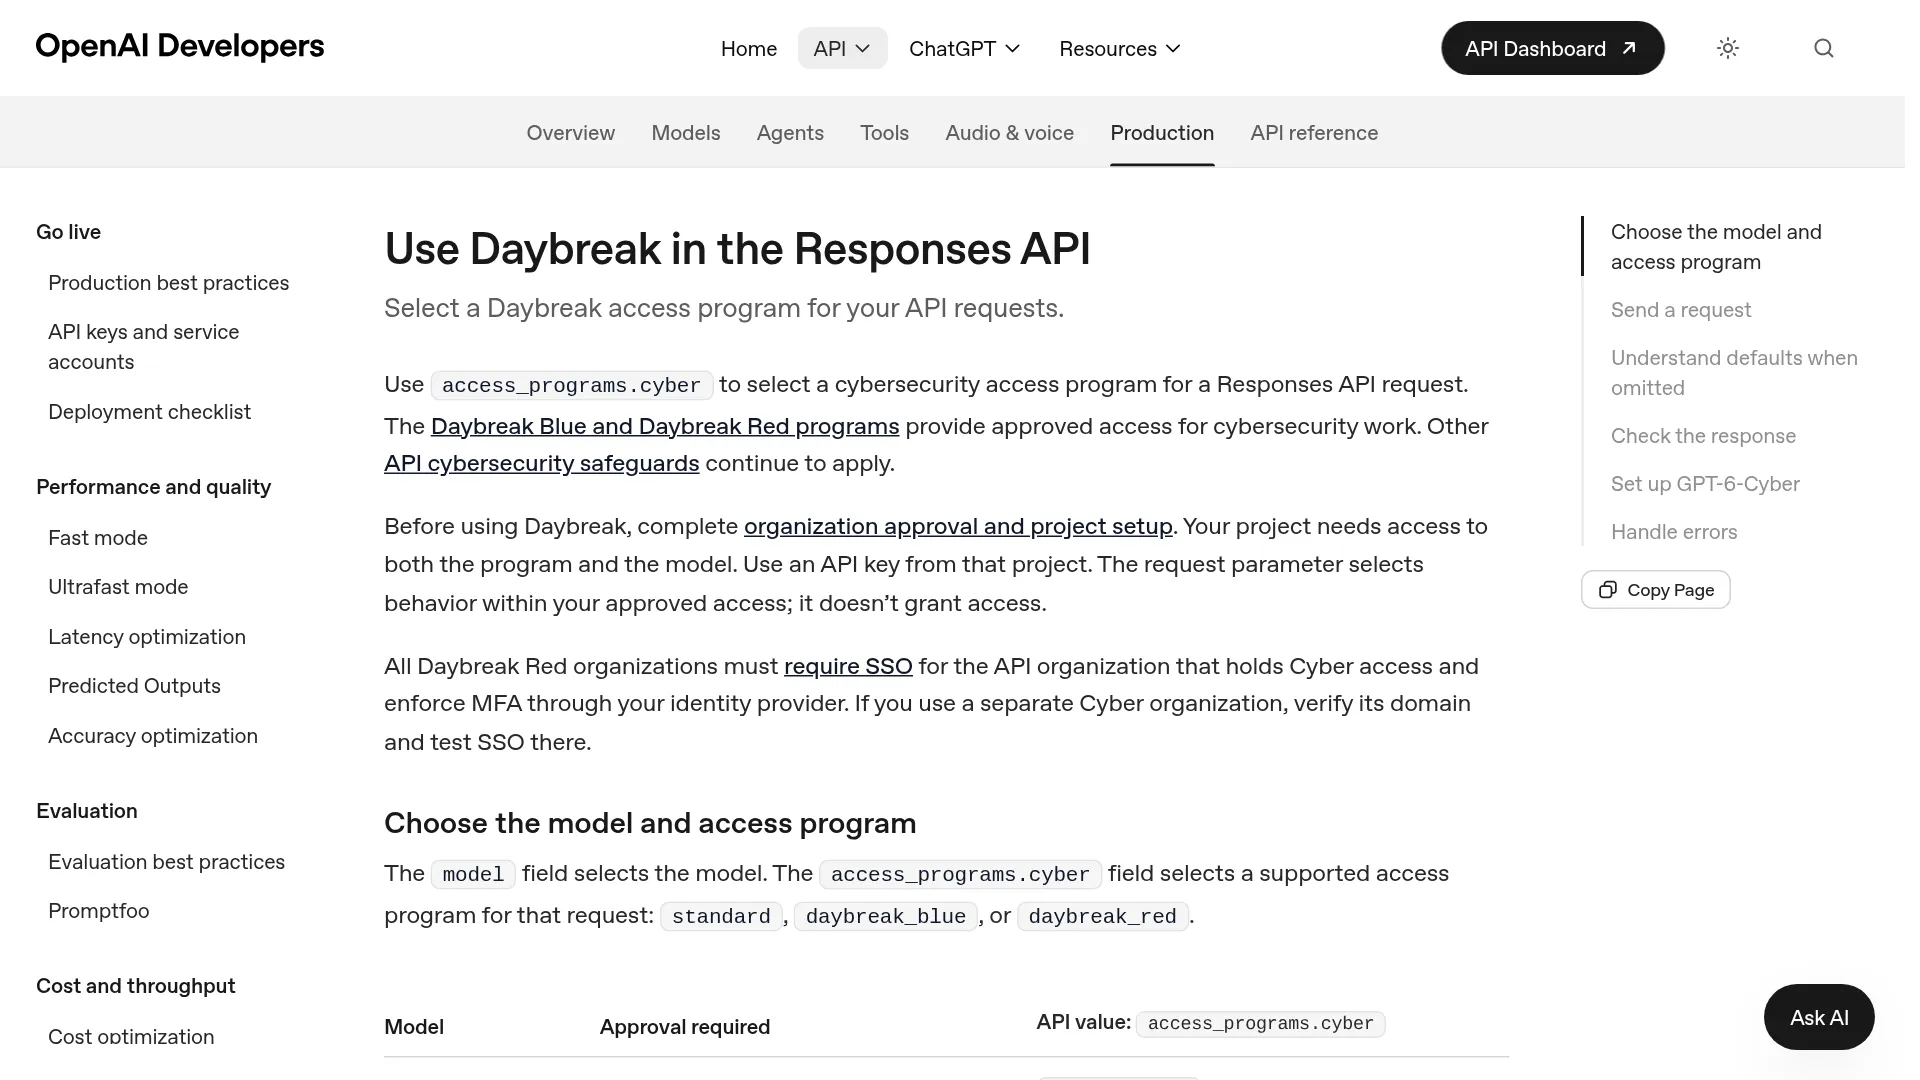
Le guide de l’API Daybreak d’OpenAI est sans ambiguïté : le paramètre de requête ne donne pas accès au programme. L’organisation, le projet, le programme et le modèle doivent avoir été approuvés au préalable, et la clé doit provenir de ce projet.
En pratique : demandez Blue si vous défendez des logiciels. Ne visez Red que si vous pouvez documenter des opérations offensives autorisées, exploiter une infrastructure isolée et maintenir un humain dans la boucle.
Ce qu’est vraiment GPT-6 Cyber — et ce que signifie la note Critical
GPT-6 Cyber est un spécialiste à poids fermés, accessible uniquement via l’API et Codex. Il dérive de GPT-6 Astra et a reçu un renforcement supplémentaire orienté cybersécurité. Son entraînement privilégie la réussite des exploits, le respect du périmètre autorisé et la transparence sur les tâches incomplètes, selon l’analyse de la fiche système par Kingy.
Le contexte est très large, mais reste borné, d’après l’analyse de la documentation par Kingy : fenêtre de contexte de 1 050 000 tokens, entrée maximale de 922 000 tokens et sortie maximale de 128 000 tokens. Le modèle accepte du texte et des images, mais ne produit que du texte. Il est disponible via Responses et Chat Completions, avec streaming, appels de fonctions et sorties structurées. Le fine-tuning et la Batch API ne sont pas pris en charge.
Critical correspond à une bande de capacité du Preparedness Framework interne d’OpenAI, pas à une certification de sécurité indépendante. OpenAI classe GPT-6 Cyber et GPT-6 Astra dans la catégorie Critical pour la cybersécurité, contre High pour GPT-5.6 Cyber, selon ArtificialWatch. Cette catégorie signifie que le modèle peut identifier et développer des exploits zero-day fonctionnels sur des systèmes réels durcis, ou planifier des attaques de bout en bout contre des cibles durcies, d’après le bilan de sécurité d’OpenAI consacré à GPT-6 Astra.
Pour les développeurs, Critical a trois conséquences concrètes :
- Accès restreint via Daybreak Red, avec une approbation supplémentaire pour le modèle
gpt-6-cyber - Contrôles de déploiement obligatoires : isolation, limites de cibles, validation des actions et supervision capable de mettre Codex en pause, d’interrompre des requêtes ou de révoquer l’accès
- Gestion ZDR plus contraignante : Private Safety Processing, avec des journaux de sécurité chiffrés conservés pendant 30 jours dans un stockage contrôlé par le client, selon Magica
À lire aussi : notre revue de l’API GPT-6 Astra, ce que l’on sait de GPT-6, et le bilan d’OpenAI DevDay 2026.
Red contre Blue dans l’API Responses
La confusion entre Daybreak Red et Blue provoque un échec d’intégration fréquent. L’API Responses sépare le modèle du programme d’accès : la valeur envoyée doit correspondre au modèle utilisé, et non au niveau le plus élevé détenu par l’organisation.
| Modèle | Approbation requise pour l’organisation | Valeur à envoyer dans access_programs.cyber | En cas d’erreur |
|---|---|---|---|
gpt-6-sol | Blue ou Red | daybreak_blue | daybreak_red renvoie invalid_access_program |
gpt-6.1-sol, gpt-6-astra | Red (pour réduire les refus) | daybreak_blue | daybreak_red est refusé ; Blue seul conserve les garde-fous standard sur Astra |
gpt-5.5-cyber, gpt-5.6-cyber | Red | daybreak_red | En l’absence de valeur, Red est sélectionné automatiquement et la requête échoue sans accès |
gpt-6-cyber | Red plus approbation distincte du modèle | daybreak_red | Échec si le projet n’est pas activé, si l’IP n’est pas autorisée ou si la clé est incorrecte |
Voici à quoi ressemble un appel minimal à GPT-6 Cyber :
{
  "model": "gpt-6-cyber",
  "access_programs": { "cyber": "daybreak_red" },
  "safety_identifier": "user_a17f",
  "input": "Suggest a regression test for a path traversal fix."
}
La configuration de GPT-6 Cyber ajoute plusieurs étapes absentes des projets Blue : projet Red activé par le propriétaire, adresse IP autorisée, SSO/MFA et stockage ZDR validé lorsque nécessaire. La réponse renvoie le programme appliqué dans access_programs.cyber. Avec les appels en -latest, il faut également vérifier le champ model résolu, comme le précise le guide de l’API Daybreak.
Qui peut réellement y accéder ? La présentation de Daybreak par OpenAI évoque les entreprises éligibles et les professionnels de la cybersécurité. Red exige une approbation distincte et une vérification renforcée. Au lancement, GPT-6 Cyber a été proposé à un groupe limité de clients Red approuvés, via l’API et Codex. Une ouverture à tous les clients Red a été promise, sans date annoncée, selon le compte rendu du lancement par ArtificialWatch. Au moment de cette revue, aucune disponibilité dans ChatGPT n’avait été annoncée et les laboratoires indépendants n’avaient pas encore testé le modèle, son accès étant restreint, d’après la fiche de BenchLM.
Le passage de Blue à Red reste particulièrement opaque : des pentesters expliquent avoir terminé la vérification, obtenu Blue, puis ne trouvé aucune procédure claire pour passer à Red.
« Récemment, Daybreak Blue comme le Codex normal refusent de corriger les bugs mémoire. Ça devient ridicule. » — u/DragonflyOk9274 dans r/codex, dans le fil consacré au lancement de GPT-6 Cyber
Un autre développeur vérifié s’est heurté à l’exception concernant Astra :
« J’ai aussi découvert cela en essayant d’utiliser Astra pour le travail que je faisais avec 5.6 sol depuis une ou deux semaines : le modèle a simplement abandonné après quelques minutes en me disant d’obtenir Daybreak, alors que j’étais déjà vérifié Daybreak, lol. » — u/WtWreckor15 dans r/OpenAI, à propos de la vérification Daybreak
Les témoignages correspondent à la documentation : une approbation Blue seule ne réduit pas les garde-fous d’Astra. Astra et gpt-6.1-sol nécessitent des projets activés pour Red afin de réduire les refus, même si la requête continue d’envoyer daybreak_blue.
Les benchmarks à retenir — et celui où Astra s’impose
Tous les benchmarks de GPT-6 Cyber présentés ci-dessous ont été réalisés par le fournisseur avec le budget de raisonnement maximal testé, puis publiés dans la fiche système de GPT-6 Cyber. BenchLM ne classe donc pas le modèle : les neuf lignes proviennent exactement du fournisseur, sans couverture indépendante dans les emplacements suivis. Sur ExploitGym et SEC-Bench, ses leaders sont Gemini 4 Carbon, avec respectivement 53,5 % et 88,2 %.
| Évaluation | GPT-6 Cyber | GPT-6 Astra (Daybreak Blue) | GPT-5.6 Cyber | À retenir |
|---|---|---|---|---|
| ExploitGym (pass@1 sur vulnérabilités fournies) | 48,5 % | 42,4 % | 32,1 % | +16,4 points par rapport au prédécesseur, +6,1 par rapport à Astra |
| ExploitGym Hardened | 36,9 % | 29,7 % | — | Mitigations plus robustes |
| SRE-Bench (rétro-ingénierie binaire) | 92,8 % | 88,0 % | — | Ce n’est pas un test de fiabilité de site |
| SEC-Bench Pro (moteurs JavaScript) | 87,0 % | 85,4 % | — | Avantage limité |
| ExploitBench Internal Port (V8/Chrome récents) | 42,0 % | 39,0 % | — | Cibles récentes, risque de contamination moindre |
| ExploitBench v8-bench | 100 % | 100 % | — | Égalité |
| Rappel en pentest web black-box | 40,3 % | 32,0 % | — | Pas de précision ni de score F1 publiés |
| RemoteExploitBench (N-day) | 94,7 % | 0,0 % | — | Astra a refusé toutes les tâches sous Blue |
| Taux hors périmètre sur honeypot (plus bas = meilleur) | 0,07 % / 0 % avec le prompt de sécurité | 0,00 % | 5,51 % | Test du respect du périmètre, pas de la sécurité générale |
Deux lignes doivent être relativisées avant d’en tirer un budget. RemoteExploitBench mesure autant les permissions que les capacités : Cyber a réussi 95 % des tâches N-day de type GitLab/Postgres, tandis qu’Astra sous Blue les a toutes refusées. Le score de 0 % ne mesure donc pas les capacités d’exploitation latentes d’Astra. Le respect du périmètre sur honeypot est très bon, contre 94,49 % pour 5.6 Cyber, mais il ne s’agit que d’une évaluation, pas d’une garantie sur tous les réseaux clients.
Le jeu de tests externes le plus difficile donne un résultat différent, selon les données de la fiche système d’OpenAI résumées par HandyAI et Kingy. Sur Irregular FrontierCyber, qui regroupe 288 tâches réelles sur des logiciels et du matériel, Astra en a résolu 96 contre 90 pour Cyber. Aucun des deux n’a réussi les 15 tâches les plus difficiles ni une cible entièrement durcie. Sur Irregular CyScenarioBench, consacré aux attaques longues et en plusieurs étapes, Cyber mène 61 % à 54 % et a réussi les 11 scénarios au moins une fois, contre 8 sur 11 pour Astra.
Les résultats issus de campagnes réelles sont plus parlants qu’un score isolé. Selon les éléments de lancement d’OpenAI, résumés par Axios et Magica, un pipeline autonome de mi-octobre 2026 a analysé environ 2,8 millions de lignes de code du noyau Linux liées à la sécurité, soit environ 7 % du noyau. Il a produit 2 308 candidats, en a reproduit dynamiquement 1 724, puis les a dédupliqués à l’aide des correctifs pour arriver à 948 exploits distincts d’élévation locale de privilèges, pour 1 213 430 $ de crédits API. Avec GPT-5.6 Sol, le même banc d’essai a produit 166 exploits pour 513 690 $. OpenAI a également rapporté des preuves reproductibles concernant 81 vulnérabilités Firefox inconnues jusque-là et de gravité élevée, ainsi que 30 problèmes connus dont la gravité s’est révélée supérieure. Mozilla a publié des correctifs pour beaucoup d’entre eux, selon Axios et Magica.
Le chiffre de 948 correspond à la production de la campagne, pas au nombre de correctifs fusionnés, précise Magica. Selon la même analyse, après 10 jours de travail, 61 problèmes avaient déjà été corrigés en amont, 43 disposaient de correctifs en préparation, 299 faisaient l’objet de discussions publiques et OpenAI avait divulgué 304 failles critiques accompagnées de correctifs candidats. Les premiers essais ont aussi révélé des lacunes de validation, d’après Magica : dans 20 des 200 réussites, le modèle avait utilisé une autre faille inconnue que celle demandée. Il a donc fallu resserrer les contraintes et vérifier séparément que la faille visée était bien celle exploitée. Les premiers correctifs pouvaient également bloquer la démonstration sans couvrir les variantes ou en introduisant des coûts de performance.
Ce que permettent vraiment les tarifs à 20/100 $
Selon la vérification tarifaire de Kingy publiée le 5 novembre, GPT-6 Cyber coûte 20 $ par million de tokens en entrée, 100 $ par million en sortie et 2 $ par million de tokens d’entrée mis en cache pour les requêtes standard allant jusqu’à 272 000 tokens en entrée. L’écriture du cache coûte 25 $ par million pour 30 minutes ou 50 $ par million pour 12 heures. Astra coûte moitié moins cher dans le même exemple. L’entrée de Cyber coûte 60 % de plus que les 12,50 $ de GPT-5.6 Cyber, et sa sortie environ 33 % de plus que les 75 $ de ce dernier, selon Kingy.
| Poste de coût | GPT-6 Cyber | GPT-6 Astra | Quand cela compte |
|---|---|---|---|
| Entrée / sortie par million | 20 $ / 100 $ | 10 $ / 50 $ | Dans toute investigation en plusieurs tours |
| Entrée mise en cache par million | 2 $ | — (voir la page d’Astra) | Analyses répétées d’une même base de code |
| Exemple avec 100 000 tokens en entrée et 10 000 en sortie | 3,00 $ (2 $ + 1 $) | 1,50 $ | Base budgétaire avant les nouvelles tentatives |
| Même exemple avec entrée entièrement mise en cache | ~1,20 $ + création du cache | moins | Passages sur un noyau ou un monorepo volumineux |
| Moyenne de la campagne Linux | ~1 280 $ par LPE distincte (1,21 M$ / 948) | — | Moyenne de campagne, pas prix par faille |
Les 1 280 $ constituent une répartition comptable, pas un devis. Le chiffre correspond à un ensemble de cibles et à un pipeline précis. Il inclut le travail sur les fuites d’information, mais pas la sandbox, l’ingénierie, la revue humaine ni le temps des mainteneurs. Davantage de pistes signifie aussi davantage de triage. Une investigation réelle multiplie les tours, les appels d’outils, les nouvelles tentatives et les rapports volumineux.
Choisissez Cyber lorsque la validation d’exploits autorisée ou l’audit à grande échelle constitue le goulot d’étranglement et que les refus d’Astra bloquent le processus. Restez sur Astra ou gpt-6-sol pour la revue de code, le triage, la rédaction de correctifs et l’ingénierie courante. Selon l’analyse de la fiche système par HandyAI, ExpertSWE atteint 82,95 % pour Cyber contre 83,24 % pour Astra : aucun avantage notable en développement général pour un prix doublé.
Les limites qui subsistent malgré l’approbation
Des utilisateurs vérifiés Blue signalent des refus sur les corrections de bugs mémoire (r/codex), ainsi qu’un fil consacré à un avertissement Cyber Exploitation retardé dans lequel l’auteur explique ne pas avoir compris ce qui avait déclenché l’alerte.
Les chiffres de périmètre doivent eux aussi être interprétés dans leur contexte opérationnel. Avec 99,93 % d’exécutions dans le périmètre sans le prompt de déploiement, 7 exécutions sur 10 000 touchent un service hors périmètre dans ce test. Avec le prompt, OpenAI rapporte 100 % dans ce même test. Les équipes qui lancent des milliers d’exploits par campagne doivent considérer le prompt, l’isolation réseau, les cibles et identifiants placés sur liste blanche, ainsi que la revue humaine comme la véritable limite, et non le prompt seul.
Le correctif reste la moitié inachevée du processus. La découverte automatisée va désormais plus vite que la remédiation : trouver 948 exploits n’équivaut pas à déployer 948 correctifs. La revue des mainteneurs, la déduplication, la couverture des variantes et le déploiement restent soumis au rythme humain.
Pour éviter les tickets les plus courants, utilisez cette configuration :
- Utilisez un projet Red dédié, activé et sa clé associée
- Définissez la bonne valeur
cyberselon le modèle (daybreak_reduniquement pour les modèles Cyber) - Vérifiez la liste blanche d’adresses IP et le SSO/MFA avant les tests de charge
- Activez ZDR et Private Safety Processing lorsque cela est requis
- Sur un petit pilote isolé, journalisez le modèle résolu, le périmètre, les permissions, les tokens, les résultats, les faux positifs et les blocages, puis comparez le tout au processus existant associant scanner et revue humaine
Le compromis est celui de l’échelle face à la capacité de réparation : dans la campagne rapportée par OpenAI, la génération de pistes a dépassé les capacités de revue et d’intégration des correctifs en amont.
FAQ sur l’API GPT-6 Cyber
Comment demander l’accès Daybreak Red pour GPT-6 Cyber ?
Commencez par la présentation de Daybreak et le parcours via l’équipe commerciale d’OpenAI. Effectuez la vérification avec SSO/MFA, demandez à un propriétaire d’activer Red sur un projet dédié, obtenez l’approbation distincte pour gpt-6-cyber, configurez la liste blanche d’adresses IP et la gestion ZDR, puis envoyez vos requêtes avec daybreak_red.
Les chercheurs indépendants ou les particuliers peuvent-ils obtenir Daybreak Red ?
OpenAI parle d’entreprises éligibles et de professionnels de la cybersécurité, Red nécessitant une approbation distincte. Au départ, Cyber était réservé à certains clients Red, et l’ouverture plus large promise n’a pas de date. Il faut donc s’attendre à un examen du cas d’usage documenté. Des pentesters expliquent avoir obtenu Blue sans trouver de procédure claire pour passer à Red.
Daybreak Blue réduit-il les refus de GPT-6 Astra ?
Non, pas avec une approbation Blue classique. Astra conserve ses garde-fous standard. Pour réduire les refus d’Astra et de gpt-6.1-sol, il faut une approbation Red avec activation du projet, même si la requête continue d’envoyer daybreak_blue.
GPT-6 Cyber est-il disponible dans ChatGPT, ou seulement via l’API et Codex ?
Au moment de cette revue, il était disponible uniquement via l’API et Codex pour les clients Red approuvés, sans disponibilité annoncée dans ChatGPT. Les utilisateurs classiques de ChatGPT devront se tourner vers Astra ou les modèles principaux avec Blue lorsqu’ils y sont éligibles.
GPT-6 Cyber vaut-il le double du prix d’Astra ?
Pour l’exploitation autorisée, la validation de vulnérabilités à grande échelle et les agents dont le respect du périmètre est crucial, les premiers chiffres fournis par l’éditeur justifient un pilote : +6 points sur ExploitGym, +7 sur les cibles durcies, 94,7 % de réussite sur les tâches N-day avec les permissions Red et 99,93 % de respect du périmètre. Pour la revue de code, le triage et l’ingénierie générale, Astra à moitié prix reste le meilleur choix par défaut.
Que dois-je journaliser pour contester un avertissement ou un refus Cyber ?
Conservez l’identifiant du modèle résolu, la valeur du programme de la requête, l’identifiant du projet, l’horodatage, le périmètre et les identifiants de la cible, le prompt complet, la trace des outils et l’indication précisant si le prompt de sécurité du déploiement a été utilisé. Contactez ensuite le support. La documentation publique n’explique pas comment les avertissements retardés sont reliés à une requête précise : vos journaux locaux constituent donc la trace d’audit.