 AIREITER
Pour coder au quotidien, GPT-5.6 Terra est le choix le plus rapide et le plus économique : ses réponses arrivent en environ la moitié du temps réel, il génère nettement moins de tokens en sortie et prend l'avantage sur les tâches d'agents en terminal. Claude Sonnet 5 fait jeu égal pour la correction de bugs dans de vrais projets, le devance d'un cheveu en raisonnement composite et, surtout au moment de démarrer, il est déjà disponible partout, là où Terra reste en cours de déploiement via un accès preview. Ce comparatif GPT-5.6 Terra vs Claude Sonnet 5 passe en revue un test réel, les benchmarks publiés, les écarts de vitesse et de prix, puis indique le meilleur choix pour chaque type de tâche.
| Tâche | Meilleur choix |
|---|---|
| Développement interactif en boucle édition-exécution | Terra |
| Agents terminal / CLI | Terra |
| Correction de bugs dans de vrais dépôts | Quasiment à égalité |
| Agents d'utilisation d'ordinateur / bureau | Sonnet 5 |
| Raisonnement multi-étapes le plus complexe | Sonnet 5 |
| Coût effectif par tâche le plus bas | Terra |
Test de Terra en direct : un point de données, rien de plus
En juillet 2026, j'ai soumis à GPT-5.6 Terra, via un endpoint de chat avec une température de 0, une petite tâche truffée de pièges : implémenter my_atoi, la fonction de conversion chaîne-vers-entier du LeetCode #8. Elle doit gérer les espaces initiaux, un signe facultatif, l'arrêt au premier caractère non numérique et le bornage en cas de dépassement d'un entier signé 32 bits. J'ai ensuite exécuté son code sur 20 cas de test couvrant les cas limites : chaînes vides, "words and 987", "-91283472332" (sous INT_MIN), "+-12", ainsi que le bornage aux deux extrémités.
Terra a réussi 20 tests sur 20 en 5,5 secondes mesurées côté client, pour 193 tokens en sortie. Sa protection contre le dépassement est propre : elle vérifie value > (2**31 - ... - digit) // 10 avant la multiplication. Elle évite donc tout dépassement interne, au lieu de borner la valeur après coup :
while i < n and "0" <= s[i] <= "9":
    digit = ord(s[i]) - ord("0")
    if value > (2**31 - (1 if sign == 1 else 0) - digit) // 10:
        return 2**31 - 1 if sign == 1 else -2**31
    value = value * 10 + digit
    i += 1
Une réserve importante : il s'agit d'une seule petite tâche, pas d'un benchmark, et le test est à sens unique. Je n'ai pas accès à un véritable endpoint API Claude Sonnet 5 ; tous les chiffres concernant Sonnet 5 ci-dessous proviennent donc de sources publiques clairement attribuées, pas de mes propres essais. Voyez le résultat de Terra comme une donnée concrète sur son efficacité en tokens, pas comme un verdict à lui seul.
Les domaines où chaque modèle prend l'avantage
Les benchmarks ne désignent pas un vainqueur absolu : tout dépend plutôt du type de tâche.
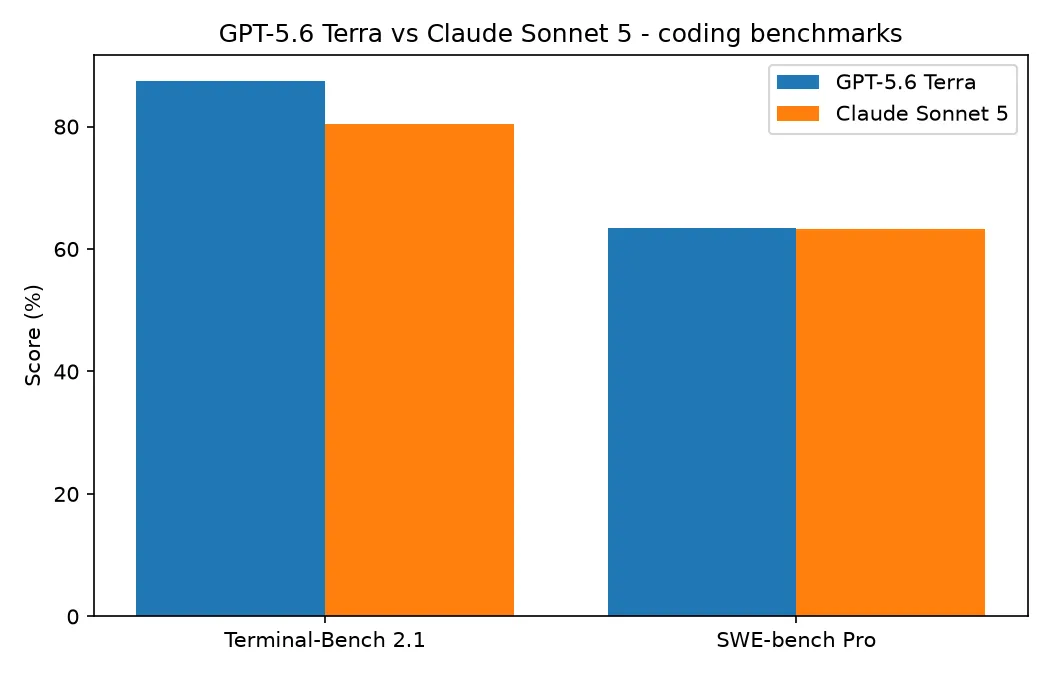
Sur Terminal-Bench 2.1, qui évalue le code produit par des agents pilotés depuis un terminal, Terra atteint 87,4 % contre 80,4 % pour Sonnet 5. L'écart est réel si votre travail repose sur des agents CLI et de l'automatisation intensive dans le shell. Sur SWE-bench Pro, qui consiste à corriger de vrais bugs dans de vrais dépôts, les deux modèles sont pratiquement à égalité, avec 63,4 % et 63,2 %. Aucun ne se distingue vraiment sur ces corrections désordonnées et réparties sur plusieurs fichiers qui constituent le quotidien.
À une échelle plus large, Sonnet 5 prend une très légère avance en raisonnement composite : Artificial Analysis lui attribue un Intelligence Index de 53, contre 52 pour Terra, avec Terra en effort xhigh et Sonnet 5 en effort maximal, en juillet 2026. Sonnet 5 affiche aussi 81,2 % sur OSWorld-Verified, le benchmark des agents capables d'utiliser un ordinateur, un domaine pour lequel les résultats publics de Terra sont plus limités. En pratique : Terra pour les agents en terminal, pile ou face pour les bugs de dépôt, et Sonnet 5 pour le raisonnement le plus exigeant comme pour les agents desktop.
Vitesse et latence : l'écart qui se ressent au quotidien
Les benchmarks masquent souvent le premier élément perceptible à l'usage : le temps passé devant un indicateur de chargement. Artificial Analysis mesure Terra à 118 tokens de sortie par seconde, contre 71 pour Sonnet 5. Le délai avant le premier token est de 16,3 secondes pour Terra, contre 198,7 secondes pour Sonnet 5. Ce second chiffre correspond toutefois au pire cas, pas au comportement par défaut : il s'agit de Sonnet 5 avec un effort de raisonnement maximal, qui effectue un long travail de réflexion avant d'émettre quoi que ce soit. En abaissant l'effort, le TTFT diminue fortement, mais l'ordre reste le même : Terra commence et termine plus vite.
Un test de développement pratique réalisé par Merge aboutit à la même conclusion. Pour créer une page d'accueil marketing, Terra a terminé en 60,2 secondes contre 136,6 secondes pour Sonnet 5, en générant 10 677 tokens de sortie face à 17 870. Mon test atoi va dans le même sens : Terra a produit une implémentation correcte, avec un bornage complet, en 193 tokens. Les données publiques et les essais pratiques, encore limités, convergent : Terra est plus concis et plus rapide à produire ses premiers résultats, tandis que Sonnet 5 consomme davantage de temps et de tokens, dont une partie pour un raisonnement dont vous n'avez pas toujours besoin.
Dans une boucle serrée édition-exécution-édition, cet écart de latence s'accumule très vite. Si vous lancez une seule tâche agentique difficile avant de passer à autre chose, son importance diminue nettement.
Les tarifs en pratique
Les prix API standard sont suffisamment proches pour rarement décider à eux seuls.
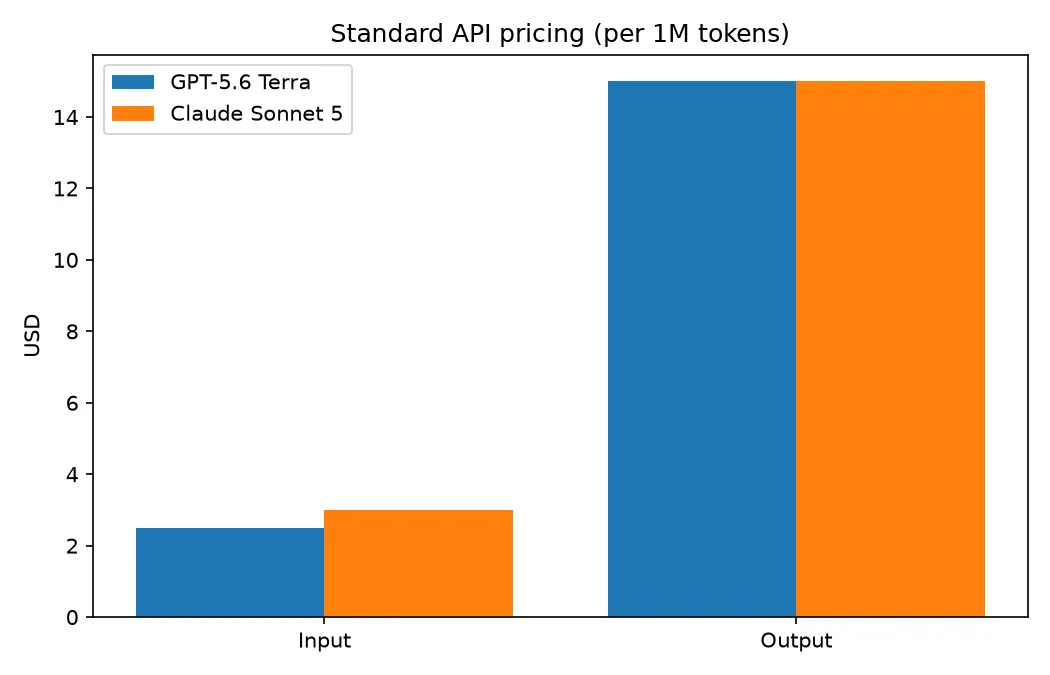
Terra est affiché à 2,50 $ par million de tokens en entrée et 15 $ en sortie. Le tarif standard de Sonnet 5 est de 3 $ en entrée / 15 $ en sortie, mais Anthropic propose une offre de lancement à 2 $ / 10 $ jusqu'au 31 août 2026. Sonnet 5 affiche donc un prix plus bas jusqu'à cette date. Les deux modèles proposent une fenêtre de contexte de 1M tokens et une sortie maximale de 128K. Terra coûte aussi environ deux fois moins cher que le précédent palier GPT-5.5 à qualité quotidienne comparable : son intérêt économique ne se limite donc pas à la comparaison avec Sonnet 5.
Trois indicateurs de coût circulent pour ces modèles, mais ils ne mesurent pas la même chose :
- Prix catalogue par token : Terra coûte moins cher en entrée et autant en sortie ; le tarif de lancement de Sonnet 5 le place temporairement sous les deux.
- Prix d'index pondéré : Artificial Analysis affiche 2,17 $ pour Terra et 1,54 $ pour Sonnet 5. Il s'agit cependant d'un mélange entrée-sortie de 3:1 aux niveaux d'effort testés, pas du coût réel d'une tâche.
- Coût effectif par tâche terminée : Terra génère moins de tokens pour obtenir le même résultat et l'emporte donc généralement sur ce terrain. Le build de Merge a coûté 0,120 $ avec Terra contre 0,179 $ avec Sonnet 5, soit environ un tiers de moins malgré le tarif réduit de Sonnet 5 en sortie.
Pour la plupart des charges de travail, c'est le coût effectif par tâche qui se retrouvera sur votre facture, et il favorise Terra. Les deux modèles sont accessibles via des API compatibles Anthropic et OpenAI, y compris via des passerelles tierces qui revendent l'accès à tarif réduit si le prix catalogue constitue une contrainte.
Ce que choisissent les développeurs
Les benchmarks et les usages de la communauté ne vont pas toujours dans le même sens ; les retours de terrain méritent donc d'être pris en compte. Sur X, en juillet 2026, la tendance penchait vers les gammes GPT-5.6 pour des raisons de coût. Un développeur a raconté avoir remplacé toute sa chaîne d'intégration d'agents — Opus 4.8 par Terra et Sonnet 5 par Luna — et qualifié les nouveaux modèles de « blazing fast, very capable and cheaper ». Un autre a indiqué avoir « mostly stopped using Claude », gardant Cursor avec Grok et Codex avec Terra/Sol comme stack principale pour le code agentique.
Terra apparaît aussi comme le modèle qui débloque certains cas où Claude échoue : un créateur a rapporté que Terra avait corrigé un bug « that Claude Sonnet 5 couldn't crack » et généré l'interface complète d'un site à partir d'un seul prompt. Une lecture plus nuancée vient d'un développeur qui a noté que Terra n'est « not as aggressive as Sol to hunt bugs, but it gets the job done ». Cela correspond bien à son positionnement : un outil de travail régulier, abordable et fiable plutôt qu'un chasseur de bugs maximaliste.
Rien de tout cela n'efface les atouts de Sonnet 5. Il est actuellement disponible à tous les niveaux d'abonnement, s'intègre à l'écosystème d'outils mature de Claude et à son workflow d'adaptive thinking. Sa gestion des contextes longs tient également la route sur les tâches agentiques étendues. Pour les équipes déjà standardisées sur Claude, cette continuité vaut souvent plus que quelques centimes économisés par tâche.
Lequel choisir ?
Le choix dépend de la forme de votre charge de travail, pas d'un hypothétique meilleur modèle universel. Pour les tâches de code que je réalise le plus souvent — itérations rapides, agents en terminal et suivi du coût par tâche — Terra est mon choix par défaut, tandis que je garde Sonnet 5 pour les travaux plus lourds en raisonnement.
- Choisissez GPT-5.6 Terra si vous faites du développement interactif fréquent, si la latence compte dans une boucle édition-exécution, si vous utilisez des agents terminal ou CLI, ou si vous recherchez le coût effectif par tâche le plus faible. Sa rapidité et sa sobriété en tokens sont ses principaux arguments.
- Choisissez Claude Sonnet 5 si votre travail exige le raisonnement multi-étapes le plus difficile, de longues exécutions agentiques avec beaucoup de contexte ou des tâches d'utilisation d'ordinateur ; c'est aussi un choix naturel si vous êtes déjà dans l'écosystème Claude et souhaitez un modèle disponible sur toutes les offres dès aujourd'hui. Son tarif de lancement à 2 $ / 10 $ jusqu'au 31 août facilite aussi l'essai.
Pour la plupart des développeurs qui livrent des fonctionnalités au jour le jour, le profil vitesse-coût de Terra l'emporte. Pour les tâches de raisonnement réellement complexes, ou si changer de stack ne justifie pas les efforts de transition, Sonnet 5 reste le choix le plus sûr. Les deux sont assez proches pour que votre workflow, et non un classement, fasse la différence.
FAQ
GPT-5.6 Terra est-il meilleur que Claude Sonnet 5 ?
Pour la vitesse et le code à coût optimisé, oui : Terra est plus rapide, moins cher par tâche et en tête sur les benchmarks d'agents en terminal. Pour le raisonnement le plus difficile et les tâches d'utilisation d'ordinateur, Sonnet 5 fait au moins jeu égal et prend souvent l'avantage. Il n'y a pas de vainqueur unique : tout dépend de la tâche.
Claude Sonnet 5 est-il bon pour coder ?
Oui. Il égale Terra sur SWE-bench Pro, avec 63,2 % contre 63,4 %, pour la correction de bugs dans de vrais dépôts, et mène sur les tâches agentiques OSWorld-Verified. Face à Terra, ses points faibles concernent la vitesse et le délai avant le premier token, pas la qualité du code.
À quel point Terra est-il moins cher que Sonnet 5 ?
Au tarif catalogue, Terra coûte 2,50 $ / 15 $, contre 3 $ / 15 $ pour Sonnet 5 en tarif standard. L'offre de lancement de Sonnet 5 à 2 $ / 10 $, valable jusqu'au 31 août 2026, le place toutefois temporairement sous Terra. En coût effectif par tâche, Terra reste généralement devant parce qu'il génère moins de tokens en sortie.
Terra et Sonnet 5 ont-ils la même fenêtre de contexte ?
En pratique, oui : tous deux proposent une fenêtre de contexte de 1M tokens et une sortie maximale de 128K. La taille du contexte ne sera donc pas le facteur décisif.
GPT-5.6 Terra est-il déjà disponible partout ?
Pas totalement. Sonnet 5 est aujourd'hui accessible sur tous les niveaux d'abonnement, tandis que l'accès à GPT-5.6 reste, par endroits, limité à la preview et à certains partenaires API. C'est un point concret si vous devez le déployer en production dès maintenant.