 AIREITER
Sur r/codex, la question revient sans cesse : « J'utilisais GPT-5.5 en extra-high ; Sol ou Terra, c'est quoi l'équivalent ? » Réponse courte : GPT-5.6 Sol est affiché exactement au même tarif API que GPT-5.5 et le surpasse sur les benchmarks d'agents. Pour les agents qui tournent longtemps et les tâches de navigation, passer à Sol peut donc sembler quasiment gratuit.
Le « même prix » masque toutefois deux coûts bien réels. Sol facture les écritures de cache, contrairement à GPT-5.5, et réfléchit plus longtemps : la dépense par tâche peut ainsi être multipliée alors que la grille tarifaire n'a pas changé.
Même grille tarifaire, pas la même facture
GPT-5.6 Sol et GPT-5.5 partagent les mêmes tarifs API standards : 5,00 $ par million de tokens en entrée, 30,00 $ par million en sortie et 0,50 $ pour les entrées mises en cache. J'ai relevé les deux lignes sur la page tarifaire d'OpenAI le 29 juillet 2026 :
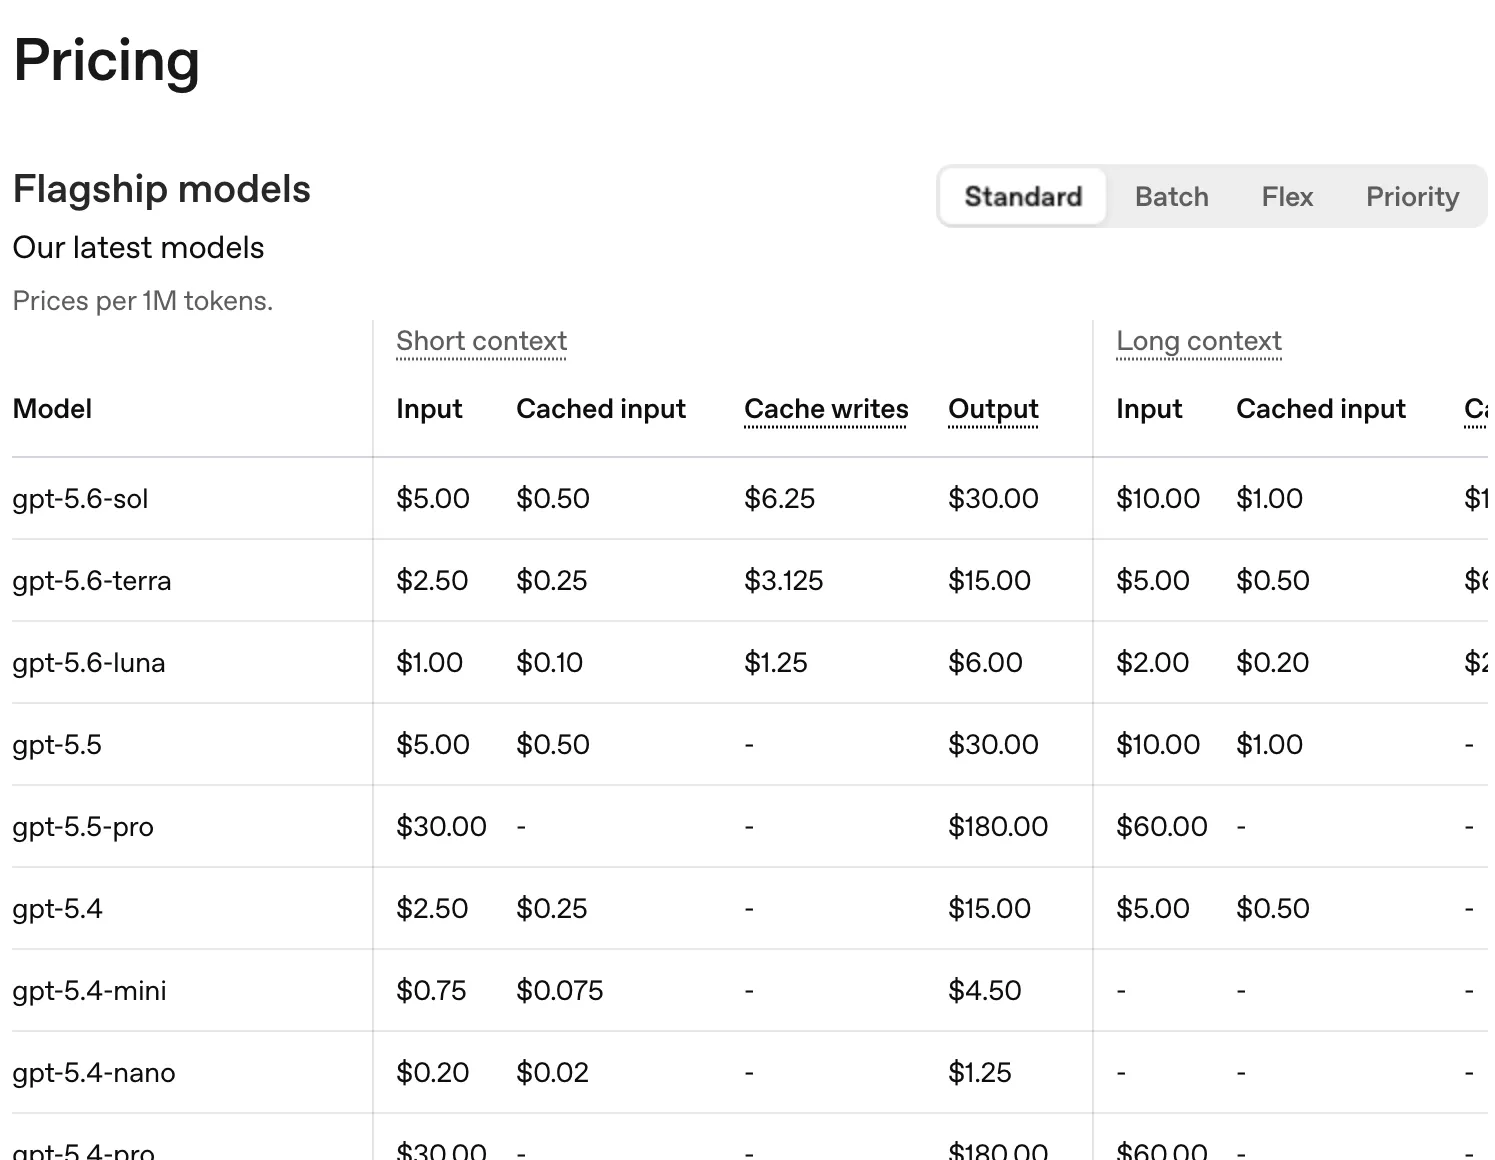
Trois postes différencient néanmoins les deux modèles :
| Poste | GPT-5.6 Sol | GPT-5.5 |
|---|---|---|
| Entrée / sortie (par 1 M de tokens) | 5,00 $ / 30,00 $ | 5,00 $ / 30,00 $ |
| Entrée mise en cache | 0,50 $ | 0,50 $ |
| Écritures de cache | 6,25 $ | non facturées |
| Contexte long (>272 K) entrée / sortie | 10,00 $ / 45,00 $ | 10,00 $ / 45,00 $ |
La ligne des écritures de cache est celle qui peut faire mal lors d'une migration. GPT-5.6 introduit des points de rupture explicites du cache, avec une durée de vie minimale de 30 minutes (l'analyse de Vellum explique le mécanisme). L'écriture coûte 1,25 fois le tarif d'une entrée non mise en cache, tandis que les lectures restent remisées de 90 %. Le calcul à partir du tableau ci-dessus est simple : un segment mis en cache coûte 6,25 $ à écrire, puis 0,50 $ par lecture, contre 5,00 $ à chaque nouvel envoi sans cache. Le cache devient donc rentable à partir de la seconde réutilisation ; à l'inverse, un pipeline qui écrit davantage qu'il ne relit paie une taxe que GPT-5.5 ne facturait pas.
Le second coût dépend du temps de réflexion. Sol raisonne plus longtemps avant de répondre, et les tokens de raisonnement sont facturés comme des tokens de sortie. Les utilisateurs de Codex ayant migré le constatent directement :
« 5.6 sol medium coûte trois fois plus cher que 5.5-xhigh, tout en offrant la même qualité de code (du moins au lancement de 5.5). » — r/codex, « GPT 5.5 and 5.6 conversion table »
Même grille tarifaire, mais un coût par tâche trois fois supérieur parce que le modèle dépense trois fois plus de tokens pour y parvenir. L'annonce de GPT-5.6 par OpenAI avance le constat inverse : 22 % de tokens d'entrée et 23 % de tokens de sortie en moins que GPT-5.5 dans ses comparaisons internes. Ces deux affirmations peuvent être vraies simultanément : l'efficacité s'améliore à quantité de réflexion égale, mais les réglages d'effort élevés font réfléchir bien davantage. Tout dépend donc du niveau d'effort choisi.
Ce que les chiffres montrent vraiment
Sur les évaluations indépendantes, GPT-5.6 Sol et GPT-5.5 sont quasiment au coude-à-coude en intelligence brute : Artificial Analysis attribue 54 à Sol (medium) et 53 à GPT-5.5 (high) sur son Intelligence Index v4.1, pour un coût mixte identique de 4,35 $ par million de tokens. Les progrès les plus notables sont ailleurs :
- Latence avant le premier token : 4,13 secondes pour Sol, contre 16,67 secondes pour GPT-5.5 (high), soit un écart d'un facteur 4. Pour les outils interactifs et les boucles d'agents enchaînant des dizaines d'appels séquentiels, c'est l'amélioration la plus perceptible au quotidien.
- Benchmarks d'agents : Sol atteint 88,8 % sur Terminal-Bench 2.1 et 92,2 % sur BrowseComp. Les gains les plus marqués de cette version concernent l'utilisation d'outils sur un horizon long.
- Contexte : 1 M de tokens pour Sol contre 922 K pour GPT-5.5, avec en plus un raisonnement qui persiste d'un tour de conversation à l'autre, comme le documente la même analyse Vellum citée plus haut.
- Vitesse de sortie : c'est le point de régression. Sol génère 65 tokens par seconde, contre 77,3 pour GPT-5.5. Les tâches de génération en volume deviennent donc plus lentes, pas plus rapides.
Dans sa suite de tests de code sur le long terme, CodeRabbit a évalué plus de 100 tâches dans cinq langages : Sol affiche 63,7 % de réussite. Son benchmark de revue de code lui attribue aussi un gain de 7,4 points de pourcentage par rapport à une intégration de référence, avec une réserve : la précision des revues de Sol n'est que de 31,6 %. Il détecte donc davantage de vrais problèmes, mais les noie dans plus de bruit. Les mêmes testeurs l'ont vu consacrer 8 tours à une modification simple après s'être engagé dans une mauvaise piste. Plus solide sur les marathons ne veut pas dire à l'abri des impasses.
J'ai soumis les mêmes trois prompts aux deux modèles
Les benchmarks favorisent les tâches de longue haleine, alors que la plupart des appels API sont courts. J'ai donc envoyé les mêmes trois prompts à gpt-5.6-sol et gpt-5.5 le 29 juillet 2026 : un correctif pour un bug Python de gestion des dates, une énigme de logique sous contraintes avec exactement deux réponses valides, puis une extraction JSON stricte avec un piège — une date sans année, que les règles imposaient de convertir en null plutôt que de deviner. Un appel API par tâche, effort de raisonnement par défaut, sans outils ni nouvelles tentatives. C'est un petit échantillon, pas un benchmark.
Les deux modèles ont réussi les trois tâches. GPT-5.5 a corrigé le bug qui faisait planter décembre avec calendar.monthrange ; Sol a construit lui-même une table correcte pour les années bissextiles. Tous deux ont trouvé exactement les deux ordres de déploiement valides, renvoyé un JSON strictement identique octet pour octet lors de l'extraction et refusé d'inventer une année pour « le 14 juillet ».
La consommation de tokens et la vitesse racontent une histoire plus contrastée :
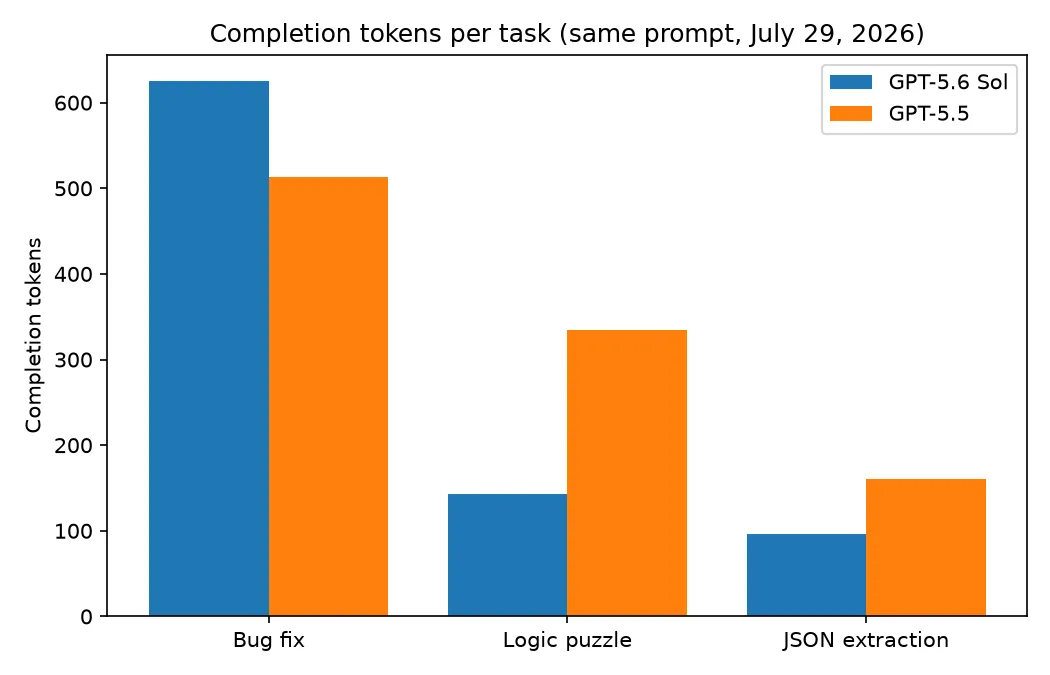
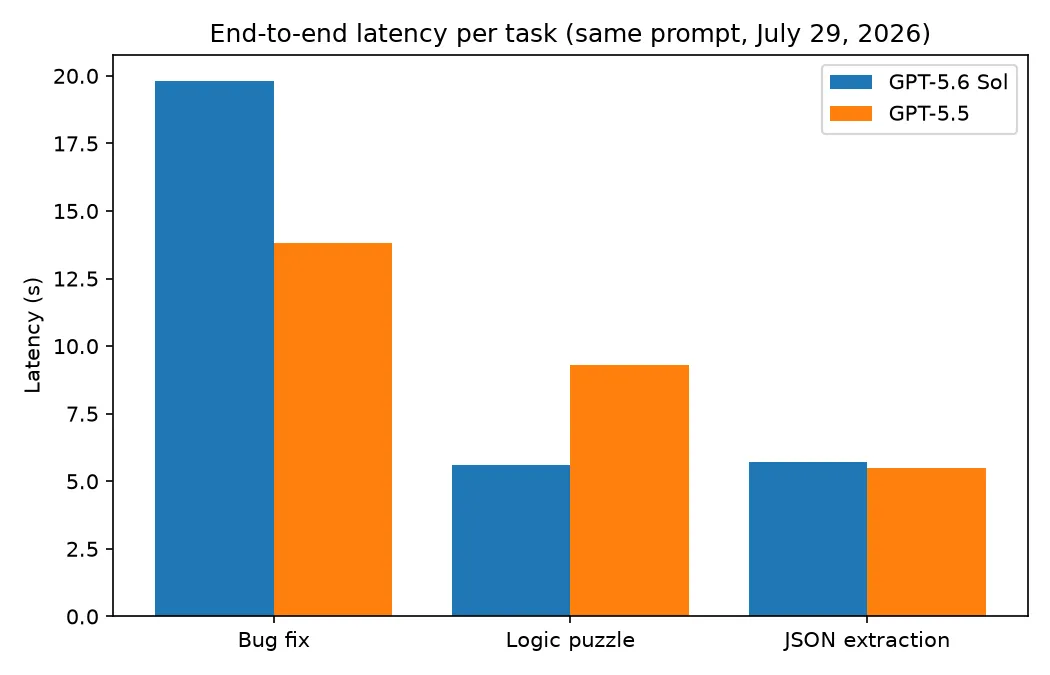
Au total, Sol a consommé moins de tokens de complétion, 864 contre 1 007, mais il s'est montré plus lent et plus bavard sur la tâche de code : 19,8 secondes et 625 tokens, contre 13,8 secondes et 513. Sur l'énigme logique, la situation s'est inversée : Sol a répondu en 5,6 secondes avec 143 tokens, là où GPT-5.5 a pris 9,3 secondes et 334 tokens. Après avoir observé les deux modèles, mon constat est le suivant : sur des tâches courtes et bien spécifiées, ils sont interchangeables. Rien dans ce test, à lui seul, ne justifierait une migration. L'argument en faveur de la mise à niveau repose entièrement sur le travail d'agent et les contextes longs mis en évidence dans les benchmarks ci-dessus.
Quel niveau GPT-5.6 choisir selon votre effort GPT-5.5 ?
D'après l'analyse Vellum citée plus haut, l'identifiant de modèle sans suffixe gpt-5.6 redirige par défaut vers gpt-5.6-sol. En remplaçant simplement l'alias, on bascule donc sur le modèle phare — et sur sa facture — sans l'avoir choisi explicitement. Pour migrer de façon réfléchie, trois éléments permettent de se repérer :
- GPT-5.5 xhigh → Sol medium est l'équivalence pratique retenue par la communauté. Le témoignage r/codex cité plus haut évoque une parité de qualité avec 5.5 et un coût par tâche environ trois fois supérieur autour du lancement. Prenez-la comme une hypothèse de départ à vérifier avec vos prompts, pas comme une garantie. Les charges sensibles au budget qui tournaient avec 5.5 high se rapprochent davantage de GPT-5.6 Terra, à 2,50 $/15 $, soit la moitié de la grille de Sol.
- Au maximum, le temps de réflexion explose. Des utilisateurs de ChatGPT Pro rapportent que GPT-5.6 passe 20 à 50 minutes sur des tâches pour lesquelles 5.5 Pro prenait 5 à 10 minutes. C'est une observation dans ChatGPT, mais la même pile de raisonnement est facturée en tokens de sortie via l'API. Le réglage
reasoning.mode: "pro"est disponible sur les trois niveaux de GPT-5.6 : ce plafond est donc optionnel. - Vos anciens prompts peuvent pénaliser le nouveau modèle. L'équipe de test de Every.to a constaté une nette amélioration des réponses de Sol seulement après avoir supprimé des instructions défensives écrites pour des modèles plus anciens — des règles comme « vérifie toujours X » qui poussaient Sol à trop vérifier et à surconstruire. Migrez le modèle, puis réévaluez le prompt système : l'échafaudage paranoïaque dont GPT-5.5 avait besoin devient désormais une taxe.
Qui devrait migrer, qui devrait attendre
Passez à GPT-5.6 Sol si votre charge de travail est agentique : utilisation d'outils en plusieurs étapes, recherche par navigation ou sessions de code à l'échelle d'un dépôt. C'est là que se situent les scores de 88,8 % sur Terminal-Bench et de 92,2 % sur BrowseComp, et que la réduction par quatre de la latence avant le premier token se cumule à chaque itération de boucle. Avec la même grille à 5 $/30 $, le gain de capacités ne coûte rien de plus — à condition que les tokens de raisonnement supplémentaires et les écritures de cache n'absorbent pas l'écart. Le contexte de 1 M de tokens et la persistance du raisonnement entre les tours éliminent deux contournements que les pipelines 5.5 devaient mettre en place.
Restez sur GPT-5.5 — pour l'instant — si votre trafic consiste surtout en appels courts et bien cadrés : extraction, classification, correctifs de code en une passe, génération à fort volume. Mon test à trois prompts place les modèles à égalité sur ce type précis de tâches, et le streaming plus lent de Sol, 65 contre 77,3 tokens par seconde, rend les traitements massifs objectivement moins bons. Les pipelines qui écrivent beaucoup dans le cache doivent chiffrer la ligne à 6,25 $ avant de migrer. Et si vous cherchez une facture plus basse à qualité comparable, la réponse est Terra, pas Sol.
J'ai réalisé mon face-à-face via AIReiter, qui donne accès à gpt-5.6-sol et à gpt-5.5 derrière une seule clé API. Remplacer la chaîne du modèle suffit donc pour lancer un A/B test : comparez le taux de réussite, la latence de bout en bout et les tokens de complétion par tâche sur votre propre trafic.
FAQ
GPT-5.6 Sol est-il meilleur que GPT-5.5 ?
Sur les tâches d'agent, clairement : 88,8 % sur Terminal-Bench 2.1, 92,2 % sur BrowseComp et une latence avant le premier token quatre fois plus basse. Pour les tâches courtes réalisées en un appel, les scores indépendants ne les séparent que d'un point, 54 contre 53 sur Artificial Analysis, et mes tests avec les mêmes prompts n'ont révélé aucun écart de justesse.
GPT-5.6 Sol coûte-t-il plus cher que GPT-5.5 ?
La grille tarifaire est identique : 5 $ en entrée et 30 $ en sortie par million de tokens. Sol ajoute cependant 6,25 $ de frais d'écriture de cache, un poste que GPT-5.5 ne facturait jamais. Avec les réglages d'effort élevés, il dépense aussi davantage de tokens de raisonnement par tâche : des utilisateurs de r/codex ont mesuré un coût par tâche environ trois fois supérieur à qualité égale avec 5.5 xhigh.
Quel est l'équivalent de GPT-5.5 xhigh dans GPT-5.6 ?
Sol avec l'effort medium offre une qualité de code comparable, pour environ trois fois le coût par tâche. Si la parité de coût compte davantage que le plafond de capacités, Terra est le choix économique le plus proche.
Puis-je encore utiliser GPT-5.5 après la mise à niveau ?
Oui. GPT-5.5 figure toujours sur la page tarifaire d'OpenAI aux mêmes tarifs, vérifiés le 29 juillet 2026 — voir la capture ci-dessus. Rien n'impose donc encore de migrer.
La décision en un tableau
| Votre charge de travail | Choix | Élément décisif |
|---|---|---|
| Agents multi-étapes, navigation, code à l'échelle d'un dépôt | GPT-5.6 Sol | 88,8 % sur Terminal-Bench, latence avant premier token divisée par 4, même grille tarifaire |
| Extraction / classification / correctifs en une passe | GPT-5.5 (pour l'instant) | Égalité dans les tests avec les mêmes prompts ; streaming de 5.5 19 % plus rapide |
| Nombreuses écritures dans le cache de prompts | GPT-5.5, ou revoir l'architecture d'abord | Les 6,25 $/1 M de frais d'écriture de cache de Sol sont nouveaux |
| Même qualité, facture plus basse | GPT-5.6 Terra | 2,50 $/15 $, soit la moitié du prix de Sol ; voir la comparaison Terra vs 5.5 ci-dessus |
| Profondeur de raisonnement maximale | Sol avec reasoning.mode: "pro" | 20 à 50 min de délibération là où 5.5 en prenait 5 à 10 |