 AIREITER
À tarif unitaire identique, GPT-5.6 Sol peut faire exploser la facture : sur 1 715 sessions Codex, il a consommé 16,45 millions de tokens par session, contre 7,30 millions en moyenne pour GPT-5.5 sur une période comparable de 1 667 sessions. Cela représente 2,25x plus de tokens. Et le problème pourrait être aggravé par un défaut documenté dans la Responses API, qui semble multiplier par 6 ou davantage les output_tokens facturés pour Sol. Si votre facture GPT-5.6 paraît anormale, elle l’est peut-être effectivement.
La consommation réelle de GPT-5.6 Sol
Le développeur Vincent Schmalbach a suivi la consommation de tokens pendant deux périodes de 14 jours d’utilisation de Codex. Il a comparé GPT-5.5 xhigh et GPT-5.6 Sol xhigh, avec des volumes de sessions presque identiques :
| Indicateur | GPT-5.5 xhigh | GPT-5.6 Sol xhigh |
|---|---|---|
| Sessions | 1 667 | 1 715 |
| Total de tokens | 12,17 Md | 28,22 Md |
| Tokens par session | 7,30 M | 16,45 M |
Le nombre de sessions n’a augmenté que de 2,9 %, mais les tokens par session ont bondi de 125 %. La consommation totale est ainsi passée de 12,17 à 28,22 milliards de tokens : une hausse de 2,32x pour une charge de travail globalement similaire.
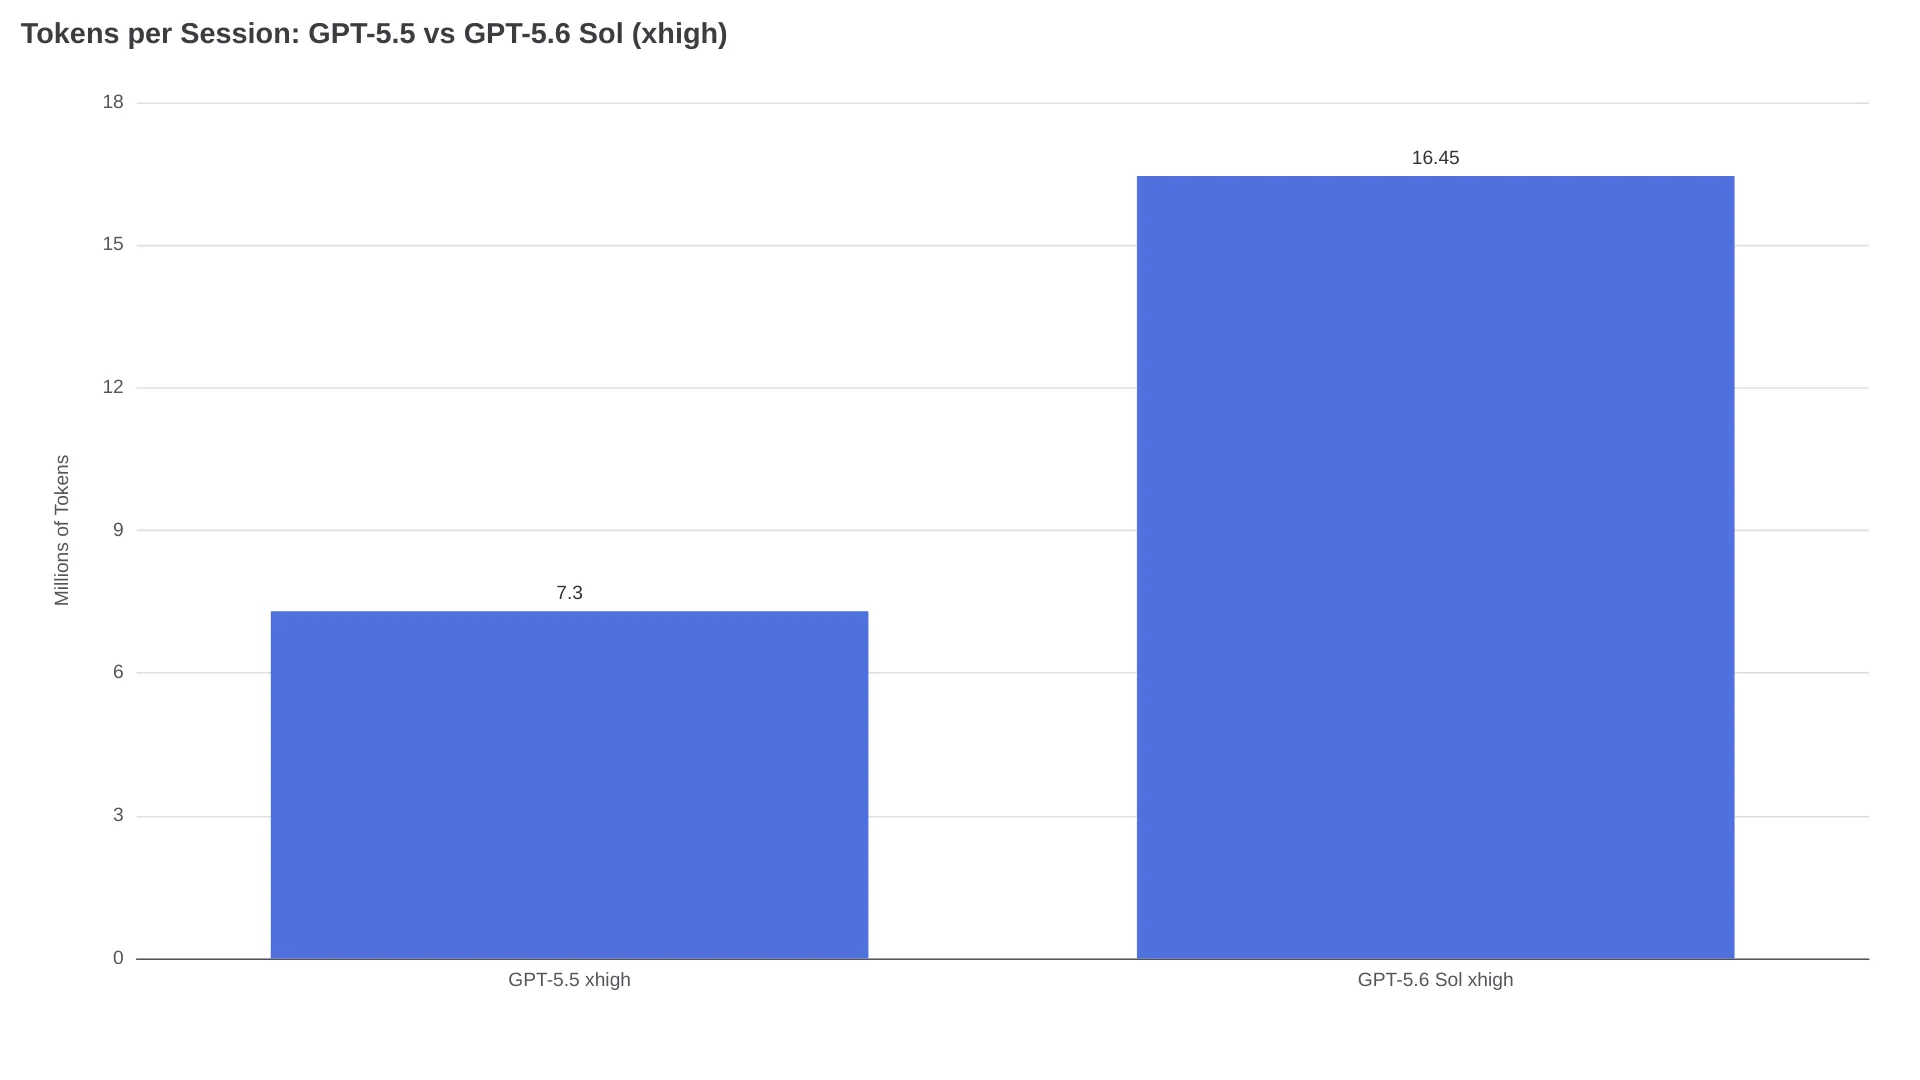
La grille tarifaire d’OpenAI affiche le même prix pour GPT-5.6 Sol et GPT-5.5 : 5 $ par million de tokens en entrée et 30 $ en sortie. À prix égal, 2,25x plus de tokens reviennent donc à environ 2,25x le coût par tâche. GPT-5.6 Sol ajoute aussi une surtaxe d’écriture en cache, à 1,25x le tarif d’entrée, qui n’existait pas avec GPT-5.5.
« GPT 5.6 Sol est une fournaise à tokens. Même Sol en medium ou high semble les engloutir. Je n’utiliserai 5.6 que pour de la planification complexe ou des bugs difficiles. » — utilisateur de r/codex
Les trois abonnements de Schmalbach, qui lui tenaient auparavant une semaine de travail intensif, s’épuisent désormais en environ une journée d’utilisation modérée.
Pourquoi Sol génère autant de tokens
À score de benchmark équivalent, Sol se révèle plus efficace que ses concurrents. Dans l’Artificial Analysis Coding Agent Index, il produit moins de tokens de sortie que Claude Fable 5 pour des résultats comparables. Mais dans les sessions réelles, Sol raisonne de manière plus poussée : il planifie, revient en arrière, vérifie et explore des alternatives. Chaque token accomplit davantage de travail utile, mais le coût en tokens par tâche grimpe.
Un défaut de facturation signalé gonflerait les tokens de sortie
À cette consommation intrinsèquement plus élevée s’ajoute un défaut de comptabilisation documenté dans la Responses API. Il semble gonfler le champ output_tokens, sur lequel repose la facturation. OpenAI enquête, sans avoir confirmé publiquement l’origine du problème.
Un développeur a documenté le phénomène sur 710 appels GPT-5.6 et 22 922 appels de raisonnement au total. GPT-5.6 est la première famille de modèles à émettre plusieurs éléments reasoning par réponse : la médiane est de k=9 pour Sol et de k=4 pour Terra. Pendant la génération, un accumulateur de l’API ajouterait le total courant du raisonnement une fois par élément reasoning, en plus du décompte final correct.
La formule est la suivante :
output_tokens ≈ R × (k + 3) / 2R désigne le nombre réel de tokens de raisonnement et k le nombre d’éléments de raisonnement. Avec une médiane k=9 pour Sol, le compteur facturé serait gonflé d’environ 6x. Pour Terra, avec k=4, le facteur est d’environ 3,6x.
À quoi cela ressemble sur une facture réelle
Le pire cas documenté concerne un unique appel GPT-5.6 Terra ayant renvoyé une réponse de quatre caractères, d1d4, mais facturé 466 818 tokens de sortie pour seulement 21 064 tokens de raisonnement réels.
| Valeur remontée par l’API | Valeur |
|---|---|
output_tokens (facturés) | 466 818 |
reasoning_tokens (réels) | 21 064 |
| Sortie visible | d1d4 (4 caractères) |
| Éléments de raisonnement (k) | 41 |
Avec k=41, la formule donne R × (41+3)/2 = 21 064 × 22 = 463 408, soit un écart de seulement 0,7 % avec le montant facturé. L’auteur du signalement l’a vérifié dans son tableau de bord de facturation : en additionnant les output_tokens fournis par l’API et en appliquant les tarifs publiés, il retrouvait les frais affichés au dixième de cent près. Sur l’ensemble de ses appels GPT-5.6, environ 284 $ sur environ 320 $ facturés correspondaient à une surfacturation.
Un bug antérieur à GPT-5.6
Pour k=1 — un seul élément de raisonnement, comme pour les modèles antérieurs à 5.6 — la formule devient R × 4/2 = 2R : une surfacturation fixe de 2x. L’auteur du signalement l’a confirmé à partir de l’export d’utilisation d’OpenAI pour mai 2026 :
| Modèle | Tokens de sortie facturés | Décompte réel | Ratio |
|---|---|---|---|
| o3-mini | 25 408 973 | 12 376 132 | 2,02x |
| gpt-5.4-nano | 11 718 610 | 5 844 140 | 2,00x |
| o1 | 778 989 | 335 944 | 2,01x |
| o4-mini (contrôle) | 12 054 680 | 9 160 567 | 1,01x |
GPT-5.6 n’aurait donc pas créé ce défaut. C’est en revanche le premier modèle à découper son raisonnement en un grand nombre d’éléments, ce qui transforme un discret facteur 2x en multiplicateur bien plus important. Le raisonnement est émis par blocs d’environ 512 tokens, donc k ≈ ceil(R/512). En remplaçant dans la formule, on obtient output_tokens ≈ R²/1024 + 3R/2 : la surfacturation croît de façon quadratique avec la longueur du raisonnement. Doubler le temps de réflexion revient donc, approximativement, à quadrupler la facture.
À l’heure où nous écrivons ces lignes, en août 2026, des collaborateurs d’OpenAI ont répondu au signalement en demandant des données complémentaires. Aucun correctif ni ajustement de facturation n’a toutefois été confirmé publiquement.
Tarifs de GPT-5.6 après la baisse du 30 juillet
Le 30 juillet 2026, OpenAI a baissé le prix de Luna de 80 % et celui de Terra de 20 %. Le tarif de Sol est resté inchangé. Voici les prix actuels selon la page tarifaire d’OpenAI :
| Modèle | Entrée (courte) | Entrée en cache | Écritures en cache | Sortie (courte) | Sortie (longue) |
|---|---|---|---|---|---|
| GPT-5.6 Sol | 5,00 $ | 0,50 $ | 6,25 $ | 30,00 $ | 45,00 $ |
| GPT-5.6 Terra | 2,00 $ | 0,20 $ | 2,50 $ | 12,00 $ | 18,00 $ |
| GPT-5.6 Luna | 0,20 $ | 0,02 $ | 0,25 $ | 1,20 $ | 1,80 $ |
| GPT-5.5 | 5,00 $ | 0,50 $ | — | 30,00 $ | 45,00 $ |
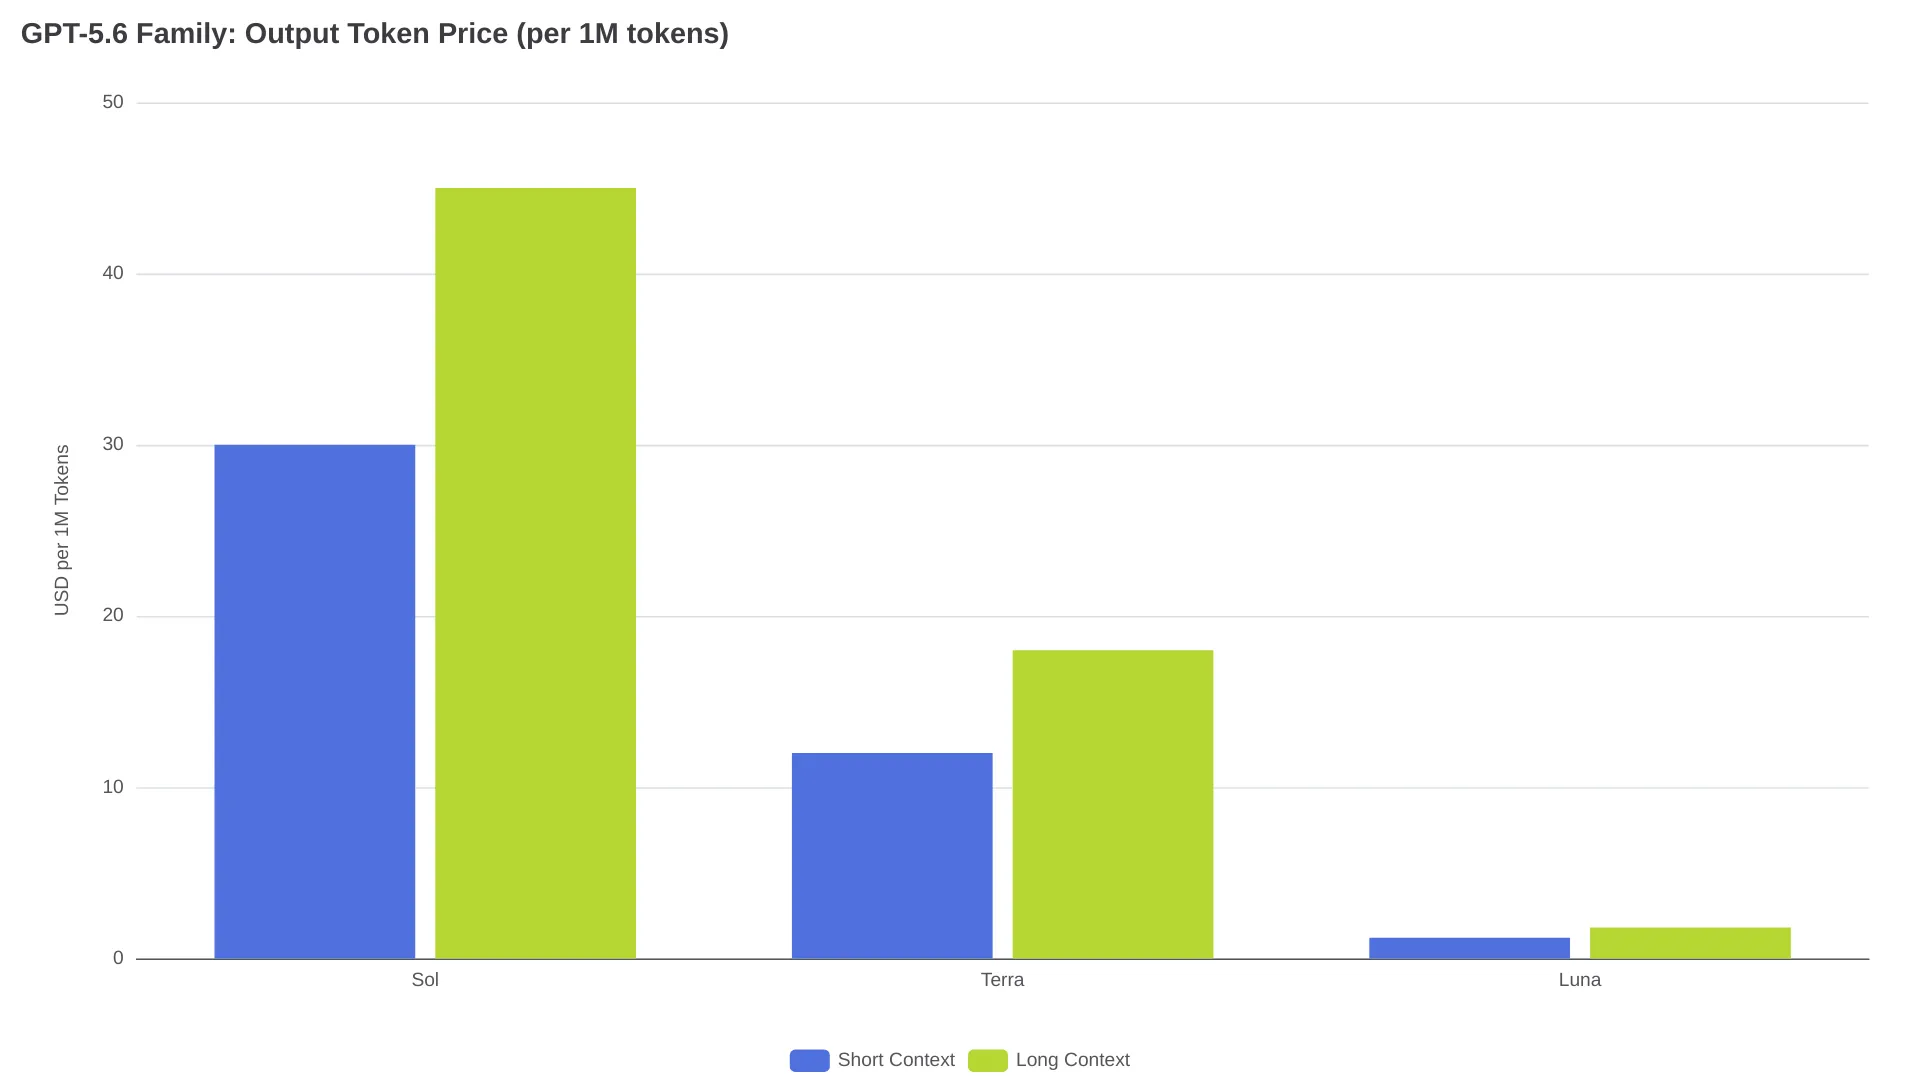
Sol coûte autant par token que GPT-5.5, mais consomme 2,25x plus de tokens par tâche. Dans les faits, votre coût par tâche double donc à peu près.
Les écritures en cache constituent un nouveau poste de dépense. GPT-5.6 facture les écritures en cache à 1,25x le tarif d’entrée, soit 6,25 $/1M pour Sol. GPT-5.5 ne prévoyait pas de frais d’écriture en cache. Si votre charge de travail affiche un faible taux de succès du cache, cela ajoute une majoration de 25 % à vos coûts d’entrée, qui n’existait pas auparavant.
Luna devient moins cher que GPT-5.4 nano. Avec 0,20 $/1,20 $ contre 0,20 $/1,25 $ pour nano, Luna est, après la baisse, le modèle le moins cher de la gamme OpenAI.
Trois leviers pour réduire votre facture GPT-5.6
Passer à Terra pour les tâches courantes
Le tarif de sortie de Terra est de 12 $/1M, soit 60 % de moins que les 30 $/1M de Sol. Dans l’Artificial Analysis Coding Agent Index, Terra se classe juste au-dessus de Claude Fable 5. Après sa baisse de prix de 20 % en juillet, Terra à 2,00 $/12,00 $ est également moins cher que l’ancien tarif de GPT-5.5.
Dans quels cas Sol reste-t-il pertinent ? Les sessions de débogage à plusieurs étapes, la planification d’architecture sur de grandes bases de code et l’analyse de sécurité. Ces tâches tirent parti de longues chaînes de raisonnement. Pour le développement standard, l’analyse et la génération de contenu, Terra offre des résultats comparables avec une consommation de tokens nettement plus faible.
Réduire le niveau d’effort
Le paramètre reasoning.effort détermine le nombre de tokens de raisonnement générés par le modèle, et le défaut de facturation signalé évolue directement avec le nombre d’éléments de raisonnement (k). En medium, Sol émet moins d’éléments de raisonnement qu’en xhigh ; le gonflement de la facturation baisse donc dans les mêmes proportions.
« J’utilise Terra Ultra et sa consommation de tokens me paraît en réalité bien plus efficace que celle de GPT 5.5. » — utilisateur de r/codex
Ce comportement de « fournaise à tokens » se concentre sur Sol aux niveaux d’effort élevés. Passer reasoning.effort à medium ou high, plutôt qu’à xhigh ou max, est le changement le plus efficace que vous puissiez effectuer.
Optimiser les accès au cache
GPT-5.6 a introduit des points de rupture explicites pour le cache ainsi qu’une durée de cache minimale de 30 minutes. Les lectures depuis le cache bénéficient d’une remise de 90 % : le coût d’entrée de Sol tombe alors de 5,00 $ à 0,50 $ par million de tokens. Les écritures en cache coûtent en revanche 1,25x le tarif d’entrée, soit 6,25 $/1M pour Sol.
Structurez vos prompts pour placer le message système et le contexte statique avant un point de rupture du cache. Le seuil de rentabilité dépend de votre charge de travail : le surcoût d’écriture représente 25 % du tarif d’entrée, tandis que les lectures économisent 90 %. Il faut donc un taux de succès où les économies sur les lectures dépassent la surtaxe d’écriture. Pour les charges de travail dont la plupart des requêtes partagent un long prompt système, l’équilibre devient rapidement favorable.
FAQ
OpenAI a-t-il reconnu le défaut de facturation ?
Un collaborateur d’OpenAI, Mark G., a répondu au signalement sur le forum communautaire le 12 juillet 2026 en demandant des identifiants de requêtes et des horodatages pour l’enquête. En août 2026, aucun correctif ni ajustement rétroactif de facturation n’avait été confirmé publiquement.
Comment vérifier si ce défaut touche mon compte ?
Pour chaque réponse comportant plusieurs éléments de raisonnement, additionnez usage.output_tokens_details.reasoning_tokens et les tokens de complétion visibles. Si usage.output_tokens dépasse cette somme de plus de quelques pourcents, le comportement de réaddition cumulative documenté dans le signalement du forum affecte probablement votre facture. Téléchargez votre CSV d’utilisation depuis le tableau de bord OpenAI et vérifiez modèle par modèle.
Faut-il passer de Sol à Terra ?
Pour la plupart des charges de travail via API, Terra coûte moins cher et obtient des scores compétitifs aux benchmarks de code. L’avantage de Sol se manifeste sur les tâches les plus difficiles : les propres benchmarks d’OpenAI montrent qu’il surpasse surtout Terra en raisonnement à plusieurs étapes et en recherche de sécurité, là où un temps de réflexion prolongé apporte le plus de valeur.