 AIREITER
Le 30 juillet 2026, OpenAI a réduit d’environ 80 % le tarif API de GPT-5.6 Luna : lancé à 1 $/6 $, le modèle est passé à 0,20 $ en entrée / 1,20 $ en sortie par million de tokens. À ce niveau, Luna revient environ 73 % moins cher que GPT-5.4 mini (0,75 $/4,50 $), tout en ayant fourni les mêmes réponses que mini sur nos prompts de code et de raisonnement. Mini conserve toutefois un avantage : ses réponses sont arrivées environ deux fois plus vite. Pour les charges de travail où la latence est la contrainte principale, l’ancien petit modèle reste donc pertinent.
La baisse de prix du 30 juillet change complètement la donne
GPT-5.6 Luna est devenu généralement disponible le 9 juillet 2026 à 1 $/6 $ par million de tokens. Il se positionnait comme l’offre économique de la famille GPT-5.6, mais restait plus onéreux que le très abordable gpt-5.4-mini d’OpenAI (0,75 $/4,50 $). Environ trois semaines plus tard, le 30 juillet, OpenAI a baissé le prix de Luna d’environ 80 %, à 0,20 $/1,20 $, et celui de GPT-5.6 Terra d’environ 20 %, à 2 $/12 $. Luna évolue désormais dans la même tranche que gpt-5.4-nano (0,20 $/1,25 $) : un modèle au prix d’un nano, avec un cerveau de génération actuelle.
Si vous avez vu Luna affiché à 1 $/6 $, ce tarif de lancement n’est plus en vigueur depuis le 30 juillet 2026. Le tarif actuel du niveau Standard est de 0,20 $/1,20 $, vérifié le 31 juillet 2026.
Luna face à mini : comparaison des tarifs catalogue
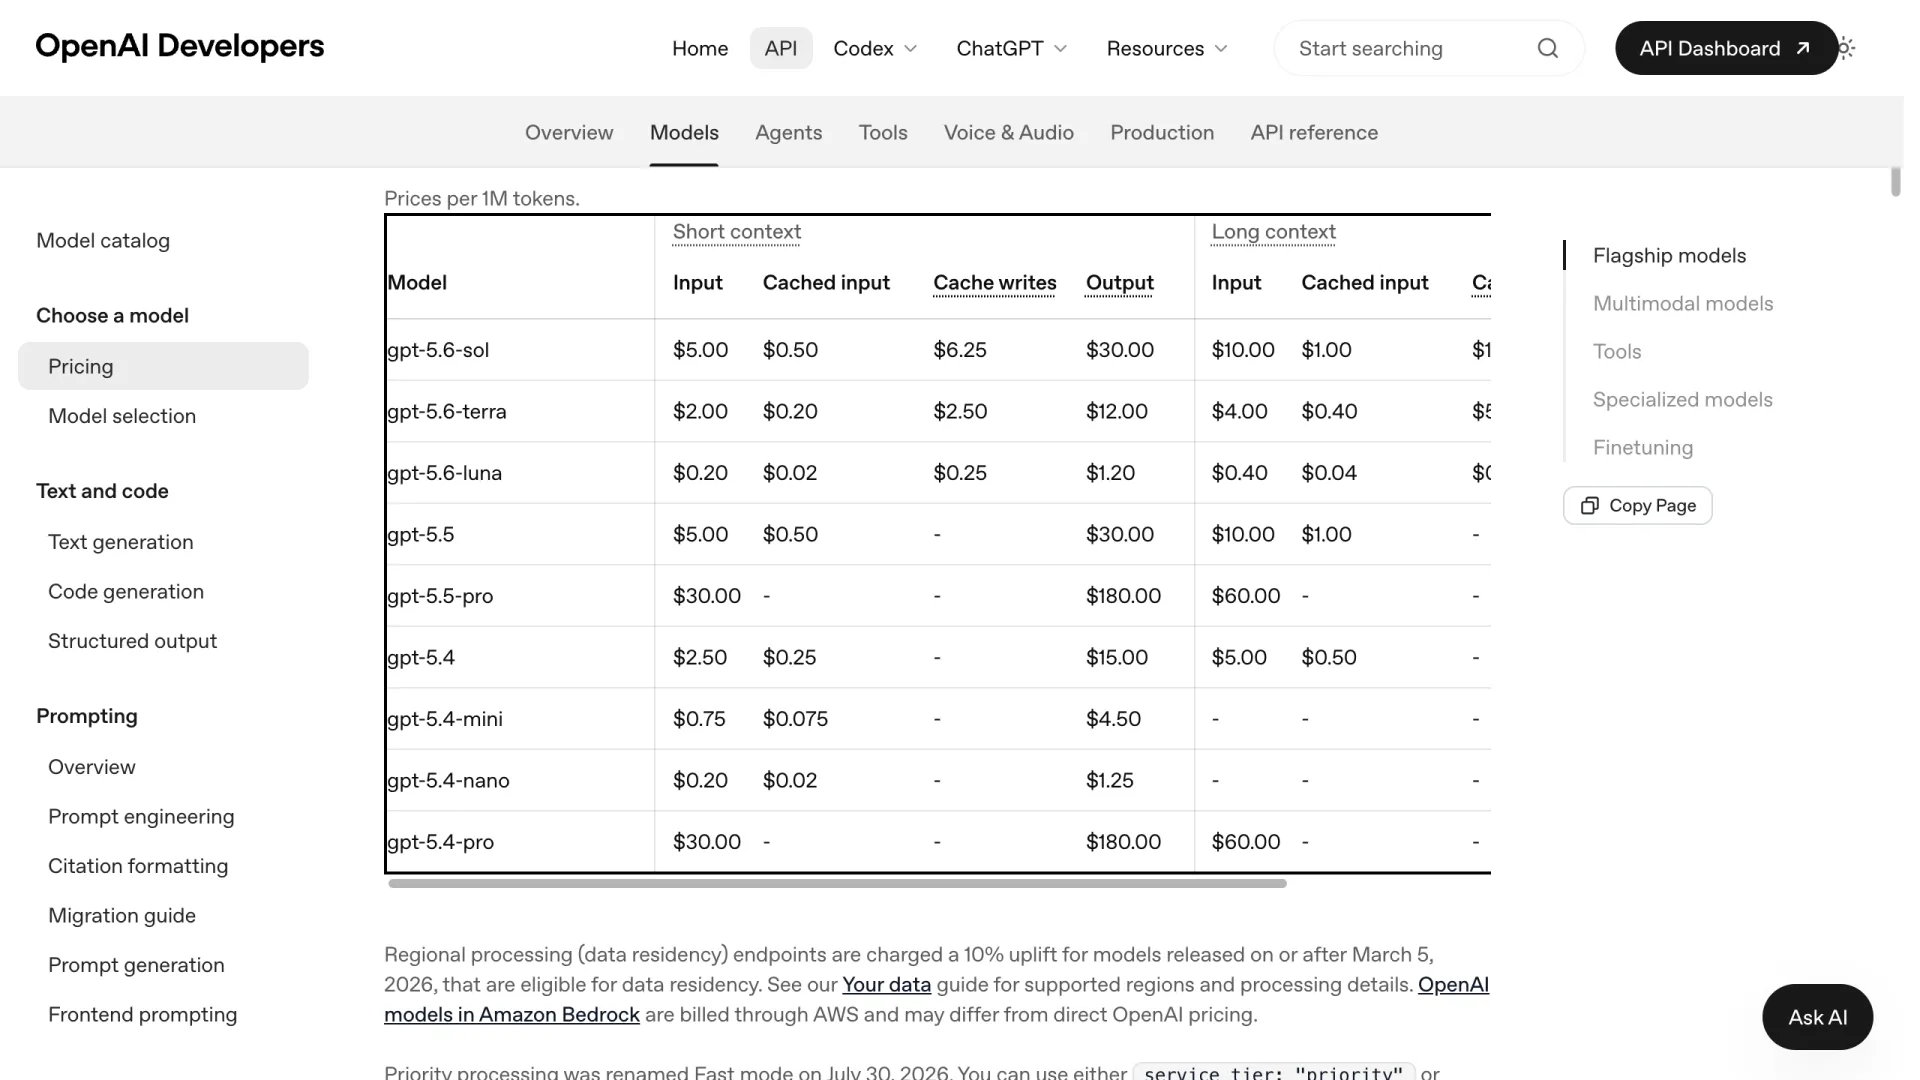
Aux tarifs actuels du niveau Standard, Luna est moins cher que mini, en entrée comme en sortie. L’écart se maintient aussi bien avec des prompts courts que longs. Luna dispose en outre d’une fenêtre de contexte de 1 050K, contre 400K pour mini.
| Modèle (Standard, par 1 M de tokens) | Entrée | Entrée en cache | Sortie | Contexte |
|---|---|---|---|---|
| gpt-5.6-luna (contexte court) | 0,20 $ | 0,02 $ | 1,20 $ | 1 050K |
| gpt-5.6-luna (contexte long, >200K) | 0,40 $ | 0,04 $ | 1,80 $ | 1 050K |
| gpt-5.4-mini | 0,75 $ | 0,075 $ | 4,50 $ | 400K |
Source : developers.openai.com/api/docs/pricing, vérifiée le 2026-07-31. À titre de comparaison, gpt-5.4-nano est affiché à 0,20 $/1,25 $, soit la tranche tarifaire que rejoint désormais Luna.
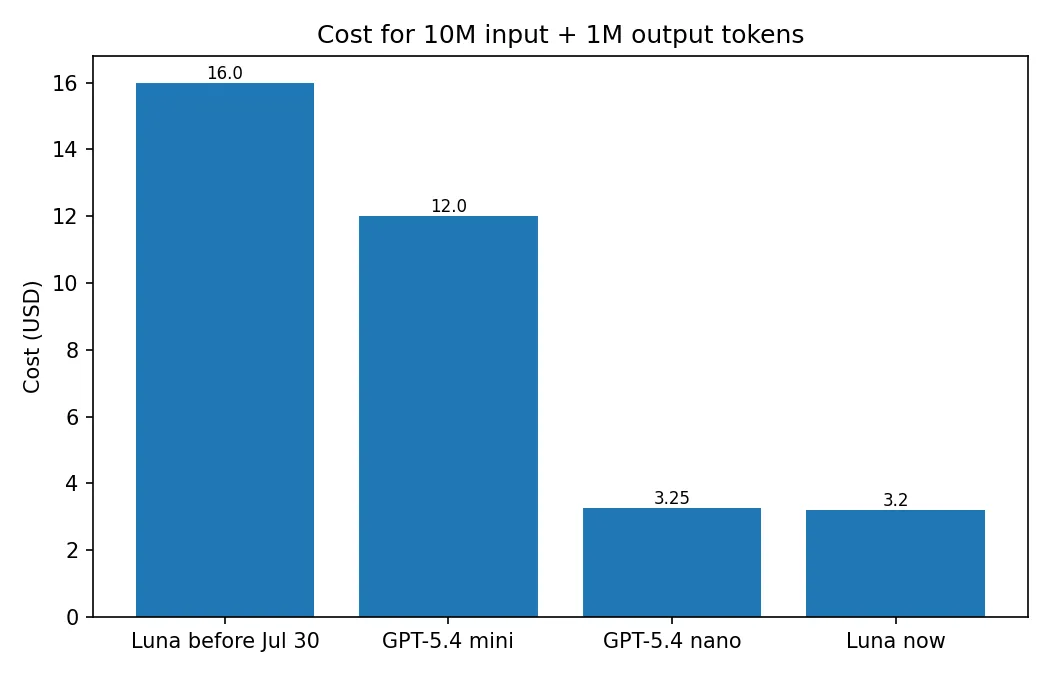
Sur une charge modérée de 10 M de tokens en entrée et 1 M en sortie, Luna coûte 3,20 $, contre 12,00 $ pour mini (nano revient à 3,25 $). À 1 M plus 1 M, on passe à 1,40 $ contre 5,25 $. Luna facture certes le double au-delà de 200K tokens en entrée — son tarif contexte long est de 0,40 $/1,80 $ — mais reste moins cher que le tarif fixe de mini à 0,75 $/4,50 $. Mini n’a pas de niveau contexte long : sa fenêtre de 400K relève d’une seule grille de prix pour contexte court. Pour une analyse plus détaillée des tarifs de toute la famille, consultez le guide tarifaire GPT-5.6.
Mêmes prompts, deux modèles : qualité, tokens et vitesse
Nous avons envoyé des prompts strictement identiques aux deux modèles via le même endpoint API : une tâche de code consistant à renvoyer la longueur de la plus longue sous-chaîne de parenthèses valides, et une tâche de raisonnement — le problème de l’escargot dans un puits — exécutée trois fois. Les deux modèles ont résolu correctement les deux exercices, avec le même algorithme à pile pour les parenthèses et la réponse « 28 jours » pour l’escargot lors de chacune des trois exécutions. La différence ne portait pas sur l’exactitude, mais sur la vitesse et la verbosité.
Qualité des réponses : match nul sur nos tests
Sur le prompt de code, Luna et mini ont produit des solutions à pile O(n) fonctionnellement identiques, avec un indice de base sentinelle ; aucune erreur à signaler. Sur le prompt de raisonnement, tous deux ont trouvé la bonne réponse, 28 jours, et noté à juste titre que l’escargot s’échappe le 28e jour avant de pouvoir redescendre. Sur ces deux tâches simples, les modèles sont donc à égalité ; nous n’avons pas mené de test de résistance sur des raisonnements plus difficiles.
Vitesse et latence
Mini a été environ deux fois plus rapide de bout en bout. Sur trois exécutions de la tâche de raisonnement, mini a affiché une moyenne d’environ 2,8 s, contre environ 5,5 s pour Luna ; sur l’unique exécution de code, mini a pris 4,0 s contre 4,6 s pour Luna. Ce surcroît de temps chez Luna suit sa réponse plus développée : 168 tokens, contre 76 pour mini sur la tâche de raisonnement. Luna privilégie l’exhaustivité plutôt que la réponse immédiate.
« It’s basically as fast as 5.4 mini if you use medium thinking and reasons really well, like above 5.4 level. » — r/codex, fil « GPT-5.6 Luna is really underrated »
Avec les réglages par défaut, mini est le choix le plus rapide.
Coût par tâche
La plus grande verbosité de Luna est largement compensée par son prix unitaire inférieur. Sur le prompt de raisonnement, Luna a généré en moyenne 168 tokens de sortie, contre 76 pour mini ; aux tarifs actuels, cette réponse revenait pourtant à environ 0,001 $ avec Luna, contre 0,004 $ avec mini. Ces chiffres sont inférieurs à un centime et reposent sur un échantillon à un chiffre (tests réalisés le 2026-07-31 via l’API AIReiter avec gpt-5.6-luna et gpt-5.4-mini, effort par défaut, endpoint américain ; temps mesurés sur la réponse complète et nombres de tokens remontés par l’API pour la complétion) : ils indiquent une tendance plutôt qu’un benchmark. Cette tendance est néanmoins sans ambiguïté : à réponse correcte égale, Luna coûte moins cher.
Pourquoi le débat « lequel est le plus intelligent ? » repose surtout sur des réglages différents
Sur les scores bruts, Luna devance mini en code et en raisonnement : 62,7 contre 54,4 sur SWE-Bench Pro, 92,3 contre 88,0 sur GPQA Diamond, et 53,4 contre 42,9 sur Toolathlon, selon les fiches de score d’OpenAI. Le résultat le plus souvent cité qui inverse ce verdict provient de l’Intelligence Index d’Artificial Analysis : GPT-5.4 y obtient 51, contre 46 pour Luna. Mais l’indice compare Luna avec un effort élevé à GPT-5.4 avec un effort xhigh. Le budget de raisonnement diffère donc de chaque côté : la comparaison n’est pas à armes égales.
| Benchmark | GPT-5.6 Luna | GPT-5.4 mini | Note |
|---|---|---|---|
| SWE-Bench Pro | 62,7 | 54,4 | Luna devant |
| GPQA Diamond | 92,3 | 88,0 | Luna devant |
| MMMU Pro | 78,4 | 76,6 | Proches |
| Toolathlon | 53,4 | 42,9 | Luna devant |
| Terminal-Bench | 84,7 (v2.1) | 60,0 (v2.0) | Versions différentes |
| OSWorld | 45,6 (v2.0) | 72,1 (Verified) | Protocoles différents |
Scores compilés à partir des fiches de score publiées par OpenAI et recoupés avec docsbot.ai.
Deux réserves sont importantes à garder en tête. D’abord, le niveau d’effort : mini propose un réglage fin None / Low / Medium / High / XHigh, tandis que Luna utilise par défaut un niveau de raisonnement élevé. Régler mini sur xhigh puis le comparer à Luna dans sa configuration par défaut gonfle donc le score mis en avant pour mini. Ensuite, les lignes ne sont pas toutes strictement comparables. docsbot.ai indique que les chiffres Terminal-Bench et OSWorld mélangent des versions et protocoles de benchmark différents. C’est ainsi que le 72,1 de mini sur OSWorld peut paraître supérieur au 45,6 de Luna, alors que les tests diffèrent subtilement.
Au-delà des scores, Luna bénéficie d’une date de fin de connaissances fixée à février 2026, contre août 2025 pour mini, ainsi que d’une fenêtre de contexte de 1,05 M contre 400K.
Le fil affirmant que « Luna coûte 96 % plus cher » est désormais dépassé
Un test de la communauté OpenAI, largement relayé, avait conclu que Luna coûtait 96 % de plus que mini sur une conversation de six tours. Ce chiffre est exact, mais antérieur à la baisse de prix : le test a été mené le 11 juillet, avec le tarif de lancement de Luna à 1 $/6 $. En outre, l’essentiel de l’écart provenait d’un bug d’invalidation du cache dans l’application de test, et non du modèle lui-même. Lorsque l’auteur a cessé de modifier les instructions de premier niveau à chaque tour, le surcoût de Luna est tombé à 16,7 % ; Luna s’est aussi montrée 9,9 % plus rapide, avec un meilleur score de qualité en évaluation à l’aveugle (4,80 contre 4,28).
Au tarif actuel de 0,20 $/1,20 $, Luna est moins cher que mini avant même de tenir compte du cache : cet argument ne pèse donc plus dans le choix entre Luna et mini. Le mécanisme reste utile à connaître pour optimiser les coûts. OpenAI facture les écritures en cache à 1,25× le tarif d’entrée — soit actuellement 0,25 $/M pour Luna — et les lectures en cache avec une remise de 90 %, pour une durée de vie minimale du cache de 30 minutes. Si votre application réécrit le prompt système à chaque tour, le préfixe mis en cache est invalidé et vous payez le tarif d’écriture plutôt que celui de lecture. C’est ce piège qui a produit le chiffre de 96 %.
Quel modèle appeler selon le besoin ?
Pour la plupart des charges de travail, Luna est désormais le meilleur choix : moins cher dans les deux niveaux de contexte, au moins au niveau de mini en qualité, avec une date de fin de connaissances plus récente et une fenêtre 2,6× plus grande. Préférez mini lorsque la latence est une contrainte impérative, ou si vous avez besoin du réglage d’effort qu’expose mini et pas Luna.
| Si vous recherchez… | Choisissez | Pourquoi |
|---|---|---|
| Le coût le plus bas par réponse correcte | Luna | 0,20 $/1,20 $, environ 73 % sous mini |
| La latence la plus basse | mini | Environ 2× plus rapide de bout en bout (environ 2,8 s contre environ 5,5 s en raisonnement) |
| Un contrôle fin de l’effort, de None à XHigh | mini | Luna n’est disponible qu’au niveau élevé |
| Des prompts de plus de 400K tokens | Luna | Fenêtre de 1,05 M ; mini est limité à 400K |
| La sortie la plus concise | mini | A généré environ deux fois moins de tokens sur des tâches identiques |
Une stratégie de routage pragmatique consiste à garder mini par défaut là où son avantage de latence compte, et à réserver Luna aux escalades et aux tâches à long contexte, où la qualité et la taille de fenêtre priment. Les deux modèles sont disponibles via une API unifiée sous les identifiants gpt-5.6-luna et gpt-5.4-mini, par exemple sur l’endpoint AIReiter GPT-5.6 Luna. Attention à un détail de routage : le modèle phare Sol est tarifé à 5 $/30 $, soit environ 25× Luna. Si votre endpoint associe un identifiant gpt-5.6 sans suffixe à Sol, utilisez explicitement l’identifiant complet gpt-5.6-luna.
FAQ
GPT-5.6 Luna coûte-t-il moins cher que GPT-5.4 mini ?
Oui, d’environ 73 % aux tarifs actuels. Depuis la baisse du 30 juillet 2026, Luna coûte 0,20 $ en entrée / 1,20 $ en sortie par million de tokens, contre 0,75 $ / 4,50 $ pour mini, aussi bien en entrée qu’en sortie.
GPT-5.6 Luna est-il plus rapide ou plus lent que 5.4 mini ?
Plus lent, d’environ 2× dans notre test sur prompts identiques : mini a affiché une moyenne d’environ 2,8 s, contre environ 5,5 s pour Luna sur le raisonnement. Luna échange de la vitesse contre un raisonnement plus complet ; réduire son effort resserre l’écart.
GPT-5.6 Luna remplace-t-il l’offre mini ?
Non. Luna représente l’offre économique de la génération GPT-5.6 ; gpt-5.4-mini est un petit modèle distinct, plus ancien, qui reste commercialisé et pris en charge.
GPT-5.4 nano ou Luna : lequel est le moins cher ?
Ils sont pratiquement à égalité. Luna est à 0,20 $/1,20 $, contre 0,20 $/1,25 $ pour nano. Luna est très légèrement moins cher en sortie et appartient à une génération plus récente, avec une date de fin de connaissances ultérieure.
Quand Luna et mini sont-ils sortis ?
Luna a été lancé le 9 juillet 2026, puis ramené à son tarif actuel le 30 juillet 2026. GPT-5.4 mini a été lancé le 17 mars 2026.
Sources
- Tarifs actuels (vérifiés le 2026-07-31) : developers.openai.com/api/docs/pricing
- Lancement de GPT-5.6, niveaux de la famille et politique d’écriture du cache : openai.com/index/gpt-5-6/
- Test de coût contrôlé sur plusieurs tours (avant la baisse) : community.openai.com
- Agrégats de benchmarks et de capacités : artificialanalysis.ai, docsbot.ai