 AIREITER
Sur nos trois prompts identiques, GPT-5.6 Luna et DeepSeek V4 Pro ont tous deux obtenu un sans-faute. La capacité brute ne devrait donc pas être le facteur décisif. En pratique, tout se joue plutôt sur la latence et la structure tarifaire — d'autant que DeepSeek affiche désormais un avertissement officiel annonçant une hausse de prix significative. Voici ce que nous avons mesuré le 10 août 2026, et comment trancher.
Trois prompts identiques, deux API : nos mesures
Le 10 août 2026, nous avons envoyé trois tâches strictement identiques à GPT-5.6 Luna et DeepSeek V4 Pro via le même pipeline API, avec les réglages par défaut de chaque modèle : un correctif de bug Python assorti d'une consigne volontairement concise ("reply with the corrected function only"), un problème de planification de camions sur trois quais n'admettant qu'une seule réponse correcte (10:10), et une extraction JSON stricte contenant un champ nullable. Les deux modèles ont réussi les trois exercices.
| Tâche | GPT-5.6 Luna | DeepSeek V4 Pro |
|---|---|---|
Correction du bug Python merge_intervals | Correcte (correctif max()), 10.7s | Correcte (correctif max()), 16.1s |
| Raisonnement de planification des quais | Correct (10:10), 8.0s | Correct (10:10), 27.2s |
| Extraction JSON stricte | Valide, schéma respecté à l'identique, 3.0s | Valide, schéma respecté à l'identique, 7.6s |
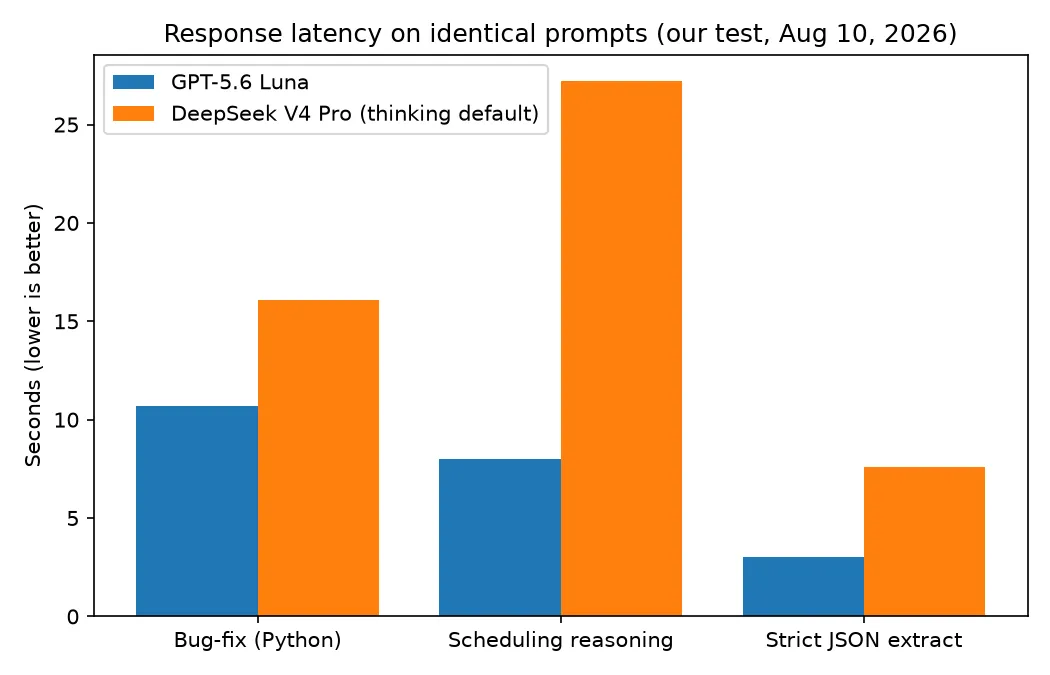
Deux réserves, puis deux précisions importantes. Il s'agit d'une vérification ponctuelle sur trois tâches, pas d'un benchmark. V4 Pro active par défaut son mode de réflexion, ce qui explique l'essentiel de son écart de latence de 2 à 3x dans ce test ; il peut être désactivé requête par requête, au prix d'une perte sur les raisonnements difficiles. Côté suivi des instructions, Luna a renvoyé uniquement la fonction demandée, tandis que V4 Pro l'a placée dans un bloc de code Markdown. Sans conséquence dans une interface de chat, mais cela ajoute une étape de parsing dans un pipeline. Nous avons relancé une fois la tâche de planification pour vérifier la stabilité : les deux modèles ont de nouveau répondu 10:10.
Tarifs officiels vérifiés, avec une hausse annoncée chez DeepSeek
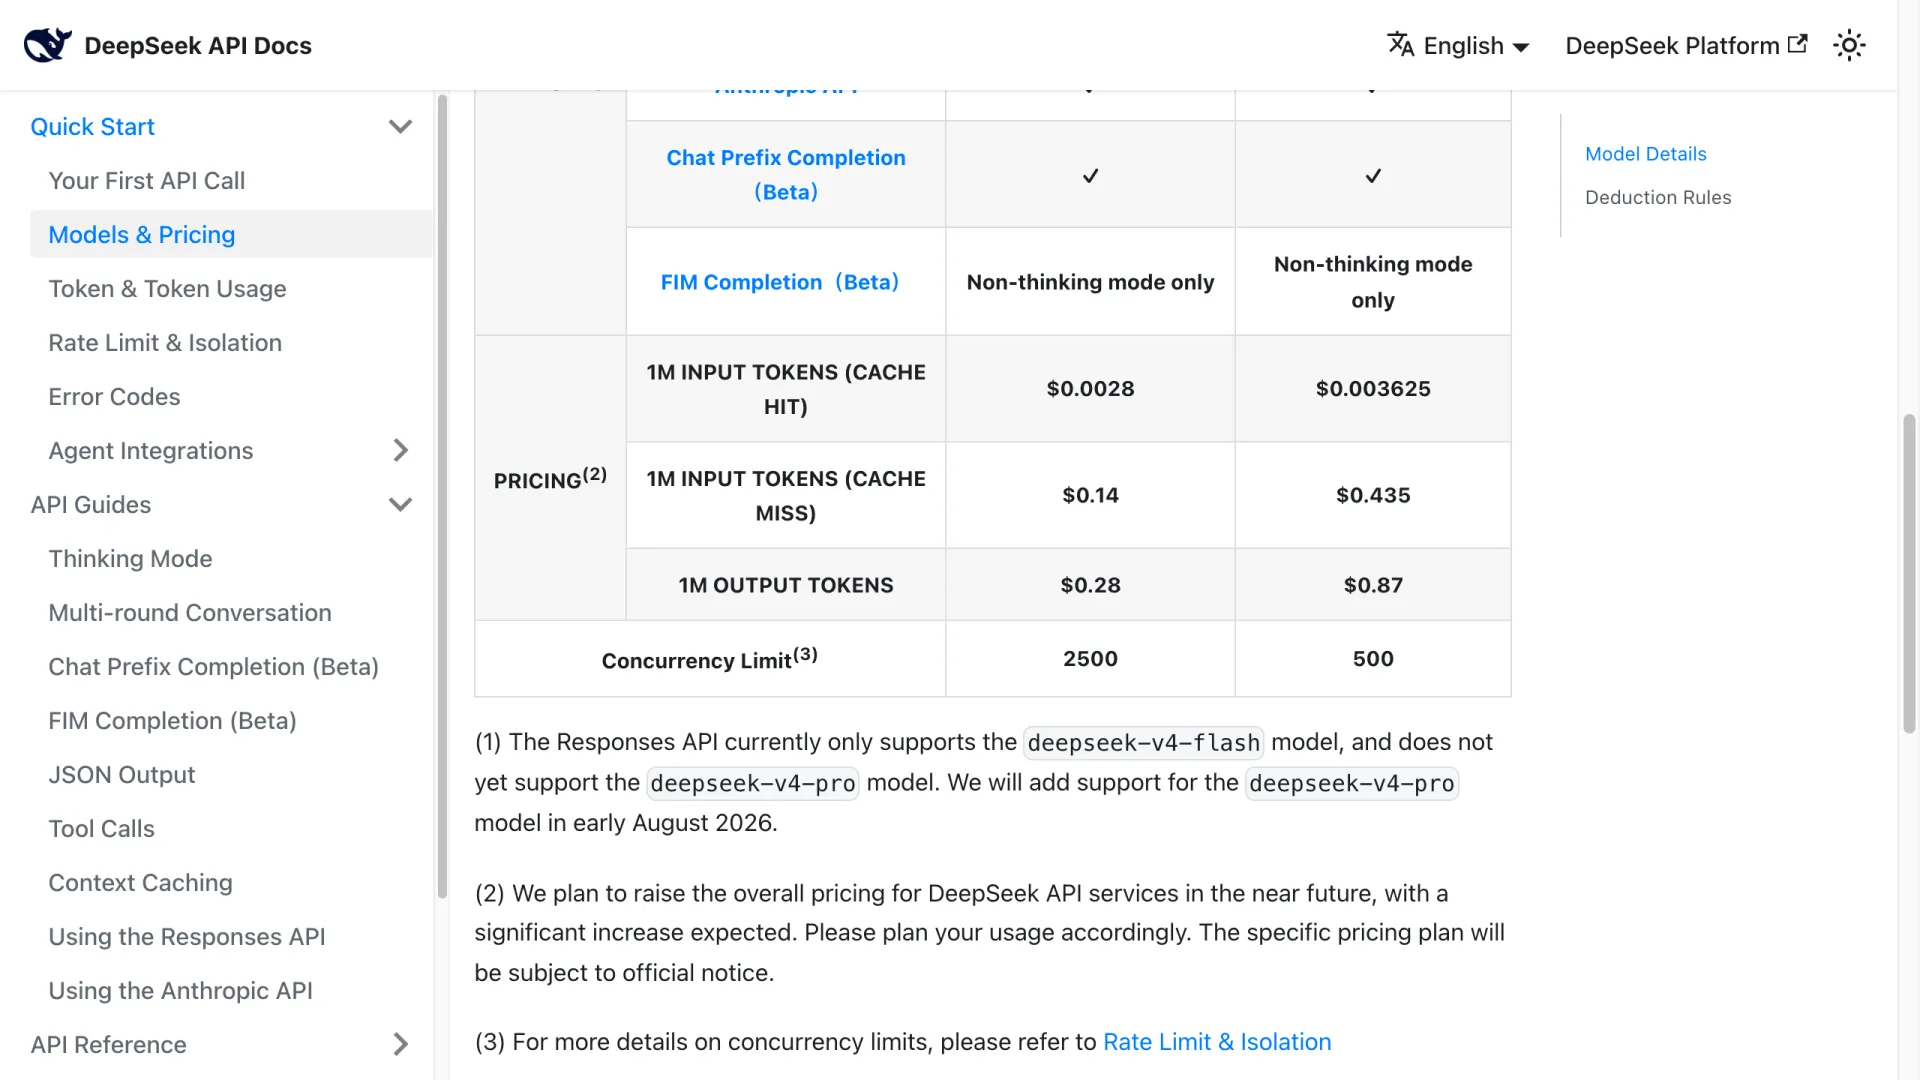
Tarifs vérifiés sur les pages officielles des deux fournisseurs le 10 août 2026 : GPT-5.6 Luna coûte $0.20 par million de tokens d'entrée, $0.02 pour les tokens mis en cache et $1.20 en sortie (page modèle OpenAI) ; DeepSeek V4 Pro facture $0.435 par million de tokens d'entrée en cas de cache miss, $0.003625 en cas de cache hit et $0.87 en sortie (page tarifaire DeepSeek).
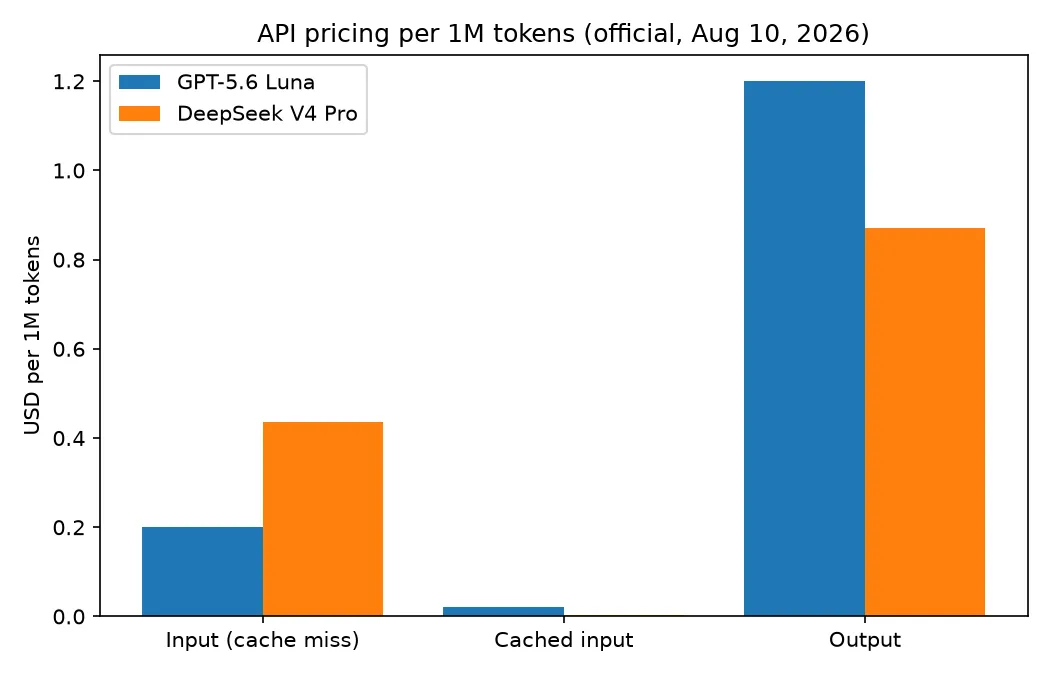
Aucun des deux modèles n'est donc moins cher dans tous les cas : l'entrée non mise en cache de Luna coûte 54% moins cher ; la sortie de V4 Pro coûte 27% moins cher ; les cache hits de V4 Pro sont 5.5x moins chers que ceux de Luna. Tout dépend de votre répartition de tokens :
- Chat interactif (1K tokens d'entrée + 500 en sortie par appel) : Luna $0.0008 contre V4 Pro $0.00087, soit une quasi-égalité.
- Revue de dépôt (50K tokens d'entrée neufs + 3K en sortie) : Luna $0.0136 contre V4 Pro $0.0244, Luna est 44% moins cher.
- Boucle d'agent (200K tokens en cache + 20K tokens d'entrée neufs + 10K en sortie par itération) : Luna $0.020 contre V4 Pro $0.018. V4 Pro prend l'avantage ici, et l'écart augmente à chaque itération supplémentaire utilisant le cache.
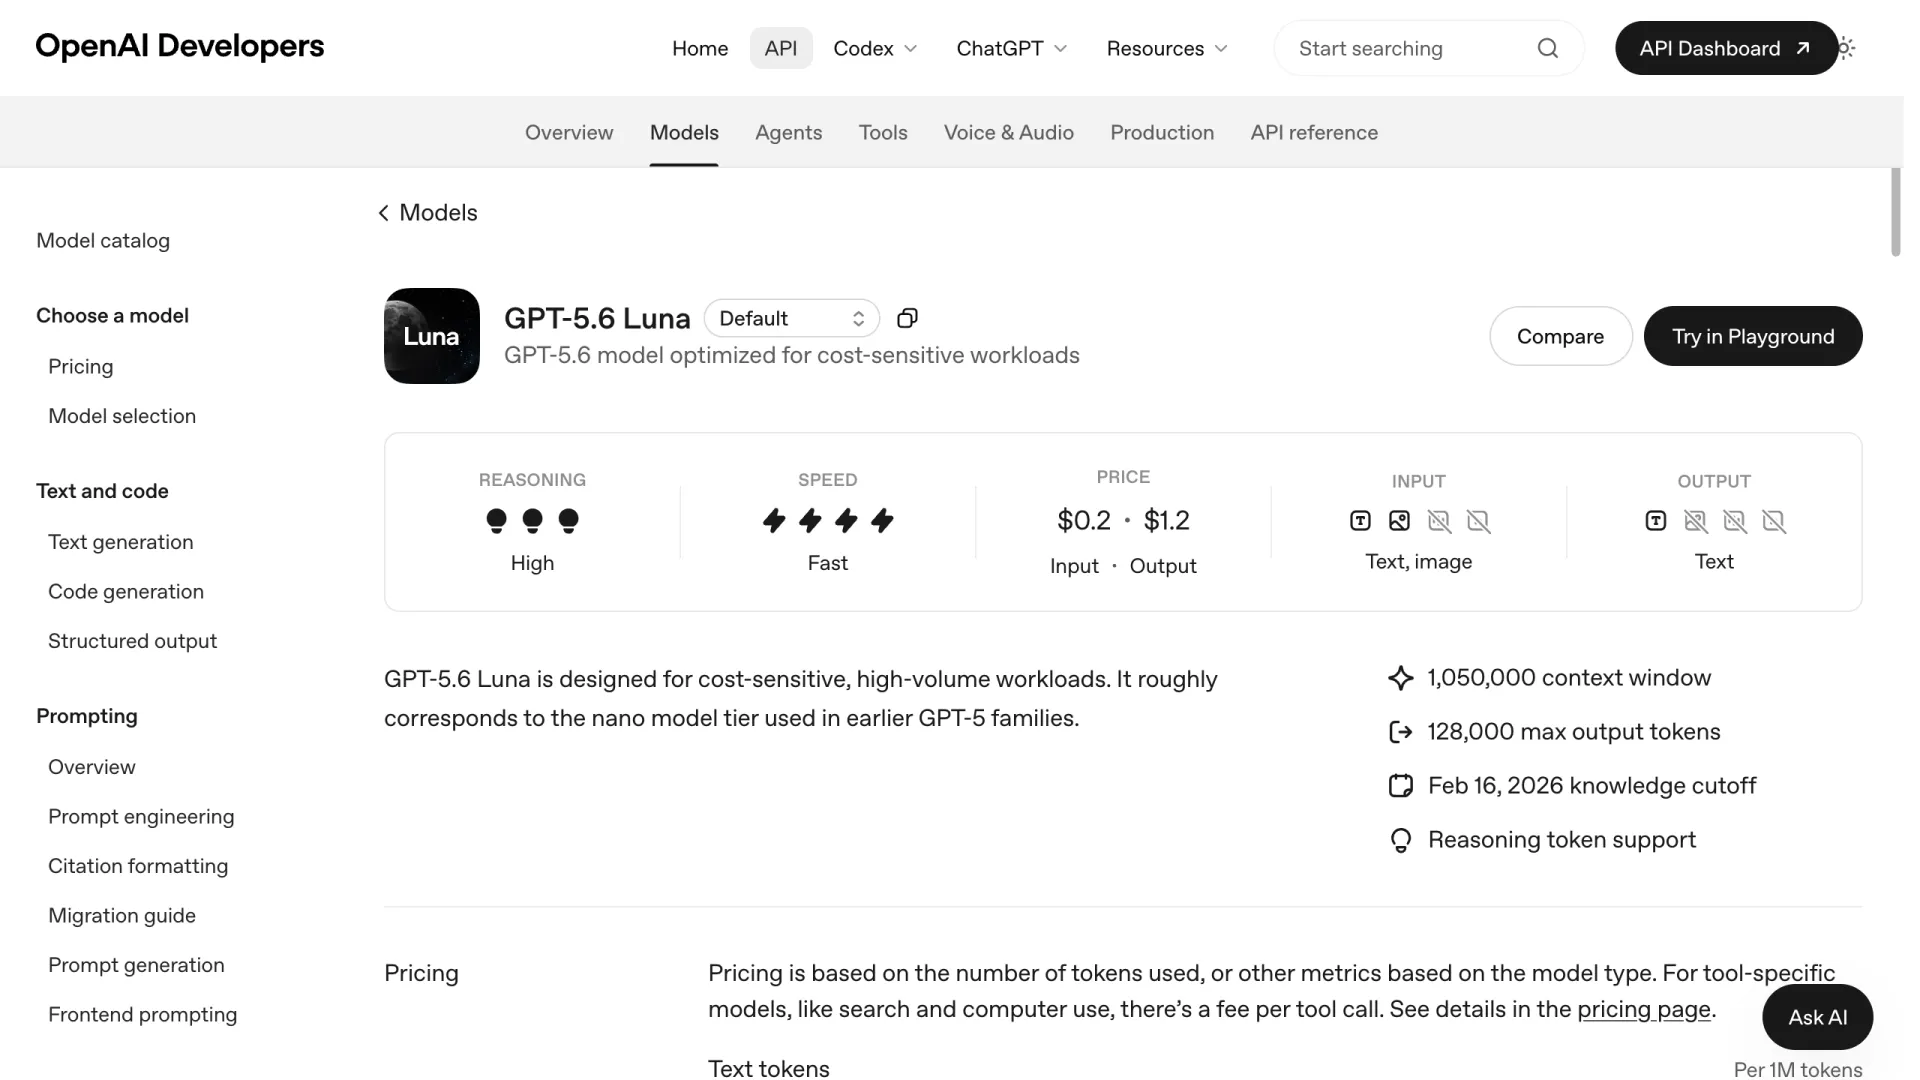
Un élément supplémentaire limite la durée de validité de ce calcul. La note de bas de page 2 de la page tarifaire de DeepSeek indique : "We plan to raise the overall pricing for DeepSeek API services in the near future, with a significant increase expected." Aucune date, aucun montant. Mais si l'argument en faveur de V4 Pro repose sur son prix, il est assorti d'un avertissement officiel d'expiration. La tarification de Luna évolue dans l'autre sens : son arrivée a coïncidé avec la baisse de prix d'OpenAI sur GPT-5.6 en août.
Économie du cache : l'avantage V4 Pro
DeepSeek V4 Pro facture $0.003625 par million de tokens d'entrée en cache, contre $0.02 pour Luna : un écart de 5.5x qui pèse lourd dans les charges d'agents, où chaque itération relit un long préfixe inchangé. Les développeurs qui font tourner des agents l'ont remarqué :
DeepSeek v4 Pro & MiMo v2.5 Pro ... are insanely cheap for agent-driven work due to their super low cached-input prices ($0.0036/mtok). For Luna, the cached-input price ... the pricing page puts it at $0.02/mtok, & that's 5x more expensive. — commentaire Hacker News, dans le fil consacré au lancement de GPT-5.6
Il faut également intégrer le surcoût d'écriture dans le cache de Luna : les écritures sont facturées 1.25x le tarif d'entrée hors cache (page modèle OpenAI), et les prompts dépassant 272K tokens d'entrée sont facturés 2x sur l'entrée et 1.5x sur la sortie, pour l'ensemble de la requête. Si le contexte de votre agent dépasse régulièrement 272K tokens, le prix effectif de Luna double à peu près précisément là où le cache de V4 Pro devient le plus intéressant.
Avant de modéliser les coûts, vérifiez les documents officiels
Au cours de cette comparaison, nous avons trouvé des chiffres tiers publiés allant de $0.435 à $1.74 par million de tokens d'entrée pour V4 Pro, ainsi que des fenêtres de contexte pour Luna annoncées entre 400K et 1.05M. Trois vérifications prennent moins d'une minute : consultez uniquement les deux pages officielles liées plus haut pour les tarifs, confirmez la chaîne de version du modèle (l'API actuelle sert DeepSeek-V4-Pro ; Flash est figé sur -0731), et regardez si le « prix d'entrée » cité correspond au tarif cache hit ou cache miss ; pour V4 Pro, l'écart entre les deux est de 120x.
Les caractéristiques qui déterminent le bon usage
Au-delà du prix, quatre différences techniques orientent réellement le choix : plafond de sortie, modalités, ouverture et surface API. Les deux modèles annoncent une fenêtre de contexte d'environ 1M de tokens (Luna : 1,050,000 tokens ; V4 Pro : 1M) ; le contexte seul ne les départagera donc pas.
| Caractéristique (vérifiée le 10 août 2026) | GPT-5.6 Luna | DeepSeek V4 Pro |
|---|---|---|
| Fenêtre de contexte | 1,050,000 | 1M |
| Tokens de sortie maximum | 128K | 384K |
| Modalité d'entrée | Texte + image | Texte uniquement |
| Contrôle du raisonnement | Niveaux d'effort (low→max) | Thinking activé (par défaut) / désactivé |
| Poids ouverts | Non | Oui (auto-hébergeable) |
| Responses API | Oui | Pas encore (officiel : début août 2026) |
| Limite de concurrence | Selon le niveau d'utilisation | 500 |
| Date limite des connaissances | 16 fév. 2026 | Non indiquée sur la page tarifaire |
Le plafond de sortie de 384K de V4 Pro représente 3x celui de Luna, limité à 128K. C'est déterminant pour générer un codebase en une passe, de longues traductions ou des extractions structurées massives, lorsque le découpage ajoute des sources d'échec. L'entrée image de Luna compte pour une tout autre raison, que les utilisateurs de DeepSeek évoquent spontanément :
My only real complaint is that they can't do images, which limits their ability to autonomously debug some kinds of issues. — commentaire Hacker News, à propos de l'utilisation de DeepSeek pour des projets personnels
Les poids ouverts font pencher la balance dans l'autre sens : V4 Pro est téléchargeable et peut être auto-hébergé. C'est donc ici la seule option adaptée à des exigences de résidence des données — avec une réserve : servir un modèle de cette taille impose de déployer une infrastructure multi-GPU conséquente, pas un projet de week-end.
Les benchmarks varient davantage selon le mode d'effort que selon le modèle
Les scores publiés pour GPT-5.6 Luna et DeepSeek V4 Pro peuvent inverser le classement selon le mode d'effort utilisé pour les tests : les mêmes modèles affichent 33.3 contre 44.3 (victoire de V4 Pro) sur un tracker qui teste Luna en effort faible face à V4 Pro en effort maximal, et 52 contre 45 (victoire de Luna) sur Artificial Analysis, qui pousse les deux modèles au maximum. Aucun de ces résultats n'est erroné : ils ne mesurent pas les mêmes configurations.
Le même piège existe pour les chiffres de latence. Artificial Analysis mesure un délai avant le premier token de réponse de 132 secondes pour Luna en effort maximal : dans ce mode, Luna réfléchit environ deux minutes avant de répondre. Dans notre test avec les réglages par défaut, Luna répondait en 3–10.7 secondes. Les deux chiffres sont réels ; un seul correspondra à votre configuration de production. Une fois la génération lancée, le débit favorise nettement Luna : 202 tokens/s contre 78 (Artificial Analysis).
Les modes d'effort font aussi énormément varier les scores d'un même modèle : V4 Pro atteint 90.1% sur GPQA Diamond avec thinking au maximum, mais 72.9% avec thinking désactivé. Sur les benchmarks partagés en effort maximal, Luna mène sur SWE-Bench Pro, 62.7% contre 55.4%, et les deux font match nul sur BrowseComp (83.3 contre 83.4). Avant de vous fier à un tableau de scores, posez trois questions : quel mode d'effort a été utilisé, le chiffre de latence inclut-il le temps de réflexion, et les versions du benchmark sont-elles identiques ? L'écart de 84.7 contre 67.9 sur Terminal-Bench chez un tracker compare par exemple v2.1 à v2.0.
Lequel choisir ?
Choisissez GPT-5.6 Luna pour les produits destinés aux utilisateurs : dans notre test aux réglages par défaut, il était 2 à 3x plus rapide sur les trois tâches, son entrée hors cache coûte moitié moins que celle de V4 Pro, et il accepte les images. Préférez DeepSeek V4 Pro pour les boucles d'agents intensives en cache, les sorties dépassant 128K tokens ou tout usage devant tourner sur votre propre matériel, en intégrant l'avertissement officiel de hausse de prix à tout engagement de long terme. Les deux ne sont séparés que par un changement d'endpoint sur GPT-5.6 Luna et DeepSeek V4 Pro : vous pouvez donc rejouer nos trois prompts sur votre propre charge de travail avant de vous engager.
| Votre charge de travail | Choix | Facteur décisif |
|---|---|---|
| Chatbots, applications destinées aux utilisateurs | Luna | Latence de 3.0–10.7s contre 7.6–27.2s dans notre test ; 202 contre 78 tok/s |
| Traitement intensif d'entrées non mises en cache | Luna | $0.20 contre $0.435 par 1M de tokens d'entrée hors cache |
| Boucles d'agents sur contexte stable | V4 Pro | $0.003625 contre $0.02 par 1M de tokens d'entrée en cache |
| Longues sorties en une seule passe | V4 Pro | 384K contre 128K tokens de sortie maximum |
| Vision (captures d'écran, PDF sous forme d'images) | Luna | V4 Pro est limité au texte |
| Auto-hébergement / résidence des données | V4 Pro | Poids ouverts ; Luna est accessible uniquement par API |
| Prévisibilité budgétaire jusqu'en 2027 | Luna | Avis officiel de DeepSeek annonçant une hausse de prix |
FAQ
Lequel est moins cher, GPT-5.6 Luna ou DeepSeek V4 Pro ?
Aucun, de façon universelle. L'entrée hors cache de Luna coûte 54% moins cher ($0.20 contre $0.435 par 1M de tokens) ; l'entrée en cache de V4 Pro coûte 5.5x moins cher ($0.003625 contre $0.02) et sa sortie est 27% moins chère ($0.87 contre $1.20). Les agents utilisant massivement le cache coûtent moins cher avec V4 Pro ; les charges centrées sur des entrées neuves coûtent moins cher avec Luna.
Les deux modèles prennent-ils en charge une fenêtre de contexte de 1M de tokens ?
Oui : Luna offre 1,050,000 tokens et V4 Pro 1M. À noter que les requêtes Luna dépassant 272K tokens d'entrée sont facturées 2x sur l'entrée et 1.5x sur la sortie pour l'intégralité de la requête.
DeepSeek V4 Pro est-il open source et peut-il être auto-hébergé ?
Oui. V4 Pro est livré avec des poids ouverts et peut être auto-hébergé, contrairement à Luna, uniquement accessible par API. Prévoyez toutefois une infrastructure de service multi-GPU plutôt qu'une station de travail unique.
GPT-5.6 Luna accepte-t-il les images en entrée ?
Oui, Luna accepte les entrées texte et image. DeepSeek V4 Pro est limité au texte. Ses propres utilisateurs citent l'absence de vision comme sa principale limite pour les workflows de débogage autonome.
Quel est le nombre maximal de tokens de sortie pour chaque modèle ?
DeepSeek V4 Pro peut générer jusqu'à 384K tokens par réponse ; GPT-5.6 Luna est plafonné à 128K. Pour produire en une seule passe de longs documents ou de gros fichiers de code, le plafond de V4 Pro est 3x plus élevé.
À lire aussi
- DeepSeek V4 Pro vs GPT-5.6 Sol : le même fleuron de DeepSeek face au modèle milieu de gamme d'OpenAI
- Test de GPT-5.6 Luna : Luna évalué pour lui-même, au-delà de ce face-à-face
- DeepSeek V4 Flash vs V4 Pro : si le risque tarifaire de V4 Pro vous pousse vers une gamme inférieure