 AIREITER
Lancé le 14 août 2026, GLM-5.3 arrive avec des promesses ambitieuses : Z.ai revendique un gain de 50 % en programmation face à GLM-5.2, ainsi qu’une nouvelle compétence en cybersécurité, créditée de 84,5 % sur CyberGym. De son côté, DeepSeek V4 Pro est déjà accessible par API, disponible en poids ouverts sous licence MIT et affiche 80,6 % sur SWE-Bench Verified dans sa model card — une mesure indépendante du NIST atteint 81 %. Tout se joue toutefois sur un point : GLM-5.3 n’a pas encore d’API publique. Il ne s’utilise qu’au sein des produits gérés de Z.ai, ZCode et le GLM Coding Plan. Cette différence change profondément la comparaison.
Deux philosophies d’accès, pas deux API comparables
DeepSeek V4 Pro a été lancé avec des poids ouverts sur Hugging Face sous licence MIT, une API documentée sur api-docs.deepseek.com et un hébergement tiers chez des fournisseurs tels que SiliconFlow. Vous pouvez l’auto-héberger, l’utiliser avec n’importe quel client compatible OpenAI ou l’appeler dès maintenant depuis Claude Code, Cline ou vos propres scripts.
GLM-5.3 suit exactement la voie inverse. L’annonce de lancement de Z.ai indique que le modèle est immédiatement disponible via le GLM Coding Plan et ZCode, l’IDE de programmation maison de Z.ai. L’accès API et les poids ouverts ne viendront qu’après des « rigorous safety evaluations ». En pratique, il n’existe ni endpoint model: glm-5.3, ni téléchargement Hugging Face, ni inférence via un fournisseur tiers. Z.ai n’a communiqué aucun calendrier.
Benchmarks de code : annonces éditeur contre résultats vérifiés
GLM-5.3 et DeepSeek V4 Pro sont tous deux de grands modèles MoE chinois conçus pour le développement agentique, mais les éléments disponibles pour les évaluer n’ont pas le même degré de maturité.
Selon les documents de lancement de Z.ai, GLM-5.3 est une déclinaison post-entraînée de son modèle de base de 743B paramètres. Ses capacités de programmation et d’agent seraient de premier plan grâce au post-entraînement, et non à une nouvelle architecture. L’annonce chinoise avance des données plus précises : des performances en code en hausse d’environ 50 % par rapport à GLM-5.2, la première place parmi les modèles ouverts sur Terminal-Bench 3.0, ainsi qu’une revue de code en boîte blanche au niveau de Mythos 5. Pour situer ce résultat, GLM-5.2 a obtenu 81,0 sur Terminal-Bench 2.1, selon les notes de version de Z.ai : c’était alors le meilleur score d’un modèle à poids ouverts, derrière les 85,0 de Claude Opus 4.8.
Les résultats de DeepSeek V4 Pro bénéficient, eux, d’une validation indépendante. Sa model card sur Hugging Face indique 80,6 % sur SWE-Bench Verified et 76,8 sur HumanEval Pass@1. L’évaluation CAISI du NIST a mesuré indépendamment 81 % sur SWE-Bench Verified. L’architecture repose sur un MoE de 1,6T paramètres, dont 49B actifs, avec un contexte de 1M tokens et une sortie maximale de 384K tokens.
| Critère | GLM-5.3 | DeepSeek V4 Pro |
|---|---|---|
| Architecture | Base de 743B, post-entraînée | MoE de 1,6T au total / 49B actifs |
| Fenêtre de contexte | Non précisée (GLM-5.2 : 1M) | 1M tokens |
| Sortie maximale | Non précisée (GLM-5.2 : 128K) | 384K tokens |
| Benchmark de programmation | N°1 des modèles ouverts sur Terminal-Bench 3.0 (affirmation éditeur) | 80,6 % sur SWE-Bench Verified (model card + NIST) |
| Cybersécurité | CyberGym 84,5 % ; revue en boîte blanche au niveau de Mythos 5 | Pas de positionnement équivalent |
| Poids ouverts | Promis après les évaluations de sécurité | Licence MIT, disponibles maintenant |
| API | Pas encore disponible | Disponible (officielle + SiliconFlow) |
Terminal-Bench et SWE-Bench sont deux benchmarks distincts, qui ne mesurent pas la même chose. Terminal-Bench évalue un agent exécutant des tâches dans un terminal ; SWE-Bench Verified note des correctifs automatisés sous forme de pull requests. Un rang sur Terminal-Bench 3.0 ne se compare donc pas directement à un pourcentage sur SWE-Bench Verified.
GLM-5.3 introduit aussi une dimension cybersécurité que DeepSeek V4 Pro ne met pas en avant. Z.ai le présente comme « ready for cyber defense », avec 84,5 % sur CyberGym. Ces résultats proviennent de l’éditeur et n’ont pas encore été vérifiés indépendamment : il faut donc les considérer comme des indicateurs, pas comme des conclusions établies. Z.ai affirme également que GLM-5.3 obtient de « meilleurs résultats avec moins de tokens en sortie » que GLM-5.2, ce qui réduirait le coût par tâche si cette efficacité se confirme lors de tests indépendants.
Abonnement ou paiement au token : la vraie question de coût
DeepSeek V4 Pro facture son API officielle au million de tokens :
| Type de token | API officielle DeepSeek |
|---|---|
| Entrée non mise en cache | $0.435 / M tokens |
| Entrée mise en cache | $0.003625 / M tokens |
| Sortie | $0.87 / M tokens |
GLM-5.3 n’est accessible que via l’abonnement GLM Coding Plan :
| Formule | Prix mensuel | Allocation |
|---|---|---|
| Lite | $18 | 10 000 crédits/semaine |
| Pro | $80 | 6× l’usage de Lite |
| Max | $168 | 14× l’usage de Lite |
Le GLM Coding Plan ne précise pas l’équivalence entre un « crédit » et un nombre de tokens, ce qui empêche une comparaison de coût exacte. DeepSeek facture au token, avec un engagement presque nul ; GLM Coding Plan applique un prix mensuel fixe, quel que soit le volume utilisé.
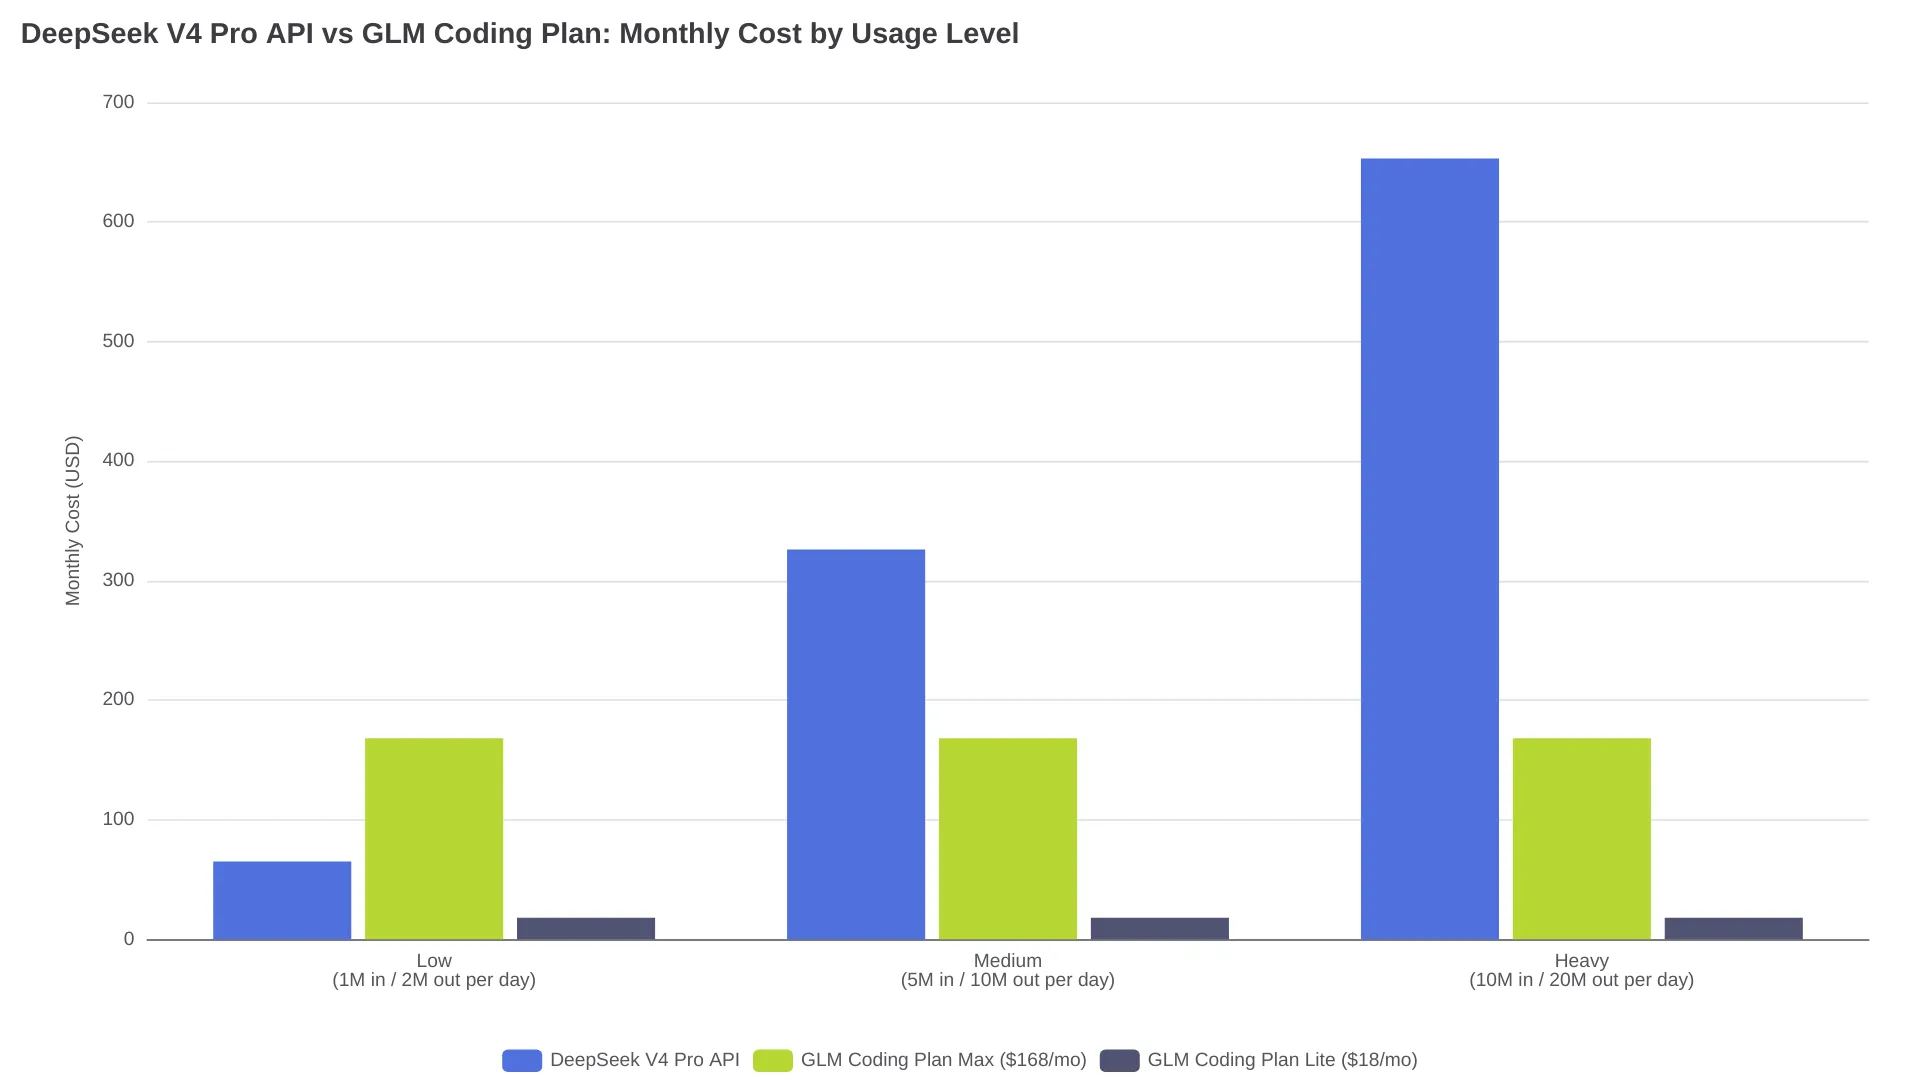
Exemple concret avec DeepSeek : pour 1M de tokens d’entrée non mis en cache et 2M de tokens de sortie par jour — une session de programmation modérée — l’API revient à environ $65/mois. À 5M de tokens d’entrée et 10M de tokens de sortie par jour, la facture atteint $326/mois. Les entrées en cache à $0.003625/M peuvent faire fortement chuter les coûts sur des bases de code répétitives. Côté GLM, la formule Max à $168/mois évite les surprises liées à la consommation, mais il est impossible de savoir si elle couvre la même charge de travail tant que la conversion crédits-tokens reste inconnue.
Ce que les développeurs rapportent sur Reddit
Dans un récent fil r/ZaiGLM, un utilisateur ayant testé les deux modèles résume ainsi son expérience :
« La tâche a été réalisée plus vite qu’avec GLM, mais elle a demandé nettement plus d’accompagnement. »
Le même fil rassemble des utilisateurs de workflows multi-modèles : GLM pour coder et naviguer dans les dépôts, DeepSeek V4 Flash pour les revues de code. Un autre participant rappelle que DeepSeek V4 Pro n’était disponible que depuis environ 24 heures et qu’il est trop tôt pour tirer des conclusions. Il s’agit de retours individuels issus d’un seul fil communautaire, pas de benchmarks contrôlés.
Quel modèle choisir selon votre cas d’usage ?
| Votre situation | Recommandation |
|---|---|
| Vous avez besoin d’une API ou d’une intégration CI/CD dès aujourd’hui | DeepSeek V4 Pro — GLM-5.3 n’a pas d’API publique |
| Vous souhaitez auto-héberger pour répondre à des contraintes de résidence des données | DeepSeek V4 Pro — poids MIT disponibles dès maintenant sur Hugging Face |
| Vous codez principalement dans un IDE et recherchez un assistant géré | GLM-5.3 via GLM Coding Plan ou ZCode |
| Vous êtes un développeur individuel avec un budget limité | DeepSeek V4 Pro est moins cher par token à faible volume ; GLM Lite ($18/mo) plafonne votre dépense quel que soit l’usage |
| Vous réalisez des audits de sécurité ou de la recherche de vulnérabilités | Testez d’abord GLM-5.3 — ses 84,5 % sur CyberGym sont uniques, mais pas encore vérifiés indépendamment |
| Vous faites du développement agentique à grande échelle avec de longues sessions | GLM Coding Plan Max ($168/mois fixe) plafonne le coût ; vérifiez que l’allocation de crédits couvre votre charge |
| Vous créez un prototype from scratch avec peu de code existant | L’un ou l’autre — les deux savent gérer du code neuf ; choisissez selon le mode d’accès qui vous convient |
Si vous utilisez déjà un GLM-5.2 Coding Plan, le passage à GLM-5.3 dans le même abonnement est la solution la plus simple. Si vous avez besoin de l’API de DeepSeek V4 Pro, notre guide de l’API GA de DeepSeek V4 Pro explique la configuration de l’endpoint et l’optimisation des coûts. Pour une comparaison plus large incluant la génération GLM précédente, consultez notre analyse GLM-5.2 vs DeepSeek V4 Pro.
FAQ
GLM-5.3 aura-t-il une API publique ?
Oui. Z.ai indique que l’accès API et les poids ouverts seront publiés progressivement après les évaluations de sécurité. Aucune date précise n’a été communiquée.
Puis-je auto-héberger l’un ou l’autre modèle ?
DeepSeek V4 Pro : oui. Les poids sous licence MIT sont disponibles sur Hugging Face. Ce MoE de 1,6T paramètres nécessite environ 3.2TB de VRAM sans quantification (FP16), ou ~800GB avec une quantification 4 bits : il faut donc un cluster multi-GPU composé de H100 ou de H200. GLM-5.3 : pas encore. Des poids ouverts sont promis après les évaluations de sécurité, mais la licence n’a pas été dévoilée.
Lequel coûte le moins cher pour coder intensivement chaque jour ?
Tout dépend du volume. Avec 1M de tokens d’entrée et 2M de tokens de sortie par jour, DeepSeek V4 Pro coûte environ $65/mois. Avec 5M de tokens d’entrée et 10M de tokens de sortie, la facture atteint $326/mois. GLM Coding Plan Max à $168/mois est moins cher à ce volume élevé, mais uniquement si son allocation de crédits non divulguée couvre la charge de travail. Testez les deux avec votre usage réel avant de vous engager.
GLM-5.3 prend-il en charge la vision ou les entrées image ?
Non. Z.ai réserve les capacités de vision à une gamme GLM-V distincte : GLM-5V-Turbo, GLM-4.6V et GLM-OCR. GLM-5.3 est un modèle de texte et de code. DeepSeek V4 Pro est lui aussi limité au texte.
La question est celle du timing, pas des capacités
Sur le papier, GLM-5.3 semble plus convaincant : 50 % de gains en programmation, un angle cybersécurité inédit et une meilleure efficacité en tokens. Mais tous ces chiffres proviennent d’une annonce de lancement vieille de quelques heures, sans API, sans poids ouverts ni validation indépendante des benchmarks. DeepSeek V4 Pro apporte aujourd’hui ce que GLM-5.3 ne peut pas encore offrir : disponibilité, benchmarks vérifiés et poids déployables. Utilisez DeepSeek dès maintenant si vous avez besoin d’une API ou d’auto-hébergement, puis surveillez la sortie de l’API GLM-5.3 pour les confronter sur votre propre base de code.