 AIREITER
Les $0.15 par million de tokens d’entrée ne racontent qu’une partie de l’histoire de GLM-5.3-Flash. Entre les hits de cache, les tokens générés, le raisonnement imposé et un checkpoint d’environ 320 milliards de paramètres, le bon choix entre API et poids ouverts dépend surtout du déploiement visé.
Les tarifs GLM-5.3-Flash actuellement en vigueur
La page tarifaire officielle de Z.AI affiche GLM-5.3-Flash à $0.15 par million de tokens d’entrée, $0.03 par million de tokens d’entrée servis depuis le cache et $0.50 par million de tokens de sortie. Une promotion temporaire de 50 % est également indiquée, jusqu’au 9 septembre 2026 à 24:00, heure UTC+8 (Singapour).
| Facturation GLM-5.3-Flash | Tarif catalogue / 1M tokens | Promotion / 1M tokens |
|---|---|---|
| Nouvelle entrée | $0.15 | $0.075 |
| Entrée en cache | $0.03 | $0.015 |
| Sortie | $0.50 | $0.25 |
| Stockage des entrées en cache | Gratuit pour une durée limitée | Gratuit pour une durée limitée |
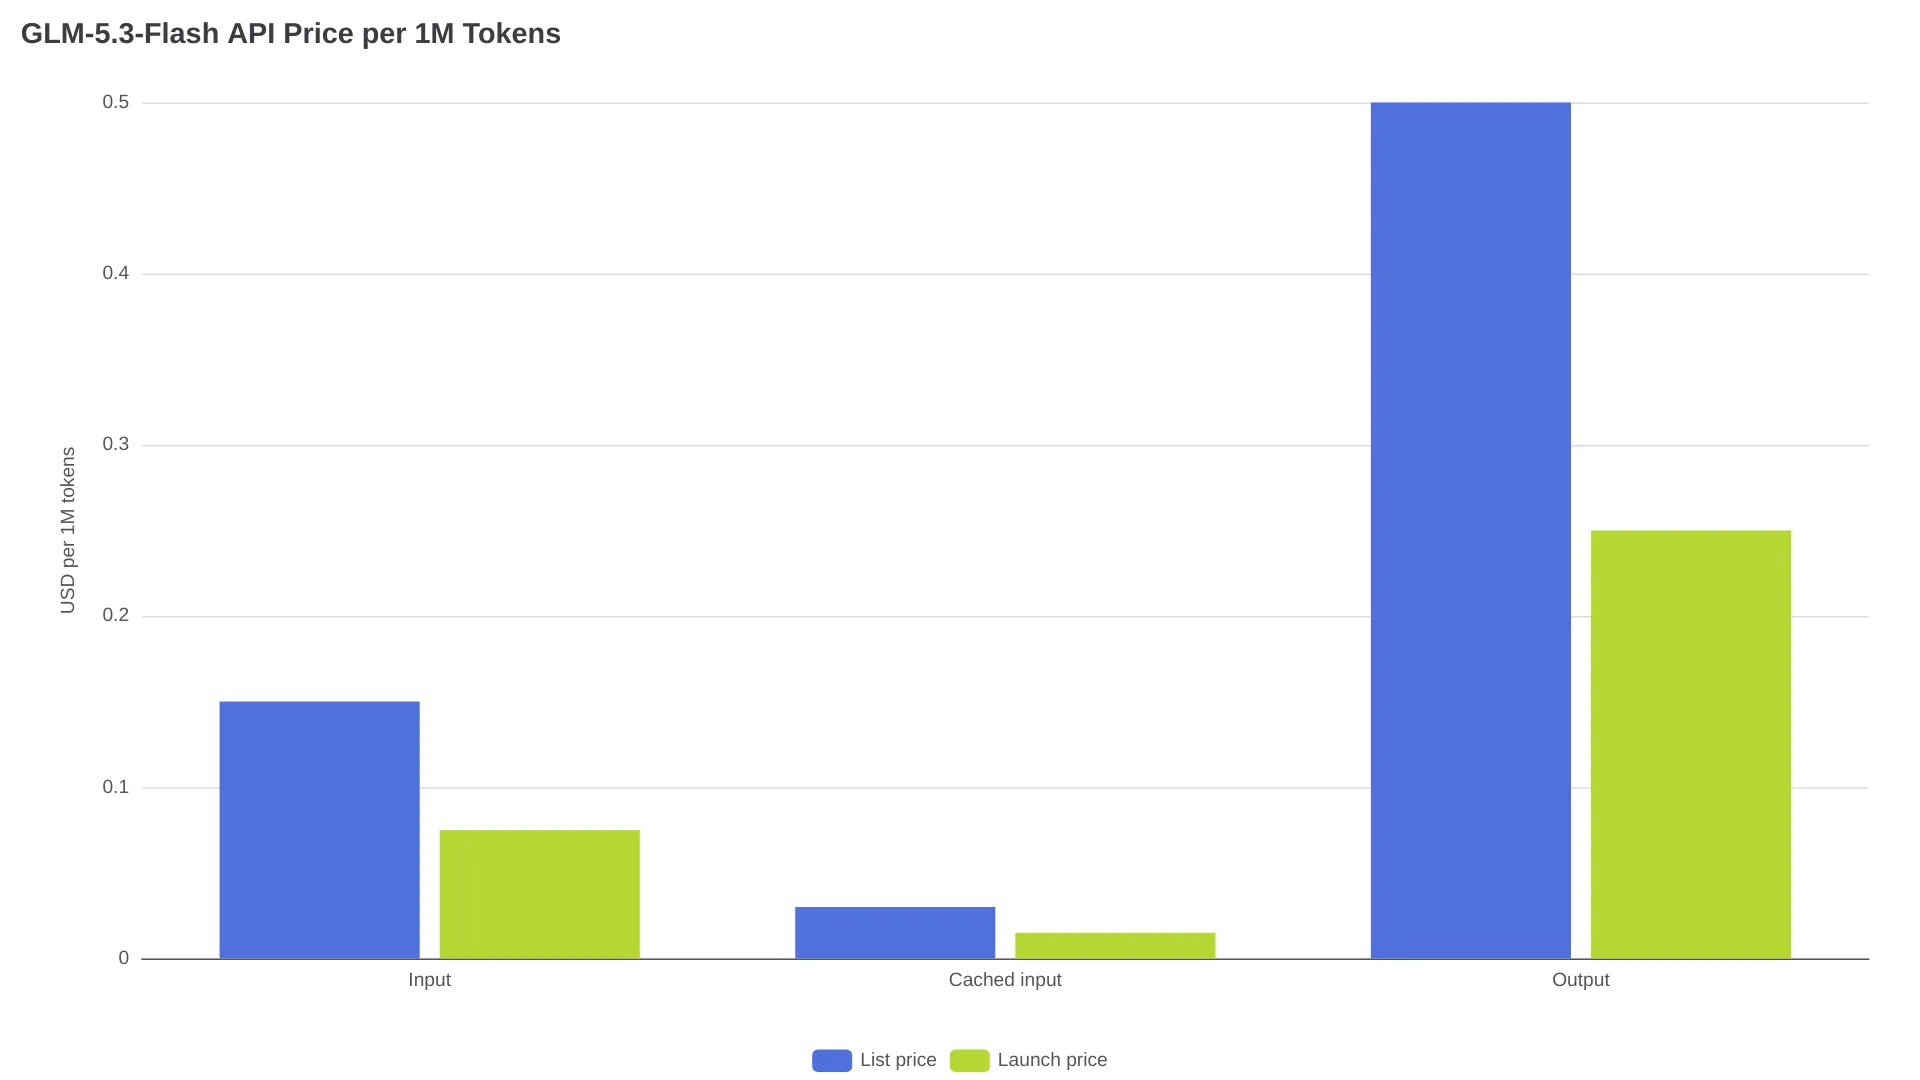
Il vaut mieux considérer cette baisse de 50 % comme un tarif promotionnel temporaire, et non comme la base d’un budget de production. Dans son annonce de lancement, Z.AI précise que ox-alpha était son identifiant de préversion.
Le même tableau officiel facture GLM-5.3 standard à $1.40 pour l’entrée, $0.26 pour l’entrée en cache et $4.40 pour la sortie, par million de tokens. Aux tarifs catalogue, Flash coûte environ 89 % de moins, tant pour l’entrée que pour la sortie. C’est une comparaison de prix, pas l’affirmation que les deux modèles offrent la même qualité, la même latence ou le même comportement opérationnel.
Vous achetez un accès API, pas un petit modèle local
GLM-5.3-Flash est un modèle multimodal à poids ouverts, sous licence MIT, avec 320B de paramètres au total et 18B de paramètres actifs par token. La model card officielle sur Hugging Face documente le checkpoint public zai-org/GLM-5.3-Flash ainsi que les options de service local. De son côté, Z.AI annonce une fenêtre de contexte d’un million de tokens et des entrées texte, image et vidéo.
Les « 18B actifs » désignent le calcul effectué par les experts sélectionnés, pas la mémoire totale requise. Les poids complets, le cache KV, les surcoûts du runtime, le traitement multimodal et la longueur du contexte restent déterminants pour un déploiement local.
| Voie d’accès | Ce qu’elle apporte | Contrainte principale |
|---|---|---|
| API Z.AI | Inférence hébergée, facturée selon les tokens d’entrée, d’entrée en cache et de sortie | Limites de compte et latence liée au raisonnement |
| Checkpoint officiel | Poids sous licence MIT pour l’auto-hébergement ou l’adaptation | Infrastructure très gourmande en mémoire, selon la précision et la quantification |
| Build communautaire quantifié | Fichiers plus compacts pour certains runtimes locaux | Qualité du build, prise en charge des modalités, vitesse et compatibilité variables |
Un prix au token faible et un coût d’hébergement faible sont deux affirmations distinctes : avec une charge irrégulière, l’API ne coûte que lorsque le trafic arrive, tandis que l’auto-hébergement réserve de la capacité même pendant les périodes creuses.
Ce que coûte réellement une charge API
Le coût de GLM-5.3-Flash dépend de la répartition entre nouvelles entrées, entrées reconnues dans le cache et sorties générées :
cost = (new_input_tokens / 1,000,000 × input_rate)
     + (cached_input_tokens / 1,000,000 × cached_rate)
     + (output_tokens / 1,000,000 × output_rate)
Au tarif catalogue, 10 millions de nouveaux tokens d’entrée et 2 millions de tokens de sortie reviennent à $2.50 : $1.50 pour l’entrée et $1.00 pour la sortie. Pendant la promotion, le même volume coûte $1.25.
| Charge | Calcul au tarif catalogue | Total catalogue | Total promotionnel |
|---|---|---|---|
| 10M de nouvelles entrées + 2M de sorties | $1.50 + $1.00 | $2.50 | $1.25 |
| 2M de nouvelles entrées + 8M d’entrées en cache + 2M de sorties | $0.30 + $0.24 + $1.00 | $1.54 | $0.77 |
| 100K de nouvelles entrées + 10K de sorties | $0.015 + $0.005 | $0.020 | $0.010 |
Le chiffre de $0.10 par million de tokens en coût moyen, affiché par Artificial Analysis, repose sur une répartition définie de 7:2:1 entre hit de cache, entrée et sortie. C’est utile pour comparer une charge précise, pas comme tarif universel de GLM-5.3-Flash.
Les économies de cache exigent un vrai hit. Le schéma de réponse Chat Completion de Z.AI expose usage.prompt_tokens_details.cached_tokens. En production, il faut donc enregistrer ce champ plutôt que de supposer que des prompts ressemblants bénéficieront d’une remise. Un utilisateur de r/opencodeCLI a résumé ainsi l’économie du lancement :
« There's a 50% discount offer until September 9th, and its context consumption is much better than in dsv4f... » — u/CriteriumA, discussion Reddit
La date de fin de promotion est confirmée par la grille tarifaire de Z.AI ; la comparaison et le retour d’expérience relèvent de l’opinion de ce commentateur. Un contexte stable et répété peut améliorer la réutilisation du cache, sans faire disparaître les coûts de sortie, de retry, d’outils ou de limites de compte.
Une grille simple pour établir le budget
Prévoyez quatre lignes distinctes : nouvelle entrée, entrée en cache, sortie et outils payants. Z.AI facture Web Search à $0.01 par utilisation : des recherches répétées par un agent peuvent donc dépasser une estimation limitée aux tokens.
| Hypothèse d’usage mensuel | Formule au tarif catalogue | Coût mensuel |
|---|---|---|
| 100M de nouvelles entrées + 20M de sorties | 100 × $0.15 + 20 × $0.50 | $25.00 |
| 20M de nouvelles entrées + 80M d’entrées en cache + 20M de sorties | 20 × $0.15 + 80 × $0.03 + 20 × $0.50 | $23.40 |
| 100 appels Web Search | 100 × $0.01 | $1.00 |
Ces calculs sont des exemples arithmétiques, pas un quota. Ajoutez séparément les retries et les exécutions d’agents abandonnées. Lorsque le volume de sortie est élevé, définir une valeur réaliste pour max_tokens et réduire reasoning_effort quand cela convient peut peser davantage que l’optimisation d’un petit préfixe de prompt.
Les contraintes de l’API Z.AI à vérifier avant une migration
L’API officielle de Z.AI utilise https://api.z.ai/api/paas/v4/ comme URL de base générale et https://api.z.ai/api/paas/v4/chat/completions pour les chat completions. L’authentification repose sur une clé API Bearer. Dans son introduction à l’API, Z.AI documente des modèles de clients Python, Node.js et Java compatibles OpenAI, via une URL de base personnalisée.
La référence Chat Completion actuelle cite GLM-5.3-FLASH dans les descriptions du thinking et du raisonnement, mais son enum de modèles affiché ne montre pas glm-5.3-flash. La page de prix officielle et les documents de lancement listent bien le SKU Flash. Testez l’identifiant exact du modèle hébergé avec une petite requête avant de basculer le trafic de production.
| Détail d’intégration | Contrainte vérifiée |
|---|---|
| Identifiant de modèle hébergé à tester | glm-5.3-flash ; confirmer son acceptation avec le schéma en direct du compte |
| Endpoint hébergé | https://api.z.ai/api/paas/v4/chat/completions |
| Authentification | Authorization: Bearer YOUR_API_KEY |
| Thinking | GLM-5.3-FLASH utilise le thinking activé ; sa profondeur se règle avec reasoning_effort |
| Effort de raisonnement | low, high ou max |
Maximum de max_tokens | 131,072 dans la référence actuelle des paramètres |
| Coding Plan | Clé, endpoints et système de crédits distincts ; ce n’est pas un solde API général. Voir le guide de démarrage rapide Coding Plan de Z.AI |
Z.AI définit max comme niveau par défaut pour l’effort de raisonnement. Le tarif au token ne varie pas avec ce réglage, mais le raisonnement peut modifier la consommation de sortie et le temps d’attente. Pour les limites de compte, Z.AI renvoie vers un tableau de bord des rate limits propre à chaque compte ; ses indications publiques ne donnent pas de plafond chiffré universel pour tous les comptes API.
Poids ouverts ou API hébergée : choisir le mode de déploiement
La model card officielle fournit des recettes de service local avec Transformers, vLLM, SGLang, TokenSpeed et KTransformers, mais ces recettes ne démontrent pas qu’un déploiement pratique soit possible sur un GPU grand public.
L’API hébergée est le choix logique pour un trafic intermittent ou en l’absence de matériel d’inférence à forte capacité mémoire. Un service distribué ou local devient à envisager lorsque l’utilisation est soutenue, ou que le contrôle du traitement des données justifie son coût opérationnel. Un build texte à précision réduite ne reproduira pas forcément la configuration multimodale officielle.
À partir de quand l’auto-hébergement devient pertinent
Une estimation de GetDeploying évalue un déploiement 4-bit à environ 192 GB de mémoire GPU, contre environ 384 GB en 8-bit et 768 GB en BF16. Elle chiffre une configuration MI300X à $2.90 par heure à environ $2,088 par mois en fonctionnement continu, avec un point de parité API/auto-hébergement proche de 14 millions de tokens par heure dans un ratio entrée/sortie de 5:1.
Il s’agit d’estimations tierces, et non de garanties matérielles de Z.AI. La configuration 4-bit de 192 GB est qualifiée de serrée ; le cache KV, les surcoûts du runtime, le traitement multimodal, le batching et les temps creux peuvent déplacer le seuil de rentabilité. Avant de choisir l’inférence locale, comparez le coût d’infrastructure horaire, le taux d’utilisation, les tokens effectifs par heure, le taux de hit du cache et le coût par tâche achevée.
GLM-5.3-Flash ou GLM-5.3 : où se situe le choix
Flash et GLM-5.3 standard ont des grilles tarifaires et des positionnements de déploiement distincts.
| Question | GLM-5.3-Flash | GLM-5.3 |
|---|---|---|
| Prix catalogue d’entrée | $0.15 / 1M | $1.40 / 1M |
| Entrée en cache au tarif catalogue | $0.03 / 1M | $0.26 / 1M |
| Prix catalogue de sortie | $0.50 / 1M | $4.40 / 1M |
| Promotion temporaire | 50 % de réduction jusqu’au 9 septembre 2026 UTC+8 | Aucune promotion Flash équivalente affichée |
| Checkpoint à poids ouverts | Checkpoint officiel sous licence MIT listé | Fiche modèle distincte ; ne pas en déduire des poids identiques |
| Positionnement multimodal | Multimodal natif ; entrées image/vidéo décrites par Z.AI | Évaluer séparément la couverture de GLM-5.3 standard |
| Déploiement local | Grand checkpoint et infrastructure de service à forte mémoire requis | Consulter sa propre documentation de modèle et de déploiement |
Commencez par Flash lorsque le coût des tokens, les entrées multimodales ou une option à poids ouverts comptent, et que l’application peut composer avec le raisonnement imposé et les contraintes du fournisseur. Ne choisissez GLM-5.3 standard qu’après avoir vérifié si son tarif supérieur apporte un gain de capacité ou de fiabilité réellement utile à l’application.
FAQ
Quel est le prix actuel de l’API GLM-5.3-Flash ?
Les tarifs officiels catalogue sont de $0.15 pour l’entrée, $0.03 pour l’entrée en cache et $0.50 pour la sortie, par million de tokens ; le tableau ci-dessus présente les prix temporaires à -50 %.
Les entrées en cache sont-elles facturées au tarif de $0.03 ?
Oui, lorsque Z.AI reconnaît les tokens comme étant en cache. Le stockage des entrées en cache est listé séparément comme gratuit pour une durée limitée : il ne faut donc pas confondre le statut du stockage et la facturation d’un hit de cache.
GLM-5.3-Flash est-il open source ?
La description exacte est : un checkpoint à poids ouverts sous licence MIT. La licence autorise de larges usages, mais le modèle de 320B de paramètres au total demande toujours beaucoup de mémoire, des logiciels compatibles et une capacité de service conséquente.
Puis-je exécuter GLM-5.3-Flash sur un ordinateur portable classique ?
Pas dans le cadre réaliste d’un déploiement complet en pleine précision. Même les estimations tierces en 4-bit tournent autour de 192 GB de mémoire GPU, et les 18B de paramètres actifs n’éliminent ni le coût de stockage ni le coût d’exécution du checkpoint complet.
GLM-5.3-Flash est-il plus rapide que GLM-5.3 ?
Le positionnement « Flash » est étayé par le coût et le calcul actif, pas par une garantie universelle de latence. Artificial Analysis rapporte 48.7 tokens de sortie par seconde via Z.AI et 42.57 secondes avant le premier token de réponse dans sa configuration mesurée ; le temps de raisonnement et la forme de la charge peuvent dominer le temps de réponse perçu.
Le Coding Plan donne-t-il accès au même solde API ?
Non. Le guide de démarrage rapide Coding Plan de Z.AI décrit une clé Coding Plan distincte, des endpoints séparés et un accès limité aux outils et produits officiellement pris en charge. Un abonnement Coding Plan ne doit pas être converti directement en budget d’API publique exprimé en dollars par token.
L’API est l’option la moins risquée lorsque le trafic est intermittent et que le matériel n’est pas déjà amorti ; le service local répond à une autre logique économique, fondée sur une utilisation soutenue, la mémoire disponible et les exigences de contrôle des données.