 AIREITER
Gemini 3.5 Flash produit 2,6 fois plus de tokens de sortie par seconde que Gemini 3.1 Pro, coûte 25 % moins cher par token et devance légèrement Pro dans l’Intelligence Index d’Artificial Analysis (50 contre 46). Mais Gemini 3.1 Pro conserve 5 points d’avance sur ARC-AGI-2 (77,1 % contre 72,1 %), tandis que le score de Flash en recherche dans un long contexte recule de 84,9 % à 77,3 % au-delà de 128k tokens. Le bon choix dépend donc avant tout de la charge de travail : Flash privilégie le débit et la latence des appels d’outils, Pro la profondeur de raisonnement en plusieurs étapes. Les benchmarks agrégés condensent ces deux priorités en un score unique, au risque de masquer celle qui compte réellement pour votre usage.
Benchmarks : les domaines où chaque modèle prend l’avantage
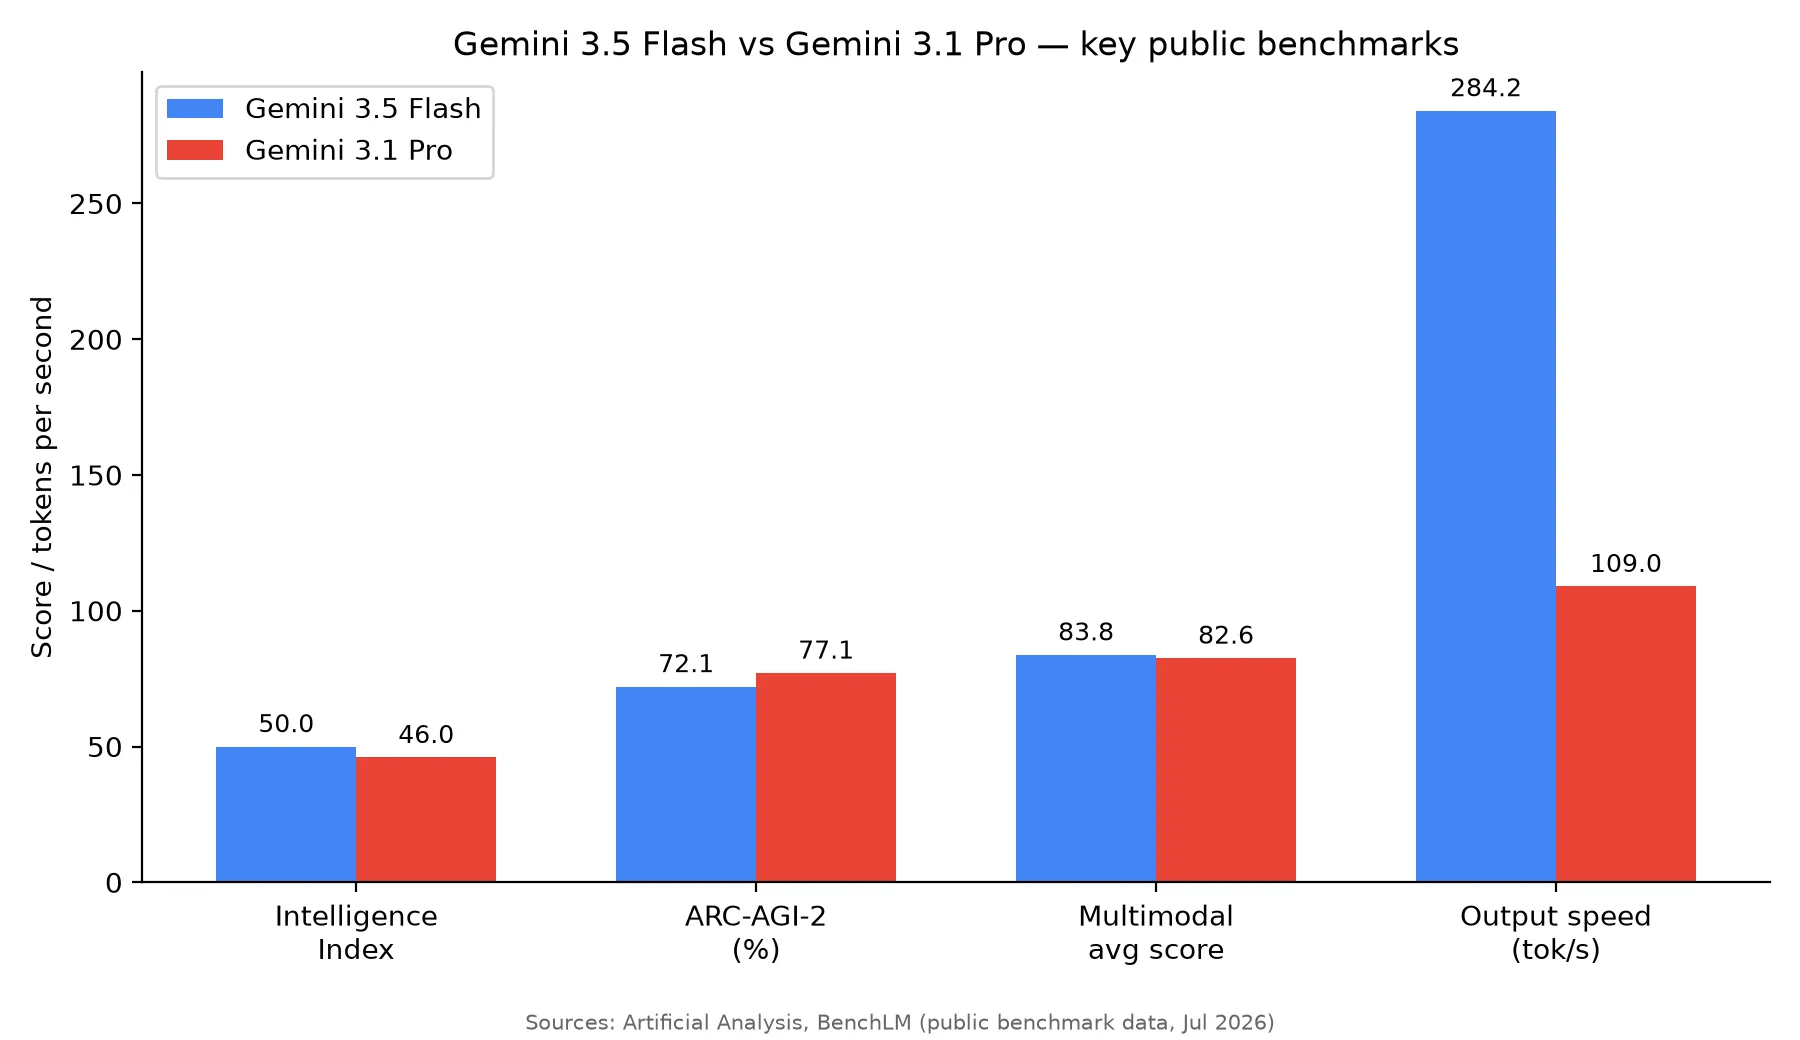
| Métrique | Gemini 3.5 Flash | Gemini 3.1 Pro | Gagnant |
|---|---|---|---|
| Intelligence Index (Artificial Analysis) | 50 | 46 | Flash |
| ARC-AGI-2, raisonnement abstrait (BenchLM) | 72,1 % | 77,1 % | Pro |
| MRCR v2 avec 128k de contexte (nxcode) | 77,3 % (contre 84,9 % avec un contexte plus court) | non communiqué publiquement à cette longueur | Données insuffisantes |
| Score multimodal moyen (BenchLM) | 83,8 | 82,6 | Flash |
| Vitesse de sortie (BenchLM) | 284,2 tok/s | 109 tok/s | Flash (2,6x) |
| GDPval-AA Elo, tâches d’agents en conditions réelles (apiyi) | 1656 | 1314 | Flash |
Flash domine les indicateurs de débit et de gestion de tâches généralistes. Pro affiche en revanche une avance nette et documentée sur la profondeur de raisonnement via ARC-AGI-2. Pour la recherche dans de très longs contextes, Flash accuse une baisse documentée au-delà de 128k tokens, mais le score équivalent de Pro n’est pas public : il faut donc considérer ce point comme non tranché, et non comme une victoire de Pro. Cette distinction est bien plus utile que le seul score agrégé de l’Intelligence Index lorsqu’il s’agit de choisir un modèle pour une tâche donnée.
Une réserve méthodologique signalée par BenchLM dans sa propre comparaison : sur les quelque 34 benchmarks pour lesquels les deux modèles ont des résultats publiés, seules 3 catégories sont directement comparables. Pro dispose de résultats exclusifs sur 14 benchmarks, Flash sur 17, et les réglages de budget de raisonnement ne sont pas toujours identiques. Le tableau ci-dessus donne donc une orientation fiable, mais sans prétendre à une précision absolue : les écarts sur ARC-AGI-2 et MRCR v2 sont suffisamment marqués pour être pris au sérieux ; un différentiel de 1 à 2 points sur une métrique partagée ne doit pas être jugé décisif.
Les limites de l’avantage de Flash
L’écart de 5 points sur ARC-AGI-2 est la plus forte différence observée par BenchLM entre les deux modèles dans une même catégorie. ARC-AGI-2 est précisément conçu pour résister aux raccourcis de reconnaissance de motifs : un écart de 5 points y constitue donc un signal plus pertinent sur la profondeur de raisonnement qu’un écart similaire dans un benchmark plus classique. Le résultat MRCR v2 de nxcode va dans le même sens : la précision de récupération de Flash tombe de 84,9 % à 77,3 % à mesure que le contexte approche 128k tokens. Le score de Pro à cette longueur n’est pas public ; il ne s’agit donc pas d’une défaite directe et documentée de Flash face à Pro, mais bien d’une régression constatée chez Flash, absente du tableau de benchmarks de Pro.
Retour d’expérience, pas donnée de benchmark : dans un fil Reddit r/GeminiAI demandant aux utilisateurs quel modèle ils préfèrent pour les tâches difficiles, plusieurs commentaires décrivent Flash comme meilleur que Pro « sur tout, sauf le long contexte et le raisonnement abstrait ». Ce ne sont que quelques avis, pas des données. Ils recoupent toutefois les deux exceptions mises en évidence par les benchmarks, ce qui en fait un contrôle de cohérence modérément utile, sans constituer une preuve à lui seul.
Prix et cache : le coût réel à prendre en compte
À première vue, l’écart tarifaire de base est moins important qu’il n’y paraît :
- Gemini 3.5 Flash : $1.50 / million de tokens en entrée, $9 / million de tokens en sortie
- Gemini 3.1 Pro : $2 / million de tokens en entrée, $12 / million de tokens en sortie
Sur le papier, Flash est donc 25 % moins cher, loin de l’écart de 4 à 8 fois qu’il avait auparavant face aux anciens modèles Pro. Le cache est le principal facteur de différenciation :
- Les écritures en cache de Flash sont gratuites ; les entrées servies depuis le cache coûtent $0.15/million de tokens
- Les écritures en cache de Pro coûtent $0.38/million de tokens ; les entrées en cache coûtent $0.50/million de tokens — soit plus de 3 fois le tarif d’entrée en cache de Flash
Dans tout workflow qui renvoie le même prompt système ou le même contexte documentaire sur plusieurs tours — agents conversationnels, assistants de code avec contexte de base de code persistant, bots de support multi-tour — cet écart de cache s’accumule vite. La différence reste discrète sur une requête unique ; elle ne l’est plus sur une session d’agent de mille tours.
L’écart n’est pas non plus constant. L’analyse tarifaire d’apiyi indique qu’au-delà d’environ 200k tokens de contexte, la différence de prix entre les deux modèles se resserre à 25-50 %, car leur économie par token converge à cette échelle. Si votre charge est surtout composée de très longs documents traités en une seule requête, plutôt que de courts appels répétés, l’argument tarifaire en faveur de Flash perd de son poids.
Exemple concret : imaginons un bot de support qui envoie chaque jour 1M de tokens d’entrée mis en cache et génère 500K tokens de sortie. Avec Flash, cela représente $0 pour l’écriture du cache, plus $0.15 x 1 pour l’entrée en cache et $9 x 0.5 pour la sortie, soit $4.65/jour. Avec Pro, la même charge coûte $0.38 pour l’écriture du cache, à payer une fois, plus $0.50 x 1 pour l’entrée en cache et $12 x 0.5 pour la sortie : environ $6.88/jour le premier jour, puis $6.50/jour après la première écriture. Sur un mois, on passe ainsi d’environ $140 à $195 — avant même de tenir compte du raisonnement plus poussé de Pro sur les requêtes qui en ont réellement besoin.
Boucles d’agents : Flash gagne en vitesse, pas toujours en fiabilité
Le benchmark de boucles d’agents de nxcode a exécuté une séquence de 8 étapes : Flash l’a terminée en environ 25 secondes, contre 100 secondes pour Pro. Un écart de 4x qui s’amplifie à chaque étape supplémentaire. Sur GDPval-AA, un benchmark axé sur des tâches d’agents de travail intellectuel en conditions réelles, le score Elo de Flash (1656) dépasse celui de Pro (1314) de 342 points, soit le plus grand écart de tout le tableau de benchmarks.
La réserve est la suivante : cet avantage de vitesse et de score suppose que la boucle de l’agent se déroule sans incident. Les écarts observés sur ARC-AGI-2 et MRCR v2, pour le raisonnement et les tâches à long contexte, permettent raisonnablement de penser que Flash est aussi moins tolérant lorsqu’un appel d’outil renvoie un résultat inattendu en cours de boucle et que l’agent doit revoir son plan. C’est une inférence tirée des données de profondeur de raisonnement ci-dessus, pas une affirmation mesurée par un benchmark distinct. Si un humain supervise l’agent et vérifie les sorties entre les étapes, la vitesse de Flash est presque un avantage gratuit. Si l’agent opère sans supervision sur de nombreuses étapes, Pro reste le choix le plus prudent grâce à sa marge de raisonnement, en attendant des données publiées sur les taux d’échec des deux modèles.
Quel modèle choisir selon votre tâche ?
| Type de tâche | Modèle recommandé | Pourquoi |
|---|---|---|
| Développement quotidien : tests, revue de PR, traduction entre langages | Flash | Avantage de vitesse et de coût ; la profondeur de raisonnement n’est pas le facteur limitant |
| Refactorings profonds, conception de nouveaux algorithmes | Pro | L’écart sur ARC-AGI-2 se retrouve directement dans le raisonnement logique multi-étapes |
| Recherche dans de longs documents : contrats, corpus de recherche au-delà de 128k tokens | Pro | Flash présente une régression MRCR v2 documentée à cette longueur ; le score de Pro n’est pas publié, mais le choix le plus sûr est le modèle sans faiblesse connue |
| Génération par lots à fort volume | Flash | Les écritures de cache gratuites et un débit 2,6x supérieur comptent le plus à grande échelle |
| Workflows d’agents supervisés avec validation humaine | Flash | Avantage de vitesse sans le risque de fiabilité lié à une exécution non supervisée |
| Chaînes d’agents autonomes et à forts enjeux | Pro | Sa marge en profondeur de raisonnement est plus rassurante lorsqu’aucun humain ne peut intercepter les erreurs en cours de boucle |
| Appels multi-tour fréquents réutilisant le même contexte | Flash | Le tarif des entrées en cache représente environ un tiers de celui de Pro |
Une règle simple couvre la plupart des cas ci-dessus : envoyez les requêtes vers Flash, sauf dans trois situations — le contexte dépasse 128k tokens et la précision de recherche est importante ; la tâche exige un raisonnement abstrait ou multi-étapes, comme de nouveaux algorithmes ou une synthèse juridique ou scientifique ; l’agent fonctionne sans supervision pendant plus de quelques étapes. Dès qu’une de ces conditions est remplie, Pro devient le choix à privilégier. En leur absence, la vitesse de Flash et ses tarifs de cache en font l’option par défaut la moins coûteuse.
FAQ
Gemini 3.5 Flash est-il meilleur que 3.1 Pro ?
Oui pour la vitesse, le coût et les benchmarks généralistes. En raisonnement abstrait, sur ARC-AGI-2, Gemini 3.1 Pro garde 5 points d’avance. Pour la recherche dans un long contexte au-delà de 128k tokens, Flash affiche une régression documentée alors que le score équivalent de Pro n’est pas publié : il faut donc considérer cette comparaison comme non résolue, plutôt que comme un avantage confirmé pour Pro. Le modèle « meilleur » dépend de la catégorie dans laquelle se situe votre tâche.
Gemini 3.5 Flash est-il beaucoup moins cher que 3.1 Pro ?
Il coûte environ 25 % moins cher sur les tarifs de base en entrée et en sortie ($1.50/$9 contre $2/$12 par million de tokens). Les économies les plus importantes viennent du cache : les écritures de cache de Flash sont gratuites et les entrées mises en cache reviennent à environ un tiers du tarif de Pro, ce qui compte surtout pour les charges multi-tour ou à haut volume.
Gemini 3.5 Flash est-il adapté au développement ?
Oui, pour les usages courants : génération de tests, revue de PR ou traduction de code entre langages. Pour les refactorings complexes ou la conception de nouveaux algorithmes, l’avantage de Pro sur les benchmarks de raisonnement abstrait tend à se traduire par une meilleure qualité de sortie.
Gemini 3.5 Flash gère-t-il bien les longs contextes ?
Oui sur des contextes plus courts : la précision de récupération MRCR v2 se maintient à 84,9 %. Au-delà de 128k tokens, elle tombe à 77,3 %, un écart significatif pour des tâches comme l’analyse de contrats répartis sur plusieurs documents. Le score de Gemini 3.1 Pro à cette même longueur n’a pas été publié : il faut donc y voir une limite connue de Flash, et non un avantage confirmé de Pro.
En résumé
Gemini 3.5 Flash est le meilleur choix par défaut pour la plupart des tâches quotidiennes et à fort volume : il est plus rapide, plus économique côté cache, et suffisamment proche sur les benchmarks généralistes pour que le compromis ait rarement de l’importance. Gemini 3.1 Pro justifie son coût plus élevé pour le raisonnement abstrait et les chaînes d’agents autonomes. Sur les documents de plus de 128k tokens, les propres chiffres de Flash révèlent une faiblesse que ceux de Pro ne permettent ni de confirmer ni d’écarter ; mieux vaut donc tester les deux avant de vous engager.
Cette comparaison s’appuie sur des données de benchmarks publiques (Artificial Analysis, BenchLM, nxcode et apiyi), et non sur des tests API réalisés directement. Gemini 3.1 Pro a été lancé avec un positionnement centré sur le raisonnement, distinct de l’orientation vitesse de Flash. À l’heure où nous écrivons ces lignes, Gemini 3.5 Pro n’est pas encore disponible ; des informations publiées évoquent une sortie en juillet 2026. Il s’agit donc d’un instantané : les deux modèles, comme cette comparaison, devront être réévalués à l’arrivée de la prochaine version de Pro.