 AIREITER
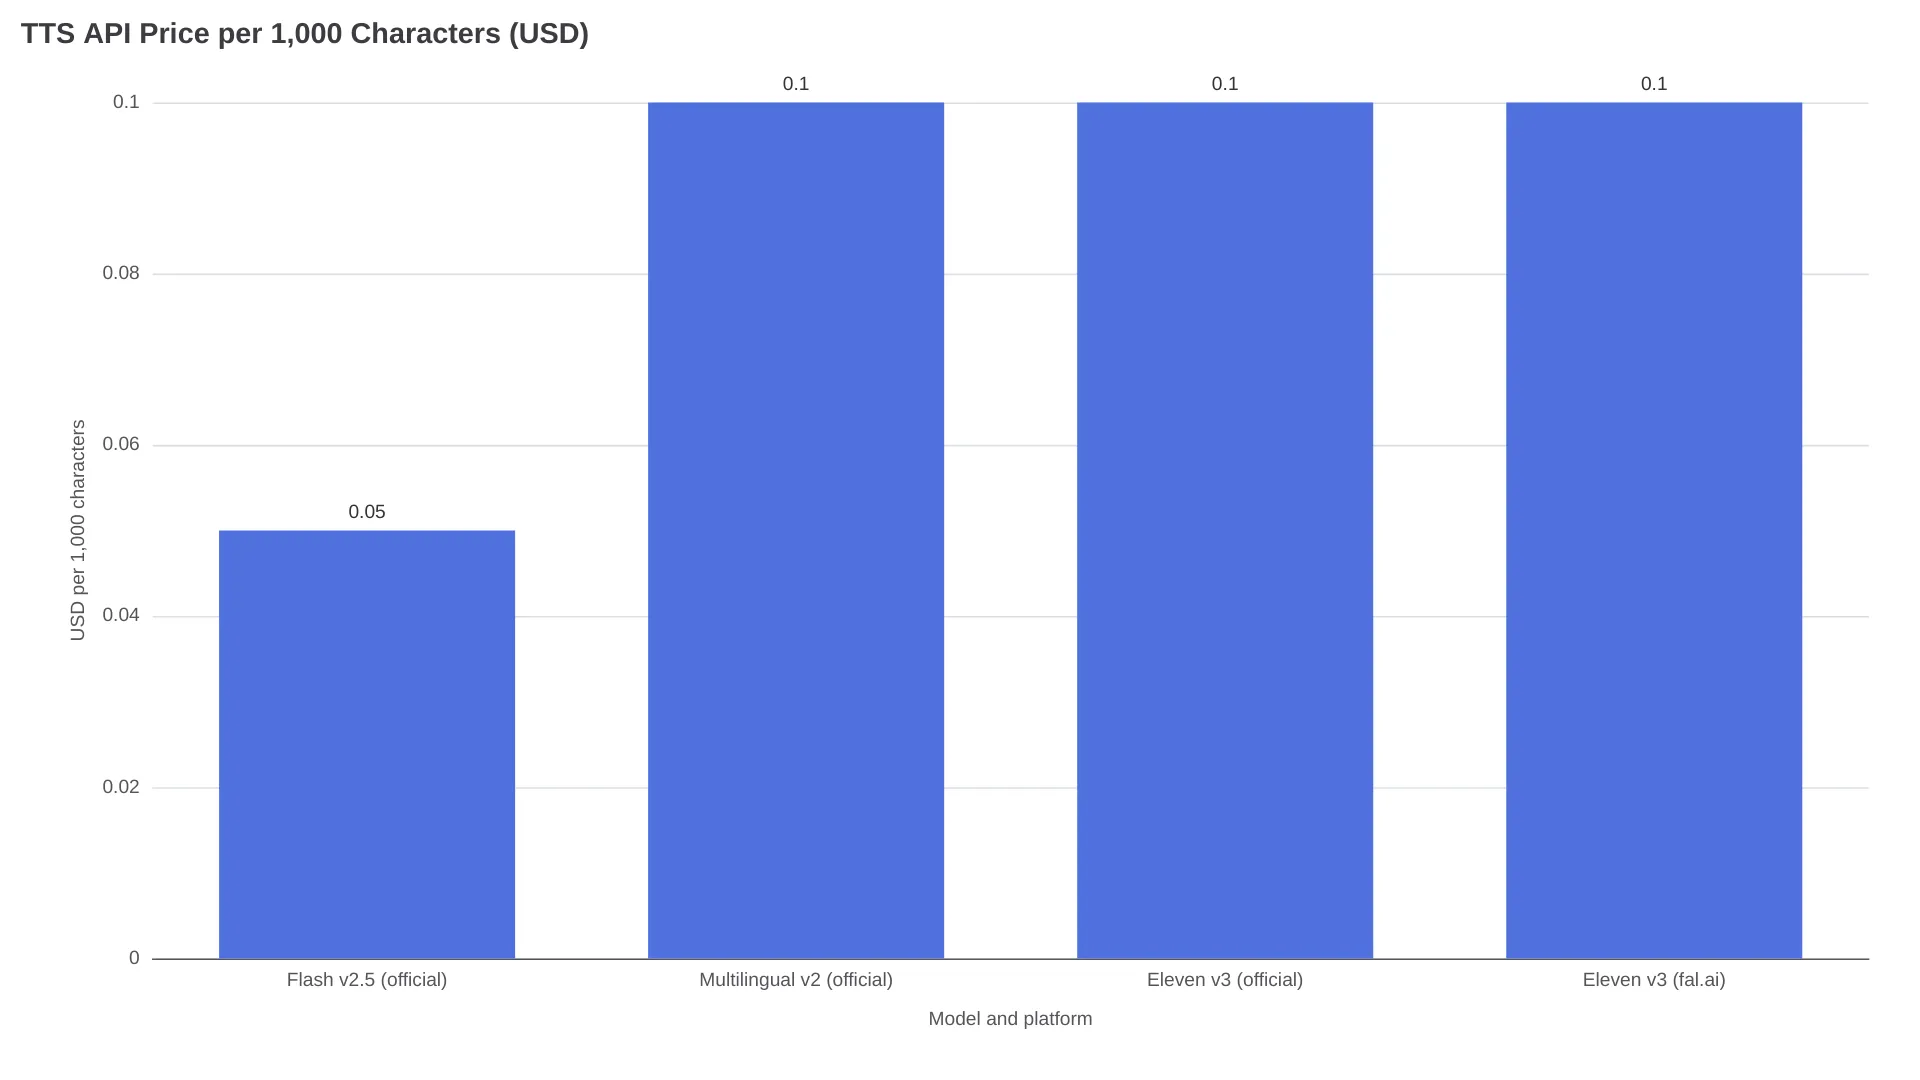
Depuis la sortie d’Eleven v3 de sa phase alpha le 2 février 2026, l’identifiant à utiliser dans l’API ElevenLabs est eleven_v3. ElevenLabs comme fal.ai facturent 0,10 $ par 1 000 caractères : le tarif unitaire ne permet donc pas de trancher. Le choix se joue plutôt sur le mode de facturation, la concurrence et l’accès aux voix. La disponibilité générale a aussi corrigé des problèmes concrets : d’après l’annonce de GA, le taux d’erreurs sur les textes structurés est passé de 15,3 % à 4,9 % dans un benchmark de 27 catégories et 8 langues. Restez toutefois dans deux limites strictes : 5 000 caractères par requête, et un modèle que son propre éditeur juge inadapté au temps réel.
Ce que propose réellement l’API ElevenLabs Eleven v3
L’API Eleven v3 couvre quatre usages : génération de parole, génération en streaming, ainsi que des endpoints distincts pour créer et diffuser en streaming des dialogues multi-locuteurs. Le modèle prend en charge plus de 70 langues et accepte des balises audio intégrées au texte pour diriger l’émotion et l’interprétation. À sa disponibilité générale, il était suffisamment stable pour qu’ElevenLabs le préfère à la version alpha dans 72 % de ses propres tests.
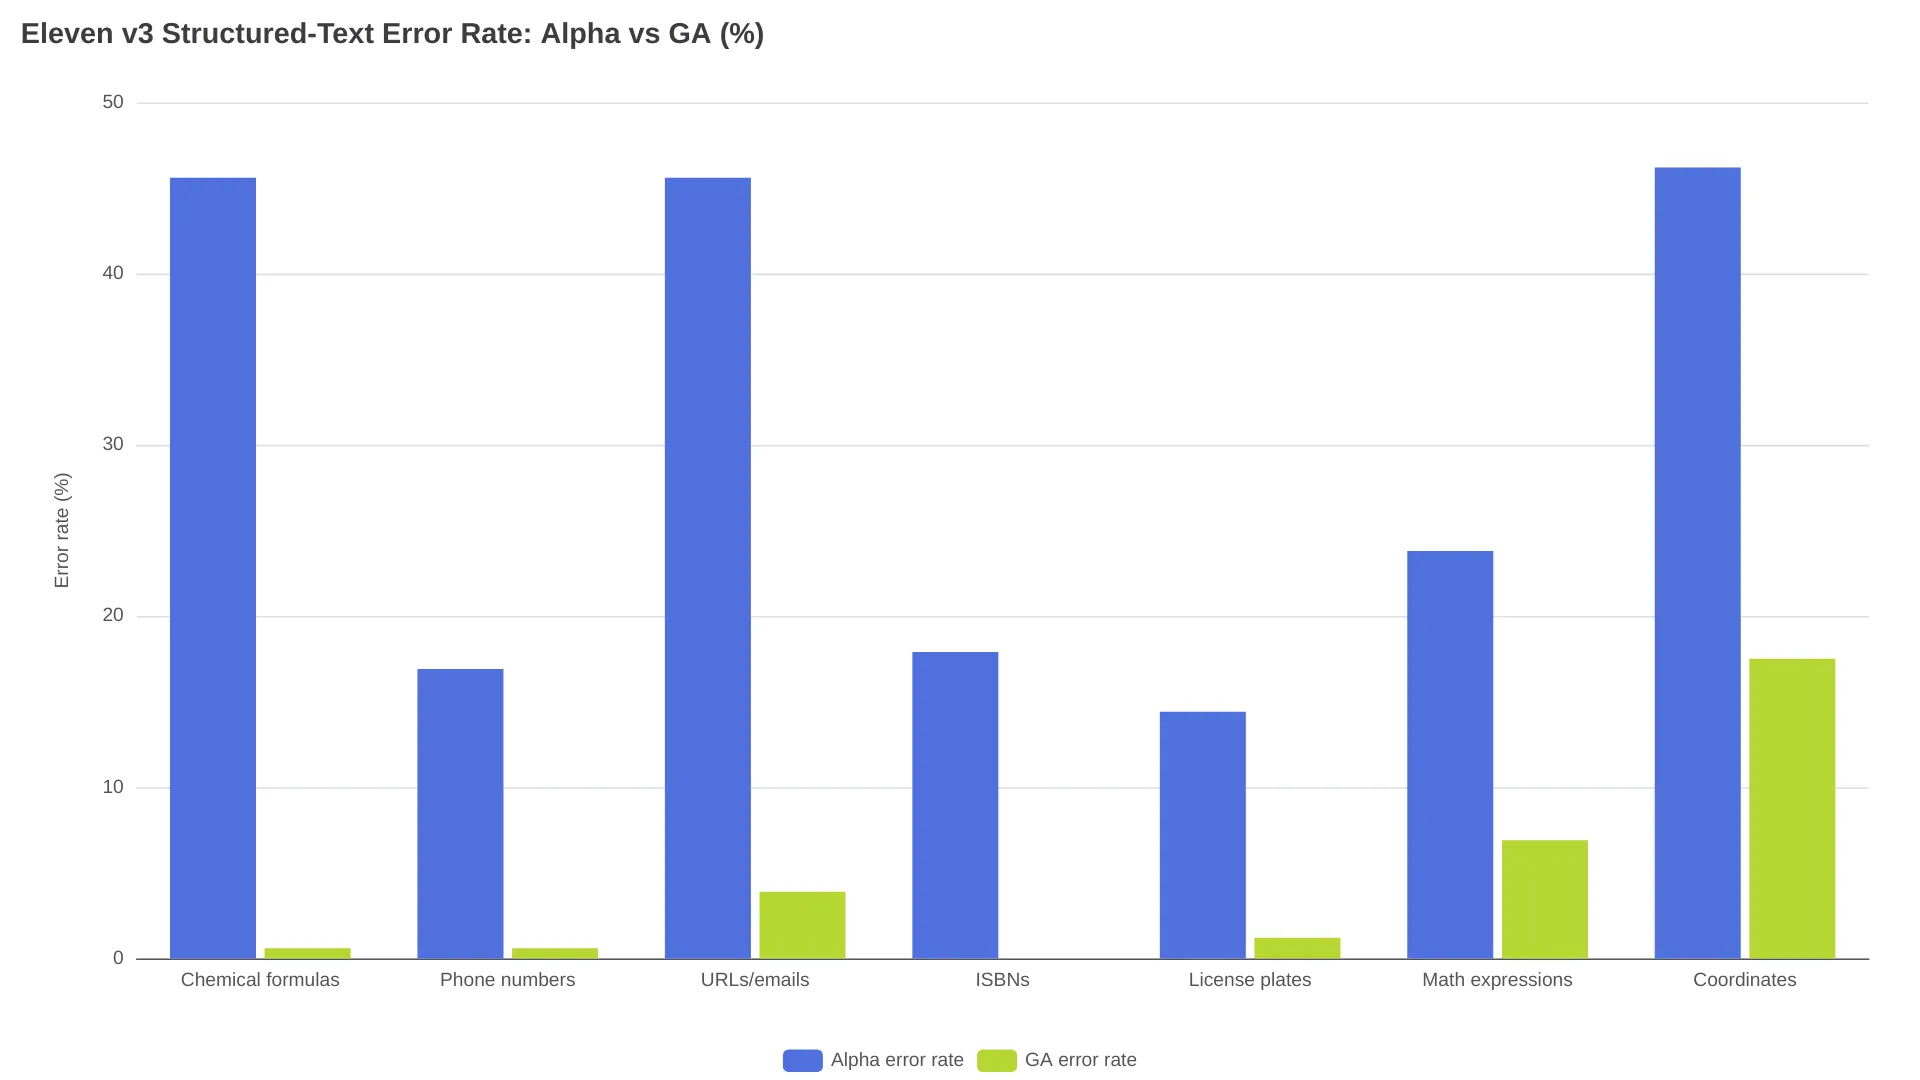
Avant de confier du texte structuré à v3, regardez le détail par catégorie du benchmark. Le taux d’erreurs des formules chimiques est tombé de 45,6 % à 0,6 %, celui des numéros de téléphone de 16,9 % à 0,6 %, et celui des ISBN à zéro. Les coordonnées géographiques restent le point faible, à 17,5 %, tandis que les expressions mathématiques atteignent 6,9 % : acceptable pour de la narration, plus risqué pour des contenus riches en coordonnées.
Voici où se place v3 face aux autres modèles, selon la référence officielle des modèles :
| Modèle | ID du modèle | Langues | Maximum de caractères/requête | Latence annoncée | Prix / 1 000 caractères |
|---|---|---|---|---|---|
| Eleven v3 | eleven_v3 | 70+ | 5 000 (~5 min) | ~250–300 ms (selon le niveau) | 0,10 $ |
| Eleven v3 Conversational | via Text-to-Dialogue WebSocket | 70+ | n/a | ~280 ms | 0,10 $ |
| Multilingual v2 | eleven_multilingual_v2 | 29 | 10 000 (~10 min) | ~250–300 ms | 0,10 $ |
| Flash v2.5 | eleven_flash_v2_5 | 32 | 40 000 (~40 min) | ~75 ms | 0,05 $ |
Une incohérence dans la documentation mérite votre attention : la page de tarification regroupe « Multilingual v2/v3 » sous une limite de 40 000 caractères, mais la référence des modèles plafonne Eleven v3 à 5 000 caractères par requête. Pour v3, retenez 5 000 : c’est la valeur propre au modèle, et tout pipeline long format conçu sur une hypothèse de 40 000 échouera.
Tarifs : ElevenLabs officiel ou fal.ai ?
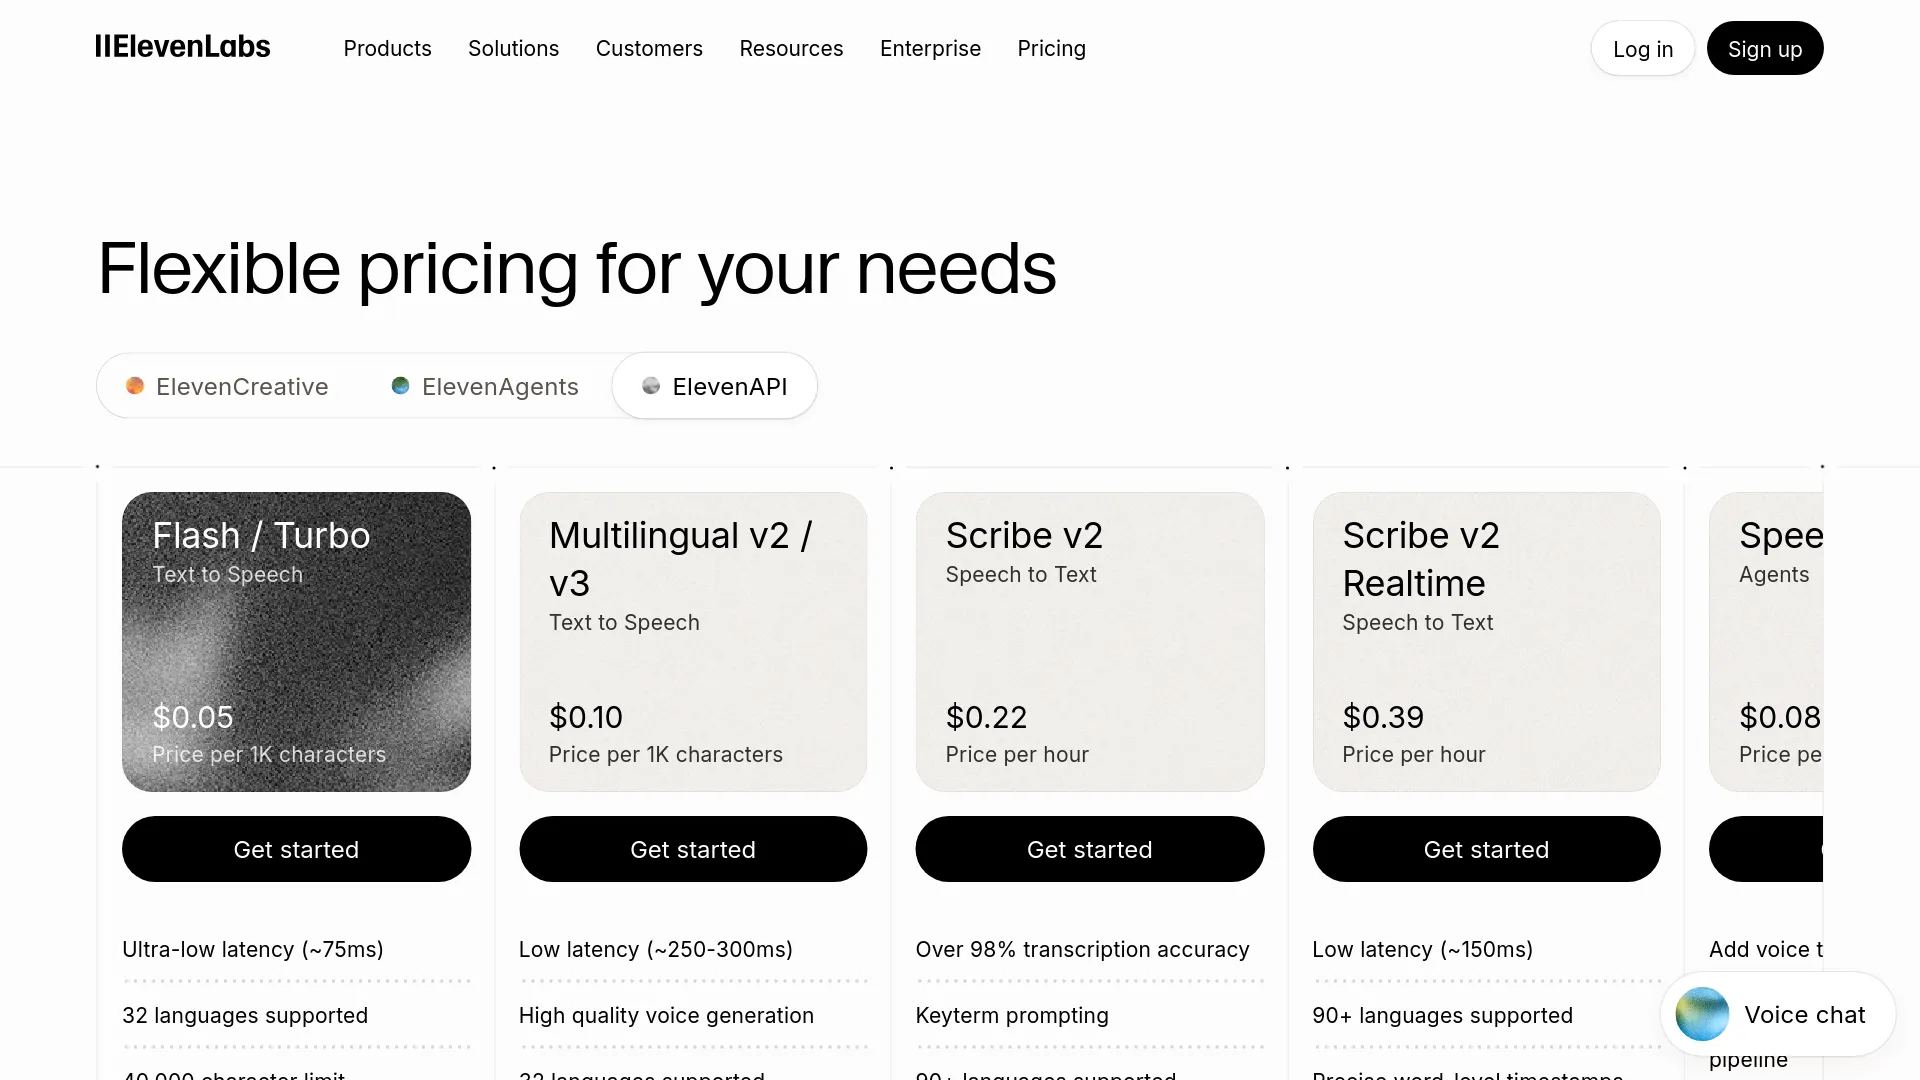
Le prix unitaire est le même, soit 0,10 $ par 1 000 caractères. Seul Flash v2.5 coûte moins cher dans cette gamme, à 0,05 $/1 000. Les différences importantes concernent donc la facturation et le parallélisme :
| ElevenLabs officiel | fal.ai | |
|---|---|---|
| Prix unitaire (Eleven v3) | 0,10 $ / 1 000 caractères | 0,10 $ / 1 000 caractères |
| Facturation | Forfaits avec crédits inclus, ou paiement à l’usage | Uniquement à l’usage ; « no seat licenses, no subscriptions, no minimums » |
| Offre gratuite | 10 000 caractères Multilingual/mois (20 000 Flash) | Aucune mentionnée sur la page du modèle |
| Exemple de forfait | Creator à 22 $/mois (11 $ le premier mois), 220 000 caractères Multilingual | n/a |
| Forfait le plus élevé | Business à 990 $/mois, 9,9 M de caractères Multilingual | n/a |
| Concurrence | Selon le forfait : 2 requêtes Multilingual simultanées sur Free, 15–30 sur Scale/Business, sur mesure sur Enterprise | File serverless ; aucun plafond par compte documenté sur la page du modèle |
| Impact de la file | Au-delà de la limite, les requêtes sont mises en file, avec « typically » ~50 ms supplémentaires | API de file avec webhooks pour les tâches par lots |
| Contrôles (schéma documenté, plus retours d’utilisateurs) | Voix par ID ; stabilité (les utilisateurs signalent 3 positions sur v3) | Voix, stability, similarity_boost, speed, language_code, apply_text_normalization, seed, timestamps, output_format |
| Programme startups | 12 mois gratuits, 33 M de caractères, concurrence accrue | n/a |
Chez ElevenLabs, la concurrence dépend du niveau de forfait. Une clé Free qui lance des appels v3 en parallèle est limitée à 2 requêtes simultanées, ce qui freine fortement le traitement par lots. fal fait passer les tâches dans une file serverless et fournit des callbacks webhook, précisément pour ce type de charge. La documentation tarifaire d’aucune des deux plateformes ne précise si les espaces ou les balises audio entre crochets sont comptabilisés dans les caractères facturés : prévoyez votre budget comme s’ils l’étaient.
Si vous n’utilisez v3 qu’occasionnellement et exécutez déjà d’autres modèles via fal, notre test de fal.ai couvre l’intérêt de la plateforme.
Balises audio : piloter l’émotion directement dans le script
Les balises audio sont des consignes entre crochets, placées directement dans le texte. Le modèle les interprète comme des indications de jeu, non comme des mots à prononcer. Exemple minimal repris de la page du modèle fal :
[slowly] Back then... [chuckles] we had no phones.
[whispers] Just dirt roads and [coughs] big dreams.
[sad] Then it happened.| Catégorie | Exemples fonctionnels |
|---|---|
| Émotions | [happy], [sad], [excited], [angry], [sarcastically], [nervous], [happily] |
| Interprétation | [whispers], [shouting], [shouts], [slowly], [quickly], [softly] |
| Sons non verbaux | [laughs], [chuckles], [sighs], [gasps], [coughs], [gulps], [clears throat], [applause] |
| Accents | [british accent], [southern accent], [strong canadian accent] |
Trois principes tirés de la documentation de prompting officielle encadrent le comportement des balises. Il n’existe pas de liste canonique : elles reposent sur des consignes en langage naturel et ElevenLabs indique que des balises plus efficaces que les exemples publiés existent probablement, ce qui rend les tests plus utiles que la mémorisation. Les balises de pause SSML ne sont pas prises en charge ; le rythme se règle avec la ponctuation, les points de suspension et les retours à la ligne. Enfin, leur efficacité varie selon la voix et le contexte. C’est souvent à ce stade que les problèmes apparaissent :
« V3 est incroyable, probablement le plus humain » ; « cela me donne encore l’impression d’une bêta » — u/ConcertNeat8147, deux extraits du même message, retour de terrain sur v3 dans r/ElevenLabs
Dans le même fil, u/poundingCode, ingénieur logiciel avec deux décennies d’expérience, explique que l’ajout de balises émotionnelles peut parfois faire basculer complètement l’accent du locuteur. Un compte de l’équipe ElevenLabs a répondu que « these are all things we're currently working on ».
Des créateurs ont partagé les contournements suivants dans ce même fil. Il s’agit de retours communautaires, pas de recommandations officielles :
- Ajoutez une phrase d’échauffement. Placez au début une phrase jetable qui fixe le ton et la hauteur de voix, puis coupez-la au montage ; les voix semblent souvent « se stabiliser » après quelques secondes de génération.
- Ajoutez
end.à la fin. Après votre texte, insérez un retour à la ligne puis le mot « end. » afin d’éviter les coupures sur le dernier mot ; retirez ensuite ce passage de l’audio. - Terminez par des points de suspension. Les coupures en fin de mot diminueraient lorsque les phrases se terminent par « ... ».
- Réglez la stabilité au maximum. Le contrôle de stabilité de v3 dispose de trois positions ; la plus haute réduit la dérive de voix au début des générations.
Les limites qui déterminent votre intégration
- Le plafond de 5 000 caractères est la contrainte principale. Une requête atteint environ 5 minutes d’audio ; les pipelines de livres audio ou de contenus longs doivent donc découper le texte. Faites-le aux limites des phrases ou des paragraphes, jamais au milieu d’une proposition, et conservez les balises dans le segment qu’elles doivent diriger. Multilingual v2 accepte 10 000 caractères si vous avez besoin d’appels plus grands et moins nombreux.
- La concurrence est liée au forfait sur l’API officielle. Selon la référence des modèles, les clés Free obtiennent 2 requêtes simultanées de niveau Multilingual (4 pour Flash), Scale et Business en ont 15–30, et Enterprise négocie des limites personnalisées. Dépasser la limite ajoute « typically » ~50 ms de mise en file. La même page propose une règle d’estimation d’ElevenLabs : une limite de concurrence de 5 peut supporter environ 100 diffusions audio simultanées dans une charge conversationnelle. Le surcoût par appel est faible, mais devient très pénalisant en traitement par lots si vous sous-dimensionnez votre capacité.
- fal ne documente aucune taille maximale d’entrée. Sa page Eleven v3 décrit l’endpoint, les paramètres et les formats, mais pas de plafond d’entrée, de durée de rétention en file ou de comportement de nouvelle tentative. Rien ne vous empêche d’envoyer un texte long ; rien ne vous garantit non plus que cela fonctionnera.
- Les timestamps diffèrent selon la plateforme. Le schéma d’entrée de fal inclut un booléen
timestamps, qui renvoie des données d’alignement mot par mot utiles aux sous-titres et au lip-sync. Sur l’API officielle, la sortie de dialogue v3 est fournie sans timestamps, un manque signalé publiquement par des développeurs (r/ElevenLabs: "v3 API, no timestamps?"). Le paramètre de fal est aujourd’hui la voie documentée pour obtenir ces données d’alignement.
- Le temps réel reste exclu. ElevenLabs considère v3 comme inadapté aux usages temps réel et conversationnels, en raison d’une latence plus élevée et d’une cohérence variable. Les options recommandées sont Flash v2.5 à ~75 ms pour les agents, ou Eleven v3 Conversational à ~280 ms via WebSocket lorsque l’expressivité doit être conservée dans un contexte interactif. Une variante v3 temps réel figure sur la feuille de route (« we're working on a real-time version »), mais n’était pas disponible lors de l’annonce de GA.
- Usage commercial. Pendant l’alpha, les développeurs demandaient publiquement si les sorties de v3 pouvaient être exploitées commercialement. L’annonce de GA a ouvert le modèle sur toutes les plateformes, et fal présente explicitement son endpoint comme destiné à un usage commercial.
Première requête : SDK officiel et client fal
Voici la voie officielle, reprise à l’identique du quickstart :
pip install elevenlabsfrom elevenlabs import ElevenLabs
client = ElevenLabs(api_key="YOUR_ELEVENLABS_API_KEY") # or ELEVENLABS_API_KEY env var
audio = client.text_to_speech.convert(
voice_id="JBFqnCBsd6RMkjVDRZzb", # "George"
text="[whispers] The first move is what sets everything in motion.",
model_id="eleven_v3",
output_format="mp3_44100_128",
)Avec fal, utilisez fal-client et l’endpoint fal.run :
pip install fal-clientimport fal_client
result = fal_client.subscribe(
"fal-ai/elevenlabs/tts/eleven-v3",
arguments={
"text": "[whispers] The first move is what sets everything in motion.",
"voice": "Rachel", # default voice
"stability": 0.5, # 0–1, lower = more expressive variation
"timestamps": True, # per-word alignment data
},
)
print(result["audio"]["url"]) # hosted MP3 URLLes deux plateformes déconseillent explicitement d’intégrer des clés API dans du code côté client. Faites donc transiter les requêtes par votre propre serveur. Pour le streaming, l’API officielle propose un endpoint de diffusion de parole, tandis que fal fournit fal.stream ainsi qu’une API de file avec webhooks pour les travaux par lots.
Quel endpoint appeler selon votre cas ?
| Votre situation | Endpoint à choisir |
|---|---|
| Vous avez besoin de vos propres voix clonées (PVC/IVC) ou de voix conçues accessibles par ID | Officiel : les voix personnalisées sont référencées par ID dans votre espace de travail ; la page de fal ne documente que des noms de voix prédéfinies |
| Vous payez déjà un forfait ElevenLabs avec des crédits inclus | Officiel : les caractères inclus constituent déjà un coût engagé, tandis que chaque appel fal ajoute une nouvelle dépense |
| Traitement par lots de livres audio ou de doublage, sans abonnement, avec webhook à la fin | fal : sa file à l’usage et son flux de webhooks ciblent exactement ce cas |
| Une seule clé API pour les modèles image, vidéo et TTS de la même stack | fal : v3 utilise le même client que vos autres modèles fal |
| Agents vocaux ou tout usage contraint par la latence | Aucun endpoint TTS v3 : utilisez Flash v2.5 (~75 ms) ou Eleven v3 Conversational (~280 ms) |
| Besoins Enterprise (SOC 2, HIPAA BAA, limites de débit personnalisées, listes d’autorisation IP) | Officiel : ces fonctions Enterprise sont documentées sur la page de tarifs ; la page du modèle fal ne précise pas quelles certifications couvrent son endpoint |
FAQ
Quel est l’ID de modèle d’Eleven v3 ?
eleven_v3, à transmettre comme model_id sur les endpoints standard de synthèse vocale. Les dialogues multi-locuteurs utilisent les endpoints Text-to-Dialogue dédiés plutôt qu’un paramètre de modèle.
L’API Eleven v3 prend-elle en charge le streaming ?
Oui. L’API officielle propose un endpoint de streaming qui renvoie l’audio pendant sa génération, et fal expose fal.stream pour le même modèle. Le streaming ne rend pas v3 adapté au temps réel : les recommandations officielles réservent toujours les usages conversationnels à Flash v2.5 ou Eleven v3 Conversational.
Quelle est la limite de caractères d’Eleven v3 ?
5 000 caractères par requête, soit environ 5 minutes d’audio, selon la référence officielle des modèles. Le chiffre de 40 000 caractères de la page tarifaire concerne le regroupement de niveau Multilingual, pas v3 spécifiquement.
Combien coûte l’API Eleven v3 ?
0,10 $ par 1 000 caractères sur les deux voies : 1,00 $ pour une histoire de 10 000 caractères, 100 $ pour un livre audio de 1 M de caractères. Les crédits des forfaits réduisent le coût côté officiel ; Creator à 22 $/mois inclut 220 000 caractères Multilingual. fal ne propose pas d’abonnement.
Puis-je utiliser des voix clonées avec Eleven v3 ?
Oui, via l’API officielle : les voix professionnelles, clonées et conçues sont référencées par leur ID. En pratique, la compatibilité varie. Des utilisateurs de r/ElevenLabs signalent que des Professional Voice Clones existantes peuvent parfois sonner comme des locuteurs différents avec v3, tandis que les PVC dont les créateurs indiquent la compatibilité V3 semblent mieux tenir. Le schéma de fal accepte un nom ou un ID de voix, mais ne documente que des voix prédéfinies ; les IDs privés de voix ElevenLabs y restent donc en terrain non documenté.
Eleven v3 convient-il aux agents vocaux en temps réel ?
Non. ElevenLabs indique explicitement que v3 n’est pas adapté au temps réel ni à la conversation, en raison d’une latence plus élevée et d’une cohérence variable. Utilisez Flash v2.5 (~75 ms, 32 langues) ou Eleven v3 Conversational (~280 ms, 70+ langues, contrôle par balises audio).
Pourquoi Eleven v3 sonne-t-il différemment via l’API et sur le site web ?
Les aperçus de voix ne reflètent pas nécessairement ce que vous obtiendrez avec votre propre texte, une plainte récurrente dans les retours de terrain de r/ElevenLabs. Les sorties de v3 varient aussi sensiblement d’une génération à l’autre. Avant de vous engager, testez chaque voix candidate avec un véritable extrait de script et le réglage de stabilité prévu pour votre production.
À lire aussi : guide de l’API Qwen Audio 3 TTS · tarifs et alternatives à Replicate · test de fal.ai 2026