 AIREITER
145 milliards de paramètres sur un ordinateur portable à 80 tokens par seconde : c’est la promesse d’Edge0-145B. Les poids sont téléchargeables, mais la réalité demande plutôt un PC NVIDIA sous CUDA 13 et environ 105 Go d’espace SSD.
Ce test d’Edge0-145B confronte les annonces de lancement au billet de lancement, à la documentation du modèle et à la fiche Q3_K, tout en tenant compte des premiers essais de la communauté. L’objectif : savoir avant de lancer le téléchargement s’il vaut mieux l’exécuter en local ou passer par une API.
Ce qui a été publié le 12 novembre : poids, moteur et limites
Edge0 a publié Edge0-145B et Edge0-120B le 12 novembre 2026, avec les poids dans Edge0-145B-q3k et Edge0-145B-NVFP4, ainsi que le moteur edge0-strata dans Edge0-AI/Edge0. Edge0-145B est un modèle Mixture-of-Experts latent, uniquement textuel, avec un contexte de 256K. Il dérive de Qwen3.8-Flash-Next et a été entraîné nativement en 4 bits. Environ 10,12 milliards de paramètres sont activés pour chaque token : les 145 milliards annoncés ne doivent donc pas tous tenir en VRAM.
Le modèle regroupe environ 84,6 milliards de paramètres experts, une table n-gramme PLE de 51,2 milliards de paramètres mappée directement depuis le SSD, une tête de prédiction de 1,26 milliard de paramètres pour le décodage spéculatif et un squelette de 6 Go. La version Q3_K contient 40,81 Gio de poids dans un dépôt de 105,4 Go, tandis que la version NVFP4 contient 47,79 Gio de poids dans un dépôt de 112,9 Go. Les experts routés sont stockés dans un fichier personnalisé experts.bin, et non dans un GGUF portable.
Les 29 Go annoncés ne suffisent pas à eux seuls
Le billet d’Edge0 évoque un pic de 29 Go dans une section, puis de 28 Go dans une autre, avec plus de 1 100 tokens par seconde en préremplissage, plus de 80 en génération et une consommation de 120 W. La fiche Q3_K indique 23,14 Gio de VRAM et 31,28 Gio de RAM système sur une RTX 5090 D. Pour NVFP4, les chiffres passent à 23,25 Gio et 38,27 Gio. La bibliothèque d’experts occupe environ 40 Go en RAM, tandis qu’environ 48 Go de vocabulaire sont lus en continu depuis le SSD.
Les experts « chauds » restent en VRAM, les experts « tièdes » prennent place en RAM et la table PLE de 51,2 Go est lue à la demande sur le SSD. La mémoire active peut donc approcher les 29 Go si l’on s’en tient à une définition étroite, mais il faut toujours télécharger l’intégralité du dépôt et disposer du stockage nécessaire au streaming.
| Ce que recouvre le chiffre | Taille | Emplacement |
|---|---|---|
| Pic de mémoire annoncé dans le billet | 28-29 Go | Résidence active, méthode non documentée |
| Téléchargement du dépôt Q3_K | 105,4 Go | SSD NVMe, PLE de 51,2 Go + experts.bin de 40,1 Go |
| Téléchargement du dépôt NVFP4 | 112,9 Go | SSD NVMe, PLE de 51,2 Go + experts.bin de 47,6 Go |
| Résidence mesurée sur 5090 D en Q3_K | 23,14 Gio de VRAM + 31,28 Gio de RAM | VRAM + RAM système pendant l’inférence |
| Résidence mesurée sur 5090 D en NVFP4 | 23,25 Gio de VRAM + 38,27 Gio de RAM | VRAM + RAM système pendant l’inférence |
La configuration réellement nécessaire pour Edge0-145B
Edge0-145B fonctionne sous Linux ou Windows avec un GPU NVIDIA et CUDA 13, via edge0-infer. Les fichiers publiés ne proposent aucun chemin de chargement pour llama.cpp, Ollama ou LM Studio : le GGUF du squelette ne contient pas les poids des experts routés et Edge0 ne documente que edge0-infer (voir les instructions du dépôt). Le processus décrit dans le guide llama.cpp v1.0 ne s’applique donc pas ici. Le billet de lancement cite macOS et le MacBook Pro parmi les plateformes prises en charge dès le premier jour, mais le tableau des plateformes ne liste, pour les modèles 145B et 120B, que Linux et Windows avec CUDA 13.
La configuration minimale testée comprend 16 Gio de VRAM et 20 Go de RAM, pour 44,9 tokens par seconde en décodage agent avec Q3_K. La recommandation monte à une carte NVIDIA de 24 Go, 32 Go de RAM système — 48 Go étant plus confortable —, 120 Go libres sur un SSD NVMe, ainsi que CUDA 13, CMake, Ninja et uv. Pour compiler et lancer le serveur, suivez les instructions du dépôt :
git clone https://github.com/Edge0-AI/Edge0.git edge0
hf download Edge0/Edge0-145B-q3k --local-dir ./Edge0-145B-q3k   # ~105 GB
export EDGE0_145B=$PWD/Edge0-145B-q3k
build/cpu/bin/edge0-infer serve --model "$EDGE0_145B"  # :8000
Sous Windows, il est aussi possible de récupérer l’application Edge0 Chat v0.2.0 depuis les versions publiées sur GitHub. Avec AMD, il faut en revanche prévoir des modifications manuelles : u/UghrUghr rapporte environ 35 lignes de changements dans la compilation et l’exécution sur une RX 7900 XTX sous Windows 11, dans ce fil r/LocalLLaMA. Les noyaux fusionnés CUDA y sont remplacés par un chemin de repli plus lent.
Q3_K ou NVFP4 : quel fichier télécharger ?
Avec 105,4 Go, Q3_K est la version par défaut. Le tableau d’Edge0 lui attribue 121,2 tokens par seconde en décodage agent sur une 5090 D. NVFP4 pèse 112,9 Go et vise l’accélération Blackwell, avec 98,3 tokens par seconde sur la même carte. Sans matériel Blackwell, mieux vaut commencer par Q3_K.
Quel débit sur les cartes disponibles ?
Les chiffres ci-dessous proviennent d’Edge0 pour Q3_K, avec un préremplissage de 16K sauf indication contraire. La ligne consacrée au M2 Ultra correspond à une mesure Metal et ne confirme pas la disponibilité d’une version macOS.
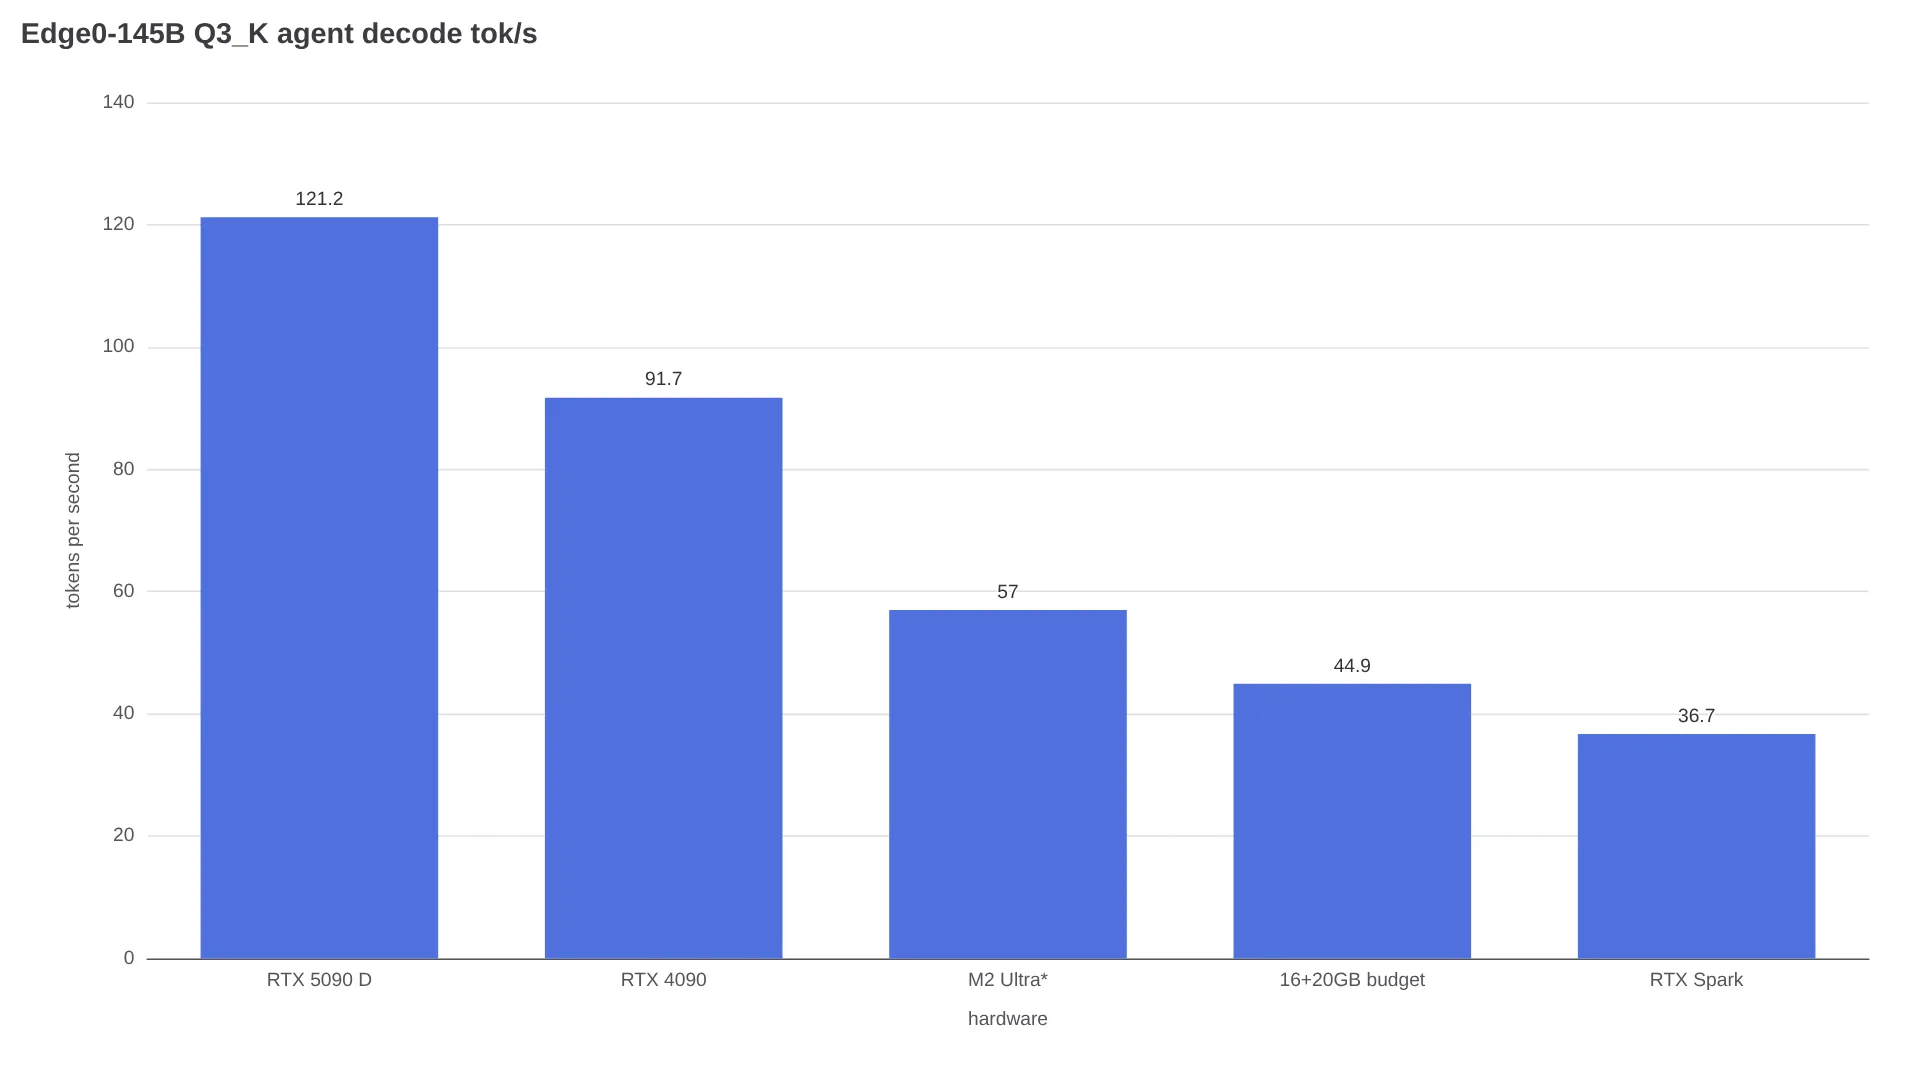
| Matériel | Décodage chat | Décodage agent | Préremplissage 16K |
|---|---|---|---|
| RTX 5090 D 24 Go Q3_K | 99.7 | 121.2 | 3,554.9 |
| RTX 4090 24 Go Q3_K | 69.9 | 91.7 | 3,179.4 |
| Apple M2 Ultra Metal Q3_K | 60.9 | 57.0 | 800.3 |
| Configuration avec 16 Gio de VRAM + 20 Gio de RAM Q3_K | 36.8 | 44.9 | 335.0 |
| RTX Spark 60 Gio Q3_K | 37.7 | 36.7 | 770.3 |
Un utilisateur de RTX 3090 rapporte 20,1 secondes avant le premier token, 1 583 tokens par seconde en préremplissage et 56,2 en décodage avec Q3_K. Cela place cette configuration sous le niveau des cartes haut de gamme :
Je viens de l’essayer sur ma configuration avec une 3090 : 20,1 s de TTFT, 1 583 tokens/s en préremplissage et 56,2 tokens/s en décodage pour Edge0-145B Q3_K.
— u/LightBrightLeftRight, fil r/LocalLLM
Sur la configuration AMD évoquée plus haut, u/UghrUghr annonce environ 40 tokens par seconde en décodage, environ 54 avec ROUTE_TAIL_SKIP=7 et ROUTE_PRIOR=1.5, ainsi qu’environ 320 en traitement du prompt. Ce sont des instantanés sur une seule session, pas des reproductions contrôlées, avec un débit situé autour de la moitié à deux tiers de celui de la 5090 D.
Benchmarks : deux victoires, quatre réserves
Le tableau d’Edge0 mélange des résultats internes pour Edge0, Qwen, DeepSeek et Claude avec des chiffres provenant de tiers pour les autres modèles, comme le précise la documentation du modèle. Edge0-145B arrive en tête sur les deux tests d’agents de programmation, mais reste derrière sa base Qwen sur les tests de connaissances et d’instructions. Je n’ai trouvé aucune reproduction indépendante liée au 13 novembre 2026, et ces scores concernent le modèle complet, pas les versions quantifiées téléchargeables.
| Benchmark | Edge0-145B | Qwen3.8-Flash-Next | DeepSeek V4 Flash | Claude Opus 4.6 Max |
|---|---|---|---|---|
| DeepSWE 1.1 | 64.6 | 58.7 | 54.4 | — |
| Terminal-Bench 2.1 | 86.52 | 83.3 | 82.7 | 78.2 |
| HLE | 35.4 | 35.9 | 33.8 | 40.0 |
| GPQA-Diamond | 90.4 | 91.7 | 90.8 | 91.3 |
| IFBench | 80.6 | 81.3 | 79.2 | 62.5 |
| AA-LCR | 79.3 | 79.1 | 79.7 | 78.0 |
La moyenne annoncée par Edge0 atteint 72,8 pour Edge0-145B, contre 71,7 pour Qwen3.8-Flash-Next et 70,1 pour DeepSeek-V4-Flash, tandis que le modèle 120B obtient 68,9. Mon avis : les deux modèles affichant des promesses de consommation maximale similaires, choisissez le 145B si l’espace disque ne pose pas problème.
Licence : des poids ouverts ne signifient pas open source
Le framework est sous licence Apache 2.0 et la base Strata sous licence MIT. Les poids, eux, relèvent de la licence Edge0 Community Model License 1.0, à laquelle s’ajoutent les conditions de Qwen. L’usage personnel, la recherche, l’usage interne en entreprise et l’exploitation commerciale des sorties sont autorisés. En revanche, vendre ou intégrer le modèle, proposer un service payant ou commercialiser un assistant de programmation ou de bureautique nécessite une autorisation écrite distincte.
Télécharger le modèle ou passer par une API ?
Téléchargez-le si vous disposez du matériel nécessaire et que votre code doit rester en local. Pour un simple essai, comparez le prix des API hébergées avant d’acheter une nouvelle machine. Les développeurs qui évaluent l’inférence hébergée peuvent consulter la page de l’API DeepSeek V4.1 Flash avant de réserver 105 Go d’espace disque.
| Votre situation | Choix recommandé |
|---|---|
| NVIDIA 24 Go + 32-48 Go de RAM + NVMe 120 Go, sous Linux/Windows | Télécharger Q3_K et le servir avec edge0-infer |
| Carte Blackwell, avec préférence pour le chemin NVFP4 | Télécharger la version NVFP4 |
| Mac uniquement, portable de 8-16 Go ou besoin d’Ollama/LM Studio | Ne pas télécharger pour le moment ; utiliser une API hébergée |
| Déployer une API ou un assistant payant basé sur ces poids | Attendre l’autorisation écrite ; utiliser une API |
| Obtenir les performances annoncées sans gérer l’infrastructure | Utiliser des API de classe Qwen ou des API de modèles de pointe ; réévaluer après les reproductions |
Le compromis se situe entre la provenance et la praticité : le streaming des experts réduit la barrière de la VRAM pour les modèles de plus de 100 milliards de paramètres, mais les promesses autour du portable, de macOS et des 29 Go vont plus vite que le code publié. En outre, le tableau d’Edge0 ne fournit aucun score de qualité distinct pour Q3_K.
FAQ
Edge0-145B peut-il fonctionner sur un ordinateur portable ?
Uniquement sur un portable NVIDIA haut de gamme doté d’environ 24 Go de VRAM, d’au moins 32 Go de RAM et de 120 Go de NVMe, sous Linux ou Windows avec CUDA 13. Un ultrabook de 8 ou 16 Go ne peut pas exécuter la version 145B : celle-ci nécessite un téléchargement de 105,4 Go et plus de 23 Gio de VRAM en résidence.
Edge0-145B fonctionne-t-il sur Mac ?
Aucune version macOS officiellement prise en charge n’apparaît dans le tableau des plateformes au 13 novembre 2026. Les chiffres du M2 Ultra correspondent uniquement à des mesures Metal.
Est-il compatible avec Ollama, llama.cpp ou LM Studio ?
Non. Les versions standard ne savent pas charger les paquets personnalisés experts.bin, et le GGUF du squelette ne contient pas les poids des experts routés. Utilisez edge0-infer serve ou l’application Chat pour Windows.
Edge0-145B est-il meilleur que Qwen3.8-Flash-Next ?
Il prend l’avantage sur DeepSWE avec 64,6 contre 58,7 et sur Terminal-Bench avec 86,52 contre 83,3 dans les tests d’Edge0. Il est derrière sur HLE, avec 35,4 contre 35,9, et sur GPQA-Diamond, avec 90,4 contre 91,7. Les tests indépendants restent à venir.
Puis-je utiliser Edge0-145B à des fins commerciales ?
Les sorties peuvent être utilisées commercialement, mais vendre le modèle, proposer un service payant ou commercialiser un assistant de programmation ou de bureautique nécessite une autorisation écrite distincte en vertu de la licence communautaire. Les conditions de Qwen s’appliquent également.