 AIREITER
Un worker peut être placé derrière votre pare-feu tout en envoyant à Cursor des fragments de code source, des sorties de terminal, des diffs et des captures d’écran. Cursor Self-Hosted Machines héberge l’exécution, pas l’agent complet : ce n’est ni un agent auto-hébergé ni un déploiement Cursor totalement isolé du réseau.
Cette analyse s’intéresse à ce qui franchit réellement la frontière et à l’effet concret des différents contrôles, en s’appuyant sur l’annonce de Cursor du 2 septembre 2026, la documentation Self-Hosted Machines et la politique d’utilisation des données.
La frontière des données en un tableau
Cursor répartit l’exécution d’une session Cloud Agent entre son infrastructure cloud et un worker que vous administrez. « Self-hosted » décrit donc l’endroit où les outils s’exécutent, pas l’ensemble des systèmes ni des flux de données concernés.
| Données ou système | Lieu d’exécution ou de stockage | Peut atteindre Cursor ? | Contrôle ou limite concerné |
|---|---|---|---|
| Boucle de l’agent, inférence et planification | Cloud Cursor | Déjà dans Cursor | Self-Hosted Machines ne les déplace pas. |
| Modifications de fichiers et commandes de terminal | Votre worker | Les résultats peuvent être renvoyés | Le worker exécute les outils. |
| Checkout complet et cache de compilation | Votre worker | Pas transférés par défaut | La copie de travail complète reste en local. |
| Identifiants présents sur la machine | Votre worker | Pas transférés par défaut | Gardez les secrets hors des commandes, sorties et artefacts. |
| Contenu des fichiers et diffs | Votre worker, puis contexte/résultats de l’agent | Oui, lorsque nécessaire | Privacy Mode concerne l’utilisation pour l’entraînement, pas le transfert. |
| Sorties de terminal et résultats MCP locaux | Votre worker, puis résultats des outils | Oui, lorsqu’ils sont renvoyés | Les résultats peuvent contenir du code ou des données sensibles. |
| Captures d’écran et flux du bureau | Votre worker, puis Cursor lorsqu’ils sont produits ou partagés | Oui | Les sessions d’utilisation de l’ordinateur peuvent diffuser le bureau de l’agent. |
| Vidéos, captures d’écran et références de journaux | Stockage d’artefacts géré par Cursor | Oui, par défaut | Bloquer l’hôte des artefacts désactive les téléversements. |
| Requêtes de modèles avec clé API | Circuit de traitement de Cursor | Oui | BYOK ne contourne pas le backend de Cursor. |
La distinction essentielle tient en une phrase : le dépôt complet peut rester sur votre machine, tandis qu’une partie du contexte nécessaire à l’inférence quitte tout de même cette machine. Vous gagnez donc le contrôle de l’exécution, pas une garantie d’absence totale de sortie réseau.
Ce que Cursor déplace réellement vers votre infrastructure
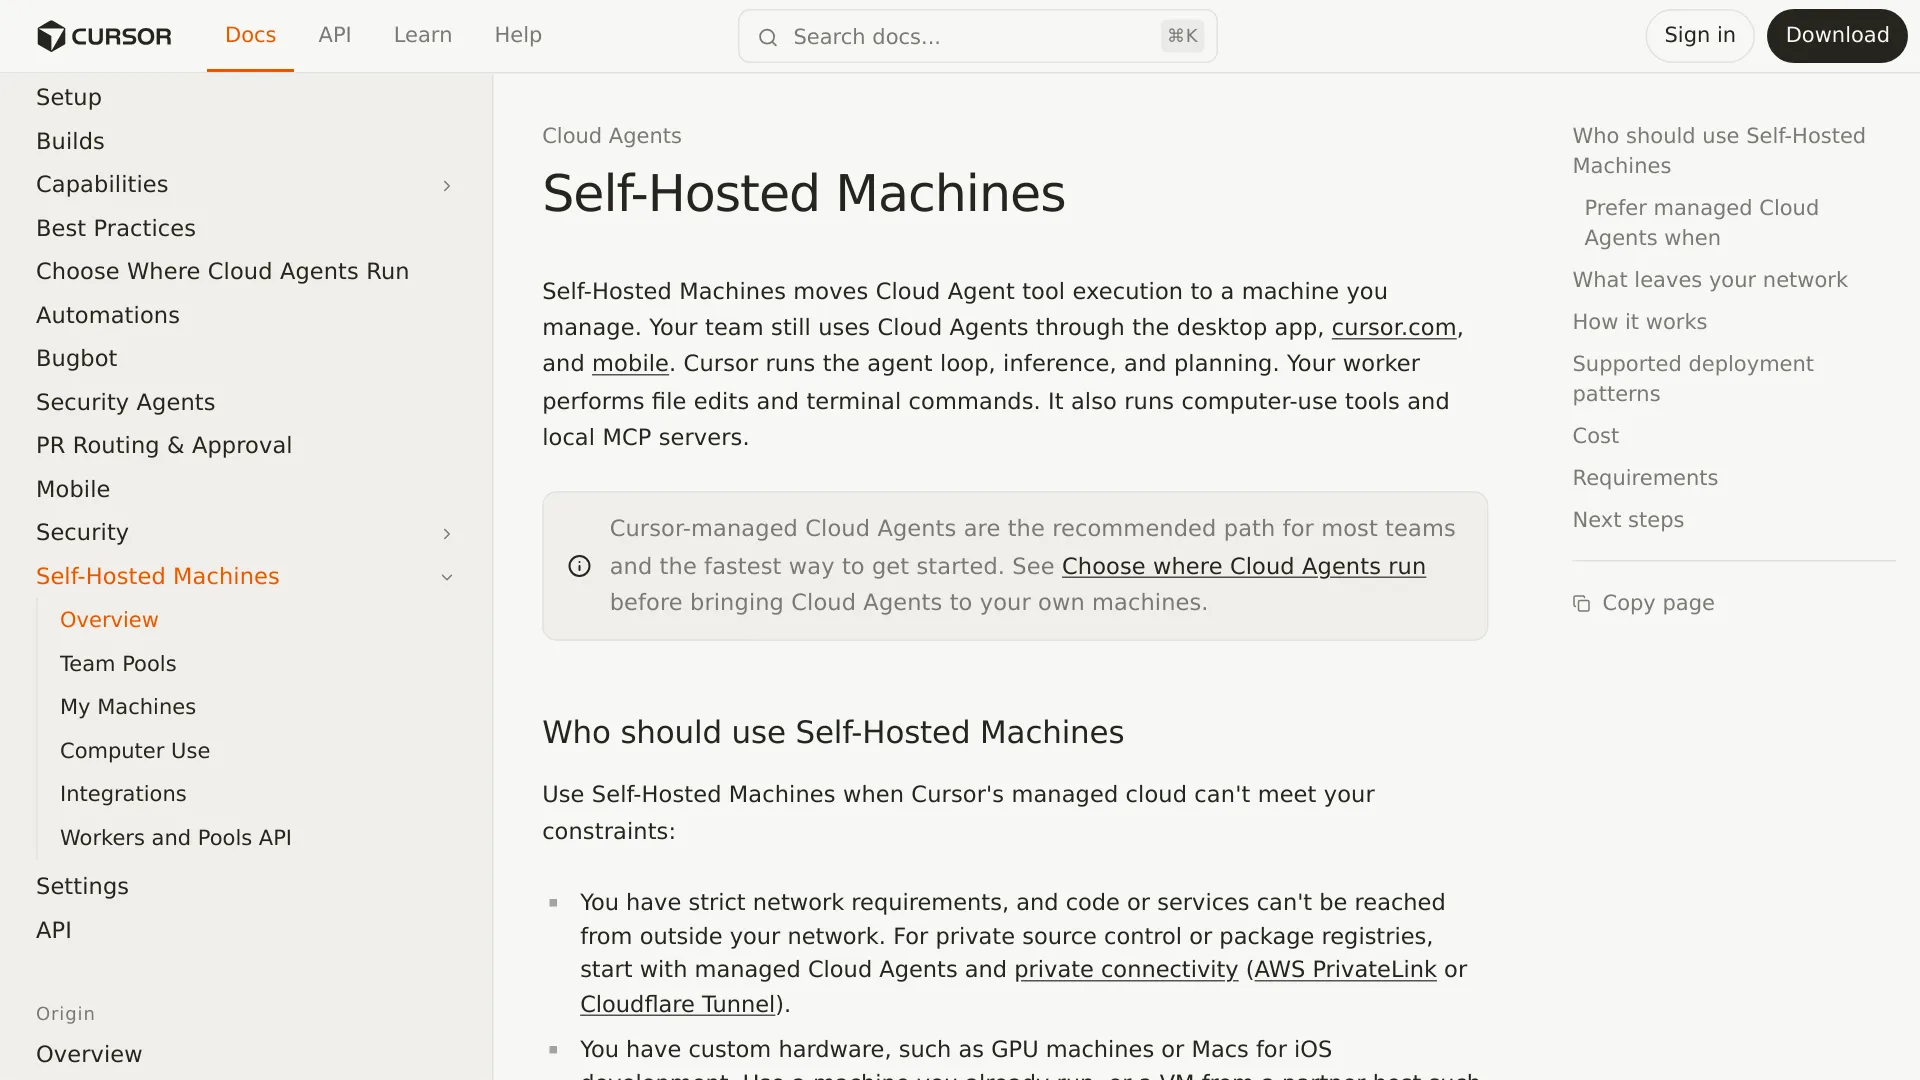
Self-Hosted Machines déplace l’exécution des outils vers une machine contrôlée par le client. Le worker peut modifier des fichiers, lancer des commandes, accéder à des services internes, piloter un navigateur et se connecter à des serveurs MCP locaux. En revanche, Cursor conserve dans son cloud la boucle de l’agent, l’inférence, la planification et l’orchestration des sessions.
Le worker est lancé avec la commande CLI Cursor agent worker start. Il ouvre une connexion HTTPS sortante persistante vers Cursor. Cursor précise que cette connexion part du worker : aucun port entrant, aucune adresse IP publique ni aucun tunnel VPN n’est nécessaire.
Le déroulement documenté d’une session est le suivant :
- Une session Cloud Agent démarre dans l’interface Cursor.
- La boucle de l’agent cloud de Cursor planifie l’action suivante.
- Cursor envoie un appel d’outil via la connexion du worker.
- Le worker exécute la commande, la modification, l’action dans le navigateur ou l’opération MCP.
- Le worker renvoie le résultat pour l’étape d’inférence suivante.
Le worker doit toujours disposer d’un accès sortant à api2.cursor.sh et api2direct.cursor.sh ; les mises à jour de la CLI et certains scénarios d’utilisation de l’ordinateur peuvent également nécessiter downloads.cursor.com. Le modèle « sortant uniquement » évite d’ouvrir un accès entrant vers votre réseau, mais ne transforme pas le worker en environnement d’exécution de modèle hors ligne.
Cursor présente cette séparation comme adaptée aux dépôts ou services privés inaccessibles depuis les workers hébergés, aux matériels spécialisés comme les GPU ou les Mac, ainsi qu’aux systèmes d’exploitation et images de build personnalisés. Si votre seul besoin est la connectivité privée, le guide de choix du runtime de Cursor recommande d’abord d’envisager les Cloud Agents gérés avec des listes d’autorisation, un réseau de type Tailscale, AWS PrivateLink ou Cloudflare Tunnel.
Ce qui peut sortir du worker — et ce que change Privacy Mode
La documentation de Cursor cite explicitement le contenu des fichiers, les sorties de terminal, les diffs, les captures d’écran, les résultats MCP locaux et les métadonnées de routage parmi les données que le worker peut envoyer. La question de la confidentialité se décompose en trois sujets distincts : ce qui est transféré, son éventuelle utilisation pour l’entraînement et sa durée de conservation.
Privacy Mode contrôle l’entraînement, pas les sorties réseau
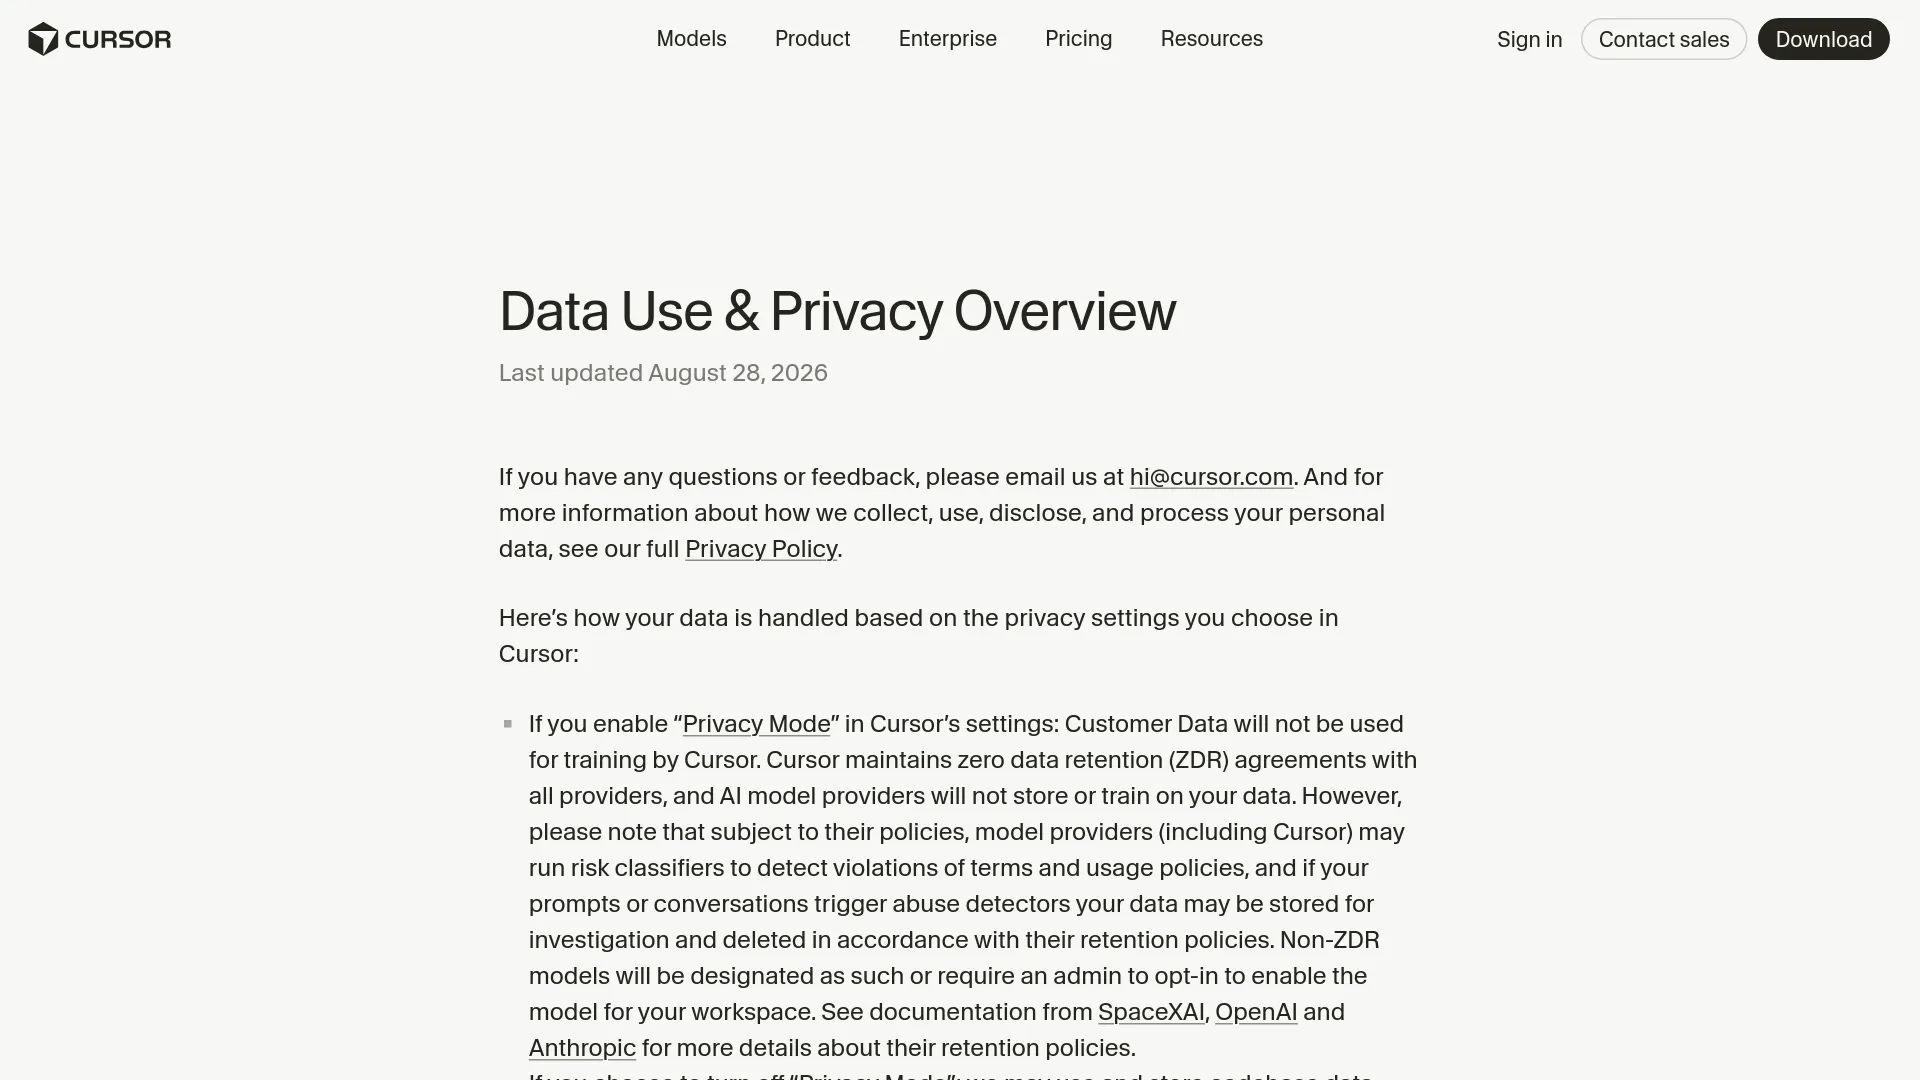
La page Data Use & Privacy Overview de Cursor, mise à jour le 28 août 2026, indique que Privacy Mode empêche Cursor d’utiliser les données client pour entraîner ses modèles et précise que Cursor a conclu avec ses fournisseurs des accords de conservation nulle des données. La même page apporte toutefois des nuances : les classificateurs de risques peuvent conserver des prompts ou des conversations à des fins d’analyse, et des fichiers peuvent être temporairement mis en cache pour réduire la latence et améliorer l’efficacité du réseau.
Cursor indique que les fichiers mis en cache sont chiffrés avec des clés générées par le client, ces clés étant conservées sur ses serveurs pendant la durée de la requête. Il s’agit d’une déclaration de Cursor sur la protection et la conservation des données, pas d’un élément prouvant que la requête ne parvient jamais à ses serveurs.
Le fonctionnement des clés API personnelles mérite aussi d’être clarifié. Cursor affirme que l’utilisation de votre propre clé de fournisseur ne contourne pas son backend, puisque les requêtes passent toujours par Cursor pour la construction finale du prompt. BYOK peut modifier l’identité qui autorise l’utilisation du modèle ; il ne faut pas l’interpréter comme une liaison directe et privée entre le client et le fournisseur.
Un utilisateur a formulé la même distinction architecturale en analysant la fonctionnalité :
« Frontière importante : les machines auto-hébergées de Cursor déplacent l’exécution, pas l’agent dans son ensemble. Cursor indique que l’inférence et la planification restent dans son cloud ; les sorties des outils remontent et peuvent contenir du code. Pour une revue de sécurité, considérez cela comme une exécution auto-hébergée — pas comme un agent auto-hébergé. » — @ham_zax, X
Le réglage des artefacts ne crée pas de diode réseau
Cursor documente une méthode ciblée pour empêcher l’envoi des artefacts : bloquer le trafic HTTPS sortant vers cloud-agent-artifacts.s3.us-east-1.amazonaws.com. Les appels d’outils et leurs résultats continuent de fonctionner, mais les captures d’écran, vidéos et références de journaux n’apparaîtront plus dans les pull requests ni dans le tableau de bord Cursor.
Cette mesure est pertinente si votre organisation n’a pas besoin d’artefacts visuels. Elle ne constitue pas une solution complète de confidentialité : le contenu des fichiers, les sorties de terminal, les diffs, les captures utilisées pendant l’inférence et les résultats MCP peuvent toujours être renvoyés via la connexion de session de l’agent.
Le transport MCP introduit une autre distinction concrète. La documentation Team Pools de Cursor indique que les serveurs MCP lancés par commande, ou via stdio, s’exécutent sur le worker et peuvent accéder aux réseaux privés. Les serveurs MCP HTTP/SSE sont pris en charge par le backend de Cursor pour OAuth, la mise en cache des sessions et l’authentification. Un endpoint MCP privé doit donc faire l’objet d’une analyse du transport, pas seulement d’un examen de l’emplacement de l’hôte.
Choisissez le runtime selon votre contrainte, pas selon son intitulé
Cursor propose trois options de runtime. L’auto-hébergement prend tout son sens lorsque la maîtrise de la frontière d’exécution, du matériel ou de l’environnement constitue une exigence formalisée plutôt qu’une simple préférence.
| Runtime | Lieu d’exécution des appels d’outils | Cas d’usage idéal | Responsabilité principale |
|---|---|---|---|
| Cloud Agents gérés par Cursor | VM isolée gérée par Cursor | La plupart des équipes pouvant utiliser un réseau géré et des environnements standard basés sur Ubuntu | Cursor gère le cycle de vie des VM, la capacité, l’isolation et la suppression après la configuration de votre environnement. |
| My Machines | Ordinateur portable, devbox, Mac ou VM d’un utilisateur | Un workflow personnel, un dépôt avec un état local ou une preuve de concept rapide | Vous gérez la disponibilité, les identifiants, les dépendances, le nettoyage et le checkout. |
| Team Pools | Workers gérés par l’organisation | Parcs d’entreprise, GPU, Mac, Kubernetes, routage par labels et capacité centralisée | Votre équipe gère les hôtes, les images, les secrets, la mise à l’échelle, la supervision, les réinitialisations et les pannes. |
Choisissez les Cloud Agents gérés si votre seule exigence concerne l’accès privé
Les Cloud Agents gérés peuvent suffire si votre organisation peut définir sa frontière au moyen des permissions de dépôt, de listes d’autorisation réseau, d’un client de type Tailscale ou d’une connectivité privée prise en charge. Le guide de choix du runtime de Cursor recommande l’infrastructure gérée à la plupart des équipes et la présente comme l’option demandant le moins d’exploitation.
Vous évitez ainsi d’opérer un parc de workers tout en conservant le cycle de vie des VM gérées par Cursor et une concurrence élastique. Cela ne signifie pas que les agents gérés ne traitent aucune donnée ; cela signifie que l’environnement d’exécution est opéré par Cursor plutôt que par votre équipe.
Choisissez My Machines pour un utilisateur et un environnement maîtrisé
My Machines relie la machine personnelle d’un utilisateur à son compte Cursor individuel. Cette option est pratique lorsqu’un développeur dispose déjà d’un Mac, d’une devbox ou d’une VM distante configurée avec ses dépendances locales et l’accès réseau nécessaire, difficile à reproduire ailleurs.
Le revers est opérationnel. La machine doit rester en ligne pendant les sessions actives, et l’utilisateur prend en charge le nettoyage, l’actualisation du checkout, l’état du disque, les identifiants et la réparation des dépendances. La documentation Self-Hosted de Cursor précise que plusieurs agents peuvent fonctionner sur la même machine, mais on reste loin du modèle de parc d’équipe centralisé.
Choisissez Team Pools uniquement si le contrôle du parc justifie la complexité
Team Pools s’adresse aux équipes Enterprise. La fonctionnalité repose sur une authentification par compte de service, une capacité de workers partagée, des labels et une mise à l’échelle pilotée par contrôleur. Un pool gpu peut diriger le travail vers des machines équipées de GPU ; un pool ios peut l’envoyer vers des Mac. Cursor documente jusqu’à 200 workers par utilisateur et 1 000 workers par équipe, les déploiements plus importants nécessitant une discussion sur la mise à l’échelle.
Les pools peuvent descendre jusqu’à zéro et s’appuyer sur des workers persistants, conteneurisés, Kubernetes ou hébergés par un partenaire. Cursor indique que la restauration d’un workspace libéré peut prendre plusieurs minutes. Cette souplesse convient aux charges irrégulières, mais la gestion des images, la réinitialisation des workers, le dimensionnement, la rotation des secrets et la supervision passent du côté du client.
Le coût combine infrastructure et utilisation des modèles
La documentation Self-Hosted Machines et la page Cursor Models & Pricing détaillent les responsabilités liées aux modèles, aux forfaits et à l’infrastructure, mais ne mentionnent pas de frais distinct distinct par worker pour Self-Hosted Machines. Le modèle de coût indiqué est le suivant : vous continuez de payer le modèle sélectionné via Cursor, tout en assumant le coût de la machine, du conteneur, du cluster, du stockage, du réseau, de la supervision et de l’exploitation que vous fournissez.
L’auto-hébergement constitue donc un argument d’économie assez faible lorsqu’aucune exigence particulière de réseau ou de matériel ne l’impose. Les pools dynamiques et l’hibernation peuvent réduire le coût du calcul inutilisé, mais le seuil de rentabilité dépend de la forme de la charge, du temps de démarrage et de la quantité d’état à reconstruire ; Cursor ne publie pas de chiffre universel.
La checklist sécurité à suivre avant l’activation
Utilisez cette checklist avec votre responsable sécurité, plateforme ou conformité. Le simple mot « self-hosted » ne doit pas être considéré comme un feu vert.
- Définissez précisément la frontière. Déterminez si votre politique exige que le checkout complet, l’exécution des outils, les identifiants, les requêtes d’inférence, les artefacts ou l’ensemble de ces éléments restent à l’intérieur du périmètre. Self-Hosted Machines ne place sous votre contrôle que le worker d’exécution et l’état local complet.
- Classez le contexte renvoyé. Le contenu des fichiers, les diffs, les sorties de terminal, les captures d’écran et les résultats MCP peuvent être envoyés à Cursor. Vérifiez si ces sorties peuvent contenir du code source, des données client, des tokens, des URL internes ou des réponses de production.
- Activez Privacy Mode en connaissance de cause. Il modifie la position déclarée de Cursor concernant l’entraînement et la conservation chez ses fournisseurs ; il n’empêche ni le traitement des requêtes, ni la mise en cache temporaire, ni les opérations de détection des risques.
- Interprétez correctement BYOK. Selon la page d’utilisation des données de Cursor, une requête utilisant une clé API ne retire pas le backend de Cursor du chemin de traitement.
- Traitez séparément la sortie des artefacts. Autorisez ou bloquez
cloud-agent-artifacts.s3.us-east-1.amazonaws.comselon que les captures, vidéos et références de journaux dans les pull requests et le tableau de bord sont acceptables. Privilégiez une règle ciblant exactement cet hôte lorsque le pare-feu le permet. - Mettez en place une liste d’autorisation sortante. N’autorisez que les endpoints Cursor documentés ainsi que les hôtes de mise à jour ou d’utilisation de l’ordinateur explicitement nécessaires. Le worker ne devrait avoir besoin ni d’un port entrant ni d’une adresse IP publique.
- Analysez le transport MCP. Utilisez un MCP stdio côté worker lorsqu’un serveur doit accéder à un service privé, puis évaluez les résultats renvoyés. Ne supposez pas qu’un endpoint MCP HTTP/SSE reste dans votre réseau simplement parce que le service est privé.
- Isolez et réinitialisez les workers. Pour Team Pools, définissez la manière dont les machines sont nettoyées ou recréées entre deux agents, la façon dont les identifiants sont injectés et le mode de supervision des journaux. Les guides et modèles de Cursor sont des architectures de référence, pas un parc de production entièrement géré.
- Testez les scénarios de panne. Vérifiez ce qui se passe lorsque les endpoints Cursor, le stockage des artefacts, le worker, un registre privé ou un serveur MCP devient indisponible. Un hôte d’artefacts bloqué ne doit pas être confondu avec une session d’agent bloquée.
- Écartez cette solution pour les charges isolées. Si l’exigence est d’interdire toute sortie réseau du contexte du modèle ou toute inférence cloud tierce, cette architecture ne convient pas. La boucle de l’agent reste dans le cloud de Cursor.
| Votre exigence réelle | Décision |
|---|---|
| Les commandes, l’état local ou un matériel personnalisé doivent s’exécuter dans votre environnement | Utilisez Self-Hosted Machines, avec des contrôles sur les sorties de contexte et d’artefacts. |
| Les agents doivent accéder à des services privés, mais l’exécution peut avoir lieu dans une VM gérée | Commencez par les Cloud Agents gérés et une solution de connectivité privée prise en charge. |
| Aucun contexte de modèle ne peut sortir du réseau, ou l’inférence doit être hors ligne | Écartez cette architecture : elle dépend toujours du cloud de Cursor. |
FAQ sur la confidentialité de Cursor Self-Hosted Machines
Cursor Self-Hosted Machines est-il entièrement auto-hébergé ?
Non. Cursor conserve dans son cloud la boucle de l’agent, l’inférence, la planification et l’orchestration. Votre machine héberge l’exécution des outils et l’état de travail local.
Le code source quitte-t-il la machine auto-hébergée ?
Certains contenus de fichiers, diffs, sorties de terminal, captures d’écran et résultats MCP locaux peuvent quitter le worker pour servir d’entrées ou de résultats d’outils à l’agent. Cursor indique que le checkout complet et le cache de compilation restent sur le worker : la frontière est donc partielle, et non binaire.
Privacy Mode empêche-t-il les données de traverser le réseau ?
Non. Privacy Mode est présenté comme empêchant l’utilisation des données pour l’entraînement par Cursor et les fournisseurs de modèles, conformément aux engagements de conservation annoncés par Cursor. Il n’empêche pas le worker d’envoyer le contexte nécessaire à l’inférence.
BYOK contourne-t-il Cursor ?
Non. La page d’utilisation des données de Cursor indique que les requêtes utilisant une clé API passent toujours par son backend pour la construction finale du prompt. BYOK ne doit pas être considéré comme une connexion directe entre votre worker et un fournisseur de modèles.
Puis-je empêcher l’envoi des captures d’écran et des vidéos ?
Vous pouvez bloquer l’accès sortant à cloud-agent-artifacts.s3.us-east-1.amazonaws.com. L’exécution des outils continue, mais les artefacts n’apparaîtront plus dans les pull requests ni dans le tableau de bord Cursor. D’autres données de la session de l’agent peuvent toujours être renvoyées à Cursor.
Un worker nécessite-t-il une règle de pare-feu entrante ou un VPN ?
Cursor documente un fonctionnement en HTTPS sortant. Aucun port entrant, aucune adresse IP publique ni aucun tunnel VPN ne sont nécessaires, même si le worker doit toujours pouvoir accéder aux endpoints Cursor documentés ainsi qu’aux services dont il a besoin.
Puis-je utiliser Team Pools avec un forfait personnel ou inférieur ?
La documentation de Cursor positionne Team Pools pour les clients Enterprise et exige une clé API de compte de service. My Machines constitue l’option destinée aux workers personnels ; ne supposez pas qu’une clé API personnelle puisse lancer un worker Team Pool.
Puis-je exécuter Cursor Self-Hosted Machines entièrement hors ligne ?
Non. La boucle de l’agent et l’inférence restent dans le cloud de Cursor, et le worker nécessite une connexion sortante. Un besoin de fonctionnement hors ligne ou en réseau isolé exige une architecture différente, avec orchestration et inférence de modèle hébergées localement.
Utilisez Cursor Self-Hosted Machines lorsque votre équipe a besoin d’une exécution contrôlée par le client, d’un accès à des réseaux privés, de matériel personnalisé ou d’un environnement persistant. Si l’exigence est de maintenir le trafic lié à l’IA hors du cloud, choisissez une autre architecture : cette fonctionnalité change l’endroit où les commandes s’exécutent, pas celui où l’agent réfléchit.