 AIREITER
"Sonnet 5 est proche d'Opus 4.8, mais moins cher" est l'argument avancé par Anthropic elle-même. Nous voulions savoir où cela cesse d'être vrai, alors nous avons exécuté quatre tâches identiques sur les deux modèles via la CLI Claude Code et consigné le coût réel, la durée et le nombre d'appels d'outils à partir de chaque réponse API. Le point le plus important : pousser Sonnet 5 à l'effort xhigh pour égaler ce qu'Opus 4.8 fait par défaut, et l'écart de prix que nous avons mesuré a presque disparu — tandis qu'Opus 4.8 terminait en environ la moitié du temps.
Sonnet 5 vs Opus 4.8 en un coup d'œil
Claude Sonnet 5 | Claude Opus 4.8 | |
|---|---|---|
Sortie | 30 juin 2026 | |
Fenêtre de contexte | 1M tokens | 1M tokens |
Sortie max | 128K tokens | 128K tokens |
Tarification (entrée/sortie par 1M tokens) | $5/$25 | |
Mode rapide | Non pris en charge | Pris en charge (aperçu de recherche), jusqu'à ~2.5x la vitesse de sortie à tarification premium |
Niveaux d'effort | low / medium / high / xhigh / max | low / medium / high / xhigh / max |
Positionnement | Modèle Sonnet moins cher, axé sur les agents | Modèle phare d'Anthropic, option la plus précise |
La fenêtre de contexte et la sortie maximale sont identiques — ce n’est pas un facteur de différenciation ici. En revanche, une chose l’est : Sonnet 5 fonctionne avec un nouveau tokenizer qu’Anthropic dit produire « environ 30 % de jetons en plus » que Sonnet 4.6 pour le même texte, donc un budget max_tokens ou une estimation de coût repris de Sonnet 4.6 ne se traduira pas directement.
Comparaison officielle des benchmarks
Selon les propres divulgations d'Anthropic, compilées parallèlement à une analyse tierce par llm-stats.com, le schéma est cohérent : Sonnet 5 gagne ou égalise sur quelques benchmarks, et Opus 4.8 mène sur la plupart des autres, généralement d'une marge à un chiffre.
Benchmark | Sonnet 5 | Opus 4.8 | Écart |
|---|---|---|---|
Terminal-Bench 2.1 | 80.4% | 74.6% | Sonnet 5 +5.8 |
Humanity's Last Exam (with tools) | 57.4% | 57.9% | Égalité quasi parfaite |
Humanity's Last Exam (no tools) | 43.2% | 49.8% | Opus +6.6 |
SWE-bench Verified | 85.2% | 88.6% | Opus +3.4 |
SWE-bench Pro | 63.2% | 69.2% | Opus +6.0 |
Toolathlon | 54.3% | 59.9% | Opus +5.6 |
OSWorld-Verified (computer use) | 81.2% | 83.4% | Opus +2.2 |
CursorBench | 61.2% | 63.8% | Opus +2.6 |
USAMO 2026 problems | 79.5% | 96.7% | Opus +17.2 |
Deux choses ressortent. Le plus grand avantage d’Opus 4.8 concerne les mathématiques difficiles (USAMO), et non le codage — les écarts en codage (SWE-bench, Terminal-Bench) sont tous à un chiffre, et Sonnet 5 en gagne même un sans partage. En raisonnement général assisté par des outils (HLE avec outils), les deux sont suffisamment proches pour considérer cela comme une égalité.
Il existe aussi un chiffre de sécurité qui mérite d’être signalé, même s’il ne s’agit pas d’un benchmark de capacités : d’après les mêmes divulgations, dans des scénarios d’utilisation du navigateur sans protections supplémentaires, le taux de réussite mesuré des attaques par injection de prompt de Sonnet 5 était de 0,93 %, contre 31,5 % pour Opus 4.8. Anthropic n’a pas publié d’explication détaillée pour cet écart spécifique. Si vous construisez quoi que ce soit d’agentique qui parcourt le web ouvert sans supervision, il vaut la peine de tester vos propres protections plutôt que de supposer que le modèle phare est automatiquement le choix par défaut le plus sûr.
Nous avons nous-mêmes effectué quatre tests comparatifs
La plupart de ce qui existe actuellement compile soit le tableau officiel de benchmark ci-dessus, soit partage des impressions subjectives sur un seul modèle. Nous n’avons pas trouvé de comparaison contrôlée des coûts et de la latence avec le même prompt, alors nous avons réalisé la nôtre.
Méthodologie : quatre tâches, exécutées le 2026-07-01, même prompt envoyé à claude-sonnet-5 et claude-opus-4-8 à chaque fois via le Claude Code CLI (claude -p --model <id> --effort <level> --output-format json). Le coût, la durée et le nombre de tours sont lus directement à partir de la réponse API de chaque exécution, et non estimés à partir des décomptes de tokens. Chaque configuration modèle/niveau d’effort a été exécutée une fois par tâche — chiffres réels provenant d’une seule exécution, et non d’un échantillon moyenné statistiquement. Considérez l’ampleur de chaque écart comme indicative plutôt qu’exacte ; la direction était cohérente dans tous les tests que nous avons exécutés.
Test 1: Le contrôle de réversion des coûts
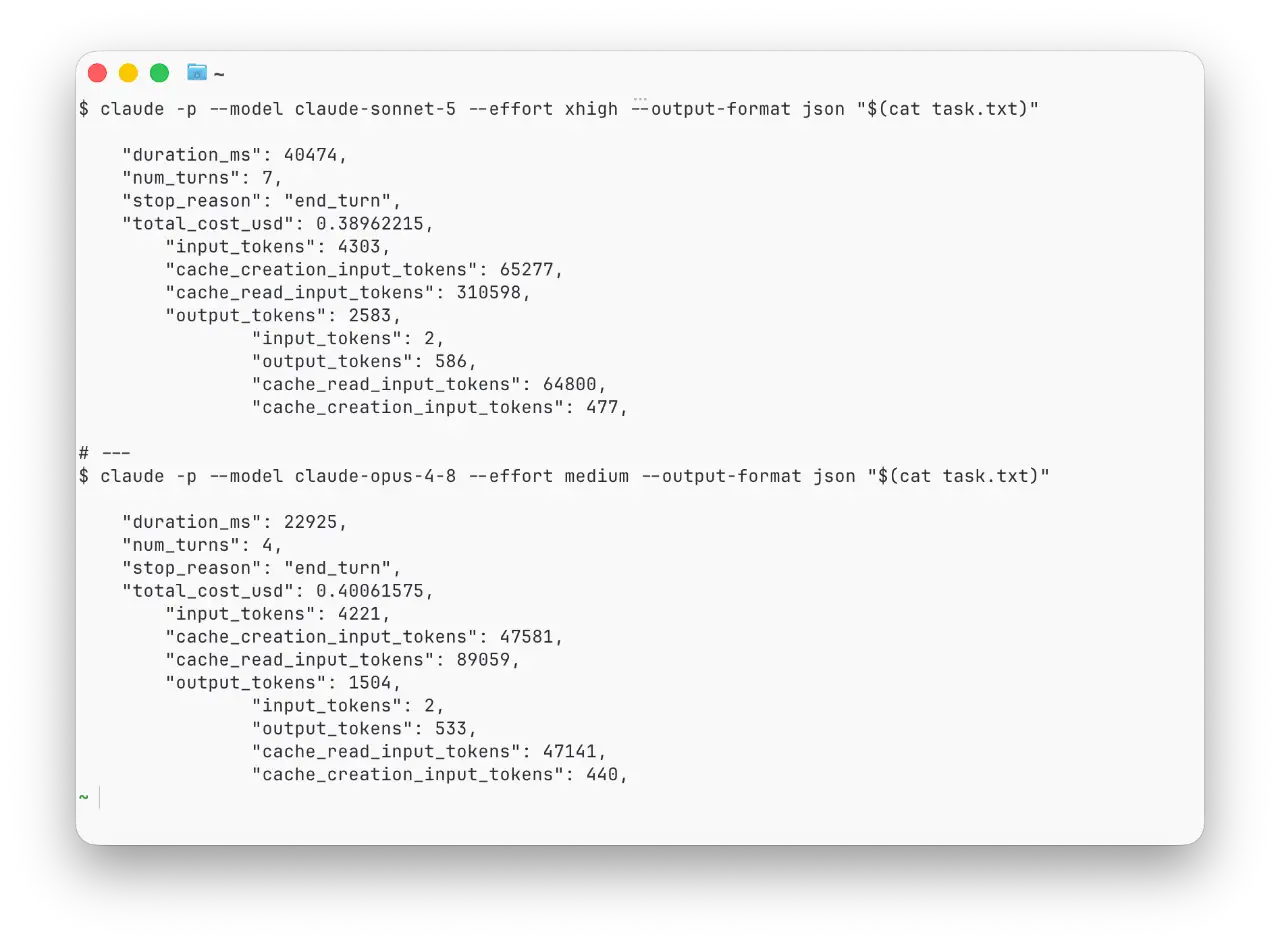
La question à laquelle nous voulions avant tout répondre : Sonnet 5 reste-t-il moins cher une fois que vous augmentez son niveau d’effort pour compenser une tâche plus difficile ? Nous avons exécuté la même tâche de codage que le Test 2 (ci-dessous) sur Sonnet 5 xhigh contre Opus 4.8 medium.
Configuration | Coût | Durée | Tours | Résultat |
|---|---|---|---|---|
Sonnet 5, effort | $0.390 | 40.5s | 7 | 8/8 tests pass |
Opus 4.8, effort | $0.401 | 22.9s | 4 | 7/7 tests pass |
Une différence de coût de 3 % — en pratique un quasi-équilibre — et Opus 4.8, avec son réglage d’effort inférieur, a terminé en 57 % du temps en utilisant presque deux fois moins d’échanges. Les deux ont produit un code correct et fonctionnel. Cela correspond à ce que les gens signalent déjà sur Hacker News : un commentateur y a estimé qu’Opus 4.8 coûtait environ 0,45 $ en raisonnement moyen contre Sonnet 5 à environ 0,52 $ en xhigh/max pour un travail comparable.
Test 2: Tâche de codage à effort égal
Même prompt, les deux modèles à high effort : écrivez une fonction efficace pour trouver la plus longue sous-chaîne palindromique, générez des cas de test couvrant les cas limites, exécutez-les, corrigez tout ce qui échoue.
Configuration | Coût | Durée | Tours | Résultat |
|---|---|---|---|---|
Sonnet 5 (high) | $0.378 | 37.4s | 7 | 8/8 pass |
Opus 4.8 (high) | $0.439 | 28.9s | 5 | 8/8 pass |
Les deux ont adopté la même approche d’expansion autour du centre et ont réussi tous les tests dès le premier essai. Opus 4.8 y est parvenu plus rapidement et en moins de tours, pour environ 16 % de coût supplémentaire. Lorsque la qualité est identique, celui-ci revient à Opus sur la seule vitesse.
Test 3 : Rédaction / Travail intellectuel
Un prompt de jugement commercial sans réponse unique correcte : conseillez une entreprise SaaS de 12 personnes sur l’opportunité de consacrer 3 à 4 semaines à la migration vers une deuxième région AWS pour la reprise après sinistre, six semaines avant la clôture de leur série A.
Configuration | Coût | Durée | Tours |
|---|---|---|---|
Sonnet 5 (high) | $0.072 | 14.7s | 1 |
Opus 4.8 (high) | $0.084 | 22.7s | 1 |
Les deux ont donné essentiellement la même recommandation — passer outre la migration complète, livrer plutôt une sauvegarde/un runbook léger — avec une qualité de raisonnement comparable. Sonnet 5 y est parvenu en environ deux tiers du temps et a coûté 14 % de moins. C’est le seul test où « Sonnet 5 tient bien la route sur le travail de connaissance » est ressorti clairement.
Test 4 : Recherche agentique — Sonnet 5 « réfléchit-il » vraiment trop ?
Certains fils de discussion Reddit décrivent Sonnet 5 comme davantage enclin à trop réfléchir sur des demandes simples qu’Opus 4.8. Nous en avons testé une vraiment simple : additionner la taille en octets de chaque fichier .py dans une arborescence de répertoires et indiquer quel sous-répertoire en contient le plus.
Configuration | Coût | Durée | Tours |
|---|---|---|---|
Sonnet 5 (high) | $0.119 | 18.5s | 3 |
Opus 4.8 (high) | $0.120 | 12.1s | 2 |
Les deux sont arrivés à la même réponse correcte. Le coût n’était séparé que par une erreur d’arrondi, mais Sonnet 5 a pris un tour d’appel d’outil supplémentaire et environ 50 % de temps en plus. C’est un point de données bien réel, même s’il est modeste, pour la critique du « surpensage » — et cela concorde avec le test 1 : Sonnet 5 a tendance à prendre plus d’étapes pour parvenir au même résultat.
Alors, lequel devriez-vous réellement utiliser ?
Choisissez Opus 4.8 pour les tâches de codage où la vitesse compte, les flux de travail agentiques avec de nombreux appels d’outils, ou tout cas où vous seriez autrement tenté de pousser l’effort de Sonnet 5 au-delà de
highpour faire confiance au résultat — c’est exactement la situation où l’avantage de coût de Sonnet 5 disparaît.Choisissez Sonnet 5 pour les travaux à grand volume, sensibles au budget, ainsi que pour les tâches générales de connaissance/rédaction, mais gardez-le à un niveau d’effort
mediumouhigh. N’augmentez pas réflexivement àxhigh« juste pour être sûr » — c’est là que l’argument tarifaire s’effondre.L’un ou l’autre convient pour les recherches simples et les requêtes en un seul tour ; la différence pratique que nous avons mesurée était un tour supplémentaire et quelques secondes, pas une mauvaise réponse.
FAQ
Claude Sonnet 5 est-il réellement moins cher qu’Opus 4.8 ?
À niveau d’effort équivalent, oui — nettement. Mais poussez Sonnet 5 à xhigh pour compenser une tâche plus difficile et l’écart peut se réduire à quelques pourcents, tandis qu’Opus 4.8 avec un réglage d’effort plus faible termine plus vite. Vérifiez le niveau d’effort que vous utilisez réellement avant de supposer que vous économisez de l’argent. Pour la liste complète des prix pour Haiku, Sonnet et Opus, consultez notre guide tarifaire de l’API Claude.
Qu’en est-il de Claude Sonnet 5 par rapport à Sonnet 4.6 ?
Une amélioration générationnelle, pas un choix de niveau de modèle — et le coût n’évolue pas non plus dans la même direction. Sonnet 5 bat Sonnet 4.6 avec un score à deux chiffres sur Terminal-Bench, mais dans nos propres tests comparatifs de coûts, Sonnet 5 s’est avéré plus cher que Sonnet 4.6 à chaque niveau d’effort que nous avons essayé, principalement en raison du nouveau tokenizer. Tests complets et chiffres dans Sonnet 5 vs Sonnet 4.6 : Est-ce vraiment moins cher ?
La comparaison entre Claude Sonnet 5 et Opus 4.6 est-elle équitable ?
Pas vraiment — Opus 4.6 est une génération derrière Opus 4.8. Si vous décidez quoi utiliser aujourd’hui, comparez avec Opus 4.8, pas avec son prédécesseur.
La fenêtre de contexte est-elle différente entre les deux ?
Non — les deux offrent une fenêtre de contexte de 1M de tokens et une sortie maximale de 128K.
Pourquoi le taux d’injection de prompt d’Opus 4.8 est-il beaucoup plus élevé lors de l’utilisation du navigateur ?
D’après les divulgations d’Anthropic, 31,5 % sans garanties supplémentaires contre 0,93 % pour Sonnet 5, notamment dans des scénarios d’utilisation du navigateur sans supervision. Anthropic n’a pas publié d’explication détaillée. Considérez cela comme une raison de tester vos garde-fous spécifiques plutôt que de supposer que le modèle phare est automatiquement l’option par défaut la plus sûre.
Annexe : invites exactes et sortie brute
Pour toute personne souhaitant reproduire cela, voici les invites exactes que nous avons envoyées pour chaque test (le Test 1 et le Test 2 ont utilisé la même invite de codage, simplement à des niveaux d’effort différents).
Tests 1 & 2 — invite de codage :
Écrivez une fonction Python `longest_palindromic_substring(s: str) -> str` qui renvoie
la plus longue sous-chaîne palindromique de s, en utilisant une approche plus efficace que
la force brute O(n^3) (par exemple, expansion autour du centre ou l'algorithme de Manacher). Enregistrez-la
dans solution.py.

Puis écrivez test_solution.py avec au moins 6 cas de test couvrant : chaîne vide,
caractère unique, caractères tous identiques, aucune palindrome plus long que 1, un
palindrome de longueur paire, et un palindrome de longueur impaire.

Exécutez les tests avec pytest et assurez-vous qu'ils passent tous. Si certains échouent, corrigez le
code et relancez jusqu'à ce que tout passe. Indiquez la sortie finale de pytest.
Test 3 — prompt de rédaction/travail de connaissance :
Vous conseillez une petite entreprise SaaS (12 employés, 80k MRR, actuellement sur une
seule région AWS) sur l’opportunité de s’étendre à une deuxième région AWS pour la reprise
après sinistre avant sa levée de fonds de Série A, qui se clôture dans 6 semaines.
L’équipe d’ingénierie estime que la migration prend 3 à 4 semaines et consommerait la
plupart de la capacité de l’équipe pendant cette période, retardant deux fonctionnalités
demandées par des clients.

Rédigez une recommandation exécutive d’environ 350 mots : doivent-ils le faire maintenant,
le retarder, ou trouver une voie médiane ? Justifiez avec les arbitrages. Pas de préambule,
juste la recommandation.
Test 4 — invite de recherche agentique :
Dans l'arborescence du répertoire actuel, trouvez tous les fichiers avec une extension .py, additionnez leur
taille totale en octets, et dites-moi quel sous-répertoire unique (enfant immédiat du
répertoire de travail) contient le plus grand nombre de fichiers .py par compte. Seulement les deux
nombres/réponse, pas besoin d'écrire de nouveaux fichiers.
Voici la réponse API réelle pour l’exécution Sonnet 5 (xhigh) du Test 1, réduite aux champs pertinents pour le coût et le timing :
{
  "duration_ms": 40474,
  "num_turns": 7,
  "stop_reason": "end_turn",
  "total_cost_usd": 0.38962215,
  "usage": {
    "input_tokens": 4303,
    "cache_creation_input_tokens": 65277,
    "cache_read_input_tokens": 310598,
    "output_tokens": 2583
  }
}
C'est le total_cost_usd, duration_ms et les comptes de tokens non modifiés que le CLI Claude Code a renvoyés pour cette exécution — les chiffres du tableau Test 1 ci-dessus proviennent directement de champs comme ceux-ci, une réponse JSON par exécution.