 AIREITER
Faire tourner un modèle de 27 milliards de paramètres sur un téléphone n’est plus seulement une promesse marketing. Bonsai 27B, la version quantifiée en ternaire de Qwen3.6 27B par PrismML, descend à 3,9 Go et atteint environ 11 tokens par seconde sur un iPhone 17 Pro. Les poids sont proposés gratuitement sous licence Apache 2.0, et la déclinaison ternaire conserve plus de 95 % du score de référence en pleine précision. Mais cette fidélité n’est pas homogène : les maths et le code résistent très bien, tandis que l’appel d’outils et la vision accusent davantage le coup. Bonsai 27B est donc une option locale intéressante pour le raisonnement et la programmation, bien moins rassurante pour les usages agentiques riches en outils. Voici ce que cache sa compression, comment interpréter les chiffres, comment le lancer et à qui il convient réellement.
Comment PrismML a fait tenir 27B paramètres dans un téléphone
En FP16, un modèle de 27B nécessite environ 54 Go de mémoire : bien au-delà de ce qu’offre un téléphone. Bonsai 27B passe sous les 6 Go en remplaçant les poids en pleine précision par des valeurs discrètes beaucoup plus compactes.
Dans la version ternaire, chaque poids ne peut prendre que trois valeurs : -1, 0 ou +1. Cela représente théoriquement environ 1,58 bit d’information par poids. PrismML y ajoute une mise à l’échelle FP16 par groupes : un facteur de mise à l’échelle en pleine précision est conservé pour chaque groupe de poids afin que les valeurs compressées gardent le bon ordre de grandeur. Le coût réel atteint ainsi environ 1,71 bit effectif par poids. La version binaire 1 bit, encore plus agressive, supprime le zéro et ne conserve que -1 et +1, pour environ 1,125 bit effectif.
Deux points sont importants. D’abord, la quantification couvre l’ensemble du modèle : embeddings, attention, blocs MLP et tête de modèle de langage, sans composant en pleine précision servant de béquille. Ensuite, la base reste Qwen3.6 27B, un modèle causal à attention hybride de 27,8B paramètres. Bonsai conserve donc sa fenêtre de contexte de 262K tokens ainsi que ses entrées multimodales.
Version ternaire ou 1 bit : laquelle télécharger ?
PrismML propose deux versions. Le choix est simple, mais il faut le faire correctement : un fichier plus léger implique une précision moindre.
| Version | Bits effectifs/poids | Taille | Qualité conservée | Usage recommandé |
|---|---|---|---|---|
| Ternaire (-1, 0, +1) | ~1,71 | 5,9 Go | >95 % de FP16 | Ordinateur de bureau, usages sensibles à la qualité |
| Binaire 1 bit (-1, +1) | ~1,125 | 3,9 Go | >90 % de FP16 | Téléphones, mémoire limitée |
Sur téléphone, c’est la version 1 bit qui entre dans la marge mémoire d’un iPhone 17 Pro. Sur un portable ou un ordinateur de bureau disposant de davantage de ressources, la version ternaire récupère plusieurs points de précision pour deux gigaoctets supplémentaires. C’est le meilleur choix dès que la qualité des réponses prime sur l’encombrement.
Ce que disent vraiment les benchmarks, et là où la qualité baisse
Les chiffres officiels concernent la version ternaire, qui atteint une moyenne de 80,49 sur 15 benchmarks en mode réflexion. Plusieurs résultats ressortent nettement :
| Benchmark | Score | Ce qu’il mesure |
|---|---|---|
| MATH-500 | 99.20 | Mathématiques du niveau scolaire à la compétition |
| AIME 2025 | 90.84 | Mathématiques de concours difficiles |
| HumanEval+ | 93.90 | Génération de code |
| BFCL v3 | 74.41 | Appel de fonctions et d’outils |
Mis côte à côte, ces résultats dessinent clairement le profil de Bonsai 27B. Les maths et le code restent dans les 90, l’appel d’outils se situe dans les 70. C’est le point essentiel à comprendre avant de s’y fier : la quantification préserve bien mieux le raisonnement et le code que les comportements structurés en plusieurs étapes dont dépendent les workflows agentiques.
Ces résultats viennent de PrismML : mieux vaut donc les considérer comme un premier indicateur plutôt que comme un verdict définitif, en attendant davantage de tests indépendants. La moyenne de 80,49 masque les signaux les plus utiles : regardez les scores tâche par tâche et les échecs rencontrés dans les usages réels. Des premiers testeurs ont signalé que la version ternaire pouvait occasionnellement s’enfermer dans des boucles de raisonnement. Par ailleurs, une quantification aussi extrême fragilise généralement davantage la stabilité sur les longs contextes qu’un score sur tâche isolée ne le laisse penser. Un essai sur vos propres prompts reste prudent avant toute dépendance au modèle.
Performances : vitesse et matériel compatible
Une compression aussi poussée n’a d’intérêt que si l’inférence reste assez rapide pour un usage réel. C’est le cas sur du matériel adapté. Voici les chiffres communiqués par PrismML :
| Appareil | 1 bit | Ternaire |
|---|---|---|
| iPhone 17 Pro | 11 tok/s | — |
| Apple M5 Max | 87 tok/s | 58 tok/s |
| NVIDIA RTX 5090 | 163 tok/s | 134 tok/s |
Les 11 tokens par seconde sur téléphone suffisent pour une conversation et du raisonnement court, sans être fulgurants. Avec un M5 Max, 87 tokens par seconde permettent à l’inférence locale de dépasser un appel d’API cloud sur des prompts courts, une fois les aller-retours réseau pris en compte. PrismML présente aussi le résultat sous l’angle de la densité d’intelligence, soit le score de benchmark par gigaoctet : Bonsai atteint environ 0,53, soit approximativement dix fois un modèle de référence en pleine précision.
Quatre façons de lancer Bonsai 27B dès maintenant
Les poids étant ouverts, il n’existe pas une seule procédure d’installation. Voici les quatre options disponibles, du test sans configuration au déploiement avec contrôle complet.
Sur iPhone
L’application iOS Locally AI exécute directement la version 1 bit de 3,9 Go sur l’appareil, sans compte ni serveur. C’est la solution qui concrétise la promesse d’un modèle 27B sur téléphone, avec un fonctionnement entièrement hors ligne après le téléchargement des poids.
Dans un navigateur
PrismML publie des kernels WebGPU capables d’exécuter le modèle 1 bit dans un onglet de navigateur, sans installation. C’est le moyen le plus rapide de tester Bonsai 27B avant de lui réserver de l’espace disque, à condition d’avoir une machine dotée d’un GPU compatible WebGPU.
Sur votre propre machine
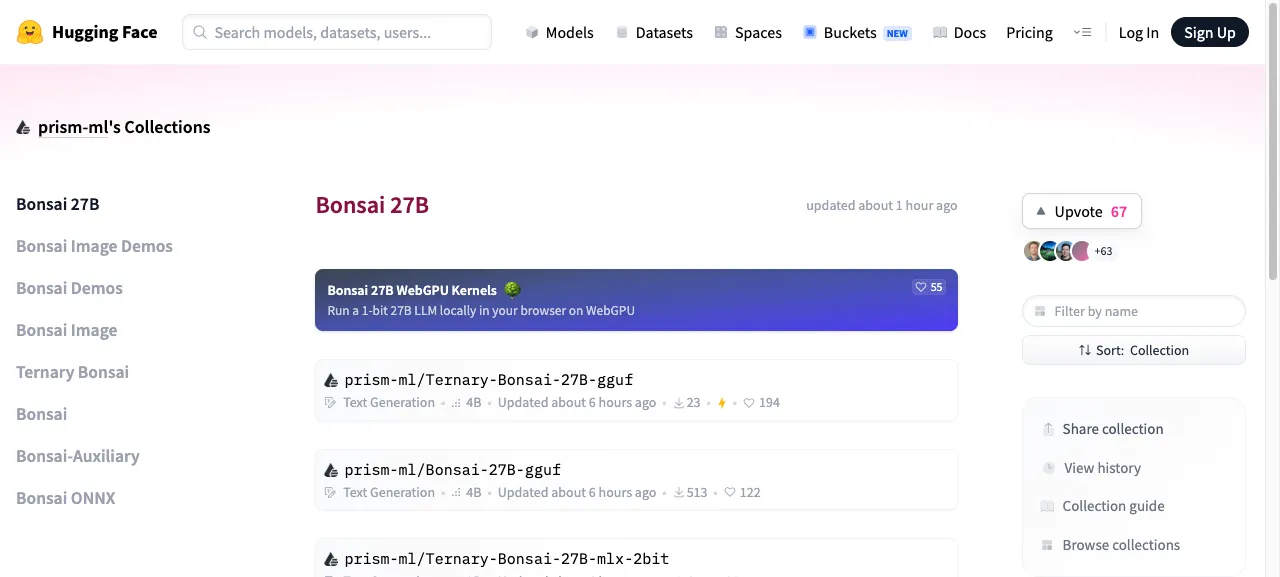
Les poids GGUF, MLX et ONNX sont disponibles sur Hugging Face et GitHub sous licence Apache 2.0. Les principaux dépôts sont prism-ml/Bonsai-27B-gguf pour la version 1 bit et prism-ml/Ternary-Bonsai-27B-gguf pour la version ternaire, accompagnés de versions MLX 2 bits et ONNX. Prévoyez environ 4 Go de stockage libre et de RAM pour la version 1 bit, et 6 Go pour la ternaire. Une réserve toutefois : l’écosystème logiciel n’avait pas encore totalement rattrapé la sortie. Les poids se chargent dans plusieurs runtimes, mais les applications locales populaires telles que LM Studio ne les prenaient pas encore pleinement en charge au lancement ; attendez-vous donc à quelques réglages manuels.
Via une API hébergée
Si vous préférez ne pas gérer les poids vous-même, Together.ai héberge la version ternaire derrière une API standard, avec la fenêtre de contexte complète de 262K, les entrées visuelles et le mode JSON. Lors de l’offre de lancement, le prix affiché pour les entrées était de $0.00 par million de tokens. Vérifiez toutefois le tarif actuel avant de bâtir votre budget sur cette base, les prix promotionnels pouvant évoluer.
Bonsai 27B face à Gemma 4 12B QAT
La comparaison qui revient le plus souvent concerne Gemma 4 12B QAT, le modèle de Google entraîné en tenant compte de la quantification. Il pèse environ 7 Go, soit à peine plus que la version ternaire de Bonsai.
Les deux modèles excellent sur des terrains différents. Grâce à sa base de 27B, Bonsai 27B dépasse clairement Gemma en mathématiques et en programmation dans les benchmarks. Gemma se montre généralement plus solide en vision et en appel d’outils ; ses poids un peu plus volumineux et moins agressivement compressés en font un choix plus stable à usage général sur téléphone. Pour un besoin local centré sur le raisonnement et le code, Bonsai est le meilleur candidat. Si les images ou l’appel de fonctions occupent une place importante, Gemma 4 12B QAT est le choix le plus sûr.
À qui s’adresse réellement Bonsai 27B ?
Utilisez Bonsai 27B si vous cherchez une assistance locale, privée et hors ligne pour le raisonnement ou le code, avec un appareil du niveau d’un iPhone 17 Pro ou un portable suffisamment puissant. C’est aussi un sujet d’étude convaincant pour qui s’intéresse à la quantification extrême : faire tourner un modèle 27B dans un onglet de navigateur marque une vraie étape, et la licence Apache 2.0 facilite les expérimentations. Il s’intègre naturellement parmi les autres modèles ouverts et gratuits intéressants pour programmer lorsqu’une option locale est souhaitée.
En revanche, ne l’utilisez pas encore pour des systèmes agentiques en production dépendant d’un appel d’outils fiable, pour des tâches où la vision est critique, ni pour tout cas où une boucle de raisonnement aurait un coût élevé. Dans ces situations, un modèle moins compressé, ou un modèle en pleine précision accessible par API, reste une option plus sûre.
Questions fréquentes
Bonsai 27B est-il gratuit ?
Les poids sont gratuits sous licence Apache 2.0 : vous pouvez donc les télécharger et les exécuter sans frais. L’accès hébergé via Together.ai relève de sa propre tarification API, affichée à $0.00 par million de tokens d’entrée au lancement. Vérifiez le tarif en vigueur.
Bonsai 27B peut-il vraiment tourner sur un téléphone ?
Oui. La version 1 bit pèse 3,9 Go et fonctionne sur un iPhone 17 Pro à environ 11 tokens par seconde via l’application Locally AI, entièrement hors ligne une fois téléchargée.
Bonsai 27B est-il aussi bon que Qwen3.6 27B en pleine précision ?
Il s’en approche, sans être identique. La version ternaire conserve plus de 95 % des performances de benchmark en pleine précision, et la version 1 bit plus de 90 %. La conservation est la meilleure en mathématiques et en code, et la moins bonne pour l’appel d’outils.
Quel fichier Bonsai 27B télécharger ?
Sur téléphone ou machine à mémoire limitée, choisissez la version 1 bit (prism-ml/Bonsai-27B-gguf, environ 3,9 Go). Sur un ordinateur de bureau ou un GPU disposant de marge, préférez la version ternaire (prism-ml/Ternary-Bonsai-27B-gguf, environ 5,9 Go) pour récupérer quelques points de précision. Des variantes MLX 2 bits et ONNX existent pour Apple Silicon et les runtimes multiplateformes.
Qu’est-ce que la quantification ternaire ?
Elle consiste à stocker chaque poids du modèle sous l’une de trois valeurs, -1, 0 ou +1, plutôt que sous forme de nombre en pleine précision. C’est ce qui permet de réduire aussi fortement la taille du modèle. Des facteurs de mise à l’échelle FP16 maintiennent les poids compressés à un ordre de grandeur approximativement correct.
Bonsai 27B prend-il en charge les images ?
Oui. Il accepte des images en entrée en plus du texte et renvoie une sortie textuelle, en héritant des capacités multimodales de sa base Qwen3.6 27B. La qualité en vision résiste toutefois moins bien à la compression que les performances en mathématiques et en code.