 AIREITER
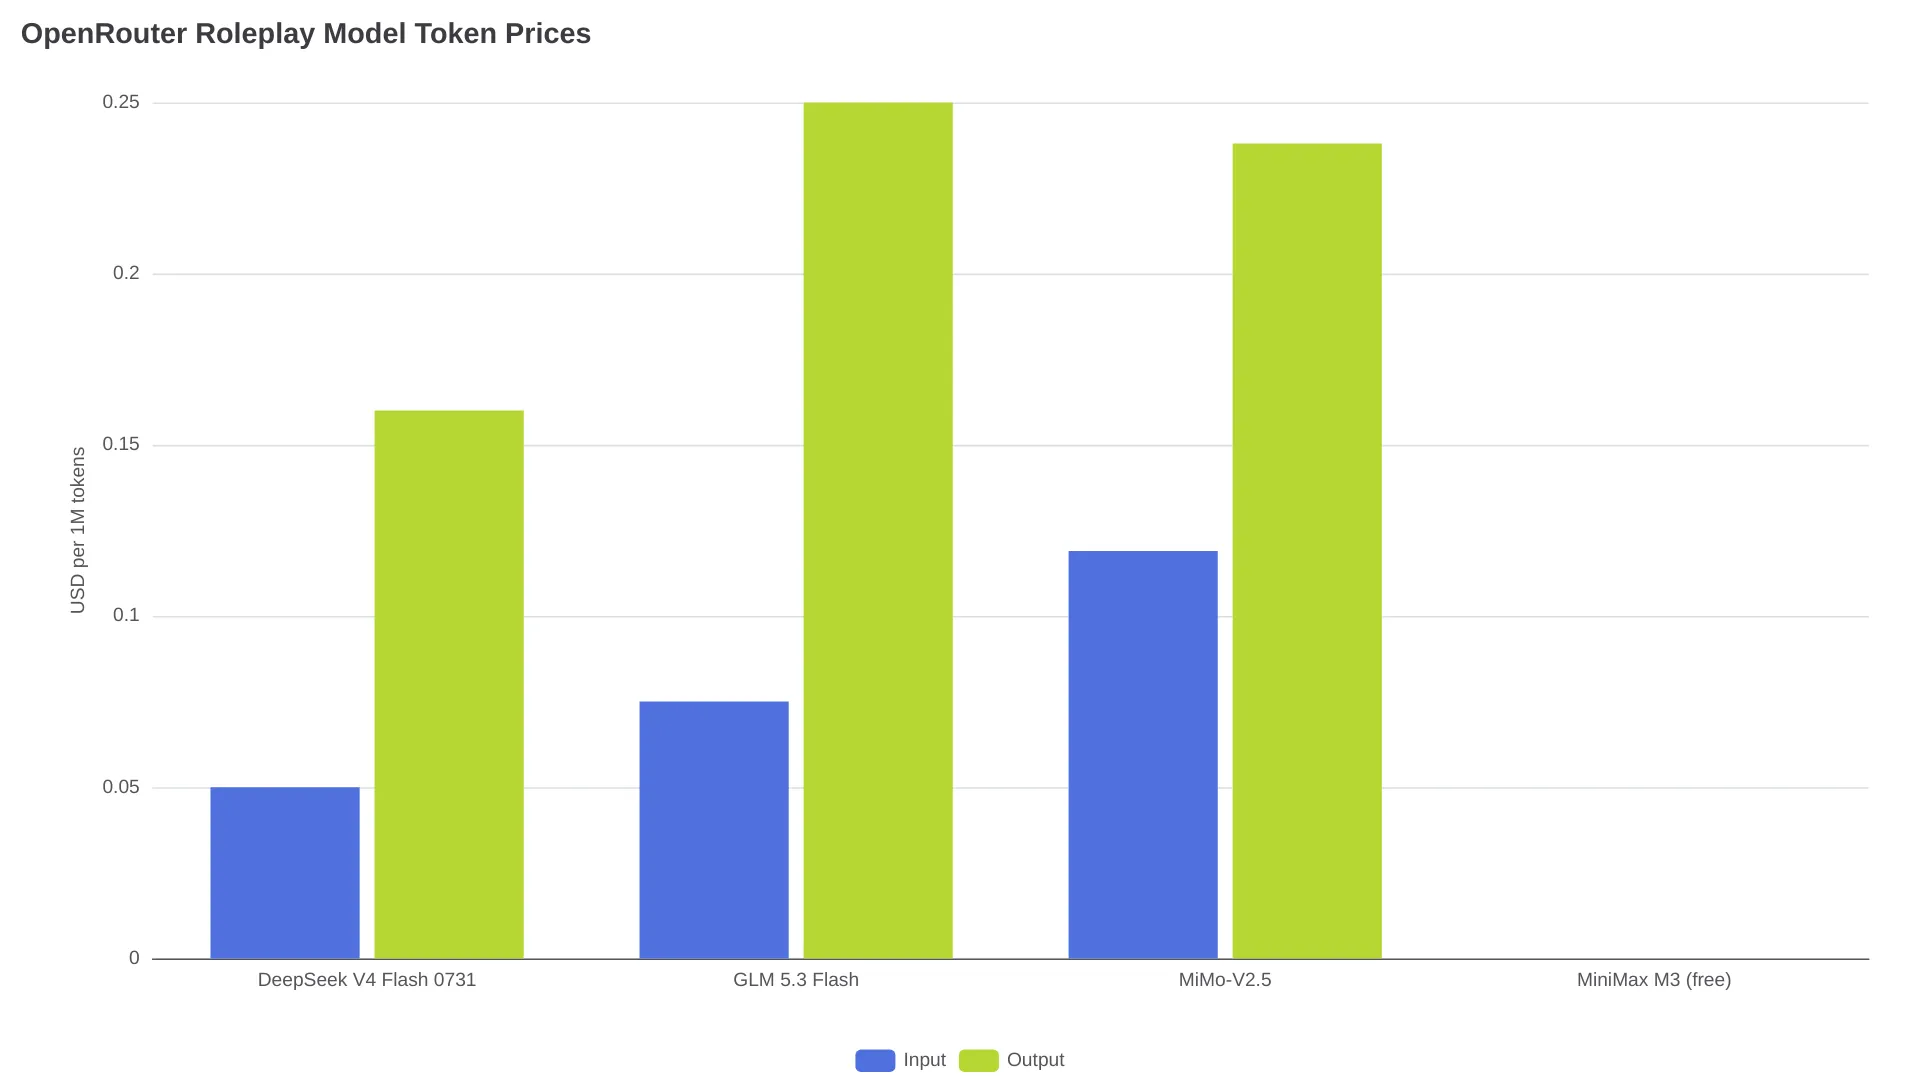
Para elegir un modelo de roleplay en OpenRouter hay tres factores que pesan más que el resto: mantener una voz coherente, disponer de contexto suficiente y poder probar sin gastar. En la instantánea del 2 de septiembre de 2026, DeepSeek V4 Flash 0731 es la referencia de pago que conviene probar primero por relación entre coste y contexto: OpenRouter le asigna un contexto de clase 1M y cobra $0.05 de entrada / $0.16 de salida por millón de tokens. Las rutas gratuitas sirven para hacer pruebas, aunque su capacidad y disponibilidad pueden variar.
Esta guía analiza comportamiento técnico y costes para roleplay ficticio no explícito. No pretende coronar un ganador universal «sin censura» ni publica porcentajes de rechazos sin una prueba controlada y comparable.
Qué modelo de OpenRouter elegir para roleplay en 2026
Fija un modelo de pago y conserva una alternativa gratuita activa; toma el ranking de uso como una señal para crear una lista corta, no como una nota de calidad.
| Caso de uso | Primer modelo que revisar | Por qué encaja | Principal limitación |
|---|---|---|---|
| Referencia de pago por coste y contexto | DeepSeek V4 Flash 0731 | Contexto de clase 1M, $0.05/$0.16 por 1M de tokens y tráfico actual de roleplay en OpenRouter | El uso no equivale a pruebas controladas de RP |
| Prueba priorizando lo gratuito | MiniMax M3 (free) | Aparece en la colección gratuita activa de OpenRouter con un contexto cercano a 1M | La capacidad, los límites y la disponibilidad del acceso gratuito pueden cambiar |
| Comparativa de pago económica | GLM 5.3 Flash | Contexto de clase 1M, 22 proveedores listados y precio temporal de $0.075/$0.25 | El descuento tiene fecha de caducidad y el modelo está orientado al trabajo agéntico |
| Comparativa de precio intermedio | MiMo-V2.5 en la colección de roleplay de OpenRouter | $0.119/$0.238 por 1M de tokens y contexto de 1.05M en la ficha activa | La página citada ofrece datos de catálogo y uso, no una puntuación de RP controlada |
| Alternativa gratuita automática | openrouter/free | Elige una ruta gratuita disponible sin fijar un slug concreto | El modelo subyacente puede cambiar de una solicitud a otra |
Empieza con DeepSeek como referencia de pago, confirma el endpoint gratuito actual de MiniMax M3 antes de depender de él y utiliza GLM 5.3 Flash como segundo control de pago. Esta lista corta se basa en uso actual, precio, contexto y datos de enrutamiento, no en un ranking universal de prosa.
Qué mide realmente el ranking de roleplay de OpenRouter
La colección Roleplay and Creative Writing de OpenRouter es una página de descubrimiento dinámica basada en el uso. En la captura del 2 de septiembre de 2026, DeepSeek V4 Flash ocupa el primer puesto.
El ranking mide uso, no fidelidad a una tarjeta de personaje, conservación de nombres, calidad de la prosa ni tasa de rechazos. Un modelo popular puede ser simplemente barato, rápido, fácil de enrutar o estar ampliamente disponible.
Crea una lista corta a partir de la colección y ejecuta la misma tarjeta segura y la misma escena inicial con dos ID de modelo fijados. Así responderás una cuestión más concreta: qué ruta funciona mejor con tu prompt, tus ajustes y tu presupuesto.
Lista actual de modelos: contexto, precio y disponibilidad
Las cifras siguientes proceden de las páginas de roleplay, modelos gratuitos y modelos individuales de OpenRouter consultadas el 2 de septiembre de 2026. Tanto los precios como el estado gratuito son instantáneas operativas.
| ID del modelo | Contexto mostrado | Precio de entrada / salida por 1M | ¿Se ha visto ruta gratuita? | Qué respaldan los datos |
|---|---|---|---|---|
deepseek/deepseek-v4-flash-0731 | 1,310,720 | $0.05 / $0.16 | Consulta el catálogo activo | Precio de pago listado bajo, 30 proveedores y failover automático |
minimax/minimax-m3 | 1,048,576 | $0.23 / $0.96 de pago | Sí, listado como MiniMax M3 (free) | Contexto amplio y pruebas sin coste mientras el endpoint gratuito esté disponible |
z-ai/glm-5.3-flash | 1,310,720 | $0.075 / $0.25 promocional | Consulta el catálogo activo | 22 proveedores y disponibilidad del 99.89% durante tres días en la instantánea |
xiaomi/mimo-v2.5 | 1.05M | $0.119 / $0.238 | No queda establecido en la página citada | Señal de uso en la colección de roleplay y precio de pago moderado |
openrouter/free | Página del router: 200K | $0 | Router, no un modelo fijo | Práctico para experimentar; la selección aleatoria reduce la reproducibilidad |
DeepSeek V4 Flash 0731: referencia por coste y contexto
DeepSeek V4 Flash 0731 ofrece un contexto de 1,310,720 tokens, hasta 393,216 tokens de completado y un precio listado de $0.05 de entrada / $0.16 de salida por millón de tokens. Su página en OpenRouter muestra 30 proveedores y describe los modos de enrutamiento Balanced, Nitro y Exacto.
Antes de iniciar una campaña larga, compruébalo con la misma tarjeta de personaje: la página del modelo no publica una medición de coherencia del personaje.
MiniMax M3: candidato para probar gratis
La colección de modelos gratuitos de OpenRouter muestra MiniMax M3 a $0 tanto para entrada como para salida, con un contexto indicado de 1.05M. La página de pago de MiniMax M3 indica 1,048,576 tokens de contexto, entrada de texto/imagen/vídeo, salida de texto y precios de pago de $0.23 de entrada / $0.96 de salida por millón de tokens.
La documentación sobre Free Variant de OpenRouter señala que una ruta :free puede tener una disponibilidad y unos límites de tasa distintos de los del modelo de pago. Cuando la reproducibilidad sea importante, selecciona el slug gratuito exacto que aparezca en el catálogo activo; usa openrouter/free solo si aceptas la selección automática.
GLM 5.3 Flash: opción con diversidad de proveedores
GLM 5.3 Flash tiene una ventana de contexto de 1,310,720 tokens y figura a $0.075 de entrada / $0.25 de salida por millón de tokens gracias a un descuento promocional del 50% a través de Z.ai hasta el 9 de septiembre de 2026 a las 16:00 UTC. La página de OpenRouter lista 22 proveedores y una disponibilidad del 99.89% durante tres días.
La ficha presenta GLM 5.3 Flash para programación eficiente y tareas agénticas de largo recorrido, no específicamente para roleplay. Comprueba su encaje en RP con el mismo prompt en lugar de deducirlo de la descripción del producto.
MiMo-V2.5 y otras alternativas
MiMo-V2.5 aparece en la colección de roleplay de OpenRouter con un contexto de 1.05M y precios de $0.119 de entrada / $0.238 de salida. Es un control razonable de precio intermedio, pero la página citada no publica un resultado controlado de roleplay. Guarda un segundo slug exacto antes de que falle una sesión: una alternativa preseleccionada es más predecible que cambiar a un modelo aleatorio.
Prueba de coste para 1.000 rondas: gestionar el contexto cambia la factura
Una ronda de roleplay consta de un mensaje del usuario y una respuesta del asistente. OpenRouter factura por tokens, así que no existe un precio universal por 1.000 rondas; gran parte del coste depende de cuánto historial reenvía el frontend.
Este modelo de planificación parte de 1,000 rondas, 200 nuevos tokens de usuario por ronda, 500 tokens de salida del asistente por ronda y un prompt fijo de personaje/sistema de 2,000 tokens. En el caso de historial completo, las 1.000 solicitudes reenvían una conversación cada vez mayor, hasta sumar aproximadamente 351.85M tokens de entrada y 0.5M tokens de salida.
| Modelo | Escenario de historial compacto: 4M de entrada + 0.5M de salida | Escenario de historial completo: 351.85M de entrada + 0.5M de salida |
|---|---|---|
| DeepSeek V4 Flash 0731 ($0.05/$0.16) | $0.28 | $17.67 |
| GLM 5.3 Flash ($0.075/$0.25) | $0.43 | $26.51 |
| MiMo-V2.5 ($0.119/$0.238) | $0.60 | $41.99 |
| MiniMax M3 de pago ($0.23/$0.96) | $1.40 | $81.41 |
| MiniMax M3 gratis | $0.00, sujeto a límites | $0.00, sujeto a límites |
La columna de historial compacto promedia 4,000 tokens de entrada por solicitud. El historial completo reenvía repetidamente los primeros mensajes, y por eso una ventana de contexto grande no convierte una campaña de 1.000 rondas en algo barato.
Con estos supuestos, el prompt final con historial completo alcanza unos 701,500 tokens de entrada, antes de sumar formato y metadatos adicionales. Una ventana de contexto de 1M puede albergar este ejemplo, pero respuestas más largas, tarjetas mayores, lorebooks o plantillas ocultas podrían superar ese límite. La capacidad de contexto no equivale a memoria automática.
El almacenamiento en caché de prompts puede reducir el coste de la entrada repetida cuando el proveedor y la ruta de solicitud lo admiten. Consulta la página Activity de OpenRouter en vez de asumir que todos los frontends reciben el mismo tratamiento de caché. La guía de precios de OpenRouter explica el modelo general de facturación por tokens.
Qué puede medir una prueba segura de coherencia —y qué no
Una comparación no explícita puede emplear un personaje adulto ficticio, una escena inocua y ajustes idénticos en todos los modelos:
- Incluye tres datos duraderos en la tarjeta de personaje, como profesión, ubicación y objetivo no sensible.
- Exige narración en tercera persona o un único punto de vista bien definido.
- Ejecuta 20 turnos con el mismo inicio y un límite de salida de 400–600 tokens.
- En los turnos 5, 10 y 20, pide al personaje que actúe a partir de un dato anterior sin repetirlo.
- Registra cambios de nombre, contradicciones, cambios de punto de vista no deseados, repeticiones, respuestas vacías y rechazos.
Esto compara tu prompt y tu ruta, no la calidad universal de los modelos. Un rechazo puede proceder del modelo, del proveedor, del clasificador del frontend o del prompt, por lo que esta guía no informa de una tasa de rechazos. Para medir velocidad, registra la latencia hasta el primer token y los tokens generados por segundo en tres ejecuciones idénticas, anotando el modelo y la ruta del proveedor.
Cuánto roleplay permite el nivel gratuito de OpenRouter
La guía oficial de SillyTavern de OpenRouter indica que las cuentas con menos de $10 en créditos comprados reciben 50 solicitudes diarias a modelos gratuitos. Tras comprar al menos $10 en créditos, la guía indica que la asignación pasa a 1,000 solicitudes diarias. También establece un límite de 20 solicitudes por minuto.
Si cada generación del asistente equivale a una ronda, esto supone aproximadamente 50 rondas iniciales o 1.000 rondas iniciales al día. Las regeneraciones, reintentos, solicitudes fallidas y flujos con varios mensajes también consumen solicitudes, así que el número de escenas completadas puede ser menor.
Las dos opciones gratuitas se comportan de forma distinta:
model-name:freefija la variante gratuita de un modelo identificado. Es más reproducible, pero el endpoint puede desaparecer o sufrir límites de tasa.openrouter/freeselecciona automáticamente un modelo gratuito apto. La documentación de Free Models Router de OpenRouter indica que la selección es aleatoria después del filtrado por capacidades, y que la respuesta identifica el modelo subyacente. Resulta cómodo para experimentar, pero la voz del personaje puede cambiar entre solicitudes.
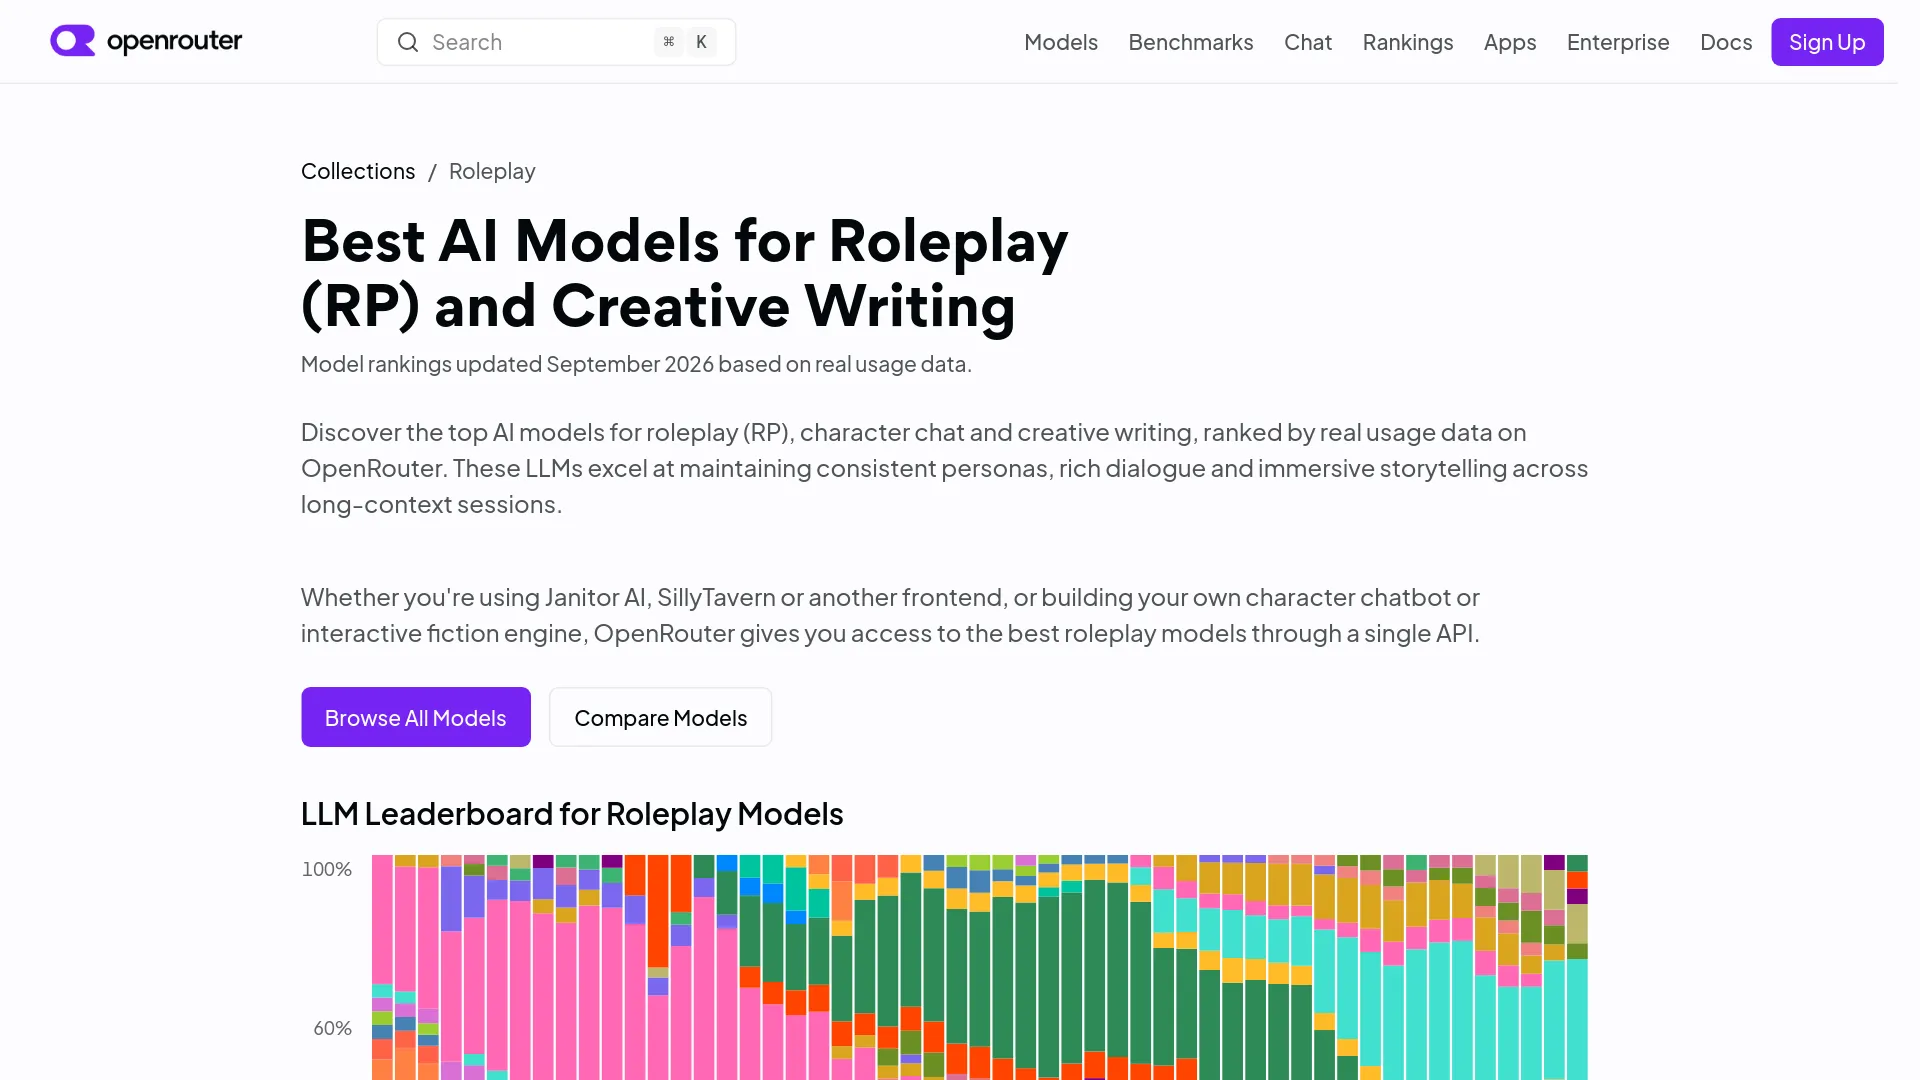
Consulta la colección activa de modelos gratuitos de OpenRouter antes de configurar un frontend. No bases una campaña larga en un slug gratuito copiado de una guía antigua.
Configurar SillyTavern para una sesión estable con OpenRouter
El flujo oficial de OpenRouter usa Chat Completion, no Text Completion. Que la clave se conecte correctamente no garantiza que el modelo elegido, la ruta del proveedor o el tamaño de contexto puedan generar una respuesta.
- Abre el panel API Connections de SillyTavern.
- Selecciona API Type: Chat Completion.
- Selecciona Source: OpenRouter.
- Autoriza mediante el flujo disponible o pega una clave API creada en los ajustes de claves de OpenRouter.
- Haz clic en Connect, selecciona el slug exacto del modelo y envía un Test Message.
- Guarda un perfil de conexión para el modelo de pago y otro para la alternativa gratuita.
Empieza con un tamaño de contexto que admita el endpoint exacto, streaming activado y un límite de salida moderado. Mantén compacta la tarjeta de personaje y resume los turnos antiguos antes de que el prompt se acerque al límite del endpoint. Prueba los ajustes de sampling por separado, ya que pueden alterar la longitud y el ritmo de las respuestas.
Si el desplegable está vacío, vuelve a conectar y actualiza la lista de modelos. Si la conexión funciona pero falla la generación, revisa el slug, los créditos, la disponibilidad del proveedor y el desbordamiento de contexto antes de reescribir el prompt.
Configuración de JanitorAI y solución de errores
La API de OpenRouter es compatible con OpenAI. El endpoint estándar de chat completions que documenta el Quickstart de OpenRouter es:
https://openrouter.ai/api/v1/chat/completionsEl artículo no se apoya en una captura actual de la interfaz de JanitorAI, así que toma lo siguiente como un patrón de integración genérico compatible con OpenAI y comprueba los campos disponibles en tu pantalla actual de JanitorAI:
- Crea una clave API de OpenRouter y mantenla privada.
- Elige la opción actual de API compatible con OpenAI o de API personalizada, si está disponible.
- Introduce la URL completa de chat completions si el campo espera un endpoint de completado.
- Pega el ID actual y exacto del modelo de OpenRouter, incluido
:freepara una variante gratuita. - Guarda, actualiza JanitorAI y prueba con un mensaje breve no explícito.
| Síntoma | Causa probable | Primera solución |
|---|---|---|
| 401 o token no válido | La clave es incorrecta, ha caducado o se pegó con caracteres adicionales | Regenera la clave y vuelve a pegarla; no uses una clave pública compartida |
| 404 o endpoint inexistente | El slug del modelo o la URL están desactualizados | Copia el slug actual desde OpenRouter y verifica el endpoint completo |
| 429 | Límite diario o por minuto del modelo gratuito, o sobrecarga del proveedor | Espera, reduce los reintentos, cambia a la alternativa fijada o usa una ruta de pago |
| Respuesta vacía | Ruta no compatible, límite de salida o desbordamiento de contexto | Reduce los ajustes de contexto/salida y prueba el modelo directamente en OpenRouter |
| El bot olvida el inicio | El frontend recortó el historial anterior | Reduce el tamaño del prompt, resume turnos antiguos y ajusta el contexto al endpoint |
| Rechazo o cambio brusco de estilo | Política del proveedor o una ruta alternativa distinta | Comprueba el modelo/proveedor real y usa un prompt de prueba neutral; «sin censura» no es una garantía |
Privacidad, enrutamiento de proveedores y cumplimiento
Las FAQ de OpenRouter indican que registra metadatos básicos de las solicitudes, como marcas de tiempo, modelo y recuentos de tokens, mientras que los prompts y completados no se registran por defecto salvo que el usuario lo autorice. Los proveedores upstream pueden contar con sus propias políticas de retención y entrenamiento.
Zero Data Retention puede limitar el enrutamiento a proveedores que cumplan la política de retención seleccionada, pero puede eliminar algunas rutas gratuitas. El acceso gratuito no garantiza privacidad, y «sin censura» no es una propiedad técnica estable: los proveedores pueden aplicar sus propias políticas y el enrutamiento puede cambiar qué proveedor atiende una solicitud.
Utiliza prompts ficticios no explícitos y no intentes eludir las salvaguardas de los proveedores.
Preguntas frecuentes
¿Cuál es ahora mismo el mejor modelo de OpenRouter para roleplay?
DeepSeek V4 Flash 0731 es la referencia de pago por coste y contexto que comparar en esta instantánea. Combina evidencia de uso actual para roleplay en OpenRouter con un contexto de clase 1M y precios de $0.05/$0.16 por millón de tokens, pero no representa una puntuación universal de calidad obtenida mediante pruebas controladas.
¿Cuál es el mejor modelo gratuito de OpenRouter para roleplay?
No hay un ganador permanente: MiniMax M3 es el candidato prioritario para probar gratis en la colección activa consultada aquí, mientras que openrouter/free es más cómodo pero menos reproducible.
¿Cuánto cuestan 1.000 rondas de roleplay?
Con los supuestos de esta guía, el uso con historial compacto cuesta alrededor de $0.28 con DeepSeek V4 Flash 0731 y $0.43 con GLM 5.3 Flash; el uso con historial completo se estima en $17.67 y $26.51, respectivamente.
¿Una ventana de contexto mayor evita que el modelo olvide?
No. El contexto es el máximo que puede aceptar el endpoint, no una garantía de que todos los detalles se utilicen correctamente; los resúmenes y los límites sobre los turnos recientes siguen siendo importantes.
¿Por qué mi modelo de roleplay rechazó una petición o cambió de comportamiento?
Es posible que hayan cambiado el proveedor, la ruta alternativa, el endpoint gratuito o el límite práctico de contexto; verifica el ID y la ruta reales del modelo antes de considerar un solo rechazo como una característica de todo el modelo.
Ejecuta la misma tarjeta segura de 20 turnos con DeepSeek V4 Flash 0731 y un endpoint gratuito actual, y guarda ambos como perfiles con nombre. La ruta de pago ofrece precios y disponibilidad más predecibles; la gratuita permite experimentar a cambio de una capacidad y una identidad de modelo cambiantes.