 AIREITER
En FinanceBench —368 documentos de la SEC, unas 53.900 páginas y 150 preguntas— Mistral afirma que su nueva capa Agentic Search elevó la precisión de las respuestas entre 47 y 53 puntos porcentuales frente a un RAG de una sola pasada mediante un bucle basado solo en búsqueda. Con el ciclo completo de navegación, la mejora llegó hasta los 59 puntos y el uso de tokens se redujo hasta en un tercio. La contrapartida está en la latencia: el bucle completo todavía registra 154 segundos en p90 y 71 segundos de media.
Mistral Agentic Search, anunciado el 20 de agosto de 2026, es una capa de recuperación pensada para corpus empresariales complejos, como informes regulatorios, contratos y PDF escaneados. No mejora la búsqueda web: profundiza en tu propia base documental. Y esos ciclos de varios minutos son el precio de ganar precisión.
Qué aporta Mistral Agentic Search
Mistral Agentic Search es una capa de recuperación lanzada el 20 de agosto de 2026 que añade, sobre un índice ya existente, un proceso de varios pasos con cinco herramientas: search, open, navigate, read y grep. Está disponible mediante el Mistral Search Toolkit e integrada en Libraries, tanto en Studio como en Vibe. El índice sigue siendo tuyo y no requiere fine-tuning: el bucle agente se encarga de las preguntas que la recuperación por fragmentos, por sí sola, no logra resolver.
Así funciona el ciclo de cinco herramientas
El ejemplo de Mistral sobre el gasto de defensa nacional de Estados Unidos en el año natural 1953 ilustra bien el mecanismo. Una única llamada de búsqueda encontró las cifras de enero a junio, pero dejó fuera las de julio a diciembre. El recorrido agente realizó dos búsquedas, localizó treasury_bulletin_1954_02.pdf, leyó la página 15 y la Tabla 3, y devolvió los doce valores mensuales: un total anual de 44.463 millones de dólares.
| Herramienta | Para qué sirve |
|---|---|
search | Consulta el índice para localizar fuentes probables |
open | Abre un documento encontrado |
navigate | Se desplaza a páginas, tablas o secciones dentro del documento |
read | Extrae el contenido de esa ubicación |
grep | Busca coincidencias exactas de tokens, códigos o identificadores |
Un RAG de una sola pasada recupera un conjunto fijo de fragmentos y debe responder de inmediato; si la recuperación es deficiente, no puede pedir otro documento. El bucle, en cambio, puede contrastar fuentes, seguir referencias hacia notas al pie y tablas, y corregir resultados parciales. Según Mistral, el intercambio no implica más reintentos y turnos desperdiciados, sino menos.
Qué muestran realmente los benchmarks
El anuncio incluye dos conjuntos de pruebas, ambos comunicados por el proveedor y ejecutados con la configuración predeterminada de Search Toolkit, sin ajustes. Mistral resume su postura así: «estos resultados son suelos, no techos». FinanceBench (Islam et al., 2023; publicación abierta en GitHub) reúne 368 documentos SEC 10-K, 10-Q y 8-K, de unas 147 páginas cada uno según el recuento de Mistral, y 150 preguntas. En la configuración de Mistral, un LLM calibrado frente a etiquetas humanas evalúa las respuestas.
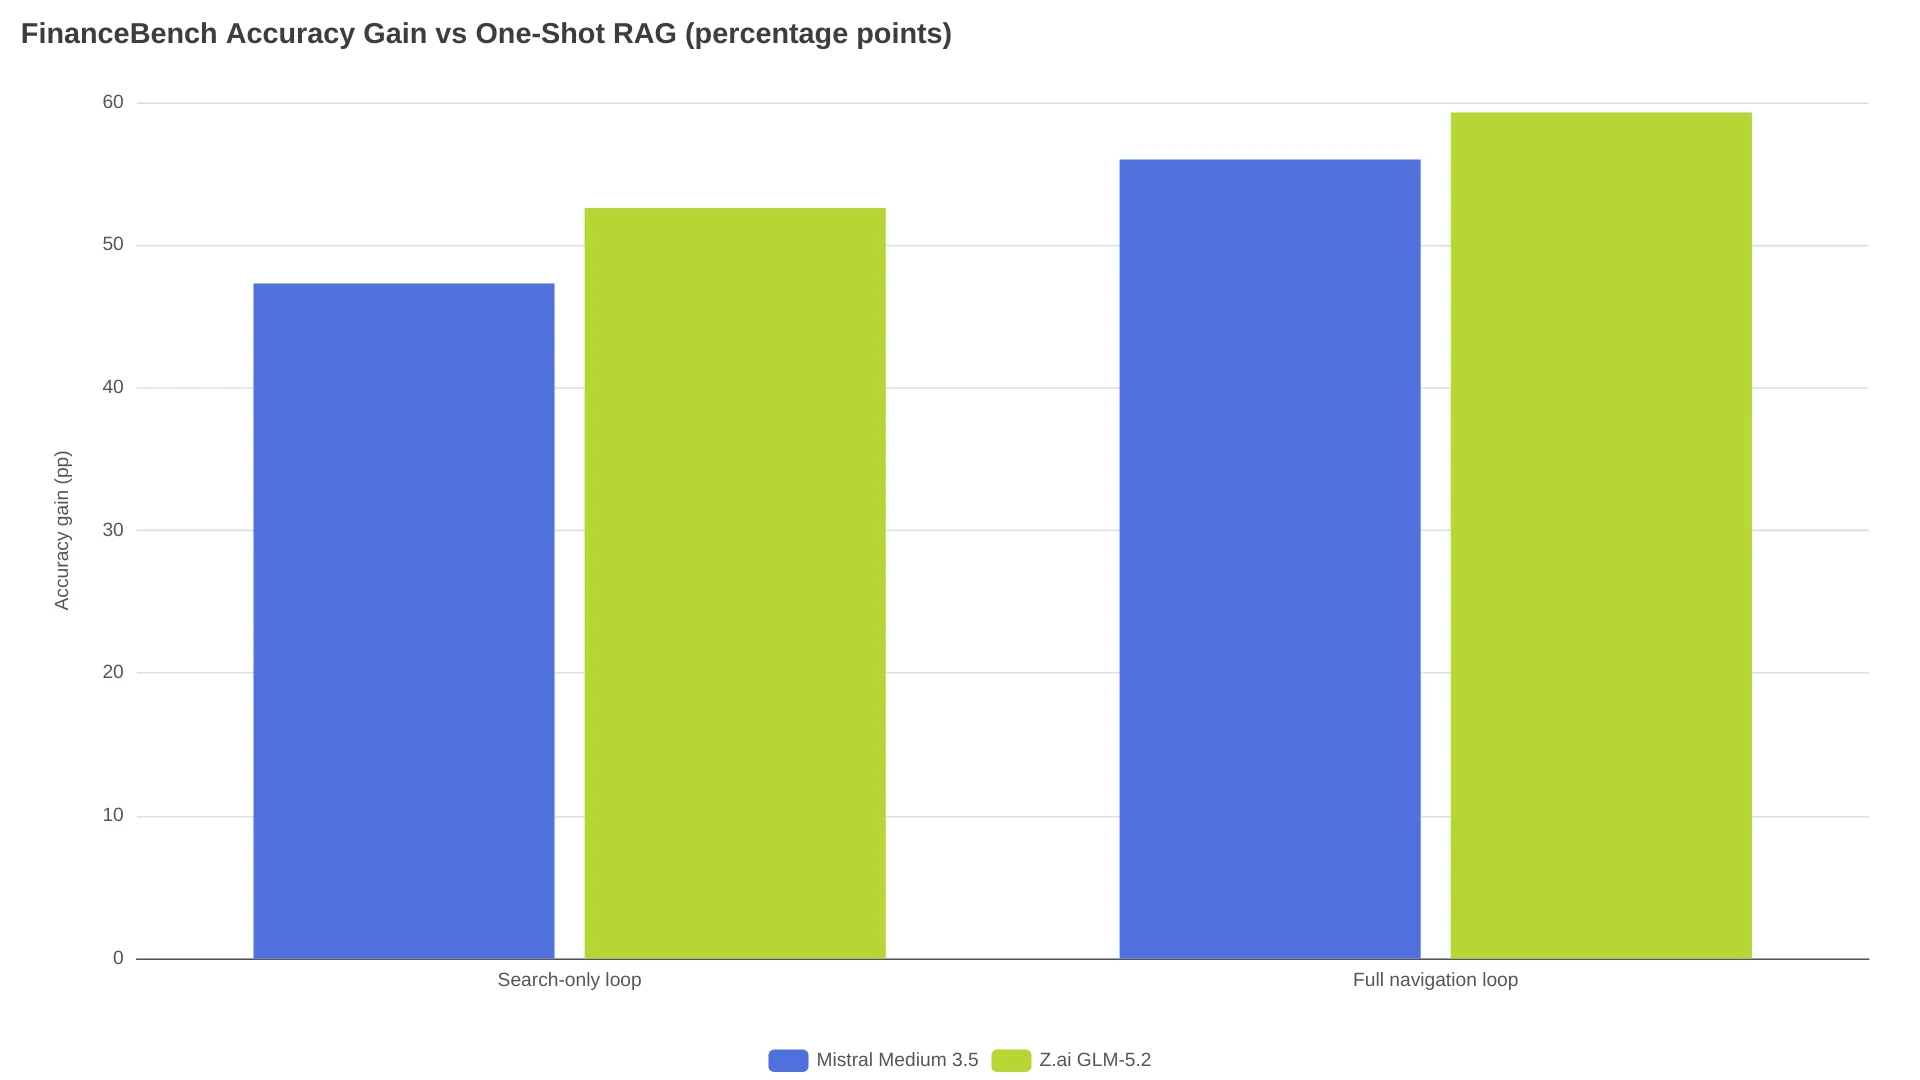
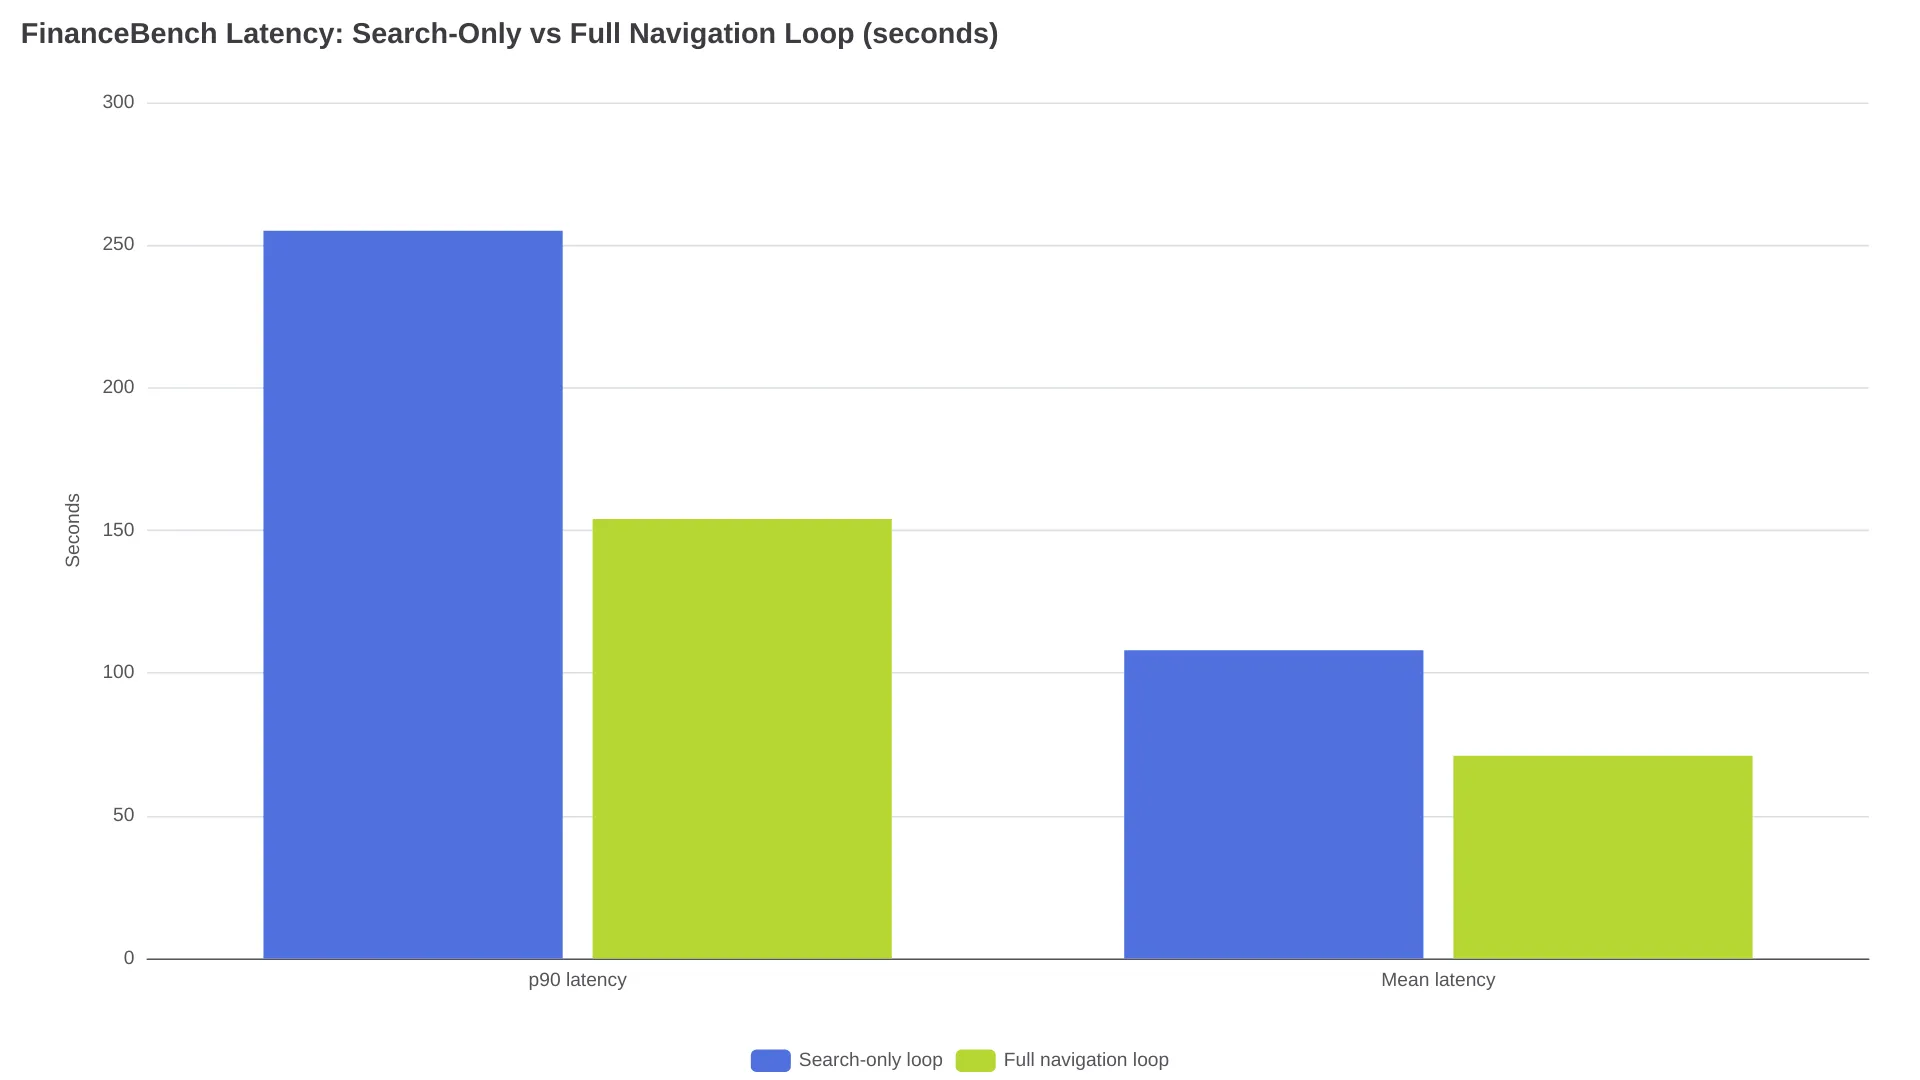
Al añadir las herramientas de navegación —open, navigate, read y grep— al bucle basado solo en búsqueda, Mistral Medium 3.5 suma otros +8,7 pp y GLM-5.2 otros +6,7 pp. Frente a ese bucle de búsqueda, el ciclo completo de navegación utilizó un 23,9% menos de tokens con Mistral Medium 3.5 y un 33,7% menos con GLM-5.2. La latencia también baja: el p90 pasa de 255 a 154 segundos y la media, de 108 a 71 segundos. Importa el punto de comparación: la reducción de tokens se mide frente al bucle agente basado solo en búsqueda, no frente al RAG de una sola pasada.
OfficeQA Pro es el conjunto más exigente: 696 históricos Treasury Bulletins de Estados Unidos, cerca de 89.000 páginas de PDF gubernamentales escaneados y cargados de tablas, y 133 preguntas. GLM-5.2 alcanzó un 51,9% de precisión con el bucle completo, un salto de +45,6 pp que implica una base de 6,3% en una sola pasada; Mistral Medium 3.5 mejoró +27,1 pp. La navegación añadió hasta un 7,0% menos de turnos.
Mistral evaluó tanto su propio Mistral Medium 3.5 como el Z.ai GLM-5.2 de terceros, y ambos mejoraron siguiendo el mismo patrón. El anuncio también menciona una investigación de Kimi que sitúa a GLM-5.2 en un 41,4% en OfficeQA Pro con un entorno de Claude Code, frente al 51,9% obtenido con el entorno de Mistral. No enlaza una fuente primaria de Kimi, por lo que esa diferencia de 10,5 pp entre entornos es una caracterización de Mistral. La conclusión de la compañía —«la calidad de la recuperación escala con la capacidad del modelo»— es que el cuello de botella está en el entorno, no en el modelo.
Cuándo sigue siendo mejor un RAG de una sola pasada
La propia Mistral señala que la recuperación indexada sigue siendo la base, y reserva el bucle agente para los casos en que los resultados iniciales no bastan. La decisión depende sobre todo de la estructura de los documentos y del presupuesto de latencia:
| Tipo de carga de trabajo | Punto de partida recomendado |
|---|---|
| Consultas directas en documentos cortos y limpios | RAG de una sola pasada |
| Recuperación semántica o por palabras clave de gran volumen | RAG de una sola pasada |
| Respuestas situadas en ubicaciones conocidas | RAG de una sola pasada |
| Informes regulatorios, contratos o manuales con tablas y notas al pie | Agentic Search |
| PDF escaneados con muchas tablas | Agentic Search |
| Respuestas repartidas entre varios documentos que deben conciliarse | Agentic Search |
| Requisitos de latencia interactiva, de segundos | RAG de una sola pasada |
Si un p90 de 154 segundos rompe tu producto, ninguna mejora de precisión lo compensa. El análisis por lotes de estados financieros es un escenario muy distinto.
Agentic Search no es la herramienta web_search
Al buscar este producto, Google muestra la documentación de websearch de Mistral, pero es otra cosa. Las herramientas web_search y web_search_premium pertenecen a la Agents API, recuperan información de la web en directo con citas y cuestan 30 y 50 dólares por cada 1.000 llamadas, respectivamente, según la página de precios de la API de Mistral, además de los tokens del modelo. Agentic Search funciona en la dirección contraria: explora tu propio corpus indexado y no consulta la web abierta. Resuelven problemas distintos, y solo uno tiene precios publicados; el anuncio no incluye tarifas de Agentic Search.
Dos formas de empezar
- Search Toolkit. Módulos abiertos para ingesta, embeddings e indexación, desplegables en la nube o en entornos on-premises, con parsers configurables, chunking, modelos de embeddings, esquemas de Vespa, perfiles de ranking y recuperación híbrida.
- Libraries de Studio y Vibe. La vía gestionada. Una Search Starter App puede crear un índice local sobre tu corpus con la configuración predeterminada; es la forma más rápida de reproducir el entorno de los benchmarks antes de ajustar nada.
Elijas la ruta que elijas, ejecuta las mismas preguntas representativas con RAG de una sola pasada y con el bucle completo. Compara calidad de respuesta, uso de tokens y latencia p90 antes de comprometerte.
Lo que todavía se desconoce en el lanzamiento
Mistral no ha publicado los precios de Agentic Search y los resultados de los benchmarks proceden del propio proveedor; en el lanzamiento no había ninguna réplica práctica independiente disponible. Las primeras reacciones públicas son impresiones iniciales:
«mistral acaba de añadir búsqueda agéntica a su api y es el movimiento correcto. incorporar una búsqueda al estilo Perplexity como herramienta nativa de agente nos evita crear pipelines frágiles de scraping web y gestionar nosotros mismos la rotación de proxies». — @AbdoKerdawy, desarrollador de productos de IA (X)
Las afirmaciones sobre tokens ya han recibido críticas que el anuncio de Mistral no responde por completo:
«La herramienta de recuperación de búsqueda agéntica de Mistral afirma reducir en más de un 40% los fallos de búsqueda de una sola pasada. Si evita las consultas a bases de datos, ¿reducirá la cantidad de tokens que necesitas gastar?». — @therawlogs, bloguero independiente (X)
La respuesta oficial es la reducción de tokens del 24–34% frente al bucle de solo búsqueda. Si eso se mantiene fuera de los corpus de benchmark es, precisamente, lo que resolvería una ejecución independiente sobre el conjunto abierto FinanceBench.
Los productos cercanos se enfrentan a la misma realidad: el modo de búsqueda agéntica Toast-1 de Mixedbread limita su ciclo a cuatro rondas y ocho llamadas de recuperación paralelas, y su propia documentación deja claro que es más lento que una búsqueda única. La latencia es el impuesto que los proveedores de esta categoría pagan por mejorar la precisión.
Respuestas directas
¿Mistral Agentic Search está disponible mediante la Agents API?
No. Se distribuye mediante Mistral Search Toolkit y Libraries en Studio y Vibe; la herramienta web_search de la Agents API es un producto independiente de búsqueda web en directo, con precios propios.
¿Agentic Search reduce realmente el uso de tokens?
Según los benchmarks oficiales, el bucle completo de navegación utilizó entre un 23,9% y un 33,7% menos de tokens que un bucle agente basado solo en búsqueda en FinanceBench; todavía no se ha publicado una réplica independiente.
¿Qué modelos funcionan con Agentic Search?
Mistral probó Mistral Medium 3.5 y Z.ai GLM-5.2, con mejoras consistentes en ambos casos, y describe la capa como agnóstica respecto al modelo y sin necesidad de fine-tuning.
¿Cuánto cuesta Mistral Agentic Search?
Agentic Search no tiene precios publicados. La cifra de 30 dólares por cada 1.000 llamadas que aparece en la página de precios de Mistral corresponde a la anterior herramienta agente web_search.
La disyuntiva pendiente es sencilla: aquí se compra precisión a cambio de minutos. Para trabajo por lotes sobre informes regulatorios, contratos y registros gubernamentales escaneados, un salto de precisión de +45 a +59 pp —los resultados del bucle completo en OfficeQA Pro y FinanceBench, respectivamente— y un recorte de un tercio de los tokens frente a un bucle más lento pueden ser un intercambio razonable. Para cualquier experiencia orientada al usuario, 71 segundos de latencia media siguen siendo inaceptables. Y mientras alguien ajeno a Mistral no repita FinanceBench, las cifras más contundentes de esta página seguirán siendo las del proveedor.
Lecturas relacionadas: la guía de la API de GLM-5.2 y el análisis de GLM-5.2 cubren el segundo modelo de benchmark utilizado en las pruebas de Mistral.