 AIREITER
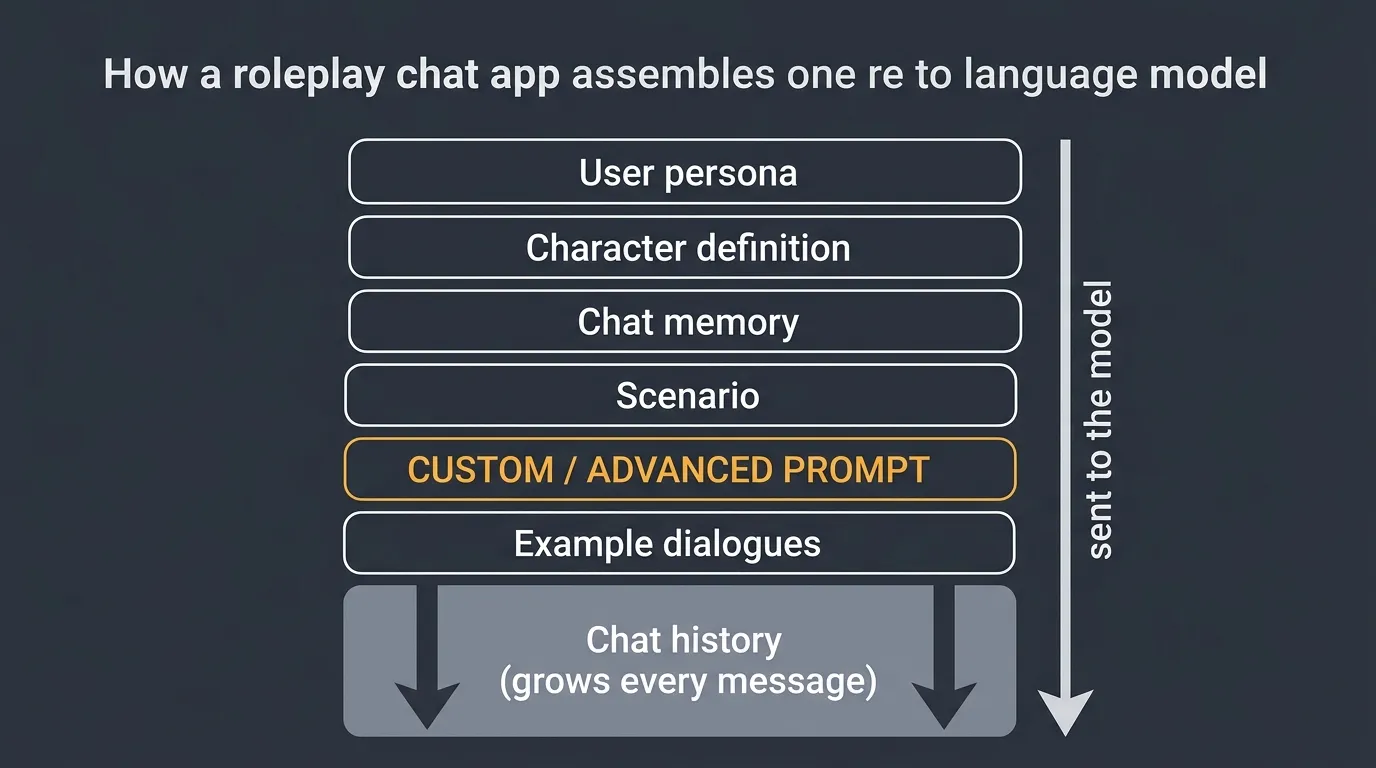
Cuando un prompt de Janitor AI «deja de funcionar», muchas veces no lo han sobrescrito: simplemente ha quedado enterrado. Las descripciones públicas del orden de envío de la plataforma sitúan el historial del chat después de tu bloque de instrucciones, así que cada mensaje nuevo aleja un poco más tus reglas del final de la entrada que recibe el modelo. Los bloques breves y centrados en un síntoma concreto aguantan mejor ese desplazamiento; los prompts maestros de 800 palabras, no.
Identifica el síntoma antes de pegar nada
Todas las fuentes que se citan a continuación describen el mismo puñado de campos que llegan al modelo como bloques separados: la definición del personaje, tu persona, Chat Memory y el campo del prompt. Elegir el campo equivocado es una de las razones más habituales por las que un prompt copiado parece no hacer nada. Busca la fila que encaje con lo que estás viendo y cambia una sola cosa.
| Lo que ves | Causa más probable | Ajuste mínimo |
|---|---|---|
| El bot escribe los diálogos de tu personaje | El primer mensaje o los diálogos de ejemplo ya hablan por ti | Corrige el texto de origen y añade después el bloque de agencia |
| Las reglas funcionan durante 20 turnos y luego se diluyen | El prompt ha quedado enterrado bajo el historial acumulado | Repite la única regla crítica en Chat Memory |
| Las respuestas se convierten en ensayos | No hay ninguna regla de longitud, o las del personaje y el prompt se contradicen | Una sola regla sobre el número de párrafos, indicada una vez |
| El bot repite tu propio mensaje | Los turnos recientes han reforzado ese patrón | Borra o edita las respuestas problemáticas y añade la línea para no repetir |
| El prompt parece ignorarse por completo | El contenido permanente superó el presupuesto de contexto y fue recortado | Recorta el prompt, no la historia |
| El mismo prompt se comporta de forma distinta al cambiar de modelo | El prompt estaba dimensionado para el contexto de un proxy, pero se está usando en JLLM | Vuelve a dimensionarlo según la tabla de más abajo |
Hay dos hábitos que ayudan más que cualquier plantilla: cambiar una sola variable en cada prueba y conservar la versión anterior para poder volver atrás.
Dónde queda el prompt y qué sobrevive en el turno 80
Janitor AI ensambla una petición distinta en cada turno a partir de varios bloques, y el campo que editas no es necesariamente lo último que lee el modelo. Las descripciones públicas de ese orden difieren en algunos detalles, pero coinciden en lo importante.
| Fuente | Posición del campo del prompt | Qué viene después |
|---|---|---|
| Guía comunitaria de chatbots (personalidad, memoria del chat, escenario, prompt avanzado, mensajes recientes) | 4.º de 5 | Mensajes recientes |
| rshtola/jai-info, observado en la ruta de proxy en abril de 2026 | 2.º, justo después del prompt global | Persona del personaje, escenario, persona del usuario, diálogos de ejemplo, resumen y lorebook |
| Análisis de problemas de prompts centrados en la ruta JLLM | 5.º de 6 | Toda la conversación |
En los tres casos, la conversación se añade después del bloque ensamblado. Ese único dato explica un problema que aparece una y otra vez en los hilos de la comunidad: la regla se sigue enviando, pero tiene que competir con varios miles de tokens de texto más reciente. También explica algo que muchos usuarios perciben sin saber por qué: una línea OOC insertada en el mensaje puede seguir guiando la respuesta mucho después de que el prompt permanente haya perdido fuerza. La línea OOC llega al final.
El documento de jai-info añade un detalle importante si utilizas un proxy. Los campos vacíos se eliminan en lugar de enviarse como secciones en blanco, y el prompt personalizado es uno de los pocos bloques que Janitor no envuelve en etiquetas como <Scenario> o <UserPersona>. Tu texto queda ahí sin etiqueta, así que conviene darle su propia línea de encabezado si quieres que el modelo lo interprete como un conjunto de reglas.
La consecuencia práctica es clara: todo lo que deba mantenerse en el turno 80 no puede vivir únicamente en el campo del prompt. Usa Chat Memory para un resumen breve que puedas mantener actualizado cuando cambien los hechos, y reserva el campo del prompt para el comportamiento general de las respuestas. Comprueba el resultado en el turno 80 en lugar de dar por hecho que esta separación siempre se mantiene.
Cinco bloques de prompt, un problema cada vez
Los cuatro primeros van en el campo Advanced Prompt o Custom Prompt; el quinto pertenece a Chat Memory. Pega uno, ejecuta seis turnos y consérvalo solo si puedes describir la diferencia. Apilar los cinco de golpe es la forma más rápida de acabar con un prompt imposible de depurar.
Evita que el bot hable por tu personaje
Es una queja recurrente en r/JanitorAI_Official y el caso en el que la formulación importa más. Especifica lo que el bot sí debe escribir, en lugar de limitarte a decirle lo que no debe hacer.
Write only {{char}}, the world, and side characters.
{{user}}'s dialogue, actions, thoughts and decisions belong to {{user}} alone.
When {{char}} would need {{user}}'s response, end the reply on the action or question that invites it.
Treat {{user}}'s latest message as the current truth of the scene.
Un hilo comunitario de resolución de problemas muy citado combina este bloque con una definición explícita de las macros en la persona: escribe {{user}} = Name y deja claro que {{user}} no es {{char}}. Conviene mantener las expectativas bajo control. En un hilo largo sobre bots que se apropian del personaje del usuario, alguien valoró la solución estándar así:
«Funciona en un 80 %» — u/NextCompetition6019, r/JanitorAI_Official
Limita la longitud sin cargarte la descripción
Default to 2–3 paragraphs. Expand only when {{user}} asks for detail.
Lead with what {{char}} does and says in the current moment.
Open each reply with new material rather than restating {{user}}'s message.
La parte de no repetir importa más que el número de párrafos: si el modelo vuelve a contar lo que acabas de escribir, se come media respuesta antes de aportar nada nuevo a la historia.
Fija el punto de vista y el tiempo verbal
Narrate {{char}} in close third person, present tense.
Keep dialogue in quotation marks and actions in plain prose.
Match the register of {{user}}'s writing rather than escalating it.
La línea sobre el registro es la que más suele omitirse. Ayuda a frenar la deriva hacia una prosa recargada y, en una ruta que tiende a imitar tu forma de escribir, le da al modelo algo concreto que copiar.
Mantén la escena en movimiento
Advance one meaningful beat per reply.
Let {{char}} act on their own motives instead of waiting for instructions.
Leave at least one thread unresolved at the end of each reply.
Utiliza este bloque solo con bots pasivos. Combinado con el límite de longitud puede producir escenas atropelladas, así que prueba ambas reglas juntas antes de conservarlas.
Un bloque de resumen para Chat Memory
Este no va en el campo del prompt.
Place: [where the scene is happening]
Goal: [what {{char}} wants right now]
Fact: [one confirmed thing about the relationship]
Open thread: [what is unresolved]
Correction: [the most recent thing {{user}} fixed]
El artículo de ayuda Advanced Prompting 101 de Janitor AI aparece citado en numerosas guías comunitarias por recomendar un resumen breve, en vez de seguir añadiendo instrucciones, cuando un chat largo empieza a olvidar cosas. Reescribir cinco líneas consume menos contexto que añadir otro párrafo de reglas.
Escribe reglas que el modelo pueda ejecutar
Ese mismo artículo de ayuda desaconseja construir reglas a partir de «no», «no hagas», «nunca» y «para», porque nombrar una conducta hace que siga presente en la entrada: «no sangre» todavía contiene la palabra sangre. La otra frase que más se cita es repetición = ruido. Expresar una misma regla de cinco maneras distintas añade tokens, no cumplimiento.
La solución es una cláusula de encaminamiento. Reescribe cada regla negativa para que indique la acción alternativa.
| En lugar de | Escribe |
|---|---|
| «Nunca hables por {{user}}» | «Escribe únicamente los diálogos, pensamientos y acciones de {{char}}» |
| «No me preguntes qué quiero hacer después» | «Cuando {{char}} necesite indicaciones, haz que {{char}} realice una acción por su cuenta» |
| «No seas repetitivo» | «Empieza cada respuesta con un acontecimiento que todavía no haya ocurrido» |
| «Evita las respuestas cortas» | «Da a cada respuesta dos párrafos: uno de acción y otro con una línea de diálogo» |
«Evita» y «abstente de» tampoco son atajos, porque siguen introduciendo la conducta no deseada en el prompt. Además, si la ficha del personaje o los diálogos de ejemplo muestran aquello que estás intentando prohibir, normalmente gana la ficha. Corrige la fuente antes de añadir otra regla.
Dimensiona el prompt para el modelo que estés usando
Un prompt escrito para un contexto de proxy de 32k tokens y pegado después en una sesión gratuita de JLLM es la causa silenciosa de muchos avisos de «este preset está roto». Advanced Prompting 101 se cita por la cifra relevante en este caso: aproximadamente entre 8.000 y 9.000 tokens de contexto operativo en JLLM, compartidos entre la persona, la definición del personaje, la memoria, el escenario, tu prompt y toda la conversación.
| Configuración | Contexto operativo (según análisis de configuraciones de proxy) | Tamaño razonable del prompt |
|---|---|---|
| JLLM (integrado y gratuito) | ~8k–9k tokens | 3–5 reglas breves; los presets largos expulsan parte de la historia |
| DeepSeek mediante proxy | habitualmente configurado entre 16k y 32k | Reglas más 2–3 intercambios de ejemplo |
| GLM mediante proxy | similar a DeepSeek | Lo mismo; vuelve a probar las reglas de formato después del cambio |
Como regla práctica para hacer cuentas, calcula aproximadamente 1.000 tokens por cada 750 palabras. Los mismos análisis que sitúan el prompt en quinto lugar de seis fijan un máximo de 2.000 tokens para todo el contenido permanente; es decir, la persona, la ficha, la memoria y el prompt juntos. La guía comunitaria de chatbots rebaja aún más el listón y advierte de que un prompt avanzado de más de unos cientos de tokens empieza a desplazar la definición del personaje que pretendía complementar.
JLLM y un modelo externo pueden llevar al mismo bot en direcciones distintas, así que trata el cambio de ruta como una decisión de configuración del proxy y vuelve a probar el prompt en lugar de asumir que se comportará igual.
Los comandos entre corchetes como <JAILBREAK=ON> o <AUTOPLOT=ON> también circulan como si fueran ajustes de Janitor AI. Las listas que los publican los describen como comandos para determinados proxies, junto a funciones exclusivas del proxy como los códigos de lorebook y el cambio de modelo por petición, y la documentación oficial de Janitor AI no los define. En una ruta sin ese analizador no significan nada especial, así que ocupan espacio del prompt como texto plano.
¿Merece la pena conservar un prompt personalizado?
Aquí hay una división real, y no separa a principiantes de expertos. En 2023, un moderador principal de Janitor AI publicó que los prompts personalizados «pueden afectar mucho al comportamiento de tus bots» y que dejar los bots sin uno «puede mejorar» el rendimiento, aunque después matizó que todo depende de probar y comparar. Los hilos que defienden alguna variante de borrar el AP reaparecen con frecuencia y las respuestas se dividen: algunas personas aseguran que JLLM genera resultados más limpios al vaciar el campo; otras notan una mejora clara al sustituirlo por un bloque más largo.
Ambos resultados encajan con el orden de envío. Un prompt puede aportar la estructura que le falta a una ficha vaga, pero también puede duplicar una buena ficha mientras compite con los ejemplos, la memoria y la conversación reciente.
Por eso la pregunta no es «¿mi prompt es bueno?», sino «¿este bot necesita uno?». Ejecuta los mismos seis turnos iniciales dos veces: una con el campo vacío y otra con un único bloque. Puntúa cada ejecución en cuatro aspectos:
- ¿Escribió diálogos o acciones para tu personaje?
- ¿Mantuvo la voz durante las seis respuestas?
- ¿La escena avanzó o se quedó estancada y repetitiva?
- ¿Aceptó una corrección a mitad de la escena?
Haz dos rondas de esa prueba antes de sacar conclusiones. Si en la segunda ronda sigue sin haber cambios, el problema no está en la redacción. Está en la ficha, el primer mensaje o la ruta del modelo; añadir otro párrafo de reglas solo le quita contexto a la historia.
Preguntas frecuentes sobre los prompts de Janitor AI
¿Dónde pego un prompt de Janitor AI?
Abre los ajustes de API o de generación del chat y busca el campo Advanced Prompt cuando utilices la ruta JLLM, o el campo Custom Prompt si estás conectado mediante un proxy.
¿Cuál es la diferencia entre un prompt avanzado y un prompt personalizado?
En la comunidad, Advanced Prompt suele referirse al campo de JanitorLLM y Custom Prompt a su equivalente para APIs externas y proxies. Ambos transmiten el comportamiento general de las respuestas, pero ocupan posiciones distintas en la petición ensamblada, así que vuelve a probar el bloque después de cambiar de ruta.
¿Por qué mi prompt de Janitor AI dejó de funcionar después de un tiempo?
El historial del chat se añade después del bloque del prompt, por lo que tus reglas se alejan cada vez más del final de la entrada con cada mensaje. Acorta el prompt, mueve a Chat Memory la regla que no puedes perder y utiliza una línea OOC insertada en el mensaje para corregir una sola respuesta.
¿Funcionan {{char}} y {{user}} dentro de un prompt personalizado?
Sí. Son las macros estándar para el personaje y tu persona, y la plantilla observada en la ruta de proxy sustituye esos mismos marcadores. Aun así, los creadores de bots suelen escribir {{user}} = Name en la persona para eliminar una variable de las pruebas.
¿Cuánto debería ocupar un prompt de Janitor AI?
Entre tres y cinco reglas en JLLM, algo más en un contexto de proxy de 16k–32k y menos de 2.000 tokens para todo el contenido permanente combinado. Cinco reglas que llegan intactas son mejores que veinticinco que terminan truncadas.
El dilema de fondo sigue sin resolverse. Un prompt lo bastante corto para conservar su influencia en el turno 80 resulta demasiado breve para especificar todo lo que quieres, y no he encontrado ninguna comparación pública y controlada entre JLLM y los modelos de proxy habituales que permita saber dónde está exactamente ese límite. Hasta que exista, la opción más defendible es usar un bloque pequeño, guardar una copia de la versión que funcionó y estar dispuesto a dejar el campo vacío cuando un bot bien construido no lo necesite.
Lecturas relacionadas
- Plantilla de persona para Janitor AI cubre la parte de
{{user}}dentro de la misma pila de contexto - Mejores modelos de IA para roleplay explica cómo elegir el modelo que debe soportar tu prompt