 AIREITER
El repositorio original facebookresearch/demucs está en modo solo lectura desde el 1 de enero de 2025. Aun así, Demucs sigue siendo una de las mejores opciones gratuitas para separar stems en tu propio equipo, siempre que lo instales desde el fork que publicó la versión v4.1.0 y tengas claro que la guitarra y el piano son los primeros elementos que empiezan a degradarse.
Parte del repositorio mantenido de Demucs, no del archivado
Hay dos repositorios de GitHub con el mismo README, pero solo uno sigue recibiendo correcciones. facebookresearch/demucs está archivado y es de solo lectura; de hecho, su propio README remite a otra ubicación. La casa mantenida del proyecto es adefossez/demucs, donde su autor, Alexandre Défossez, explica que este es "el Demucs mantenido oficialmente ahora que he dejado Meta para incorporarme a Kyutai", aunque avisa de que hay que "esperar respuestas lentas y ninguna función nueva por ahora".
La diferencia afecta a los comandos de instalación, no solo a la URL.
Qué cambió en v4.1.0
La entrada de las notas de versión fechada el 11/07/2026 presenta Demucs v4.1.0 con "un empaquetado modernizado, dependencias de inferencia más ligeras, numerosas correcciones y modelos preentrenados alojados en Hugging Face". En la práctica:
| Elemento | Repositorio archivado | Repositorio mantenido (v4.1.0) |
|---|---|---|
| Versión mínima de Python | 3.8 | 3.10 |
| Ejecución más rápida | pip install -U demucs | uvx demucs MY_TRACK.mp3 (sin paso de instalación) |
| Instalación permanente | pip install -U demucs | uv tool install demucs (pip sigue funcionando) |
| ffmpeg | Obligatorio | Opcional; necesario para exportar a FLAC y para formatos que sphn no puede decodificar |
| Modelos cuantizados | Incluidos | Necesitan el extra: uvx "demucs[quantized]" -n mdx_q MY_TRACK.mp3 |
| Alojamiento de los pesos | dl.fbaipublicfiles.com | Hugging Face |
Hay una trampa importante antes de abrir una incidencia: PyTorch dejó de admitir los Mac con Intel después de la versión 2.2, lo que limita a sus usuarios a Python 3.12. Por eso se les recomienda ejecutar uvx --python 3.12 demucs.
Cómo elegir modelo: htdemucs, htdemucs_ft, htdemucs_6s y mdx
El flag -n permite seleccionar el modelo, y el predeterminado no siempre es la mejor opción. Demucs ofrece modelos de cuatro fuentes —batería, bajo, otros y voces—, un experimento de seis fuentes y los modelos MDX, más antiguos.
| Modelo | Fuentes | Velocidad | Advertencia oficial | Cuándo elegirlo |
|---|---|---|---|---|
htdemucs | 4 | Referencia (predeterminado) | Ninguna indicada | Primera pasada, trabajos por lotes y cualquier tarea en la que importe el rendimiento |
htdemucs_ft | 4 | ~4× más lento | "podría ser algo mejor" | Exportaciones finales de una pista importante |
htdemucs_6s | 6 | Entre los dos anteriores | La guitarra es "aceptable"; el piano "no funciona demasiado bien", con "mucho bleeding y artefactos" | Necesitas específicamente un stem de guitarra y puedes tolerar resultados irregulares |
hdemucs_mmi | 4 | Referencia | Arquitectura v3, reentrenada | Compararlo cuando v4 suene mal en una mezcla concreta |
mdx / mdx_extra | 4 | Referencia | mdx_extra se entrenó con datos que incluían el conjunto de prueba MUSDB | Material antiguo o situaciones en las que los artefactos de v4 resulten molestos |
mdx_q / mdx_extra_q | 4 | Los más rápidos y pequeños | "La calidad puede ser ligeramente peor" | Equipos con poco almacenamiento y previsualizaciones rápidas |
Fíjate en el matiz de htdemucs_ft: necesita cuatro veces más cómputo para conseguir una mejora de calidad que el propio autor solo describe como posible. En una CPU, la penalización es enorme, y los usuarios lo dejan claro.
Qué miden realmente las cifras de 9.00 y 9.20 dB de SDR
Las dos cifras aparecen en el mismo párrafo del README, pero no son equivalentes. Hybrid Transformer Demucs alcanza 9.00 dB de SDR en el conjunto de prueba MUSDB HQ. El resultado superior de 9.20 dB requiere kernels de atención dispersa y ajuste fino por fuente; además, ese modelo disperso "no se proporciona porque necesita código CUDA personalizado que todavía no está listo para publicarse".
Por tanto, ningún modelo descargable reproduce los 9.20 dB. En la tabla comparativa del propio README, la versión v4 ajustada que se distribuye aparece con 9.0 de SDR global, empatada con Band-Split RNN entrenado con 1.7k mezclas.
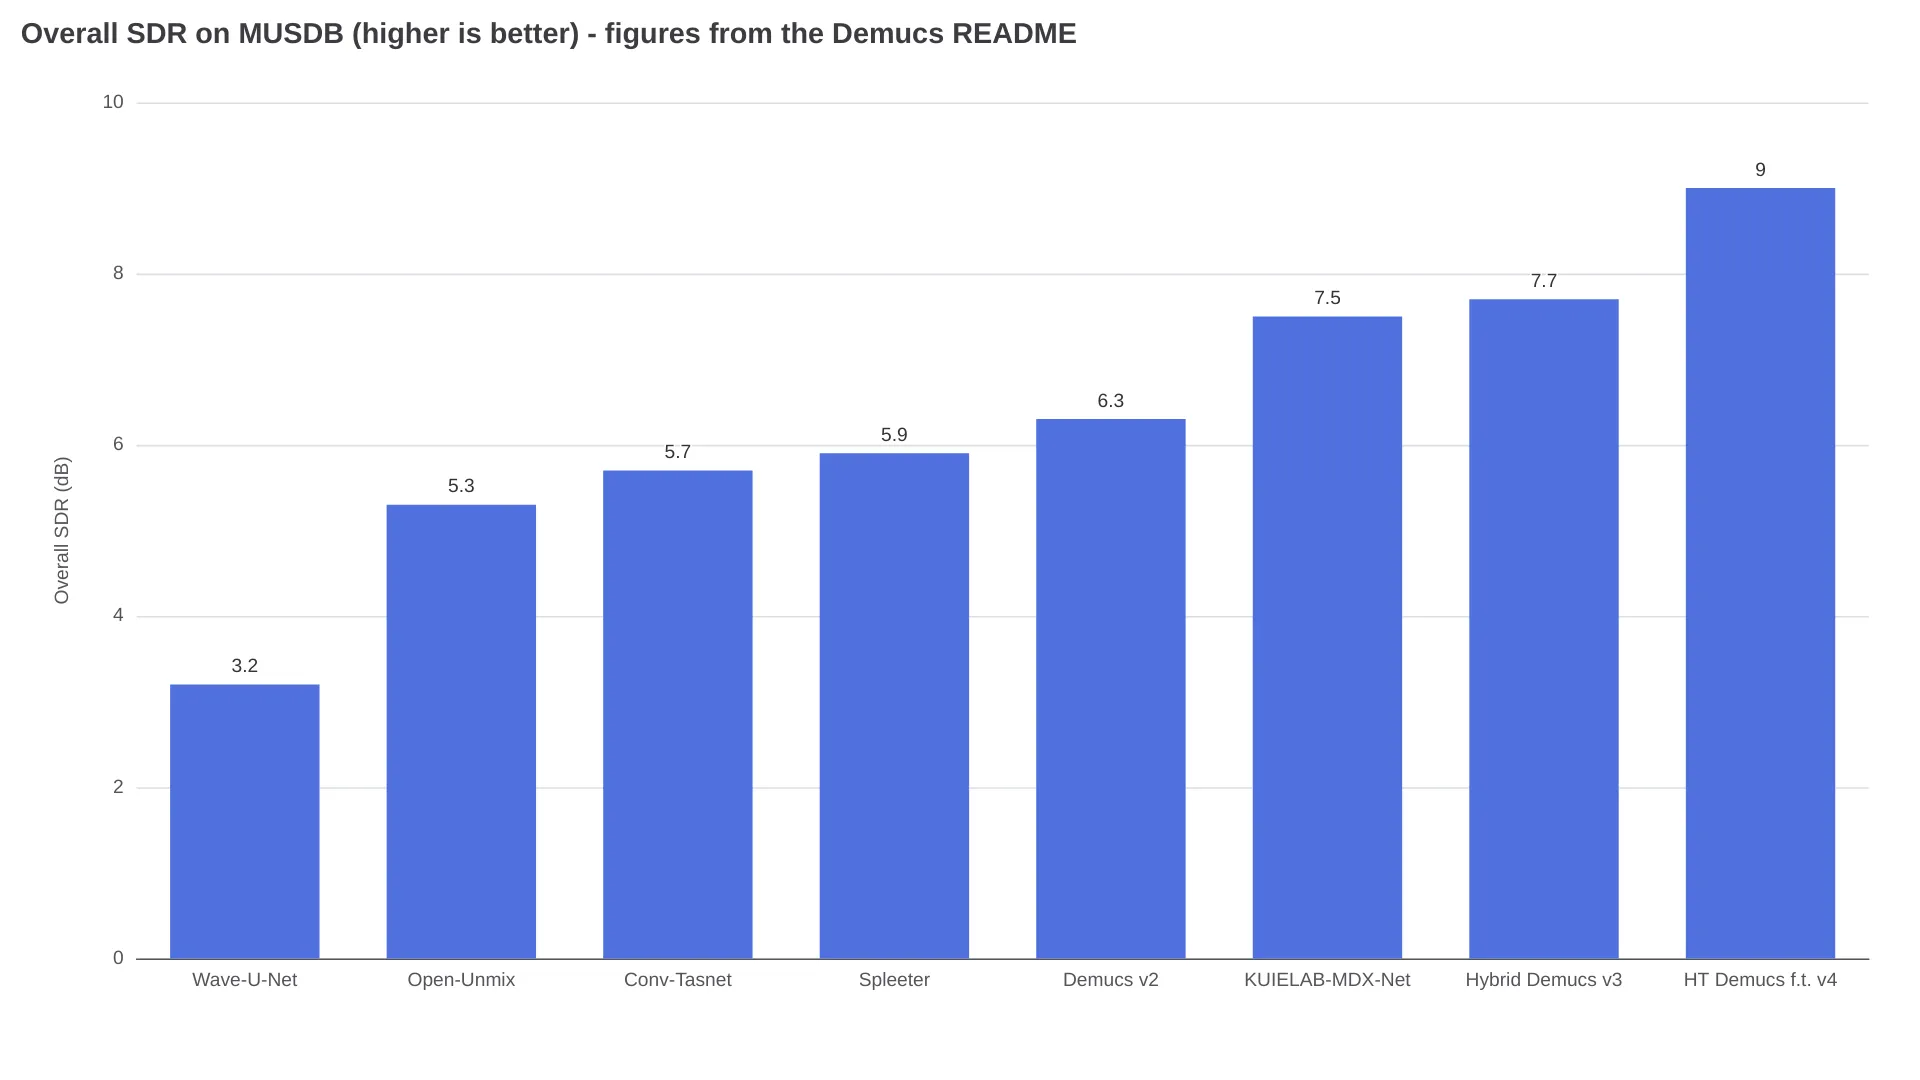
En esa misma tabla, Spleeter se queda en 5.9 dB pese a haberse entrenado con 25k canciones: una diferencia de aproximadamente 3 dB frente a la versión v4 ajustada.
Los flags que cambian el resultado
La mayoría de ejecuciones de Demucs exigen tomar tres decisiones: cuántos stems quieres, cuánto cómputo estás dispuesto a gastar y en qué formato guardar el resultado.
--two-stems=vocalsactiva el modo karaoke y generavocals.wavyno_vocals.wav. Primero separa la mezcla completa y después hace la mezcla de salida, así que no consume menos tiempo ni memoria que una ejecución normal.--shifts=Npromedia N predicciones sobre entradas desplazadas aleatoriamente. Hace que la predicción tarde N veces más; el README recomienda "no usarlo salvo que tengas una GPU". El artículo científico empleó 10 desplazamientos; el valor predeterminado en Replicate es 1.--overlapusa 0.25 por defecto, aunque puedes bajarlo a 0.1 para obtener una pequeña mejora de velocidad.--segment Nes el control clave cuando aparece un error de memoria insuficiente, pero hay un detalle que rompe muchos comandos copiados: los modelos Hybrid Transformer admiten una longitud máxima de segmento de 7.8 segundos. Por eso, un valor largo de--segmentsolo tiene efecto en los modelos que no son HT.- Flags de salida:
--mp3(320 kbps por defecto),--flac(requiere ffmpeg),--int24y--float32. La salida predeterminada es un WAV int16 a 44.1 kHz enseparated/MODEL_NAME/TRACK_NAME. --clip-modeimporta más de lo que parece: por defecto, Demucs reajusta el nivel de los stems para evitar clipping, lo que puede romper el volumen relativo entre ellos. Conclamp, en cambio, aplica un límite duro.
La documentación ofrece estas referencias de hardware: al menos 3 GB de memoria de GPU, unos 7 GB con los argumentos predeterminados y --segment 8 junto con PYTORCH_NO_CUDA_MEMORY_CACHING=1 si tienes 3 GB o menos. En CPU, "el tiempo de procesamiento debería ser aproximadamente 1.5 veces la duración de la pista". Es una estimación optimista comparada con lo que algunos usuarios obtienen al usar htdemucs_ft.
Dónde pierde Demucs y el arreglo en dos pasadas que usan los usuarios
El bleeding aparece una y otra vez como principal queja, sobre todo cuando las voces comparten registro con un instrumento protagonista. Ryan Herr (@rrherr) lo resumió así después de intentar una extracción:
demucs dejó que se filtrara mucho saxofón en la pista de 'vocals'.
La solución a la que llegan muchos usuarios experimentados no es un flag, sino un segundo modelo. El productor japonés 夜凪P (@yonagip, 145 Me gusta) explica que primero ejecuta una pasada con MelBand Roformer en UVR5 para separar las voces del instrumental y después pasa únicamente el instrumental por htdemucs_ft para extraer batería, bajo y otros:
Demucs単体だとVoが他に漏れるんだけど (con Demucs por sí solo, las voces se filtran a los demás stems)
Otros dos testimonios apuntan en la misma dirección: un productor obtiene una definición de bajo mejor con htdemucs_ft, pero calcula que el procesamiento en CPU es cuatro veces más lento (@hachi_vm); otro publica una comparación de extracción de guitarra en la que htdemucs-6s pierde claramente frente a un modelo BS-RoFormer (@junon_12). Son experiencias anecdóticas, no benchmarks, pero encajan con la postura oficial: cuando Défossez anunció el modelo de seis fuentes en diciembre de 2022, escribió que había observado "algo de bleeding + artefactos".
Regla práctica: si la fuente contiene un saxofón, una guitarra solista o un piano con un papel melódico, considera que una sola pasada de Demucs es el punto de partida, no un resultado listo para entregar. Si necesitas una segunda pasada, puedes acceder a alternativas de la familia Roformer desde la interfaz de UVR5.
Usar Demucs como API en lugar de instalarlo
Si quieres obtener stems sin preparar un entorno de Python, una opción alojada muy utilizada es cjwbw/demucs en Replicate: suma aproximadamente 1,5 millones de ejecuciones en hardware Nvidia T4. La propia página estima un coste de alrededor de $0.020 por ejecución (unas 50 ejecuciones por dólar), y normalmente las predicciones terminan en menos de 90 segundos.
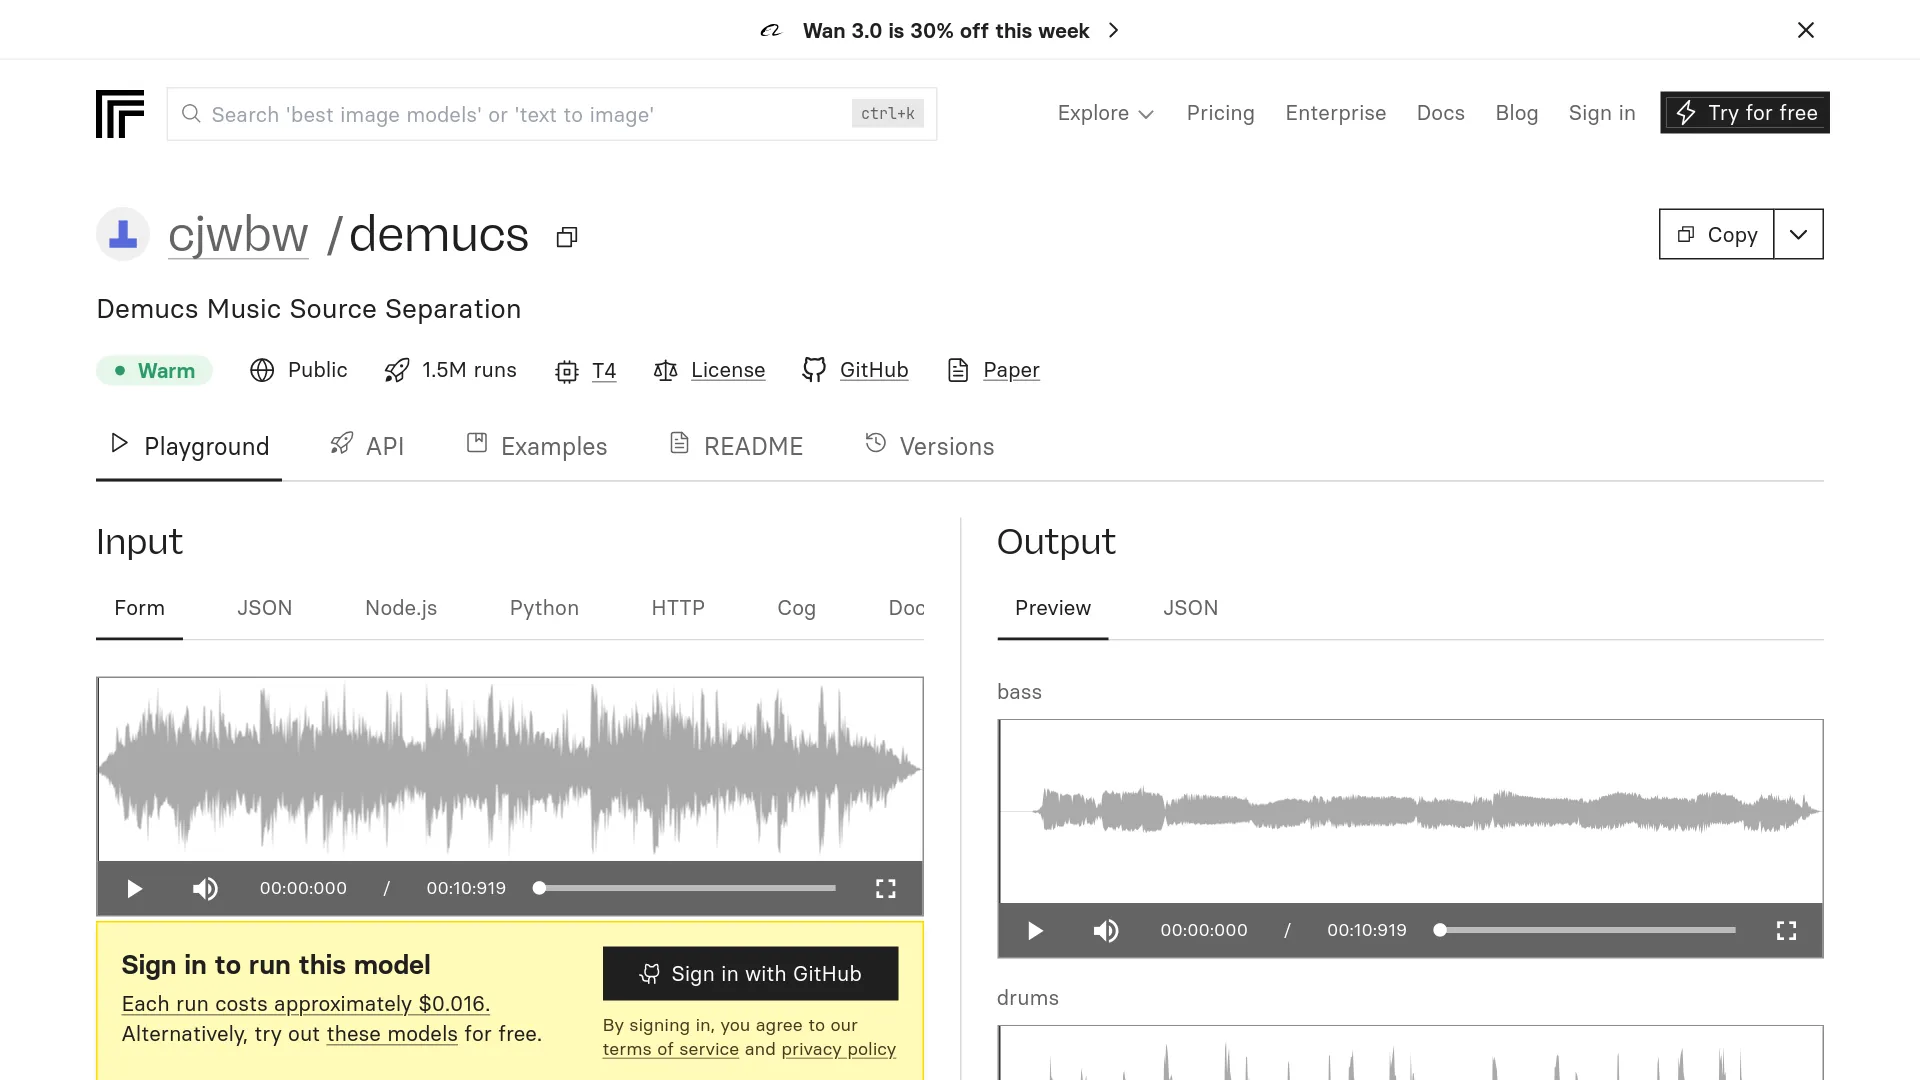
El esquema de entrada refleja el CLI: model_name (predeterminado htdemucs), stem, shifts (predeterminado 1), overlap (0.25), clip_mode (rescale), mp3_bitrate (320), float32 y output_format (mp3).
Hay una salvedad que la página no te señalará: su última versión data de hace aproximadamente tres años, y un endpoint alojado fija una instantánea concreta. Estás llamando a esa compilación, no al empaquetado ni al trabajo sobre dependencias de v4.1.0 de julio de 2026. Además, el tiempo de ejecución varía más de lo que sugiere la cifra principal: un ejemplo público de predicción en ese mismo modelo tardó 6 minutos y 18 segundos.
Cuánto cuesta realmente una pista de 4 minutos
El dato que acaba determinando el flujo de trabajo es el coste por pista, y depende de un detalle de facturación que mucha gente descubre después de suscribirse.
LALAL.AI calcula el consumo como duración del archivo × número de tipos de separación seleccionados. Por tanto, separar una canción de 4 minutos en cuatro stems consume 16 minutos, no 4.
La misma página de precios muestra recargas puntuales (comprobadas el 25 de septiembre de 2026): $50 por 750 minutos de Fast Queue, $190 por 3.000 y $300 por 5.000. Con esas tarifas, separar cuatro stems de una canción de 4 minutos cuesta entre $0.96 y $1.07.
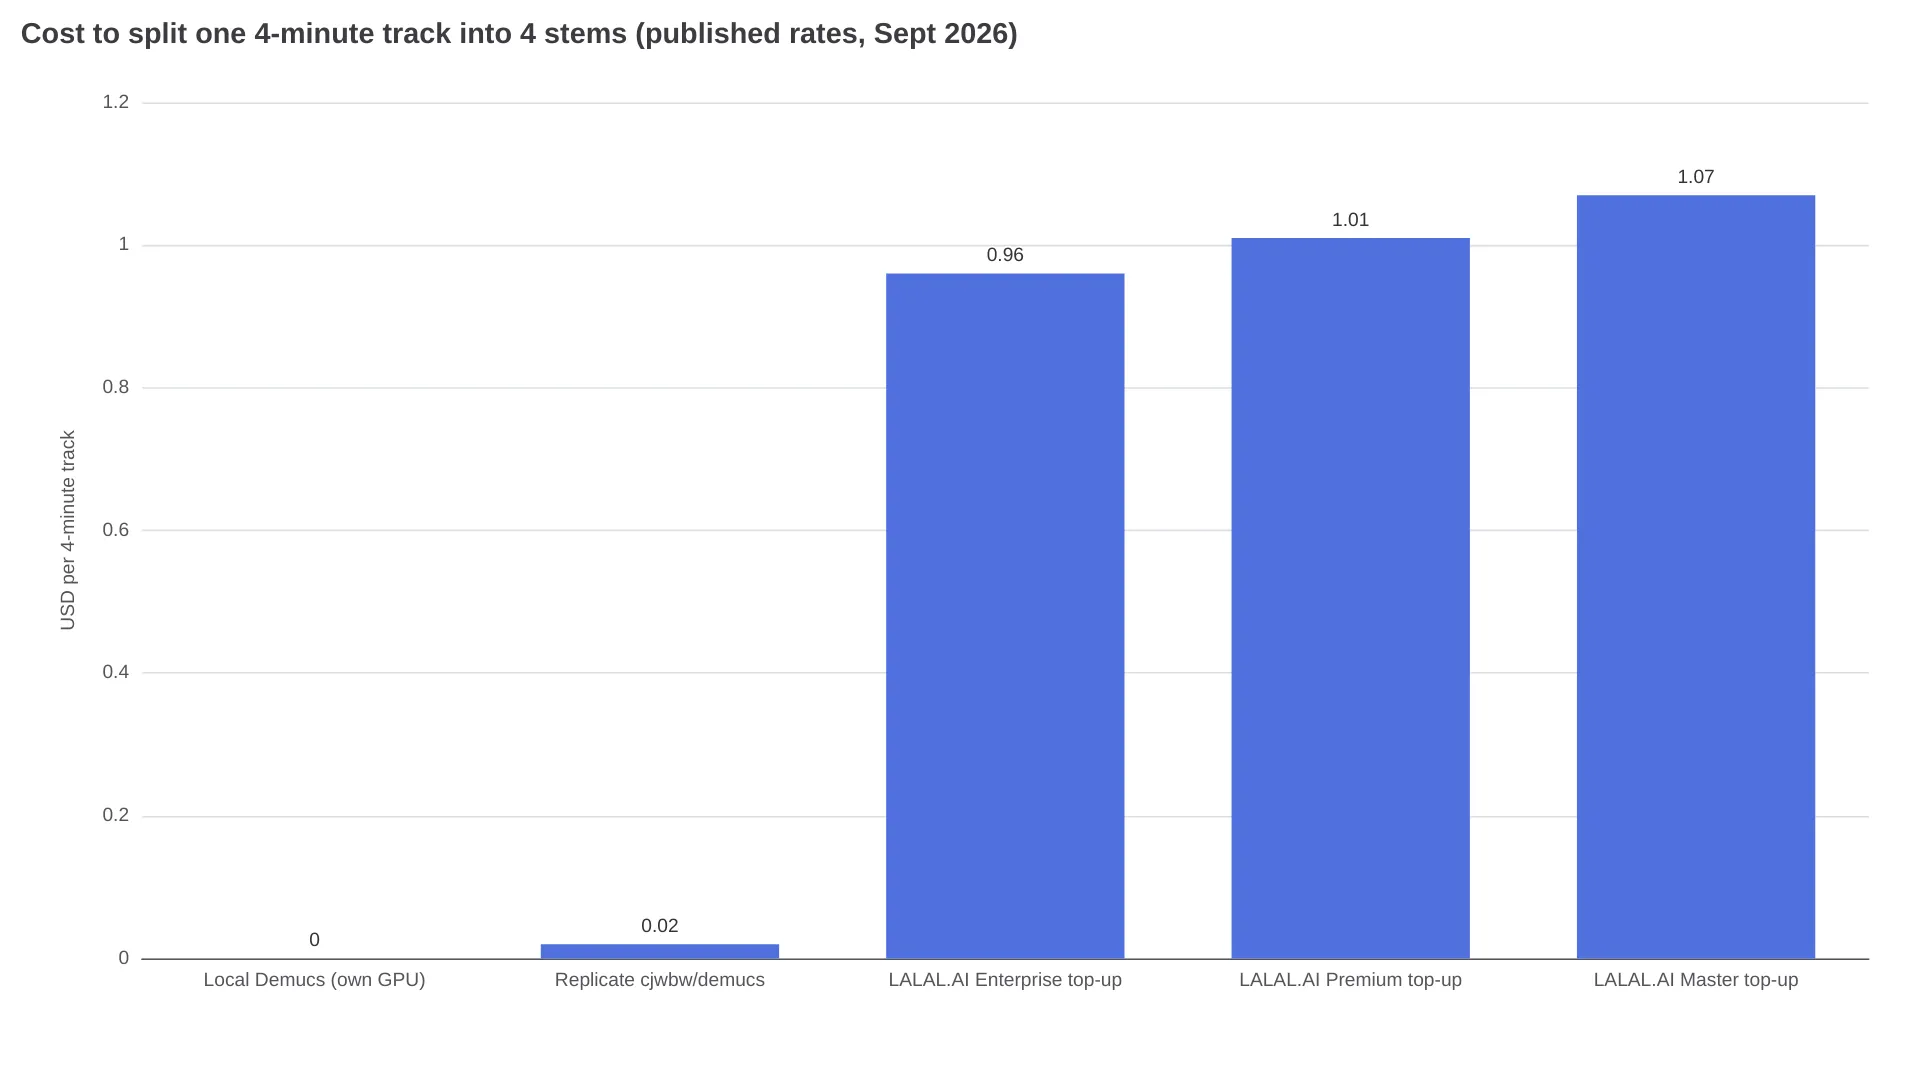
Hay que leer el gráfico con una precisión importante: las cifras de LALAL.AI corresponden al procesamiento prioritario. Los planes de pago incluyen minutos ilimitados en Relaxed Queue, y la empresa afirma que ambas colas "ofrecen una calidad de separación idéntica". Fast Queue solo compra una espera más corta.
| Plan | Precio | Incluye | Límites destacables |
|---|---|---|---|
| LALAL.AI Starter | Gratis | 10 minutos de Relaxed Queue | Límite de subida de 200 MB |
| LALAL.AI Lite | €6.75/mes, €81 facturados anualmente | Relaxed ilimitada, 90 minutos de Fast | Sin procesamiento por lotes, VST ni API; los minutos no se acumulan |
| LALAL.AI Pro | €13.50/mes, €162 facturados anualmente | Relaxed ilimitada, 250 minutos de Fast | Único nivel con acceso a API, plugin VST y procesamiento por lotes |
| Moises | No publicado públicamente | Plan gratuito con subidas mensuales limitadas | La tabla de precios está detrás del inicio de sesión; afirma ofrecer 27 tipos de stems |
Replicate cjwbw/demucs | ~$0.020/ejecución | T4, normalmente en menos de 90 s | Versión fijada hace ~3 años |
| Demucs local | Gratis (licencia MIT) | Ilimitado y sin conexión | El tiempo de tu GPU y el esfuerzo de configuración |
Los 90 minutos de Fast Queue del plan Lite cubren aproximadamente cinco pistas de cuatro stems al mes antes de pasar a la cola relajada. Si procesas más de unas pocas canciones por semana, las cuentas dejan de favorecer rápidamente la facturación por minuto. Es justo el volumen a partir del cual instalar Demucs empieza a compensar la tarde dedicada a configurarlo.
Qué opción encaja mejor con cada trabajo
| Tu situación | Mejor opción | Motivo |
|---|---|---|
| Separaciones ocasionales, sin GPU ni terminal | LALAL.AI Starter y después Lite | Los 10 minutos gratuitos permiten probar la calidad antes de gastar |
| Aprender canciones y practicar desde el móvil | Moises | 27 tipos de stems, además de herramientas de tempo y acordes; comprueba el precio después de iniciar sesión |
| Mucho volumen y GPU propia | uvx demucs con htdemucs | Coste marginal cero, ejecuciones ilimitadas y nada sale de tu equipo |
| Una exportación final especialmente importante | htdemucs_ft, --shifts 2 en GPU | Compra ese último extra de calidad a cambio de 4× más cómputo |
| Necesitas un stem de guitarra | htdemucs_6s primero y después compáralo con un modelo de la familia Roformer en UVR5 | La documentación oficial reconoce el bleeding del modelo de seis fuentes |
| Material inédito o sujeto a NDA | Solo Demucs local | No hay subidas, usa licencia MIT y procesa sin conexión |
| Backend de una aplicación sin presupuesto para operaciones | Replicate cjwbw/demucs | ~$0.020 por ejecución y sin infraestructura de GPU que administrar |
Preguntas frecuentes sobre la separación de stems con Demucs
¿Qué modelo de Demucs ofrece las mejores voces?
htdemucs_ft es el modelo distribuido de cuatro fuentes más potente para voces, aunque tarda aproximadamente cuatro veces más que htdemucs. En mezclas difíciles, algunos usuarios obtienen mejores resultados con una cadena de dos pasadas: primero una separación vocal con un modelo de la familia Roformer y después Demucs para desglosar el instrumental.
¿Puede Demucs separar guitarra y piano?
Solo mediante htdemucs_6s. El README oficial considera "aceptable" la calidad de guitarra en pruebas rápidas y afirma que la fuente de piano "no funciona demasiado bien", con "mucho bleeding y artefactos".
¿Necesito una GPU NVIDIA para ejecutar Demucs?
No. Puedes usar la CPU con -d cpu, y la documentación estima un procesamiento de aproximadamente 1.5× la duración de la pista. En Apple Silicon puedes pasar -d mps. La aceleración por GPU necesita al menos 3 GB de VRAM, unos 7 GB con los argumentos predeterminados.
¿Por qué los stems separados no vuelven a formar la mezcla original?
Demucs reajusta cada stem para evitar el clipping provocado por los artefactos de separación, y eso puede alterar los volúmenes relativos entre ellos. Usa --clip-mode clamp para aplicar clipping duro o baja el volumen de la mezcla de entrada antes de procesarla.
¿Dónde guarda Demucs los stems?
En separated/MODEL_NAME/TRACK_NAME/, como archivos WAV estéreo a 44.1 kHz codificados en int16: drums.wav, bass.wav, other.wav y vocals.wav, salvo que solicites una salida en MP3, FLAC, int24 o float32.
¿Cómo soluciono un error de memoria insuficiente de CUDA?
Reduce --segment (8 es el mínimo documentado para tarjetas de 3 GB), establece PYTORCH_NO_CUDA_MEMORY_CACHING=1 o vuelve a -d cpu. Recuerda que los modelos Hybrid Transformer limitan la longitud del segmento a 7.8 segundos, así que elevar ese valor por encima del límite no tiene ningún efecto en ellos.