 AIREITER
38,5 Sekunden Audio in 2,81 Sekunden – lokal auf einem Mac mini, ohne Cloud-Rechnung: Mit solchen Zahlen tritt Zyphras ZONOS3-Mini an. Das am 9. November 2026 veröffentlichte Mixture-of-Experts-Modell für Text-to-Speech bringt insgesamt 800 Millionen Parameter mit, aktiviert pro Schritt aber nur rund 100 Millionen davon. Die Einschränkung, auf die frühe Tester mehrfach hinweisen: Die Demo lief auf leistungsstarker Hardware auf Englisch. Ob die Werte für den eigenen Text, die eigene Sprache und GPU erreichbar sind, muss sich erst zeigen.
ZONOS3-Mini: Funktionen und Einsatzwege
ZONOS3-Mini ist ein Zero-Shot-TTS-Modell mit Voice Cloning von Zyphra: Ein kurzer Referenzclip plus Text genügt, damit das Modell in dieser Stimme spricht. Alternativ stehen 27 Standardstimmen bereit, deren Alter, Akzent und Klangcharakter sich anpassen lassen. Die Gewichte stehen unter Apache 2.0, der Runtime-Code unter MIT – lokaler und kommerzieller Einsatz sind damit erlaubt. Stimmen dürfen allerdings nur geklont werden, wenn die nötigen Rechte oder eine Einwilligung vorliegen.
Technisch setzt das Modell auf ein sparsames MoE mit 64 Experten und Top-2-Routing. Die 11 Schichten kombinieren Gated DeltaNet und globale Attention im Verhältnis 3:1. Dazu kommt der neue Zyphra Audio Codec 1 (ZAC-1), der mit 15 Frames pro Sekunde statt mit den 86 Hz des in ZONOS2 verwendeten DAC arbeitet. Laut Zyphra sinkt dadurch die Zahl der Sprach-Tokens von 774 auf 150 pro Sekunde; bei identischen Daten soll die Wortfehlerrate gegenüber DAC etwa zehnmal niedriger ausfallen.
Die wichtigsten Daten: Ausgabe mit 44,1 kHz, Generierungen von bis zu 10 Minuten, Referenzen von maximal 60 Sekunden für Raw-Cloning und 120 Sekunden für Embedding-Cloning. Trainiert wurde auf 112 NVIDIA-H100-GPUs über 2,5 Tage.
Für den Betrieb gibt es fünf Wege:
- WebGPU-Playground im Browser ohne Installation
- Natives C++/ggml für CPU, CUDA, Metal oder Vulkan
- Apple-MLX-Server
- SGLang oder vLLM auf NVIDIA-Servern
- Zyphras gehostete API mit
zyphra/zonos3-miniüber einen OpenAI-kompatiblen Endpunkt/v1/audio/speech
Als Herstellerwerte nennt Zyphra weniger als 570 ms bis zum ersten Audio in einem Pixel-9-Browser sowie weniger als 150 ms auf einem M3 MacBook Air. Über SGLang sollen auf einer H100 median 57–80 ms möglich sein, bei einer Spitzenleistung von bis zu 457 Audiosekunden pro Sekunde. Die Smartphone- und Laptop-Werte sind als Best-Case zu verstehen. Im eigenen Launch-Thread nannte Zyphra für dieselben Geräte vorsichtigere Werte von unter 800 ms beziehungsweise unter 450 ms. Vor verbindlichen Zusagen zählt deshalb nur ein Test auf der eigenen Hardware.
Zwei Punkte bleiben in den Launch-Unterlagen offen: Der Technikbeitrag spricht von 800 Millionen Gesamtparametern, die Modellseite dagegen von 886 Millionen. Außerdem findet sich weder eine Beschreibung von Watermarking oder Missbrauchsschutz noch eine Aussage zur Aufbewahrung hochgeladener Referenzstimmen.
Erst im Browser ausprobieren, dann installieren
Der Browser-Playground führt die Inferenz per WebGPU auf der eigenen GPU aus – ohne Server und ohne Installationsschritt. Der weniger offensichtliche Teil kommt beim ersten Besuch: Ein früher Tester beobachtete, dass die Seite zunächst rund 920 MB für Modell und Codec lädt, bevor überhaupt Audio generiert wird. Danach liegt das Material im Browser-Cache.
Als kostenloser Ersttest ist der Playground sinnvoll: Cloning und Steuerung einzelner Textspannen ausprobieren, anschließend die Latenz auf dem schwächsten Zielgerät vergleichen. Denn das Verhalten von WebGPU hängt stark von Browser, Treiber und GPU ab.
„Feiert nicht bei jedem kleinen Modell im Browser gleich das Ende von Cloud-TTS! Die WebGPU-Kompatibilität zwischen Browsern und Treibern steckt voller Fallstricke! Eine überzeugende englische Demo sagt nichts darüber aus, ob euer Produktionstext durchkommt!“ — @GKev1n, Nutzerwarnung davor, gehostetes TTS allein auf Basis einer Demo zu ersetzen
Bei alten Smartphones, integrierter Grafik oder Nicht-Chromium-Browsern sollte der Pixel-9-Wert keinesfalls ungeprüft hochgerechnet werden.
Voice Cloning ohne Transkript und Steuerung bis aufs Wort
- Zero-Shot-Cloning: Referenzaudio von bis zu 60 Sekunden, ganz ohne Transkript. Der Raw-Clip-Modus zielt auf ein möglichst natürliches Ergebnis, ein wiederverwendbares Speaker-Embedding lässt sich später weiterformen.
- Stimmgestaltung: Steuerung von Altersziel, maskuliner bis femininer Präsentation sowie amerikanischem, britischem und australischem Akzent. Kombinierbar sind Klangprofile wie weich, rau, hell und tief.
- Vortragssteuerung: Tempo, Emotion, Projektion, Lebendigkeit, Erregung und Flüstern lassen sich bis auf Wortspannen festlegen – etwa nur „I didn't say“ flüstern, während der Rest des Satzes neutral bleibt.
- Nachträgliche Bearbeitung: Ein VoiceCraft-ähnliches Modell ersetzt Wörter nach der Generierung und behält Stimme sowie Einstellungen bei. Ein falsch ausgesprochener Name erfordert damit nicht zwingend ein vollständiges Neu-Rendering.
Die eigene Einschränkung von Zyphra gilt für alle diese Regler: Werte für Emotion und Vortrag sind Zielvorgaben, keine Garantien. Die Temporegelung kann auch Lautstärke und Tonhöhe verändern, die Steuerung der Lebendigkeit wiederum Tonhöhe und Dauer.
Veröffentlichte Hardwaretests: Tempo, VRAM und zwei Windows-Fallen
| Setup | Gemessenes Ergebnis | Quelle |
|---|---|---|
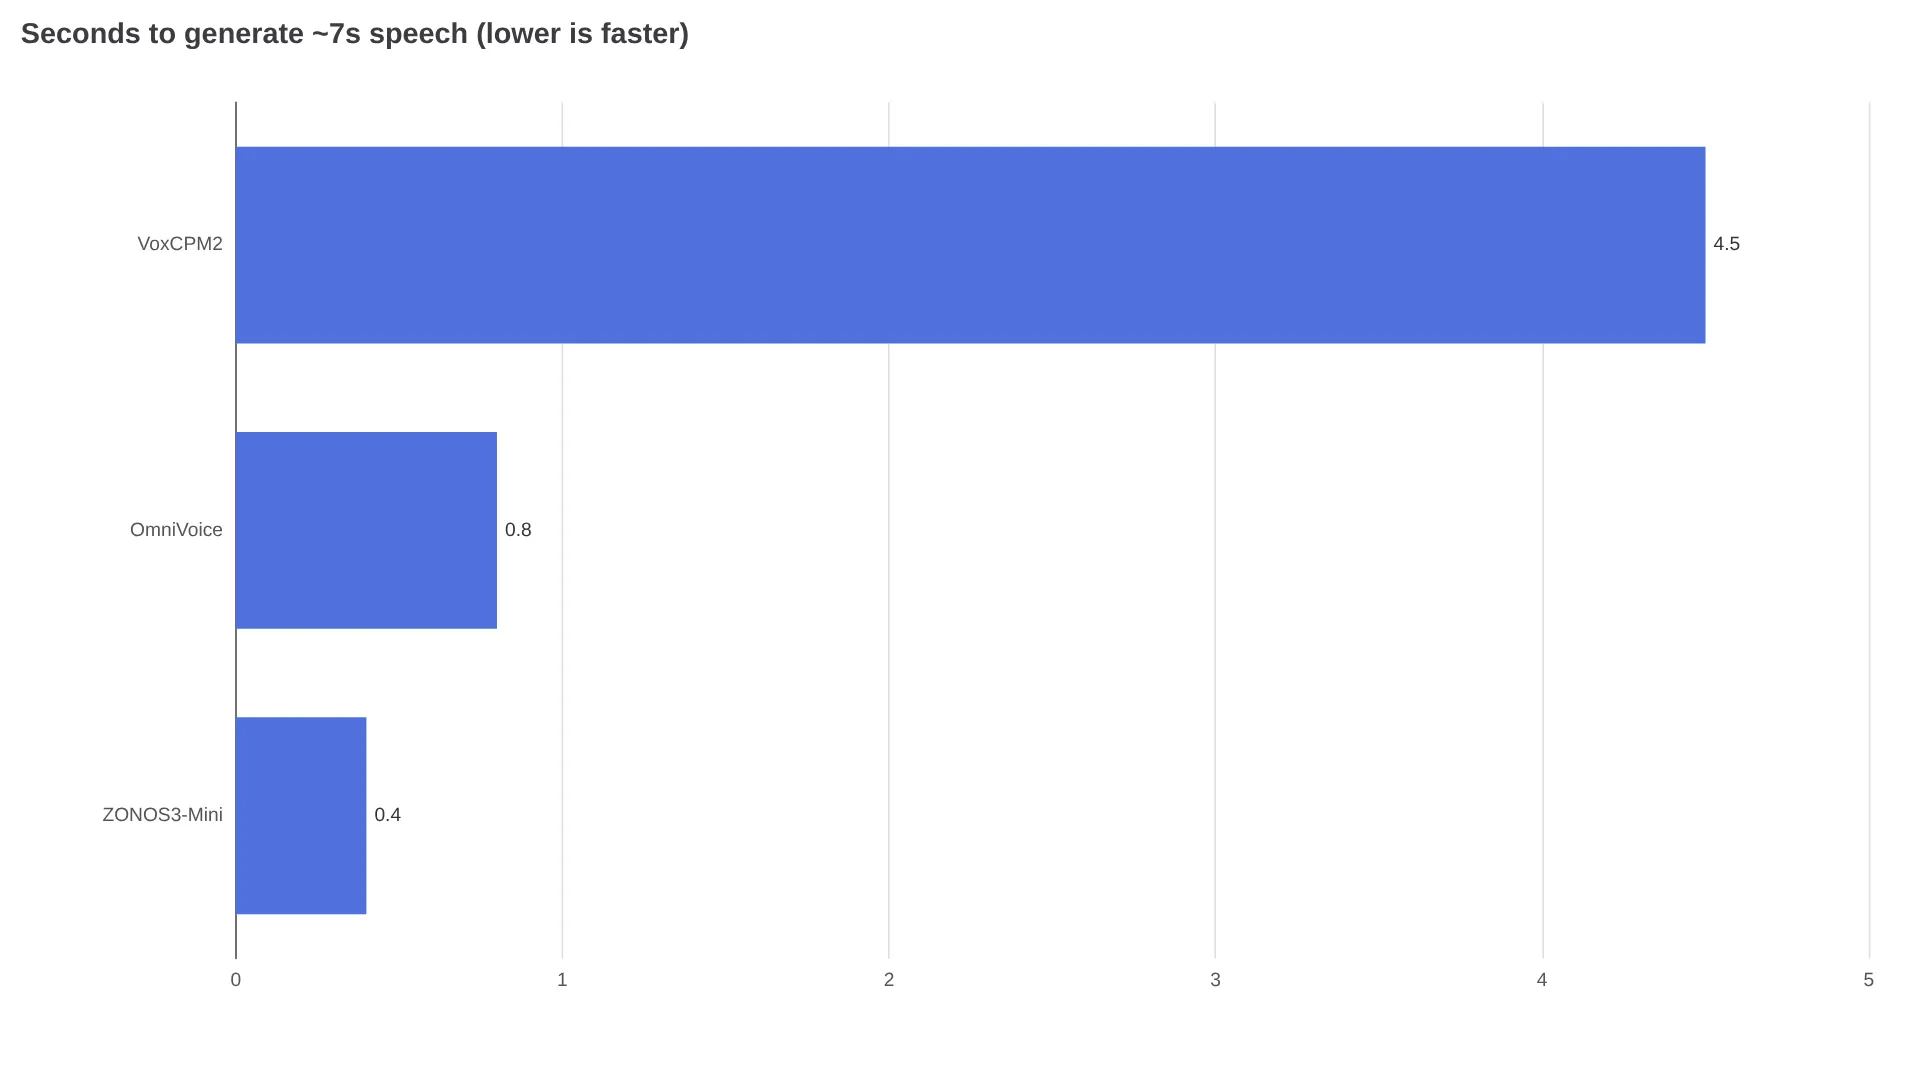
| RTX 5080, quantisiertes ggml (0,66 GB Backbone + 0,45 GB Decoder) | ~7,1 Sekunden japanische Sprache in 0,40 Sekunden; 2,4 GB VRAM insgesamt – Real-Time-Faktor 0,056, also ~18-mal schneller als Echtzeit | VRAM16-Benchmark |
| Gleiches System: 31-Sekunden-Passage; 7,2-Sekunden-Clip nur auf CPU | 1,50 Sekunden bei 2,5 GB auf GPU; auf CPU 1,45 Sekunden Rechenzeit (2,38 Sekunden vom Start bis zum Ende) | VRAM16-Benchmark |
| Mac mini mit 64 GB M5 Pro, MLX-Server | 38,5 Sekunden Audio in 2,81 Sekunden; 75–100 ms bis zum ersten Audio; ~16 GB Peak beim ersten Cloning | @pratikg |
Das GPU-Ergebnis liegt ungefähr doppelt so schnell wie die Messung desselben Benchmarks für das frühere OmniVoice und deutlich vor den dort gemessenen 0,63x für VoxCPM2.
Mit dem vollständigen 2,2-GB-Decoder stieg der Speicherbedarf auf 4,2 GB; einen hörbaren Unterschied konnte der Tester jedoch nicht eindeutig bestätigen. Transkriptionen mit Whisper large-v3 entsprachen dem vorgesehenen japanischen und englischen Text. Das belegt Verständlichkeit, aber weder Natürlichkeit noch Ähnlichkeit zur Referenzstimme.
Der schnellste veröffentlichte lokale Bericht stammt von einem Apple-Silicon-Tester mit einem M5 Pro Mac mini mit 64 GB und dem MLX-Server:
„BENCHMARKED: ... läuft bis zu 13,7X schneller als Echtzeit. Das ist auf meinem M5 Pro Mac mini mit 64 GB (vollständig lokal mit ihrem MLX-Server): ~75–100 ms Time-to-First-Audio (TTFA) mit Standardstimmen. Einen 38,5-Sekunden-Audioclip in 2,81 Sekunden generiert. Eine neue Stimme aus einem 11–13-Sekunden-Audioclip geklont, die nach ~1,3 Sekunden sprach. ... WER von 0–4 %. Nur wenige GB Speicher genutzt (~16 GB Peak beim anfänglichen Voice Cloning).“ — @pratikg, Nutzer mit veröffentlichtem Datensatz und Notizen
Wichtig ist die Einschränkung in diesem Ergebnis: Das erste Cloning erreichte einen Speicher-Peak von rund 16 GB, während gecachte Klone so schnell wie Standardstimmen liefen. Wer viele Sprecher stapelweise klonen will, sollte daher den Peak einplanen, nicht nur den Dauerbetrieb.
Unter Windows stießen Quellcode-Builds auf zwei Fallen, die der VRAM16-Tester mit Patches dokumentiert hat. Der Microsoft-Compiler lehnte eine Struktur ab, deren Mitglied ebenfalls head hieß – GCC und Clang akzeptierten sie. Mit dem bereitgestellten Umbenennungs-Patch sollten daher nur zonos3-cli, zonos3-server und spk-encoder-cli gebaut werden. Zusätzlich übergibt japanisches Windows CLI-Text in CP932 statt UTF-8, was zu fehlerhaftem Audio führt, bis das Programm die Kommandozeile über GetCommandLineW erneut einliest. JSON-Anfragen an zonos3-server sollten bereits UTF-8 sein, wurden aber nicht verifiziert.
Für die Praxis: Einen Pfad ohne Leerzeichen oder Nicht-ASCII-Zeichen verwenden, etwa C:\zonos3. Benötigt werden Visual Studio 2022 mit C++-Tooling sowie Git und FFmpeg. Für ein sauberes CUDA-Setup sollten rund fünf Minuten eingeplant werden, dazu etwa 1,2 GB Standardgewichte und rund 2 GB lokales CUDA (Installationsnotizen).
Gehostete API: Was $10 pro Million UTF-8-Bytes tatsächlich kosten
Die gehostete Variante ist ein OpenAI-kompatibler Speech-Endpunkt unter https://api.zyphracloud.com/api/v1/audio/speech. Aufgerufen wird er mit dem Modell zyphra/zonos3-mini und einem Bearer-Token ZYPHRA_API_KEY. Das folgende Snippet startet einen lokalen SGLang-Omni-Server über das SGLang-Cookbook und nutzt dieselbe Request-Struktur wie die Cloud-API. Genau das ist der Vorteil: lokal gegen localhost entwickeln und später nur die Base-URL auf Zyphra Cloud umstellen.
sgl-omni serve --model-path Zyphra/ZONOS3-Mini --port 8000

curl -X POST http://localhost:8000/v1/audio/speech \
  -H "Content-Type: application/json" \
  -d '{"input": "Hello from ZONOS3-Mini!"}' \
  --output output.wav
Abgerechnet wird nach Bytes, nicht pro Zeichen oder Audiominute: $10.00 pro 1 Million UTF-8-Bytes. Enthalten sind 1 parallele Anfrage, 100 Generierungen pro Tag, unbegrenzt viele Eingabezeichen sowie die oben genannten Cloning-Limits von 60 beziehungsweise 120 Sekunden. Für einfaches Englisch mit grob einem Byte pro Zeichen und angenommenen 800–900 Zeichen pro gesprochener Minute reichen $10 für etwa 1.100–1.250 Minuten – also weniger als einen Cent pro Minute. Bei CJK-Text fällt dieselbe Rechnung deutlich schlechter aus, da ein Zeichen ungefähr drei Bytes kostet: etwa dreimal so viel pro Zeichen. Für chinesische, japanische oder koreanische Eingaben sollte deshalb ein eigenes Skript die Kosten pro Minute ermitteln.
Lokale Inferenz oder Browser-Inferenz verursacht nach Anschaffung der Hardware nahezu keine Grenzkosten. Das Hosting-Angebot eignet sich für Prototypen und Lastspitzen, ist mit einer parallelen Anfrage und 100 Generierungen täglich aber nicht für Produktionsskalierung ausgelegt. Teams mit Durchsatzbedarf sollten eine selbst gehostete SGLang- oder vLLM-Installation kalkulieren, statt die $10-Zahl einfach hochzurechnen.
Vergleich mit ElevenLabs, Fish, Qwen und dem #1-Siegel
Auf seinen Seiten vergleicht Zyphra ZONOS3-Mini mit Fish Audio, Qwen, Cartesia, ElevenLabs und OmniVoice anhand von drei Skripten: einem dramatischen Trailer-Monolog, einer längeren komödiantischen „straight to jail“-Passage zur Konsistenzprüfung sowie einer dialogartigen Passage im Podcast-Stil. Hinzu kommt ein Pareto-Diagramm für Latenz und Durchsatz. Die Beispiele sollte man selbst anhören. Die Seiten bieten Audioplayer, nennen aber keinen schriftlichen Sieger, keine Modellversionen der Konkurrenz, keine Seeds und keine Aussage zu abgestimmten Einstellungen.
Auch das Zahlen-Ranking verdient diese Vorsicht. Zyphras ZTTS2-Eval umfasst 35 saubere Sprachen und 20 Alltags- beziehungsweise In-the-wild-Sprachen über 420 Metrik-pro-Set-pro-Sprache-Elemente. Im Capability Index liegt ZONOS3-Mini damit unter den offenen Modellen vor Fish S2 Pro und MOSS TTS v1.5. Allerdings bewertet hier der Anbieter sein eigenes Modell mit einem selbst entwickelten neuen Test. Die Methode ist öffentlich, doch bei Veröffentlichung dieses Tests gab es keine unabhängige Reproduktion. Vergleiche mit geschlossenen Modellen bestehen nur aus Audio, ohne gemeinsamen Score.
Weil Zyphra weder Ergebnisse je Sprache noch unabhängige Hörvergleiche veröffentlicht, bleiben Mandarin-Tonpräzision, japanischer Tonhöhenakzent, mehrdeutig gelesene Schriftzeichen und Emotionen über lange Texte ungeklärt. Vor einem Einsatz müssen sie selbst getestet werden. Die nüchterne Einordnung: Bei Effizienz und flexibler Bereitstellung liegt ZONOS3-Mini vorn, eine Qualitätsführerschaft ist nicht belegt.
Für wen sich ein Wechsel jetzt lohnt
| Team | Empfehlung | Warum |
|---|---|---|
| Offline-, On-Device- oder datenschutzsensible Anwendungen (Spiele, Reader, Kioske) | Jetzt testen | Apache 2.0, 1,2-GB-Standarddownload, 2,4 GB VRAM, CPU-tauglich, keine Abrechnung pro Minute |
| Hörbuch- oder NPC-Pipelines mit vielen Stimmen | Pilotprojekt | Wortgenaue Steuerung und Nachbearbeitung senken Neu-Rendering-Kosten, doch die Ähnlichkeit jedes Sprecherklons muss geprüft werden |
| Nicht-englische Produktion, besonders Chinesisch | Eigene Evaluation abwarten | Keine Herstellerwerte je Sprache; Aussagen zu Wortfehlern und Prosodie sind englischlastig, bis Polyphone und Töne getestet wurden |
| Gehostetes TTS mit hoher Parallelität | Selbst hosten oder beim bisherigen Anbieter bleiben | Das Cloud-Angebot ist auf 1 parallele Anfrage und 100 Generierungen/Tag begrenzt; SGLang/vLLM ist der eigentliche Produktionsweg |
| Teams, die Watermarking oder einen Audit-Trail benötigen | Abwarten | Die Release-Unterlagen beschreiben weder Watermarking noch eine Aufbewahrungsrichtlinie für Referenzclips |
Die sinnvolle Reihenfolge lautet: Browser-Playground, lokaler Build auf dem schwächsten Gerät, anschließend die gehostete API. Wechseln sollte nur, wer die Hürden von 2,4 GB VRAM und WebGPU auf eigener Hardware nimmt und dessen Sprache Blind-Hörtests besteht. Andernfalls ist es sinnvoller, bei der geschlossenen API zu bleiben und unabhängige mehrsprachige Benchmarks abzuwarten.
FAQ
Wie viel VRAM benötigt ZONOS3-Mini?
Auf dem getesteten RTX-5080-Setup insgesamt etwa 2,4–2,5 GB (vollständiger Decoder: 4,2 GB; anfänglicher Cloning-Peak auf dem Mac: ~16 GB).
Läuft es im Browser oder auf der CPU?
Ja: per WebGPU nach einem Download von ~920 MB beim ersten Besuch. In dem einen veröffentlichten Test benötigte reine CPU-Synthese einschließlich Startzeit etwa ein Drittel der Echtzeit.
Wie gut ist das Voice Cloning?
Zero-Shot mit bis zu 60 Sekunden Referenzaudio ohne Transkript; ein unabhängiger Test meldete 0–4 % Wortfehlerrate. Die Ähnlichkeit für einzelne Sprecher muss aber im eigenen Hörtest geprüft werden.
Ist die kommerzielle Nutzung erlaubt?
Die Gewichte stehen unter Apache 2.0, der Code unter MIT. Für jede geklonte Stimme sind jedoch Rechte oder eine Einwilligung erforderlich.
Wie lauten API-Endpunkt und Preis?
OpenAI-kompatibles POST https://api.zyphracloud.com/api/v1/audio/speech mit dem Modell zyphra/zonos3-mini für $10 pro Million UTF-8-Bytes (1 parallele Anfrage, 100/Tag).
Weiterführend: Beste Text-to-Speech-API, Beste Voice-Cloning-API 2026, Kokoro 82M TTS Local Guide