 AIREITER
„Unlimited“ ist bei Baidus OCR-Modell kein Versprechen ohne Einschränkung: Die mitgelieferte Konfiguration setzt max_position_embeddings auf 32,768. Genau diese Zahl ist vor einem Deployment entscheidend. Unlimited OCR ersetzt die OCR-Schleife Seite für Seite durch einen einzigen Forward Pass – allerdings nur, solange das Dokument in das 32K-Token-Budget passt und die Scans einigermaßen sauber sind.
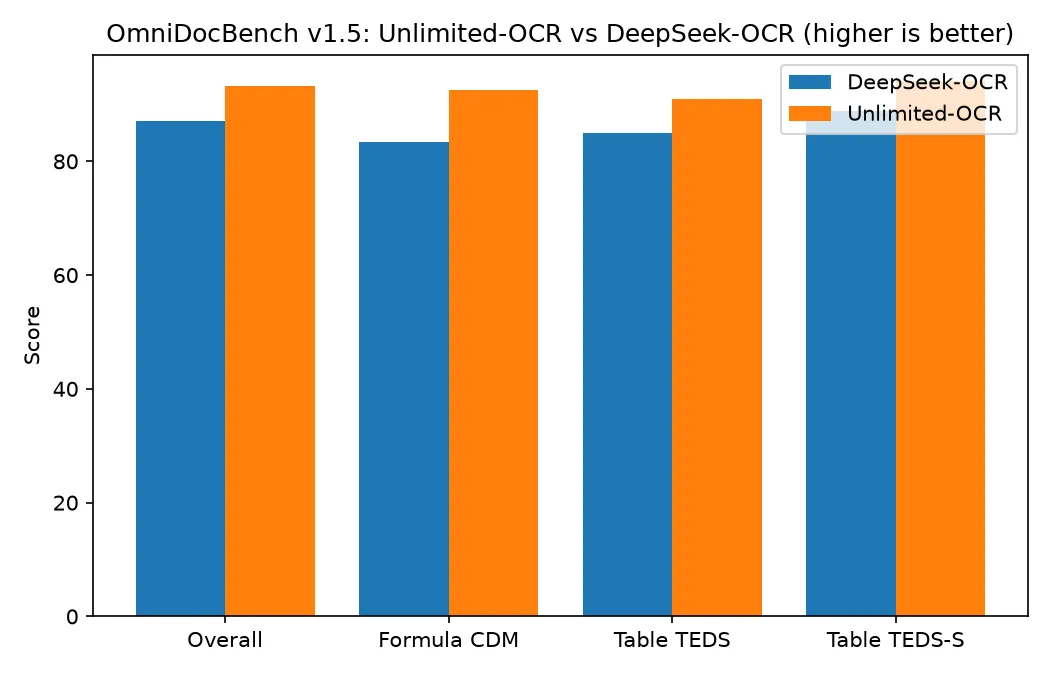
Abgesehen davon fällt das Release überzeugender aus, als diese Einschränkung zunächst vermuten lässt. Die Gewichte stehen unter der MIT-Lizenz, die safetensors-Metadaten weisen 3,336,106,240 Parameter in BF16 aus, und auf OmniDocBench v1.5 erreicht das Modell 93.23 insgesamt. Das DeepSeek-OCR-Basismodell, auf dem es aufbaut, kommt dort auf 87.01. Auf Hugging Face lag die Zahl der Downloads in den vergangenen 30 Tagen am 2026-07-29 bei 2,694,935; dazu kamen 3,389 Likes.
Die 32K-Grenze hinter dem Namen
Im Mehrseitenmodus wird jede Seite mit 1024×1024 kodiert und um den Faktor 16 auf rund 256 visuelle Tokens verdichtet. Daraus lässt sich das Seitenbudget berechnen, noch bevor die erste Zeile Code geschrieben ist.
| Seiten in einem Durchlauf | Visuelle Tokens (Prefill) | Verbleibende Tokens für die Ausgabe | Budget pro Seite |
|---|---|---|---|
| 10 | ~2,560 | ~30,200 | ~3,020 |
| 20 | ~5,120 | ~27,600 | ~1,380 |
| 40 | ~10,240 | ~22,500 | ~560 |
Ein Foliensatz oder ein locker gesetzter Vertrag passt problemlos mit 40 Seiten hinein. Eine dichte Zeitungsseite im Zweispaltensatz kann für sich genommen schon mehr als 560 Markdown-Tokens benötigen. Für solche Vorlagen liegt die praktische Grenze daher deutlich unter 40 Seiten. Das Paper benennt das ausdrücklich: Bei endlicher Kontextlänge kann das Parsing nicht wirklich unbegrenzt sein, weil der Prefill mit jeder weiteren Seite wächst. Baidus Roadmap sieht eine Variante mit 128K Kontext sowie einen „prefill pool“ vor, der Seitenblöcke bei Bedarf nachlädt. „Unlimited“ bezieht sich also auf eine im Verhältnis zur Cache-Größe unbegrenzte Decode-Länge – nicht auf eine unbegrenzte Seitenzahl.
R-SWA: Was sich ändert – und was nicht
Gegenüber DeepSeek-OCR wurden zwei Dinge verändert. Der DeepEncoder-Visionsstack aus einer SAM-ViT-B- plus CLIP-L-Kaskade blieb erhalten und wurde während des Trainings eingefroren. Dafür ersetzte Baidu sämtliche Attention-Layer des Decoders durch Reference Sliding Window Attention. Jedes erzeugte Token berücksichtigt dabei alle Referenz-Tokens – also visuelle Tokens und Prompt – aber nur die letzten 128 Output-Tokens. Die config.json bestätigt das: sliding_window_size: 128, 12 Decoder-Layer, 64 geroutete Experten und 6 aktive Experten pro Token.
Die Verbesserungen betreffen mehrere Bereiche, nicht nur eine Spezialdisziplin – und vor allem die Seitenelemente, die bei längerer Generierung relevant bleiben. Auf OmniDocBench v1.5 stieg Formula CDM von 83.37 auf 92.61, Table TEDS von 84.97 auf 90.93. Die Edit-Distanz für die Lesereihenfolge halbierte sich von 0.086 auf 0.045. Da der Encoder nicht nachtrainiert wurde, gehen diese Unterschiede auf den neuen Decoder zurück, nicht auf einen besseren Visionsstack.
Umgekehrt bleiben auch die Schwächen des Encoders erhalten. Eine längere Generierung verbessert nicht plötzlich die Zeichenerkennung eines verblichenen Faxes.
Mehr Tempo gibt es erst bei langen Ausgaben
Bei 256 Output-Tokens sind beide Modelle praktisch gleich schnell: 7,229.52 gegenüber 7,229.32 Tokens pro Sekunde. Erst mit längerer Generierung öffnet sich die Lücke. Bei 6,144 Output-Tokens fällt die Baseline auf 5,822.87 zurück, während Unlimited OCR bei 7,847.71 bleibt – rund 35% schneller.
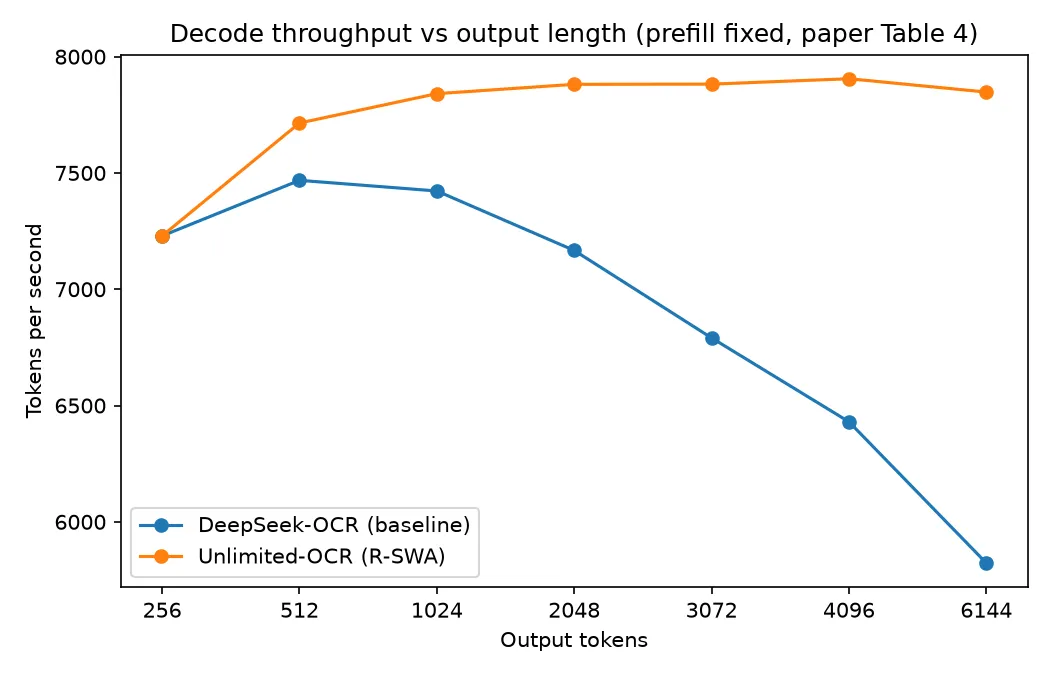
Im kompletten OmniDocBench-Lauf im Base-Modus bei 512-facher Parallelität schrumpft der Vorsprung auf 12.7%: 5,580 statt 4,951 Tokens pro Sekunde. Batching verdeckt bereits einen großen Teil der Attention-Kosten pro Schritt. Bei der Verarbeitung einseitiger Rechnungen mit hoher Parallelität bringt R-SWA daher fast nichts.
Bis 40 Seiten bleibt die Qualität stabil – dann steigt die Fehlerquote
Das Paper setzt die Edit-Distanz bei einem einzelnen Durchlauf ins Verhältnis zur Seitenzahl. Die Kurve verläuft nicht flach.
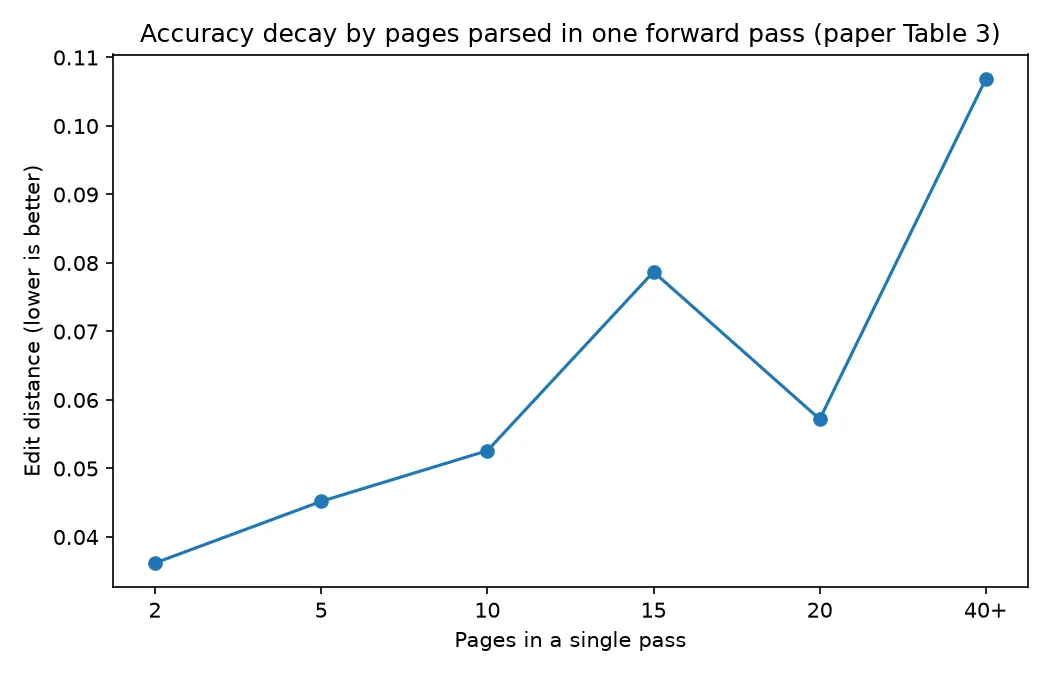
Bei zwei Seiten liegt sie bei 0.0362, bei zehn Seiten bei 0.0526. Ab 40 Seiten erreicht sie 0.1069; zugleich fällt Distinct-35 von rund 99.9% auf 96.90%. Das heißt: Wiederholte n-Gramme tauchen zunehmend in der Ausgabe auf. Der Messwert bei 15 Seiten, 0.0787, ist schlechter als jener bei 20 Seiten mit 0.0572. Die Kurve sollte deshalb als Trend verstanden werden, nicht als Garantie für jede Seitenzahl. Baidu führt die Wiederholungsfehler vor allem auf kleinen Text bei der Basisauflösung von 1024×1024 zurück, nicht auf abdriftende Attention. Das passt zum Kompromiss des Modells: Mehrseitige und PDF-Eingaben können nicht den hochauflösenden Crop-Modus nutzen, der bei einzelnen Bildern verfügbar ist.
Warum „8 GB reichen“ in der Praxis nicht für 40 Seiten gilt
Die vLLM-Anleitung nennt eine einzelne GPU mit mindestens 8 GB als ausreichend für BF16-Inferenz. Berichte aus der Community passen dazu nicht – und die Modellkonfiguration erklärt, warum.
Die einzelne safetensors-Datei ist 6.673 GB groß. Für den Cache sind vier Werte aus der config.json maßgeblich: num_hidden_layers: 12, num_attention_heads: 10, num_key_value_heads: 10, v_head_dim: 128 und use_mla: false. Weil Query- und Key/Value-Head-Anzahl gleich sind, arbeitet das Modell mit klassischem MHA. Es gibt also kein GQA- oder MQA-Sharing, das den Bedarf reduziert. Der Cache pro Token beträgt damit 2 für K und V × 12 Layer × 10 Heads × 128 Dimensionen × 2 Byte = 61,440 Byte beziehungsweise 60 KiB. Daraus ergeben sich drei relevante Werte:
- Vollständiger 32K-Prefill: 32,768 × 60 KiB = 1.875 GiB Cache
- Decode-Seite mit R-SWA: Durch
sliding_window_size: 128auf konstante 7.5 MiB begrenzt - Gleicher Decoder ohne R-SWA bei 6,144 Output-Tokens: 360 MiB, linear wachsend
Das sind theoretische Cache-Größen, keine Peak-Allokationen. Aktivierungen des Vision-Encoders, Fragmentierung durch den Allocator und vorallokierte Cache-Blöcke der Engine kommen noch hinzu. Deshalb füllen Gewichte plus langer Prefill eine 8-GB-Karte schnell aus. Ein lokaler SGLang-Lauf auf einer RTX 4070 Ti Super mit 16 GB meldete rund 12 GB Belegung. Das passt zu dieser Rechnung, beweist sie aber nicht. Die 8-GB-Angabe ist als Untergrenze für kurze Einzelseiten gedacht, nicht als Spezifikation für einen 40-Seiten-Fall.
Diese Werte zeigen auch, was R-SWA tatsächlich spart: Bei dieser Modellgröße reduziert die Begrenzung des Decode-Cache den Bedarf um Hunderte Megabyte, nicht um Gigabyte. Der praktische Vorteil liegt in den Attention-Kosten pro Schritt, die nicht weiter anwachsen. Genau das misst die Durchsatzkurve.
Keine offizielle API: So läuft Unlimited OCR tatsächlich
Auf der Hugging-Face-Modellseite steht: „This model isn't deployed by any Inference Provider.“ Es gibt weder einen First-Party-Endpunkt noch eine von Baidu gehostete Preisseite. Für den Eigenbetrieb bleiben drei Wege: Transformers mit trust_remote_code, SGLang oder die vLLM-Anleitung. Letztere verlangt vLLM 0.25.0 oder neuer aus dem dedizierten Container vllm/vllm-openai:unlimited-ocr, weil die Architektur noch nicht in einem stabilen pip-Wheel enthalten ist.
Ob überhaupt eine Ausgabe entsteht, hängt von vier Einstellungen ab:
- N-Gram-Logits-Processor registrieren:
NGramPerReqLogitsProcessor. Ohne ihn geraten lange Dokumente bei<|det|>-Koordinaten-Tokens in Schleifen. - N-Gram-Parameter passend setzen:
ngram_size: 35undwindow_size: 128für Einzelbilder, für mehrseitige oder PDF-Eingaben1024. - Den Text mit dem Literal
<image>beginnen lassen: etwa<image>Multi page parsing.Eine Chat-Vorlage liefert das Modell nicht mit. skip_special_tokens: Falseübergeben: Mit der Standardeinstellung bleiben nur leere Strings zurück.
Die rohe Generierung enthält Grounding-Markup. Für sauberes Markdown bleibt der Text innerhalb von <|ref|> erhalten, während die Bounding Boxes in <|det|> entfernt werden. Seitengrenzen gibt das Modell ebenfalls nicht nativ aus. Falls sie für einen Audit-Trail benötigt werden, sollten Seitenlabels im Prompt angefordert werden.
Der in der Anleitung als funktionierend dokumentierte Server und Request sehen so aus:
docker run --rm --gpus all --network host --ipc host \
  vllm/vllm-openai:unlimited-ocr baidu/Unlimited-OCR \
  --trust-remote-code \
  --logits_processors vllm.model_executor.models.unlimited_ocr:NGramPerReqLogitsProcessor \
  --no-enable-prefix-caching --mm-processor-cache-gb 0
client.chat.completions.create(
model="baidu/Unlimited-OCR",
messages=[{"role": "user", "content": [
{"type": "text", "text": "<image>Multi page parsing."},
{"type": "image_url", "image_url": {"url": page_data_url}},
]}],
max_tokens=8192, temperature=0.0,
extra_body={"skip_special_tokens": False,
"vllm_xargs": {"ngram_size": 35, "window_size": 1024}},
)Auf Hopper-Karten ist das Image-Tag unlimited-ocr-cu129 zu verwenden. Wichtig außerdem: Mehrere Bilder in einem Request fallen auf den Base-Modus ohne Crop zurück. In diesem Fall ist window_size: 1024 erforderlich.
Kosten pro 1.000 Seiten: Self-Hosting gegen Managed API
Offene Gewichte kosten nichts, ihr Betrieb dagegen schon. Eine der wenigen veröffentlichten Praxismessungen stammt von einem Nutzer im Hacker-News-Thread: Über Transformers wandelte er auf einer RTX 4090 ungefähr 200 Seiten pro Stunde aus einem japanischen Grammatik-PDF um. Zum Vergleich: Eine 4090 kostet bei RunPod zum Community-Tarif $0.34 pro Stunde.
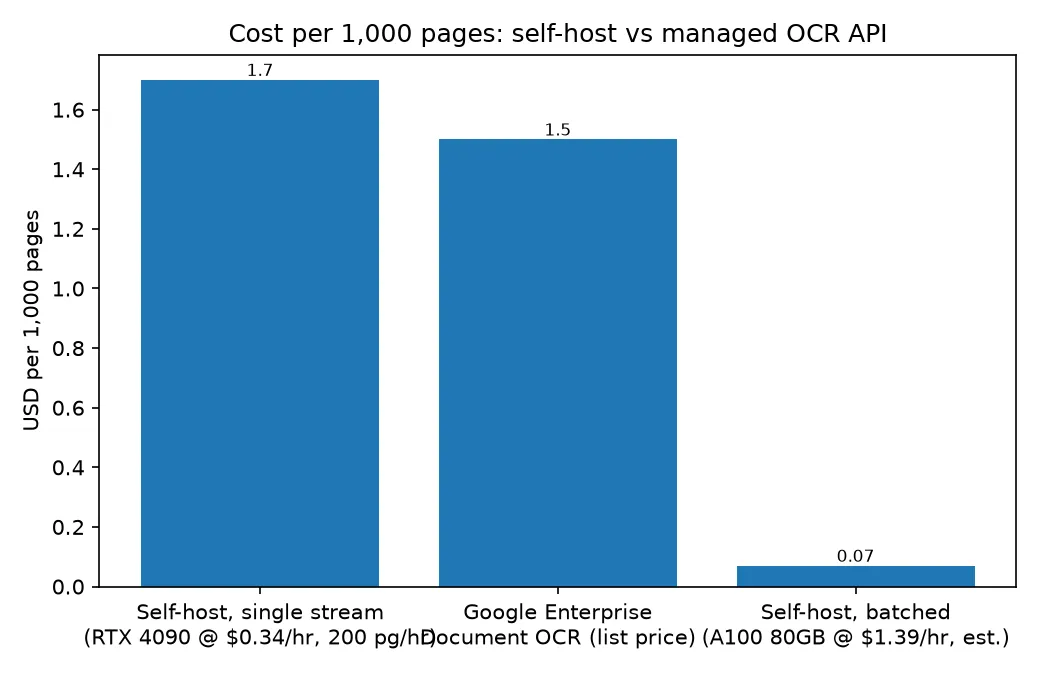
| Option | Kosten pro 1.000 Seiten |
|---|---|
| Self-Hosting, Einzelstream (4090 für $0.34/Std., 200 Seiten/Std.) | ~$1.70 |
| Google Enterprise Document OCR, 1K bis 5M Seiten/Monat | $1.50 (Listenpreis) |
| Google Layout Parser, gleiche Seitenzahl | $10.00 (Listenpreis) |
| Self-Hosting, ausgelastete Batch-Untergrenze (A100 80GB für $1.39/Std., modelliert) | ~$0.07 |
Listenpreise mit Stand 2026-07-29. Bei Google sind die ersten 1,000 Seiten pro Monat kostenlos; oberhalb von 5 Millionen Seiten sinkt der Tarif auf $0.60. Die letzte Zeile ist eine modellierte Untergrenze, keine Messung, und sie hängt von der Ausgabelänge ab. Beim im Paper gemessenen Durchsatz von 5,580 Tokens pro Sekunde mit 512-facher Parallelität ergeben 700 Output-Tokens pro Seite rund 28,700 Seiten pro Stunde ($0.05 je 1,000), 1,000 Tokens etwa 20,000 ($0.07) und eine dichte Seite mit 2,000 Tokens rund 10,000 ($0.14). Dieser Durchsatz wurde auf Baidus eigenem Evaluierungscluster gemessen, nicht auf einer gemieteten A100. Die Zeile kombiniert daher einen Benchmark-Wert mit einem Mietpreis. In echten Deployments liegen die Kosten über allen drei Werten, sobald ungenutzte Kapazität, Wiederholungen fehlgeschlagener Seiten, Vorverarbeitung und Storage hinzukommen.
Ein Einzelstream auf einer Consumer-Karte kostet ungefähr so viel wie Googles Managed OCR. Self-Hosting gewinnt also durch Parallelität und Datenresidenz, nicht durch die Lizenz. Außerdem ist Parsing nur die halbe Aufgabe: Um aus dem Markdown Felder zu machen, braucht es weiterhin einen Aufruf an ein Long-Context-Textmodell. Dort wird wieder pro Token statt pro Seite abgerechnet – unabhängig davon, ob es im eigenen Stack läuft oder über etwas wie die GPT-5.6 API.
Wo das Modell scheitert
Die berichteten Fehlerbilder entsprechen dem, was bei einem eingefrorenen Encoder zu erwarten ist. Derselbe Lauf auf einer 4070 Ti Super lieferte bei Belegen, Handschrift und komplexen Scans verstümmelte Ausgaben, ausgelassene Bereiche und strukturelle Verschiebungen. Saubere gedruckte Seiten gelangen dagegen durch. Nutzer im Hacker-News-Thread beschreiben jene VLM-OCR-Fehlerklasse, die bei Compliance-Aufgaben problematisch wird: Fremdsprachige Wörter werden stillschweigend ins Englische übersetzt, handschriftliche Namen in eine vermeintlich wahrscheinlichere Schreibweise „korrigiert“. Beides sind Einzelfallberichte. Sie sollten daher als Testfälle dienen, nicht als gemessene Fehlerquoten.
Auch die Positionierung sollte realistisch bleiben. Unlimited OCR führt die Genauigkeitstabellen nicht an. In aggregierten OmniDocBench-Listen liegt PaddleOCR-VL-1.6 bei 96.33, laut Herstellerangabe, während dieses Modell auf v1.6 93.92 erreicht. In olmOCR-Bench taucht es bislang gar nicht auf. Bei der Genauigkeit pro Seite tritt es nicht primär an.
Lohnt sich der Einsatz?
Gut geeignet ist Unlimited OCR für Pipelines, die derzeit jede Seite einzeln verarbeiten und den Text anschließend wieder zusammensetzen. Das gilt besonders für born-digital erzeugte oder sauber gescannte Dokumente sowie für Fälle, in denen seitenübergreifende Strukturen – etwa Tabellen über einen Seitenumbruch hinweg – die aktuelle Ausgabe beschädigen.
Weniger geeignet ist es bei Tausenden einseitigen Rechnungen pro Tag, weil seitenweise Pipelines besser batchen und günstiger arbeiten. Gleiches gilt, wenn Handschrift oder fotografierte Belege einen relevanten Teil der Eingaben ausmachen, oder wenn heute ein SLA und ein Audit-Trail benötigt werden statt einer GPU und eines Container-Tags.
In jedem Fall sollte vor einer Entscheidung getestet werden. Ein brauchbares Minimum sind 50 Dokumente aus dem eigenen Bestand, sortiert nach Länge – 1 bis 5 Seiten, 6 bis 20, 20 oder mehr – und Eingabequalität – born-digital, sauberer Scan, fotografiert. Für 10 davon sollte der Ground Truth manuell erfasst werden. Anschließend Character Error Rate, Edit-Distanz der Lesereihenfolge und Table TEDS getrennt bewerten, statt sie zu mitteln, und die Wall-Clock-Sekunden pro Seite auf der GPU erfassen, die tatsächlich gemietet werden soll. Der Vergleich gehört gegen die aktuelle Lösung auf denselben 50 Dateien. Die Schwelle sollte dort liegen, wo der nachgelagerte Prozess wirklich scheitert – bei Feldextraktion meist an der Tabellenstruktur, nicht an der reinen CER. Wie stark Optimierung den Wert verschieben kann, zeigt ein Team mit PDF-Volumen im Enterprise-Maßstab: Nach dem Umschreiben der Inferenzschicht in Rust berichtete es 0.94% Character Error Rate.
FAQ
Ist Unlimited OCR kostenlos?
Die Gewichte stehen unter der MIT-Lizenz und können kostenlos von Hugging Face oder GitHub heruntergeladen werden, auch für kommerzielle Nutzung. Die Inferenz ist nicht kostenlos: Je nach Batch-Auslastung sollten ungefähr $0.07 bis $1.70 pro 1,000 Seiten zuzüglich Engineering-Aufwand eingeplant werden.
Gibt es eine offizielle Unlimited-OCR-API?
Nein. Die Modellseite zeigt keine Bereitstellung bei einem Inference Provider. Jeder verfügbare Endpunkt stammt daher von einem Drittanbieter, der die offenen Gewichte selbst hostet und Preise sowie Rate Limits unabhängig von Baidu festlegt.
Ist Unlimited OCR derzeit das beste OCR-Modell?
Nicht in den Genauigkeitstabellen: PaddleOCR-VL-1.6 meldet auf OmniDocBench 96.33, Baidu 93.92 auf v1.6. Außerdem gibt es für das Modell noch keinen Eintrag in olmOCR-Bench, weshalb die Konsistenz über Benchmarks hinweg unbewiesen ist. Sein gemessener Vorsprung liegt beim einzelnen 40-Seiten-Durchlauf mit 0.1069 Edit-Distanz.
Kann ich Unlimited OCR in Ollama ausführen?
Die offizielle Modellkarte dokumentiert nur Transformers, vLLM und SGLang; die eigene Architektur benötigt trust_remote_code. Community-Quantisierungen auf Hugging Face gibt es, doch jeder Ollama-Build sollte als unbestätigt gelten, bis seine Ausgabe auf eigenen Dateien mit dem Referenzpfad verglichen wurde.