 AIREITER
Am 26. August 2026 ist Schluss mit der OpenAI Assistants API. Der größte Fehler bei der Umstellung wäre, sie als bloße Umbenennung abzutun. OpenAI hatte das Ende der Assistants API ein volles Jahr im Voraus angekündigt, in der Deprecation-Mitteilung vom 26. August 2025. Ihr Nachfolger ist die Responses API. Auf dem Papier sind die Objekte schnell zugeordnet – die Orchestrierung darunter jedoch nicht. Selbst Entwickler, die dem offiziellen Leitfaden folgten, brachten Fehler in Produktion. Hier erfahren Sie, was wegfällt, was die Mappings verschleiern und wie Sie die verbleibende Zeit sinnvoll nutzen.
Was am 26. August 2026 ausfällt – und was erhalten bleibt
Nach dem Stichtag liefern sämtliche Endpoint-Familien der Assistants API Fehler zurück. Betroffen sind /v1/assistants, /v1/threads, Thread-Messages, Runs und Run Steps – einschließlich aller Abläufe, die weiterhin den Header OpenAI-Beta: assistants=v2 senden. Assistant-Konfigurationen und Thread-Verläufe sind dann nicht mehr über die API erreichbar.
Nicht alles, was an einer Assistants-Integration hängt, verschwindet jedoch:
| Ab 26. August 2026 nicht mehr verfügbar | Weiter verfügbar |
|---|---|
/v1/assistants-CRUD-Endpunkte | Vector Stores und hochgeladene Dateien, weiterverwendbar über Responses File Search |
/v1/threads, Thread-Messages | Chat Completions API (nicht Teil dieser Abschaltung) |
| Runs und Run Steps | Responses API und Conversations API |
OpenAI-Beta: assistants=v2-Workflows | Realtime API |
Auch OpenAIs eigener Deprecation-Tracker nennt Responses und Conversations als vorgesehene Nachfolger:
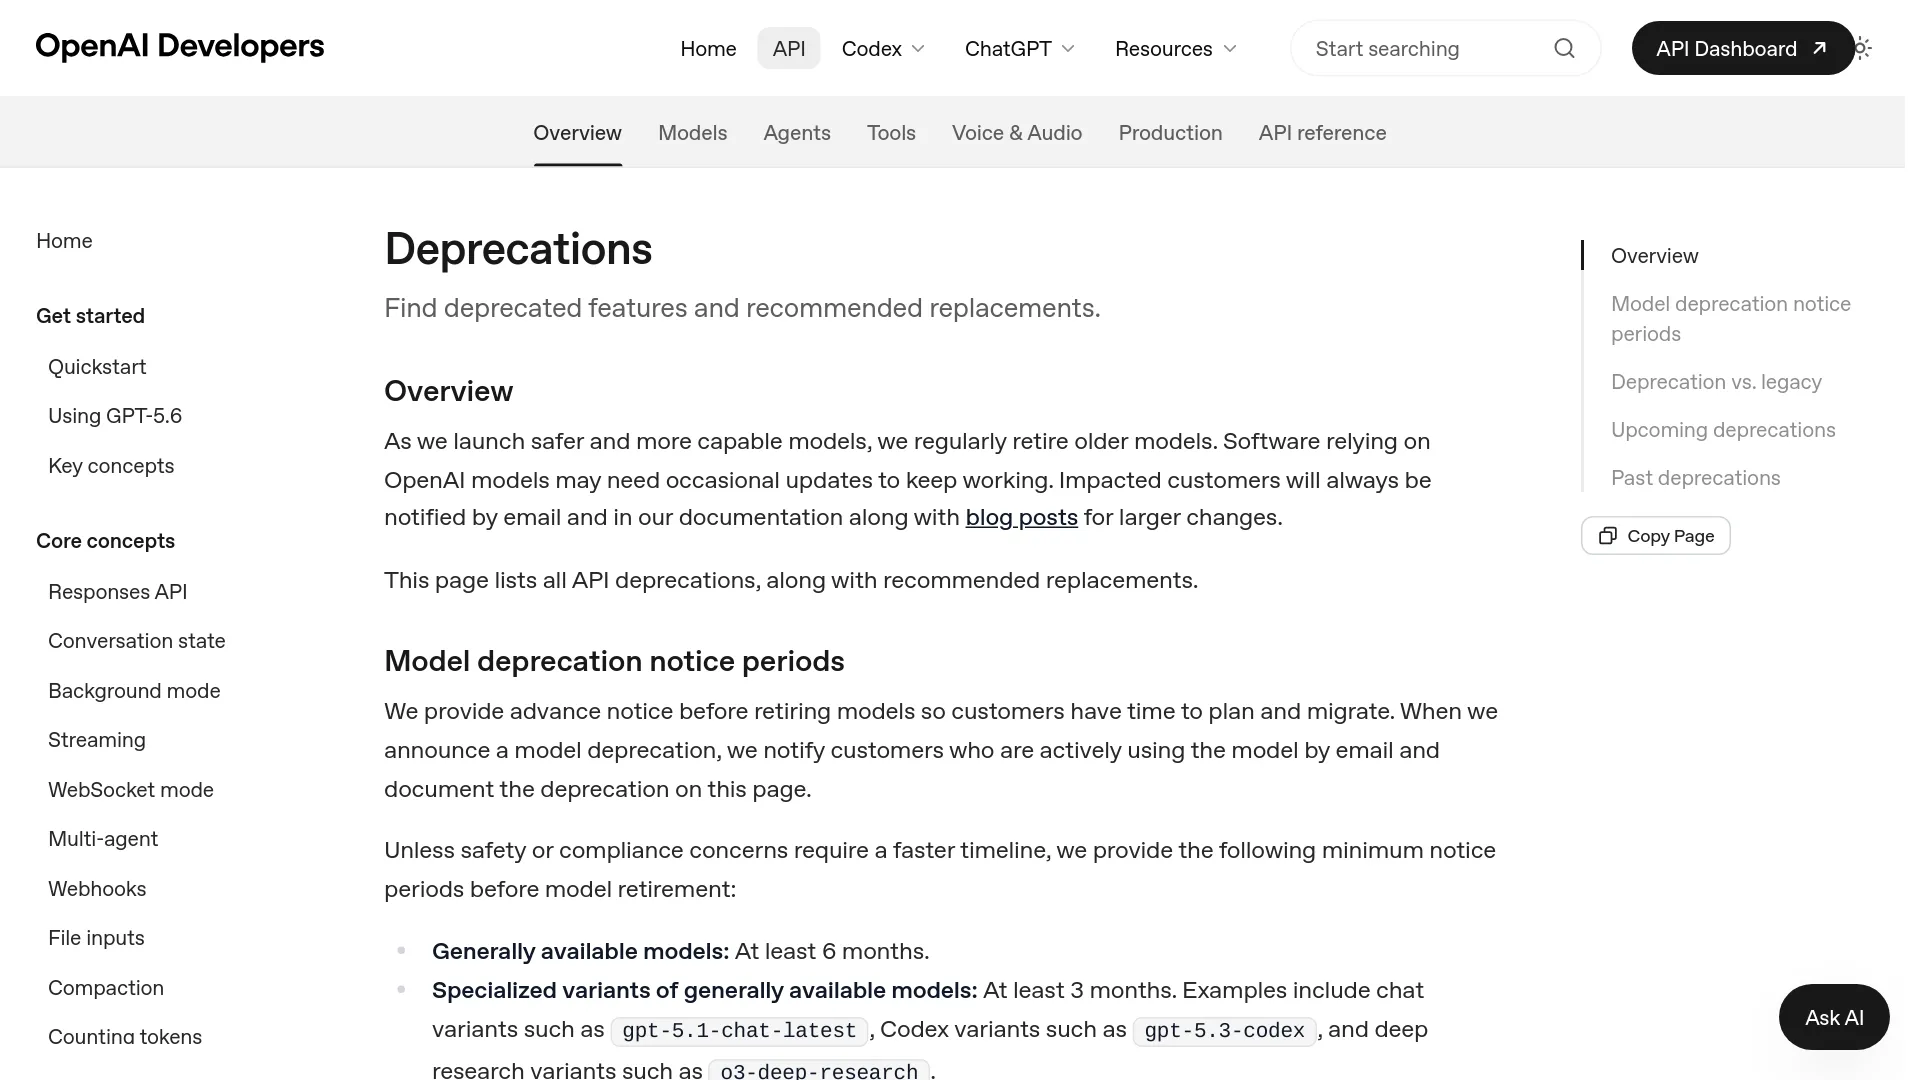
Vier Objekt-Mappings mit zwei wichtigen Folgen für die Architektur
Der Migrationsleitfaden von OpenAI ordnet vier Konzepte der Assistants API ihren Gegenstücken in der Responses-Welt zu:
| Assistants API | Nachfolger | Was sich tatsächlich ändert |
|---|---|---|
Assistants | Prompts | Die Konfiguration wandert in ein im Dashboard angelegtes, versioniertes Objekt |
Threads | Conversations | Speichert allgemeine Items – Messages, Tool Calls und Tool Outputs – statt nur Messages |
Runs | Responses | Der Ablauf aus Run erstellen, pollen und abrufen wird zu einem einzelnen Aufruf von responses.create |
Run steps | Items | Ein Union Type für Messages, Function Calls und Ergebnisse |
Wie stark dieser Ablauf verdichtet wird, zeigen die offiziellen Beispiele: Ein abgeschlossener Run mit gpt-4.1 weist 34 Prompt Tokens und 130 Completion Tokens aus. Eine abgeschlossene Response mit gpt-5.5 meldet dagegen 17 Input Tokens und 150 Output Tokens – vergleichbare Art von Workload, aber andere Feldnamen.
Genau diese Umbenennung ist die erste wichtige Fußnote. Billing-Dashboards und Payload-Parser, die auf die bisherigen Usage-Felder zugeschnitten sind, können beim Namenswechsel unbemerkt falsch laufen:
| Feld in Assistants | Feld in Responses |
|---|---|
usage.prompt_tokens | usage.input_tokens |
usage.completion_tokens | usage.output_tokens |
max_completion_tokens / max_prompt_tokens | max_output_tokens |
truncation_strategy | truncation |
object: "thread.run" | object: "response" |
Die zweite Fußnote betrifft die Architektur. Prompts lassen sich nur im Dashboard erstellen, nicht per API. Damit funktionieren Systeme nicht mehr wie bisher, die dynamisch einen Assistant pro Kunde, Workspace oder Dokumentensammlung anlegen. Der offizielle Leitfaden rät selbst dazu, vor dem Einsatz von Prompt-Objekten in langlebigen Integrationen deren Deprecation-Zeitplan zu prüfen: Wiederverwendbare Prompt-Objekte bringen ein eigenes Sunset-Risiko mit. Dauerhaft robuster ist es, Instructions, Tool Schemas und die Modellauswahl im eigenen Source Control zu halten und bei jeder Anfrage mitzusenden. Zu Thread-Historien fällt OpenAIs Position knapp aus: "We will not provide an automated tool for migrating Threads to Conversations."
Die drei integrierten Tools auf Responses umstellen
Für jedes Assistants-Tool gibt es in Responses ein konkretes Ziel – und jeweils mehr Verantwortung für Ihre Anwendung:
| Assistants-Tool | Entsprechung in Responses | Was jetzt Ihre Anwendung übernimmt |
|---|---|---|
| File search | Vector Stores bleiben bestehen; übergeben Sie vector_store_ids zur Request-Zeit in der Tool-Definition | Vor jedem Aufruf die richtigen Store-IDs auflösen |
| Code interpreter | Container mit type: "auto" konfigurieren | Den Lebenszyklus des Containers |
| Functions | Der verschachtelte Schlüssel function entfällt; name, description und parameters rücken eine Ebene nach oben | Die Tool-Schleife: Aufruf ausführen, Ergebnis mit passender call_id zurückgeben und über weitere Schleifen entscheiden |
Gerade File Search verändert die Architektur von Multi-Tenant-Anwendungen leise, aber grundlegend. Ein Vector Store pro Tenant war bisher eine beim Setup hinterlegte Bindung am Assistant-Objekt. Nun muss der Tenant der eingehenden Session vor dem Request auf die korrekten Store-IDs aufgelöst werden.
Was bei bereits erfolgten Migrationen schiefging
OpenAI begründet den Wechsel damit, dass Responses Feature-Parität erreicht habe. Die folgenden Migrationsberichte zeigen: Auf Objektebene mag diese Parität bestehen, darunter liegt jedoch ein echter Refactor. Der Betreiber eines Multi-Tenant-Chatbot-SaaS dokumentierte auf r/aiagents eine zweiwöchige Migration. Die Probleme blieben, obwohl er den offiziellen Leitfaden sorgfältig befolgt hatte:
Ich musste jedes optionale Feld als
["type", "null"]nachrüsten, was sich wie ein Workaround für das Typsystem anfühlt. — u/aidenclarke_12
Strikte Tool Schemas verlangen, dass optionale Properties nullable deklariert werden und trotzdem in required stehen. Dadurch werden Schemas umfangreicher, und jeder Handler, der fehlend mit nicht vorhanden gleichsetzt, muss erneut geprüft werden. Derselbe Entwickler benannte auch den Kern der tieferliegenden Umstellung:
Die Änderung bei der Vector-Store-Anbindung ist der eigentliche Architekturwechsel. — u/aidenclarke_12
Streaming ist der zweite stille Fehlerherd. Assistants-Run-Streaming lässt sich nicht einfach an Responses anpassen, sondern muss anhand typisierter Server-Sent Events neu geschrieben werden: etwa response.created, response.output_text.delta, response.completed sowie response.function_call_arguments.delta / .done. Es gibt explizite Completion-Events und neue Event-Formate für Tool Calls; die Event-Namen sind in einer Migrationsübersicht dokumentiert. Sowohl SSE-Proxies als auch Client-Handler benötigen ein Rewriting, einschließlich der Reconnect-Logik.
Der dritte Stolperstein liegt nicht in der API selbst, sondern im Rückstand des Ökosystems:
Die Response API gibt es schon lange, aber viele Framework-SDKs unterstützen sie noch immer nicht. — u/zhlmmc
Wenn Ihr Stack auf einem Agent-Framework basiert, das weiterhin vom Threads/Runs-Modell ausgeht – genau auf diese Verzögerung stieß u/zhlmmc –, sollten Sie dafür ebenso Zeit einplanen wie für Ihren eigenen Glue Code.
State-Strategie wählen: Chaining, Conversations oder manuelles Replay
In Responses gibt es drei Wege, mehrturnigen Kontext zu behalten. Sie sind nicht austauschbar:
| Strategie | Geeignet für | Worauf Sie achten müssen |
|---|---|---|
previous_response_id | Einfachstes Chaining mit minimalen Änderungen | Vorheriger Kontext bleibt kostenpflichtiger Input |
| Conversations API | Nächste Entsprechung zu Threads; serverseitige Historie | Das Backfill müssen Sie selbst bauen; es gibt kein Vendor-Tool |
Manuelles Replay, store: false | ZDR und strenge Anforderungen an die Aufbewahrung | Sie verwalten den gesamten State; Reasoning Items müssen weitergegeben werden |
Für die Historie empfiehlt OpenAI folgende Reihenfolge, um einen alten Thread zu konvertieren:
- Listen Sie die Messages des Threads in aufsteigender Reihenfolge auf.
- Wandeln Sie jede User-Textnachricht in
input_textum. - Wandeln Sie jede Assistant-Textnachricht in
output_textum. - Konvertieren Sie Inhalte mit Bild-URLs zu
input_image;image_urlunddetailbleiben erhalten. - Erstellen Sie die Conversation mit den konvertierten
items.
Ein falsches Role-Mapping hat einen konkreten Effekt: Das Modell liest seine eigenen früheren Antworten als neue Anweisungen des Nutzers. Gespeicherte Responses haben standardmäßig eine TTL von 30 Tagen, sofern Sie nicht store: false übergeben. Conversations liegen außerhalb dieser Response-TTL und hatten Ende Juli 2026 keine separat veröffentlichte Aufbewahrungsdauer, wie die Migrationsberichterstattung festhält. Das ist relevant, wenn Ihre Hinweise ein Zeitfenster für die Löschung zusichern.
Welche Folgen die Migration für Ihre Token-Kosten hat
Zwei Abrechnungsaspekte sind entscheidend.
Erstens: previous_response_id ist bequem, aber kein Rabatt. Laut OpenAIs Migrationsleitfaden für Responses werden frühere Input Tokens einer Response-Kette weiterhin als Input Tokens abgerechnet. Lange Unterhaltungen wachsen ohne Bereinigung daher linear.
Zweitens sind gecachte Inputs deutlich günstiger als nicht gecachte: Über die GPT-5.x-Tiers hinweg lagen sie im Juli 2026 ungefähr bei einem Zehntel des Input-Preises. Zudem meldete OpenAI in internen Tests für Responses gegenüber Chat Completions eine um 40–80 % bessere Cache-Auslastung, laut der zusammengetragenen Berichterstattung. Behandeln Sie diese Auslastungsspanne als Herstellerangabe, bis Ihre eigenen Dashboards sie bestätigen. Entscheidend ist der Vergleich Ihrer Token-Zahl pro Session vor und nach dem Cutover.
Falls die Migration zugleich Anlass ist, den GPT-5.x-Workload neu zu kalkulieren: Die Preisaufschlüsselung für GPT-5.6 erläutert die Rechnung pro Token. OpenAI-kompatible Endpunkte wie die GPT-5.6 API-Seite führen dieselben Responses-artigen Workloads aus und eignen sich damit für einen direkten Vergleich.
Ein Migrationsplan für Ihre verbleibende Zeit
1–6 Tage verbleibend. Sichern Sie zuerst alles: Listen Sie Assistants und Vector Stores mit limit=100 auf, laden Sie Dateien herunter und serialisieren Sie SDK-Objekte mit model_dump(). Backup-orientierte Leitfäden weisen auf die harte Grenze hin: Es gibt keinen List-Threads-Endpoint. Exportieren können Sie daher nur Thread-IDs, die Ihre Anwendung bereits gespeichert hat. Stellen Sie dann hinter einem Flag um: Neue Sessions gehen sofort an Responses, alte Threads werden erst bei erneuter Öffnung durch einen Nutzer schrittweise nachgezogen.
Eine Woche oder mehr. Migrieren Sie zunächst einen risikoarmen Flow vollständig, bevor Sie den Rest anfassen. Bauen Sie die Tool-Schleife neu auf und prüfen Sie, dass jedes Function-Ergebnis die passende call_id trägt. Ersetzen Sie das Stream-Handling durch Verzweigungen nach Event-Typ. Vergleichen Sie anschließend Verhalten, Latenz, Token-Verbrauch und Fehlerraten mit der Assistants-Basis, bevor Sie den Traffic ausweiten.
Nach Ablauf der Frist. Die Endpunkte liefern Fehler, und Assistant-Konfigurationen sind API-seitig nicht mehr verfügbar. Wiederherstellung bedeutet dann, aus Ihrer Anwendungsdatenbank und Backups neu aufzubauen. Vector Stores und Dateien bleiben über File Search erreichbar.
Der offene Zielkonflikt: Sie tauschen einen serverseitig verwalteten Lebenszyklus – Polling, Truncation und Tool-Schleife – gegen ein Single-Call-Modell, dessen Orchestrierung sichtbar und testbar ist. Ein Entwickler, der beide Varianten produktiv eingesetzt hat, fasste es so zusammen:
Die Responses API trifft perfekt die Mitte – sie übernimmt die schwere Arbeit, bleibt aber flexibel genug für eigene Funktionalität. — u/landongarrison
FAQ zur Abschaltung der OpenAI Assistants API
Wird auch die Chat Completions API abgeschaltet?
Nein. Chat Completions gehört nicht zur Abschaltung am 26. August 2026. OpenAI behandelt die Migration zu Responses hier als schrittweise Umstellung einzelner Flows, nicht als Wechsel mit verbindlicher Frist.
Migriert OpenAI meine bestehenden Threads automatisch?
Nein. Der offizielle Migrationsleitfaden sagt ausdrücklich: "We will not provide an automated tool for migrating Threads to Conversations." Das Backfill ist Anwendungscode, den Sie selbst schreiben und dabei die oben beschriebene Item-Konvertierung anwenden.
Kann ich die Assistants API nach dem 26. August 2026 weiter nutzen?
Nein. Assistants, Threads, Messages, Runs und Run Steps liefern nach diesem Datum Fehler – einschließlich Workflows mit assistants=v2. Exportieren Sie alles Benötigte vor dem Stichtag.
Laufen gespeicherte Responses ab?
Ja. Gespeicherte Responses haben standardmäßig eine Aufbewahrungsfrist von 30 Tagen, sofern Sie nicht store: false übergeben. Conversations liegen nach dem Stand der Berichterstattung vom Juli 2026 außerhalb dieser TTL.
Muss ich meine Assistant-Konfiguration in Prompts überführen?
Nein – und bei dynamisch erzeugten Assistants sollten Sie das nicht tun. Prompts lassen sich nur im Dashboard anlegen, und der offizielle Leitfaden selbst verweist auf die Prüfung möglicher Deprecations für wiederverwendbare Prompt-Objekte. Instructions und Tool Schemas im Source Control zu halten und pro Request zu übergeben, ist das robustere Muster.