 AIREITER
Muse Spark 1.3 kostet bei OpenRouter derzeit 1,25 US-Dollar pro einer Million Input-Tokens und 4,25 US-Dollar pro einer Million Output-Tokens. Der Preis allein entscheidet aber nicht über die Praxistauglichkeit. Besonders interessant ist das Modell für Coding-Aufgaben mit langem Kontext und agentische Workflows. Gleichzeitig ist der Rollout noch jung, Max Reasoning war zum Start nicht verfügbar und der erste Token kann lange auf sich warten lassen.
Was Muse Spark 1.3 ist – und was „verfügbar“ hier bedeutet
Muse Spark 1.3 ist Metas proprietäres Reasoning-Modell für länger laufende Agenten-Workflows, Coding und multimodale Aufgaben. Meta kündigte es am 2. September 2026 an und erklärte, dass der Rollout in Muse Code und der Meta Model API erfolge. Die bestehenden Reasoning-Modi waren zuerst verfügbar; für Max Reasoning waren zusätzliche Sicherheitstests nötig. (Ankündigung von Meta AI Research)
Da die Launch-Grafik bereits Ergebnisse für Max zeigt, Max Reasoning aber noch zusätzliche Sicherheitstests benötigte, sollten Käufer nicht davon ausgehen, dass diese Werte vom ersten Tag an reproduzierbar sind.
Meta zufolge hält Muse Spark 1.3 bei langen Aufgaben Anforderungen besser ein, verarbeitet Unterbrechungen innerhalb eines Threads zuverlässiger, stellt häufiger Rückfragen, bittet vor folgenreichen Aktionen um Bestätigung und erkennt besser, wenn es nicht weiterkommt. In internen Coding-Vergleichen soll das Modell außerdem rund 20 % weniger Tool-Aufrufe und 25 % weniger Tokens als Muse Spark 1.2 benötigen. Diese Zahlen stammen vom Anbieter; ein reproduzierbarer Aufgabensatz und Fehlerbalken fehlen.
Im Launch-Beitrag beschreibt Meta Open Weights als Teil der künftigen Roadmap. Die hier geprüften Quellen führen Muse Spark 1.3 als gehostetes Modell an, das ausschließlich über eine API verfügbar ist. Einen herunterladbaren Checkpoint, eine bestätigte Lizenz, eine Parameterzahl oder konkrete Hardwareanforderungen dokumentieren sie nicht.
Die API-Preise sind übersichtlich – die Kostenrechnung nicht
Die klarste öffentliche Preisliste findet sich auf der OpenRouter-Seite zu Muse Spark 1.3, nicht im Launch-Beitrag von Meta. OpenRouter nennt Standardpreise von 1,25 und 4,25 US-Dollar pro einer Million Input- beziehungsweise Output-Tokens. Hinzu kommen separate Gebühren für Cache-Lesezugriffe und Websuche.
| Nutzung | Ausgewiesener Preis | Worauf es ankommt |
|---|---|---|
| Input | 1,25 $ / 1 Mio. Tokens | Neue Prompt- und Kontext-Tokens |
| Output | 4,25 $ / 1 Mio. Tokens | Etwa 3,4-mal so teuer wie der Input |
| Cache-Lesezugriff | 0,15 $ / 1 Mio. Tokens | Nützlich bei wiederholtem Agentenkontext |
| Websuche | 2,50 $ / 1.000 Aufrufe | Zusätzlich zu den Token-Gebühren |
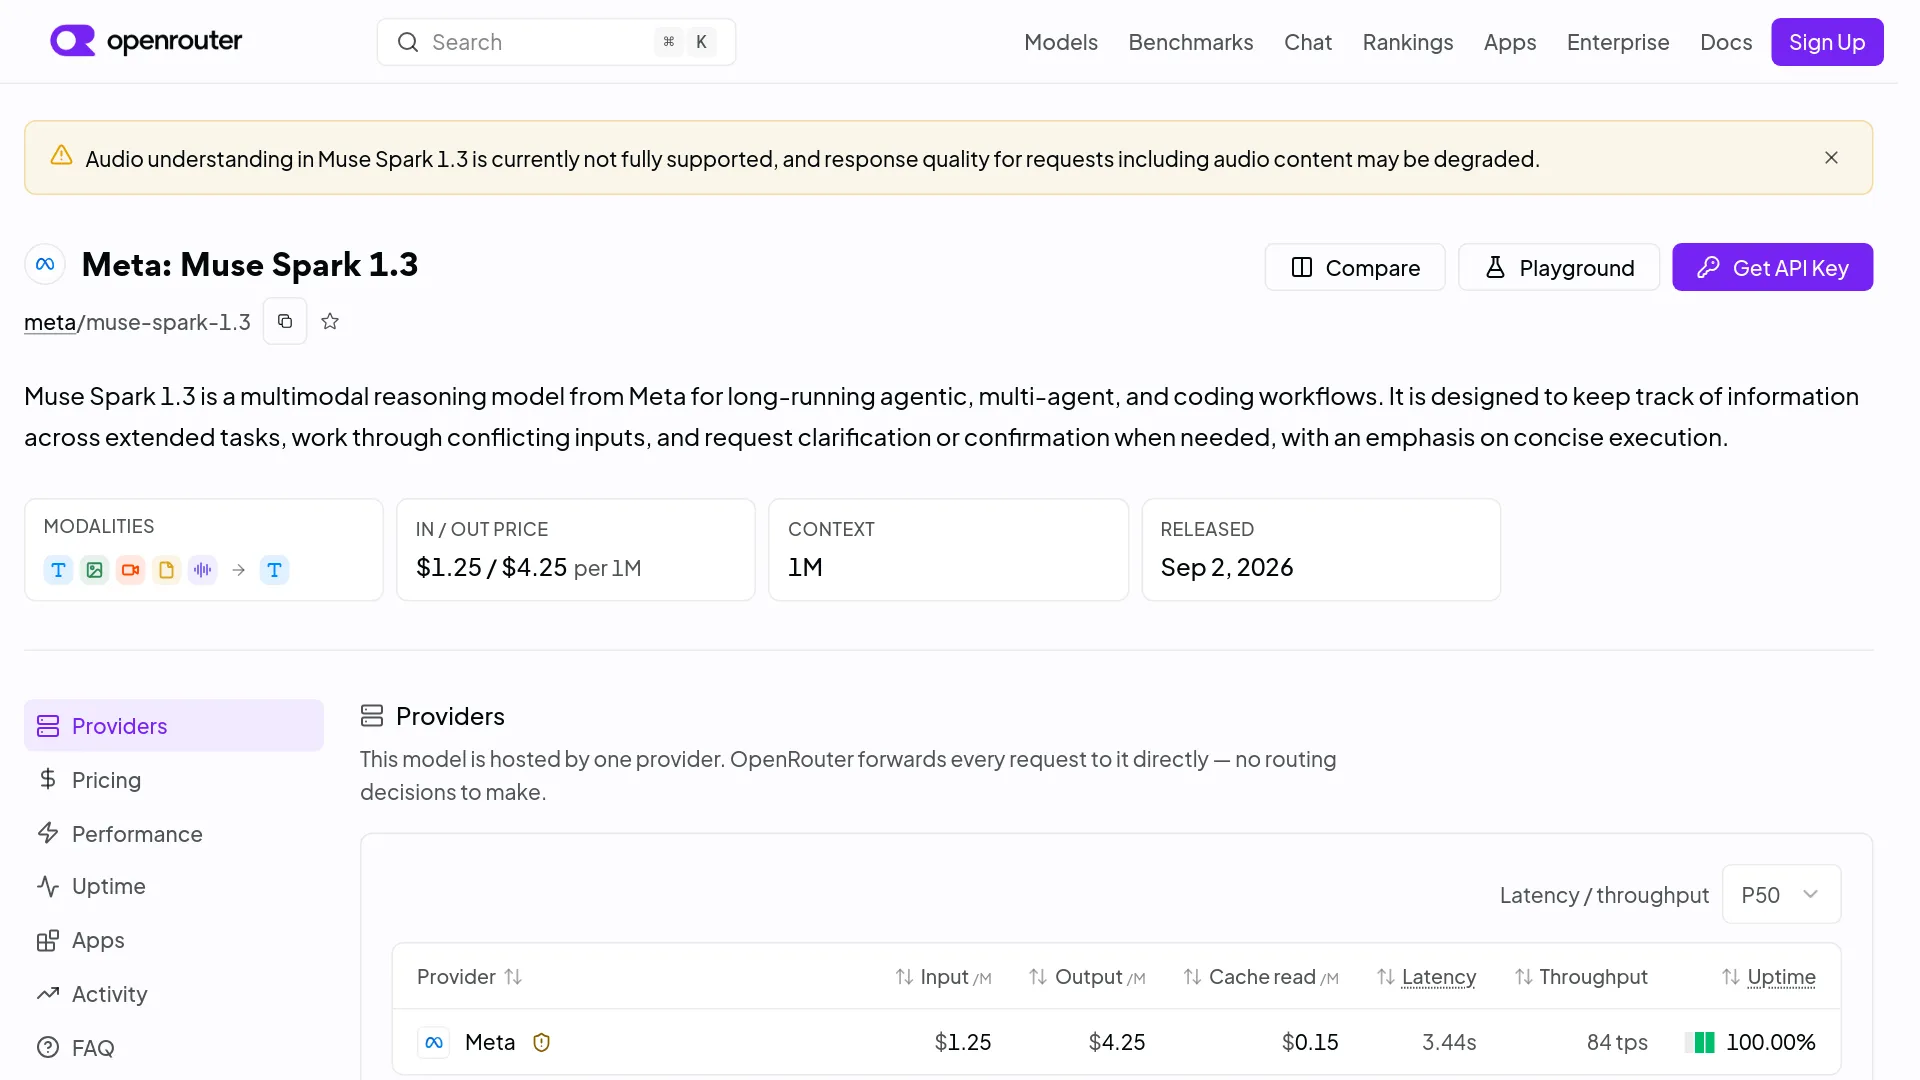
Eine Anfrage mit 100.000 neuen Input-Tokens und 20.000 Output-Tokens kostet vor Cache- oder Websuche-Gebühren ungefähr 0,21 US-Dollar: 0,125 US-Dollar für den Input plus 0,085 US-Dollar für den Output. Agentenschleifen, Wiederholungen und erneut übertragener Kontext treiben die Kosten kompletter Aufgaben nach oben.
Artificial Analysis weist einen gemischten Preis von 0,78 US-Dollar pro einer Million Tokens aus. Grundlage ist ein Mix aus 7:2:1 für Cache-Treffer, Input und Output. Workflows mit frischem Kontext oder hohem Output-Anteil sind teurer. Der Wert ist daher als Szenario-Schätzung zu verstehen, nicht als allgemeingültiger Tarif.
Die Contributor-Annahmen aus dem Muse Spark 1.2 API Pricing Guide lassen sich nicht automatisch auf Muse Spark 1.3 übertragen. Das öffentliche 1.3-Angebot bestätigt zwar den genannten Standardtarif, die hier geprüften Quellen belegen aber keinen vollständigen 1.3-Contributor-Vertrag zu Datennutzung, Rate Limits oder regionaler Verfügbarkeit. Plane daher zunächst mit dem Standardpreis, bis dein Provider etwas anderes bestätigt.
Die Daten sprechen für ein starkes Coding-Modell – nicht für einen Alleskönner
Die vorliegenden Ergebnisse zeichnen Muse Spark 1.3 als starkes Modell für Coding und lange Kontexte aus, nicht als universellen Spitzenreiter. Die folgende Tabelle nutzt Werte aus Metas verlinkter Evaluationsmethodik. Die Benchmark-Skalen unterscheiden sich; höhere Werte sind nur innerhalb derselben Zeile direkt vergleichbar.
| Evaluation | Muse 1.3 max | Muse 1.3 xhigh | Muse 1.2 xhigh | GPT-5.6 Sol | Claude Opus 5 | Höchster Wert |
|---|---|---|---|---|---|---|
| MRCR 512K–1M | 98.1 | 93.1 | 55.5 | 73.8 | — | Muse 1.3 max |
| DeepSWE v1.1 | 75.4 | — | 55.0 | 73.0 | 74.0 | Muse 1.3 max |
| SWE-Atlas Codebase QnA | 59.4 | 54.0 | 46.2 | 53.5 | 52.7 | Muse 1.3 max |
| Terminal-Bench 2.1 | 88.8 | 89.2 | 82.9 | 88.8 | 86.7 | Muse 1.3 xhigh |
| OSWorld 2.0 | 66.9 | 57.2 | 47.6 | 62.7 | 68.3 | Claude Opus 5 |
| DeepSearchQA | 89.4 | 89.4 | 85.9 | 93.0 | 90.4 | GPT-5.6 Sol |
| GDPVal-AA v2 | 1754 | 1709 | 1615 | 1710 | 1824 | Claude Opus 5 |
Der stärkste Beleg für Muse Spark 1.3 liegt beim Coding mit langem Kontext: Im MRCR-Test bei 512K–1M Kontext erreicht die Max-Variante 98.1, bei DeepSWE 75.4. Muse Spark 1.2 xhigh kommt dort auf 55.5 beziehungsweise 55.0. Dieselbe Tabelle zeigt aber auch, dass andere Modelle bei bestimmten Aufgaben aus professionellen Workflows, Computer-Use und Recherche besser abschneiden.
Metas Methodik weist darauf hin, dass die einzelnen Werte aus Metas eigener Evaluation, einem offiziellen Leaderboard oder einer Selbstauskunft eines Providers stammen können. Die Coding-Tests liefen mit eingeschränkten Tools und ohne externen Internetzugriff. Damit sind die Ergebnisse interessante Signale, aber kein vollständig unabhängig reproduzierter Vergleich.
Artificial Analysis nennt einen Intelligence-Index von 61 und Platz #10 von 196 vergleichbaren Modellen. Der Median dieser Vergleichsgruppe liegt bei 36. ModelCap weist einen ModelCap-Index von 81,7 und Platz 4 im Ranking aus, vergibt aber nur 20 % Unterstützung und stützt sich auf eine öffentliche Benchmark-Beobachtung. Die unterschiedlichen Systeme führen zur gleichen Vorsicht: Die Datenbasis ist noch dünn.
Für einen echten Workflow solltest du Muse Spark 1.3 zunächst bei der Erkundung von Repositories, langen Terminal-Agenten und Fragen zu Codebasen testen. Die Ergebnisse lassen sich nicht ohne Weiteres auf jede browserlastige Aufgabe oder jeden professionellen Computer-Use-Workflow übertragen.
Das Geschwindigkeit-Paradox: schnell nach dem Start, langsam bis zum Start
Muse Spark 1.3 scheint nach Beginn der Ausgabe schnell zu arbeiten. Bis die erste sichtbare Antwort erscheint, kann es jedoch deutlich länger dauern. Das spricht eher für längere oder gebündelte Aufgaben als für interaktives Pair Programming, bei dem jede Runde sofort beginnen sollte.
Artificial Analysis misst 181,7 Output-Tokens pro Sekunde; der Median vergleichbarer Modelle liegt bei 68,1. Gleichzeitig nennt die Plattform 27,51 Sekunden bis zum ersten Token, gegenüber einem Median von 3,04 Sekunden, und schätzt unter dem eigenen Workload 41,26 Sekunden für eine Antwort mit 500 Tokens. Auf der Provider-Seite werden 38,51 Sekunden bis zum ersten Antwort-Token sowie 0,55 US-Dollar Kosten pro Intelligence-Index-Aufgabe ausgewiesen.
OpenRouter zeigt andere P50-Werte: 62 Tokens pro Sekunde und 1,83 Sekunden Latenz. Die Kennzahlen sind nicht direkt vergleichbar, weil die Seiten unterschiedliche Workloads und Definitionen verwenden. Außerdem berücksichtigt Artificial Analysis bei der Zeit bis zur ersten Antwort auch die Reasoning-Zeit. Miss in deinem eigenen Testsystem sowohl die Zeit bis zum ersten Token als auch die Gesamtdauer der Aufgabe.
„Da ein paar Leute fragen: Mein erster Eindruck (läuft gerade noch) – wirkt mechanisch (hervorragend für Arbeit, bei Strategie bin ich unsicher), aber sehr leistungsfähig. Scheint sehr schnell zu sein.“ — u/NewYak4281, r/singularity
Dieser unkontrollierte erste Eindruck passt zum gemessenen Kompromiss: eine schnelle Ausgabe nach potenziell langer Wartezeit und ein Interaktionsstil, der mechanisch wirken kann. Als Kontext ist das hilfreich, einen kontrollierten Test ersetzt es nicht.
API-Funktionen und Rollout-Limits vor dem Produktiveinsatz prüfen
Muse Spark 1.3 bringt die Integrationsfunktionen eines modernen Agentenmodells mit. Mehrere Details für den Produktivbetrieb hängen jedoch vom Provider ab oder sind nicht veröffentlicht. Die derzeit belastbarsten API-Hinweise stammen von der aktiven OpenRouter-Modellseite und dem Provider-Tracker von Artificial Analysis, nicht aus einer vollständigen öffentlichen Meta-Spezifikation im Launch-Beitrag.
| Funktion oder Limit | Aktueller Stand | Bedeutung für den Produktivbetrieb |
|---|---|---|
| Kontextfenster | OpenRouter und ModelCap nennen 1.048.576 Tokens | Effektives Limit des konkreten Endpunkts bestätigen |
| Maximale Ausgabe | ModelCap nennt 944K Tokens | Provider können niedrigere Output-Limits setzen |
| Eingaben | Text, Bilder, Videos und Dateien; Audio ist mit Warnhinweis aufgeführt | Audioverständnis als unvollständig behandeln |
| Ausgabe | Text | Workflow auf textvermittelte Verarbeitung auslegen |
| Tool-Aufrufe | Als unterstützt aufgeführt | Schemas und Tool-Fehler im eigenen SDK testen |
| Strukturierte Ausgabe | Antwortformat mit JSON-Schema ist aufgeführt | Fehler bei strikten Schemas testen |
| Provider-Abdeckung | Auf der OpenRouter-Seite und im Artificial-Analysis-Tracker ist ein Meta-Provider sichtbar | Keine redundante Ausfallsicherung voraussetzen |
| Modellgewichte | Nur per API; keine herunterladbaren Gewichte aufgeführt | Kein etablierter Self-Hosting-Weg |
ModelCap weist darauf hin, dass ein einzelner Provider ein kleineres Kontext- oder Output-Limit anbieten kann als das veröffentlichte Maximum. Das Verfügbarkeits-Panel von OpenRouter zeigt für drei Tage eine Uptime von 99,97 %, für die Ansichten über 72 und 24 Stunden jedoch niedrigere Werte. Das sind unterschiedliche Seitenmetriken. Für produktiven Traffic solltest du deshalb aktuelle Statusdaten und deine eigenen Fehlerprotokolle heranziehen.
Meta veröffentlicht im Launch-Beitrag weder die Parameterzahl noch die Architektur, formale API-Rate-Limits, Lizenzbedingungen oder detaillierte Ergebnisse der Sicherheitstests. Das Unternehmen behauptet zwar eine bessere Widerstandsfähigkeit gegen Prompt Injection und eine zuverlässigere Einschätzung irreversibler Aktionen, nennt dafür aber weder Erfolgsraten von Angriffen noch ein reproduzierbares Red-Team-Protokoll.
Solltest du Muse Spark 1.3 jetzt einsetzen?
Muse Spark 1.3 ist einen Test wert, wenn du Coding mit langem Kontext und toolintensive Agenten-Workflows betreibst, bei denen niedrige Tokenkosten und eine zügige Dauerausgabe wichtiger sind als sofortige Antworten. Als einziges Produktionsmodell ist es für latenzkritische, audiointensive, datenschutzsensible oder auf Redundanz angewiesene Systeme noch nicht geeignet.
| Deine Situation | Entscheidung |
|---|---|
| Großes Repository, Fragen zur Codebasis, lange Terminal-Aufgabe | Muse Spark 1.3 zuerst testen |
| Gebündelte Agentenarbeit, bei der die Ausgabegeschwindigkeit zählt | Guter Kandidat; Gesamtkosten der Aufgabe messen |
| Interaktives Pair Programming | Nur einsetzen, wenn die Verzögerung bis zum ersten Token akzeptabel ist |
| Audio-basierter Workflow | Abwarten oder bestätigte Audio-Unterstützung wählen |
| Sensibler Kundencode oder regulierte Daten | Zuerst den Datenvertrag prüfen |
| Geschäftskritischer Dienst mit Failover-Anforderung | Ein zweites Modell und eine alternative Route vorhalten |
Ein risikoarmer Rollout bringt mehr als ein weiterer Screenshot aus einem Leaderboard:
- Starte mit einem nicht sensiblen Repository und fünf bis zehn fest definierten Aufgaben.
- Beschränke Shell-, Dateiänderungs-, Netzwerk- und destruktive Tools auf die unbedingt nötigen Berechtigungen.
- Protokolliere Abschlussrate, Tool-Aufrufe, Zeit bis zum ersten Token, Dauer, Tokenverbrauch und Rechnungskosten.
- Vergleiche dieselben Aufgaben mit deinem bisherigen Basismodell und halte für Timeouts oder Änderungen mit geringer Konfidenz ein Fallback bereit.
Schalte Muse Spark 1.3 bei Coding-Agenten zunächst über ein Experiment-Flag frei und entscheide auf Basis des Repository-Tests statt des Rankings vom Starttag. Der Preis und die Ergebnisse bei langem Kontext sprechen für einen Test. Die langsame erste Antwort, die geringe Provider-Liquidität, die unvollständige Audio-Unterstützung und die vorläufige Benchmark-Abdeckung sprechen dagegen, das Modell exklusiv einzusetzen.
Muse Spark 1.3 API und Preise: Häufige Fragen
Ist Muse Spark 1.3 offiziell veröffentlicht?
Ja. In Metas Ankündigung vom 2. September 2026 heißt es, dass Muse Spark 1.3 in Muse Code und der Meta Model API ausgerollt wurde. Max Reasoning wartete zu diesem Zeitpunkt noch auf zusätzliche Sicherheitstests.
Wo kann ich auf Muse Spark 1.3 zugreifen?
Meta nennt Muse Code und die Meta Model API. Auch OpenRouter führt meta/muse-spark-1.3 auf. Der Zugriff kann je nach Provider, Konto und Region variieren.
Wie viel kostet Muse Spark 1.3?
Der OpenRouter-Eintrag nennt 1,25 US-Dollar pro einer Million Input-Tokens, 4,25 US-Dollar pro einer Million Output-Tokens, 0,15 US-Dollar pro einer Million Cache-Read-Tokens und 2,50 US-Dollar pro 1.000 Websuch-Aufrufen. Behandle diese Werte als die genannten OpenRouter-Tarife, sofern dein direkter Provider keine eigene Preisliste bestätigt.
Hat Muse Spark 1.3 ein Kontextfenster von einer Million Tokens?
OpenRouter und ModelCap nennen 1.048.576 Tokens, während Artificial Analysis auf eine Million abrundet. Bestätige die effektiven Kontext- und Output-Limits für den von dir verwendeten Endpunkt.
Unterstützt das Modell Vision, Video, Tools und JSON-Ausgaben?
OpenRouter führt Text-, Bild-, Video- und Dateieingaben sowie Tool-Aufrufe und strukturierte Ausgaben per JSON-Schema auf. Audio ist ebenfalls aufgeführt, allerdings mit dem Hinweis, dass das Verständnis noch nicht vollständig unterstützt wird.
Ist Muse Spark 1.3 Open Source oder selbst hostbar?
In den geprüften Quellen wurden weder herunterladbare Gewichte noch ein Paket für Self-Hosting gefunden. Meta beschreibt Open Weights als künftige Roadmap, nicht als verfügbares Artefakt von Muse Spark 1.3.
Ist Max Reasoning verfügbar?
Meta erklärte, dass die bestehenden Reasoning-Modi zuerst verfügbar waren und Max Reasoning nach zusätzlichen Sicherheitstests folgen sollte. Einen konkreten Termin nannte die Ankündigung nicht.
Kann ich davon ausgehen, dass die Contributor-Preise von Muse Spark 1.2 auch für 1.3 gelten?
Nein. Die Contributor-Bedingungen für 1.2 sind separat dokumentiert. Die hier geprüften Quellen belegen jedoch keinen vollständigen Contributor-Vertrag für 1.3. Plane mit dem Standardtarif von 1.3, bis dein Provider eine andere Stufe, Datenrichtlinie und ein anderes Rate Limit bestätigt.
Führe vor dem Produktiveinsatz einen kleinen Benchmark mit einem nicht sensiblen Repository durch. Vergleiche dieselben Aufgaben mit deinem aktuellen Modell und protokolliere die Verzögerung bis zum ersten Token, abgeschlossene Änderungen, Tool-Aufrufe und Kosten. Damit lässt sich die Einsatzfrage zuverlässiger beantworten als anhand von Rankings am Tag des Launches.