 AIREITER
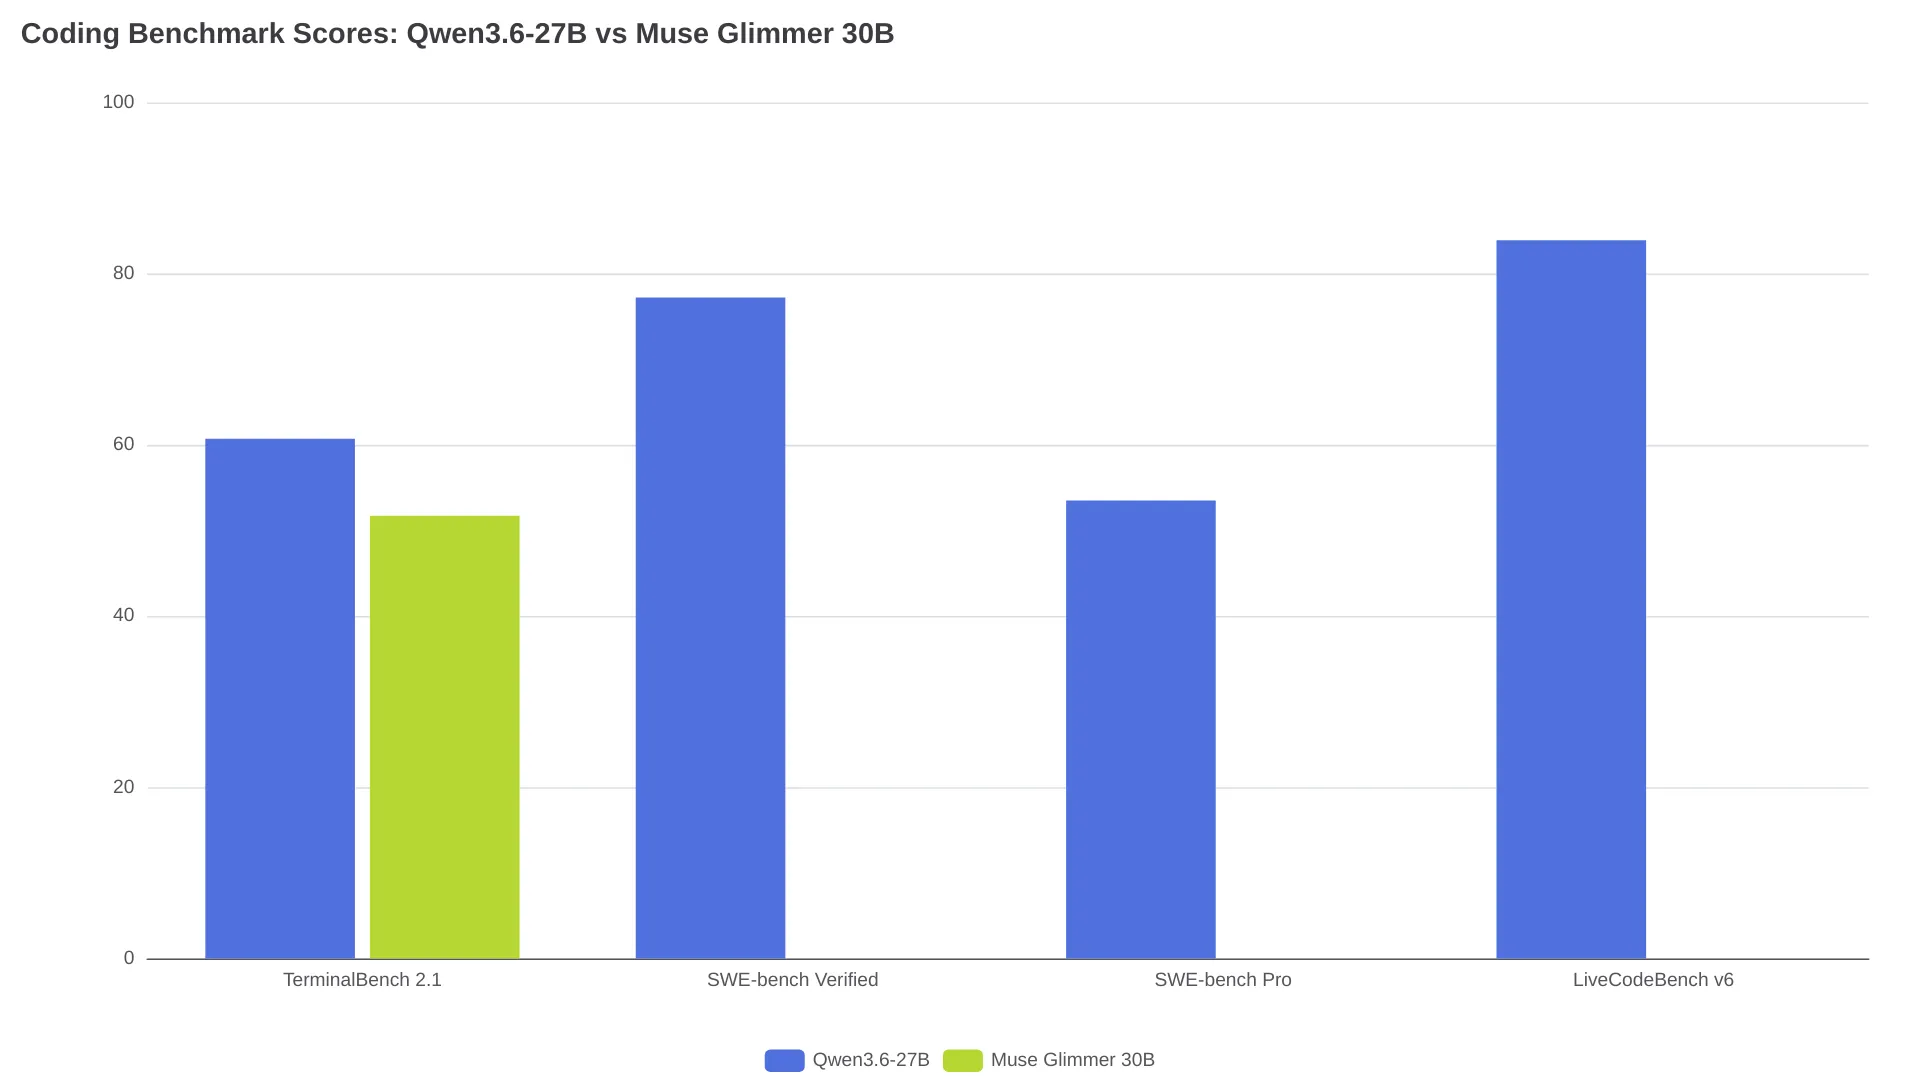
Bei Coding-Benchmarks zeichnet sich zunächst ein klares Bild ab: Qwen3.6-27B erreicht 60,7 Punkte in TerminalBench 2.1, Muse Glimmer 30B kommt auf 51,7. Für Qwen liegt zudem ein offizieller SWE-bench-Verified-Wert von 77,2 vor. Dennoch ist der Vergleich nicht so eindeutig, wie diese Zahlen nahelegen. Glimmer kann auf einer einzelnen GPU deutlich mehr Kontext unterbringen – ein entscheidender Vorteil für lokale Setups. Qwen3.6-27B erschien im April 2026 mit einer vollständigen Benchmark-Tabelle auf seiner Hugging Face model card; Muse Glimmer 30B folgte im August 2026 als Meta-Release mit offenen Gewichten, woraufhin die lokale LLM-Community innerhalb weniger Tage erste direkte Tests durchführte.
TerminalBench 2.1: Qwen liegt 9 Punkte vorn
TerminalBench prüft, wie zuverlässig ein Modell mehrstufige Aufgaben als Terminal-Agent löst. Dazu gehören Tool-Aufrufe und das Halten von Kontext über längere Sitzungen hinweg. In den verlinkten Community-Diskussionen wird TerminalBench 2.1 häufig als derzeit verfügbarer direkter Vergleich für Coding-Agenten genannt.
Von der Community gemeldete Ergebnisse für TerminalBench 2.1, aufgegriffen in r/LocalLLaMA-Diskussionen vom 10. bis 11. August 2026:
| Modell | TerminalBench 2.1 | Quellentyp |
|---|---|---|
| Qwen3.6-27B | 60.7 | Von der Community gemeldet |
| Muse Glimmer 30B | 51.7 | Von der Community gemeldet |
| Gemma 4 31B | 43.4 | Von der Community gemeldet |
Wichtig dabei: TerminalBench bewertet nicht nur das Basismodell, sondern die Kombination aus Modell und Harness. Die offizielle Karte von Qwen3.6-27B nennt einen Harbor/Terminus-2-Harness mit 3 Stunden Timeout, 32 CPUs, 48 GB RAM, 80K maximaler Ausgabe, 256K Kontext und Mittelwertbildung über fünf Durchläufe. Glimmers Ergebnis kann aus einer anderen oder weniger optimierten Harness-Konfiguration stammen. Je nach Agent-Setup könnte der Abstand von 9 Punkten also kleiner oder größer ausfallen.
Offizielle Coding-Benchmarks: Zahlen für Qwen, noch nicht für Glimmer
Qwen3.6-27B veröffentlicht offizielle Benchmark-Ergebnisse auf seiner Model Card. In den für diesen Vergleich ausgewerteten verlinkten Quellen fanden sich bis August 2026 keine offiziellen SWE-bench-, LiveCodeBench- oder vergleichbaren agentischen Coding-Benchmarks für Muse Glimmer. Qwen verfügt damit über die solidere veröffentlichte Datenbasis – ein offizieller direkter Vergleich unter identischen Bedingungen existiert allerdings nicht.
Die offiziellen Coding-Benchmarks von Qwen:
| Benchmark | Qwen3.6-27B (offiziell) |
|---|---|
| SWE-bench Verified | 77.2 |
| SWE-bench Pro | 53.5 |
| SWE-bench Multilingual | 71.3 |
| Terminal-Bench 2.0 | 59.3 |
| LiveCodeBench v6 | 83.9 |
Diese Werte stammen vom Anbieter selbst. Laut Model Card laufen die SWE-bench-Evaluierungen mit Qwens internem Bash-/File-Edit-Scaffold, Temperatur 1.0, top-p 0.95 und einem Kontextfenster von 200K. Die Ergebnisse für SWE-bench Pro wurden auf einem überarbeiteten Task-Set berechnet, in dem Qwen problematische Einträge korrigierte. Ein direkter Vergleich mit Werten aus öffentlichen Leaderboards ist daher möglicherweise nicht vollständig gleichwertig. Die Drittanbieteranalyse von morphllm weist ebenfalls darauf hin, dass die Ergebnisse auf Qwens eigenem Agent-Scaffold beruhen und nur begrenzt unabhängig reproduziert wurden.
Lokale Coding-Tests: Das berichten Anwender
OpenCode-Test mit Q4 auf dem M5 Pro
Ein Entwickler testete Muse Glimmer in Q4-Quantisierung, als Unsloth-Build, auf einem M5 Pro mit 48 GB RAM über OpenCode. Das Modell belegte ungefähr 20 GB RAM und erzeugte 17 Token pro Sekunde. Sein Fazit:
"Insgesamt unterhalb von Qwen3.6 27B" - u/curiousily_
Die Ergebnisse bei Frontend- und Backend-Code wurden schwächer als bei Qwen bewertet. Positiv fiel dem Autor auf, dass Muse Glimmer im Test keinen einzigen Tool-Call scheitern ließ. Reasoning-Loops oder verlängertes Nachdenken waren allerdings nicht konfiguriert, was Glimmers Leistung eingeschränkt haben könnte.
Die max_tokens-Falle
Ein weiterer Tester auf r/LocalLLM stellte fest, dass Muse Glimmer deutlich schlechter wirken kann, wenn das Budget für Ausgabe-Token zu knapp ist. Das Modell verbraucht sein Token-Budget zunächst für Reasoning, bevor sichtbare Ausgabe entsteht. Die Folge sind leere oder abgeschnittene Antworten. Nach dem Erhöhen von max_tokens stieg die Zahl bestandener Aufgaben in seinem Test-Harness von 6/13 auf 11/13 – die Erfolgsrate verdoppelte sich damit beinahe, ohne das Modell selbst zu verändern. Wer Glimmer mit den Standardlimits testet, misst möglicherweise eher die Konfiguration als das Modell.
Endlosschleifen im Hermes-Terminal
Ein anderer Nutzer berichtete, dass Muse Glimmer bei übermäßig vielen Terminal-Befehlen hängen blieb, wenn es mit dem Agent-Framework Hermes kombiniert wurde. Mit Qwen3.6-27B im selben Setup habe er dieses Verhalten nicht erlebt. Diese Einzelbeobachtung passt grundsätzlich zum derzeit sichtbaren Abstand in TerminalBench, trennt den Einfluss des Modells jedoch nicht von der Hermes-Konfiguration.
Token-Effizienz: Ein qualitativer Vorsprung
Der Benchmark-Galerie-Beitrag von u/NoFaithlessness951 brachte noch einen Effizienzaspekt ins Spiel:
"Etwas weniger intelligent als Qwen, aber deutlich weniger Token pro Aufgabe." - u/NoFaithlessness951
Das ist eine qualitative Beobachtung aus der Community, keine kontrollierte Messung von Token pro erfolgreich gelöster Aufgabe. Es gibt keine direkte Studie, die Glimmers Token-Vorteil gegenüber Qwen bei gleichen Aufgaben, Erfolgsraten und Latenzdaten beziffert. Die Aussage ist daher ein vielversprechender Hinweis, aber noch keine gesicherte Erkenntnis.
VRAM und Kontext: Hier hat Glimmer den Hardware-Vorteil
In diesem Punkt setzt sich Muse Glimmer klar ab. Ein Tester auf r/LocalLLaMA zeigte, dass Muse Glimmer 30B bei Q4_K_XL mit DFlash Speculative Decoding, multimodalem Projektor und vollständigem F16-KV-Cache auf einer einzelnen RTX 3090 ungefähr 22-23 GB benötigt. Konfiguriert war dabei ein Kontextfenster von 262.144 Token.
Gleiche RTX 3090, gleiche Q4_K_XL-Quantisierung:
| Modell | F16-KV-Kontext | Q8-KV-Kontext | Genutzter VRAM |
|---|---|---|---|
| Muse Glimmer 30B | 262,144 | N/A | ~22-23 GB |
| Qwen3.6-27B | 70,000 | 125,000 | Passt in 24 GB |
| Gemma 4 31B | 52,000 | 81,000 | Passt in 24 GB |
Für Workflows, die umfangreichen Repository-Kontext in den Prompt laden, bezeichnete der Autor Qwens F16-Kontext von 70K als "an der Grenze zur Unbrauchbarkeit".
Gemeldeter Durchsatz von Muse Glimmer auf diesem RTX-3090-Setup:
- Generierung: 64-124 Token pro Sekunde, abhängig davon, ob Code oder Fließtext erzeugt wurde
- Prompt-Verarbeitung: ~1.400 Token pro Sekunde
- Retrieval bei langem Kontext: bestand einen Two-Needle-Haystack-Test bei ~150K Token im ersten Versuch
Qwen3.6-27B benötigt auf derselben Hardware entweder eine Q8-KV-Cache-Komprimierung – also einen Tausch von Ausgabequalität gegen Kontextlänge – oder das Auslagern auf eine leistungsfähigere Maschine. Der Tester nutzte Qwen auf seinem DGX Spark, wenn voller Kontext erforderlich war, einem deutlich teureren Gerät.
Auf leistungsstärkerer Hardware erreichte ein Qwen3.6-27B-NVFP4-Build auf einem DGX Spark laut der Benchmark-Analyse von kie.ai in einer einzelnen Session 28-33 Token pro Sekunde, bei Kontexten bis 128K. Ein Unsloth Muse Glimmer Q5_K_M-Build auf einer RTX 5090 soll über einen gepatchten llama.cpp-DFlash-Pfad bei der Code-Patch-Generierung 220-253 Token pro Sekunde erreicht haben.
Welches Modell passt zu welchem Einsatz?
| Dein Szenario | Empfehlung | Warum |
|---|---|---|
| Reines Coding, einmalige Generierung | Qwen3.6-27B | Stärkere veröffentlichte Evidenz bei Coding-Benchmarks; vorn im verfügbaren Community-Vergleich zu TerminalBench 2.1 |
| Agentisches Coding mit großem Kontext auf einer einzelnen 24-GB-GPU | Muse Glimmer 30B | 262K F16-Kontext gegenüber 70K bei Qwen auf derselben Hardware im Q4_K_XL/DFlash-Setup |
| Terminal-Aufgaben mit langem Horizont | Qwen3.6-27B | 60.7 gegenüber 51.7 in TerminalBench 2.1; Community-Bericht über Schleifen im Agent-Framework bei Glimmer |
| Hoher Durchsatz bei Kostensensibilität | Muse Glimmer 30B (möglich) | Ein Community-Bericht deutet auf weniger Token pro Aufgabe hin; kein direkter Kosten-pro-Erfolg-Vergleich |
| Repository-weites Coding mit großem Kontext | Muse Glimmer 30B (bei VRAM-Limit) | Qwen benötigt für großen Kontext auf 24 GB Q8-KV-Komprimierung oder mehrere GPUs |
| Maximale Coding-Genauigkeit, Hardware spielt keine Rolle | Qwen3.6-27B | Stärkere veröffentlichte Benchmarks und offizielle Werte |
FAQ
Gibt es für Muse Glimmer einen offiziellen SWE-bench-Wert?
Nein. In den für diesen Vergleich ausgewerteten Quellen wurde bis August 2026 kein offizieller SWE-bench-, LiveCodeBench- oder TerminalBench-Wert für Muse Glimmer 30B gefunden. Der TerminalBench-2.1-Wert von 51.7 stammt aus Community-Tests in Reddit-Threads, nicht aus einer offiziellen Meta-Evaluierung.
Laufen beide Modelle auf einer einzelnen RTX 3090?
Ja. Muse Glimmer 30B bei Q4_K_XL passt mit 262K Kontext und vollständigem F16-KV-Cache in ~22-23 GB. Qwen3.6-27B bei Q4_K_XL passt ebenfalls, ist auf derselben GPU aber auf 70K F16-Kontext oder 125K mit Q8-KV-Cache-Komprimierung begrenzt.
Ist Muse Glimmer bei Coding-Aufgaben zensiert?
Ein Nutzer berichtete, dass Muse Glimmer nicht beim Debuggen von Python-Code zur Maussteuerung helfen wollte und dies als mögliches Sicherheitsrisiko einordnete. Das ist ein einzelner Erfahrungsbericht mit nicht näher beschriebenem System-Prompt und unbekannter Konfiguration. Daraus lässt sich nicht ableiten, ob das Verhalten vom Modell selbst oder vom Inferenz-Setup verursacht wird.
Welches Modell eignet sich besser für agentische Coding-Workflows?
Qwen3.6-27B ist für Terminal-Agent-Aufgaben mit langem Horizont anhand der TerminalBench-Werte und Community-Berichte verlässlicher. Muse Glimmer 30B ist wegen seiner VRAM-Effizienz auf eingeschränkter Hardware besser praktikabel und verbraucht möglicherweise weniger Token pro Aufgabe. Das könnte Kosten und Latenz in Agent-Schleifen mit hohem Durchsatz senken, wurde bislang aber nicht kontrolliert quantifiziert.
Welchen max_tokens-Wert sollte ich für Muse Glimmer beim Coding setzen?
Wähle ein großzügiges Ausgabe-Budget. Ein Tester stellte fest, dass enge max_tokens-Limits dazu führten, dass Glimmer sein Budget für Reasoning aufbrauchte, bevor sichtbare Ausgabe entstand. Die daraus resultierenden leeren oder abgeschnittenen Antworten sahen wie Fehlschläge aus. Nach dem Anheben des Limits stieg die Zahl bestandener Aufgaben in seinem Test-Harness von 6/13 auf 11/13. Die Model Card von Qwen3.6-27B empfiehlt 32,768 Token für allgemeine Anfragen und 81,920 für anspruchsvolle Benchmark-Aufgaben; bis Meta eigene Empfehlungen veröffentlicht, ist dasselbe Ausgabe-Budget ein sinnvoller Ausgangspunkt für Glimmer.