 AIREITER
Kann ein dichtes multimodales Modell mit 30B Parametern Qwen 3.6 27B auf Consumer-Hardware ablösen? Seit Meta Muse Glimmer am 10. August 2026 veröffentlicht hat, stellt die Local-AI-Community genau diese Frage auf die Probe. Die kurze Antwort: Muse Glimmer läuft mit vollständigem 262K-Kontext auf einer einzelnen RTX 3090 und erreicht mit DFlash 236 tok/s auf einer RTX 5090. In TerminalBench 2.1 liegt es allerdings 9 Punkte hinter Qwen 3.6 27B und verweigert mitunter Aufgaben zur Automatisierung auf Betriebssystemebene.
Was steckt hinter Muse Glimmer 30B?
Muse Glimmer ist ein dichtes multimodales Modell mit 30B Parametern, das Meta Superintelligence Labs unter der Apache-2.0-Lizenz veröffentlicht hat. Entwickelt wurde es für lokale, dauerhaft laufende Agenten-Workflows – nicht für Spitzenplätze in Coding-Ranglisten. Ein Text-Decoder mit 27,9B Parametern, ein ViT-Bildencoder mit 1,9B Parametern und ein GELU-basierter multimodaler Projektor ermöglichen dem Modell, Text und Bilder zu verstehen. Die folgenden Architekturdetails stammen aus dem SGLang-Blog zu Day-0-Support.
Die Architektur in Kürze
| Spezifikation | Details |
|---|---|
| Parameter insgesamt | 30B |
| Text-Decoder | 27,9B dicht |
| Bildencoder | 1,9B ViT |
| Transformer-Layer | 52 |
| Attention | Grouped Query (32 Query Heads, 2 KV Heads – 16:1 GQA) |
| Feed-forward | SwiGLU |
| Kontextfenster | 128K+ (bis 262K getestet) |
| Lizenz | Apache 2.0 |
Die Architektur setzt auf hybride Attention: Auf jeweils drei Sliding-Window-Attention-Layer mit 2.048 Token folgt ein Full-Sequence-Attention-Layer. Für die lokalen Fenster nutzt das Design RoPE, für die Full-Attention-Layer NoPE – das erlaubt eine Erweiterung des Kontexts über das Trainingslimit hinaus. Das 16:1-Verhältnis bei Grouped Query Attention hält den KV-Cache klein. Eine Messung aus der Community kommt für 131K Token in F16 auf rund 1,8 GiB. Deshalb kann das Modell den kompletten Kontext auf einer GPU mit 24 GB halten, während Qwen 3.6 27B in derselben F16-Konfiguration bei 70K Token ankommt.
Läuft Muse Glimmer auf deiner Hardware?
Entscheidend ist vor allem die gewählte Quantisierung. SGLang stellt offizielle Checkpoints in BF16, NVFP4+MXFP8, GGUF Q4_K_M, GGUF Q4K-Dynamic und MLX 4-Bit bereit. Für extrem knappe VRAM-Konfigurationen haben Community-Tester das Modell außerdem auf 2-Bit-GGUF gebracht.
VRAM-Bedarf je Konfiguration
| Konfiguration | Ungefährer VRAM-Bedarf | Zielhardware |
|---|---|---|
| BF16 | ~60 GB | Einzelne H100 |
| NVFP4 + MXFP8 | ~19,5 GB | RTX 5090 / DGX Spark |
| NVFP4 + BF16 DFlash | 18 GB + 5 GB Speculator | RTX 5090 |
| Q4_K_XL + DFlash + mmproj + 262K Kontext | ~22–23 GB | RTX 3090 (24 GB) |
| 2-Bit-GGUF | ~14 GB | RTX 4060 Ti / Einsteigerklasse |
| MLX Q4 (Apple Silicon) | Unified Memory | Mac mini / MacBook Pro |
Ein Reddit-Nutzer zeigte, dass Muse Glimmer als Q4_K_XL mit spekulativem Decoding per DFlash, der multimodalen Projektionsdatei und F16-KV-Cache auf einer einzelnen RTX 3090 problemlos in 22–23 GB passt – bei aktivem vollständigem Kontext von 262.144 Token. Beim ersten Versuch fand das Modell zwei Nadeln in einem Heuhaufen mit rund 150K Token.
Zum Vergleich: Qwen 3.6 27B erreicht auf derselben RTX 3090 mit F16-KV-Cache nur 70K Token, mit Q8-KV-Cache 125K. Gemma 4 31B kommt auf 52K in F16 beziehungsweise 81K in Q8. Ausschlaggebend dafür, dass Muse Glimmer auf derselben Hardware mehr Kontext halten kann, ist vor allem die Effizienz seines KV-Caches durch das 16:1-GQA-Verhältnis.
Installationswege: Unter NVIDIA nutzt du SGLang oder llama.cpp mit dem NVFP4- oder GGUF-Checkpoint und aktivierst --speculative-algorithm DFLASH. Auf Apple Silicon kommt das MLX-Backend zum Einsatz; DFlash ist dort nicht verfügbar. Ein Nutzer mit einem M3 Max und 96 GB Unified Memory berichtete von 17 Token/s und stellte fest, dass Muse Glimmer auf seinem System sowohl Qwen als auch Gemma übertraf.
Wie schnell ist Muse Glimmer?
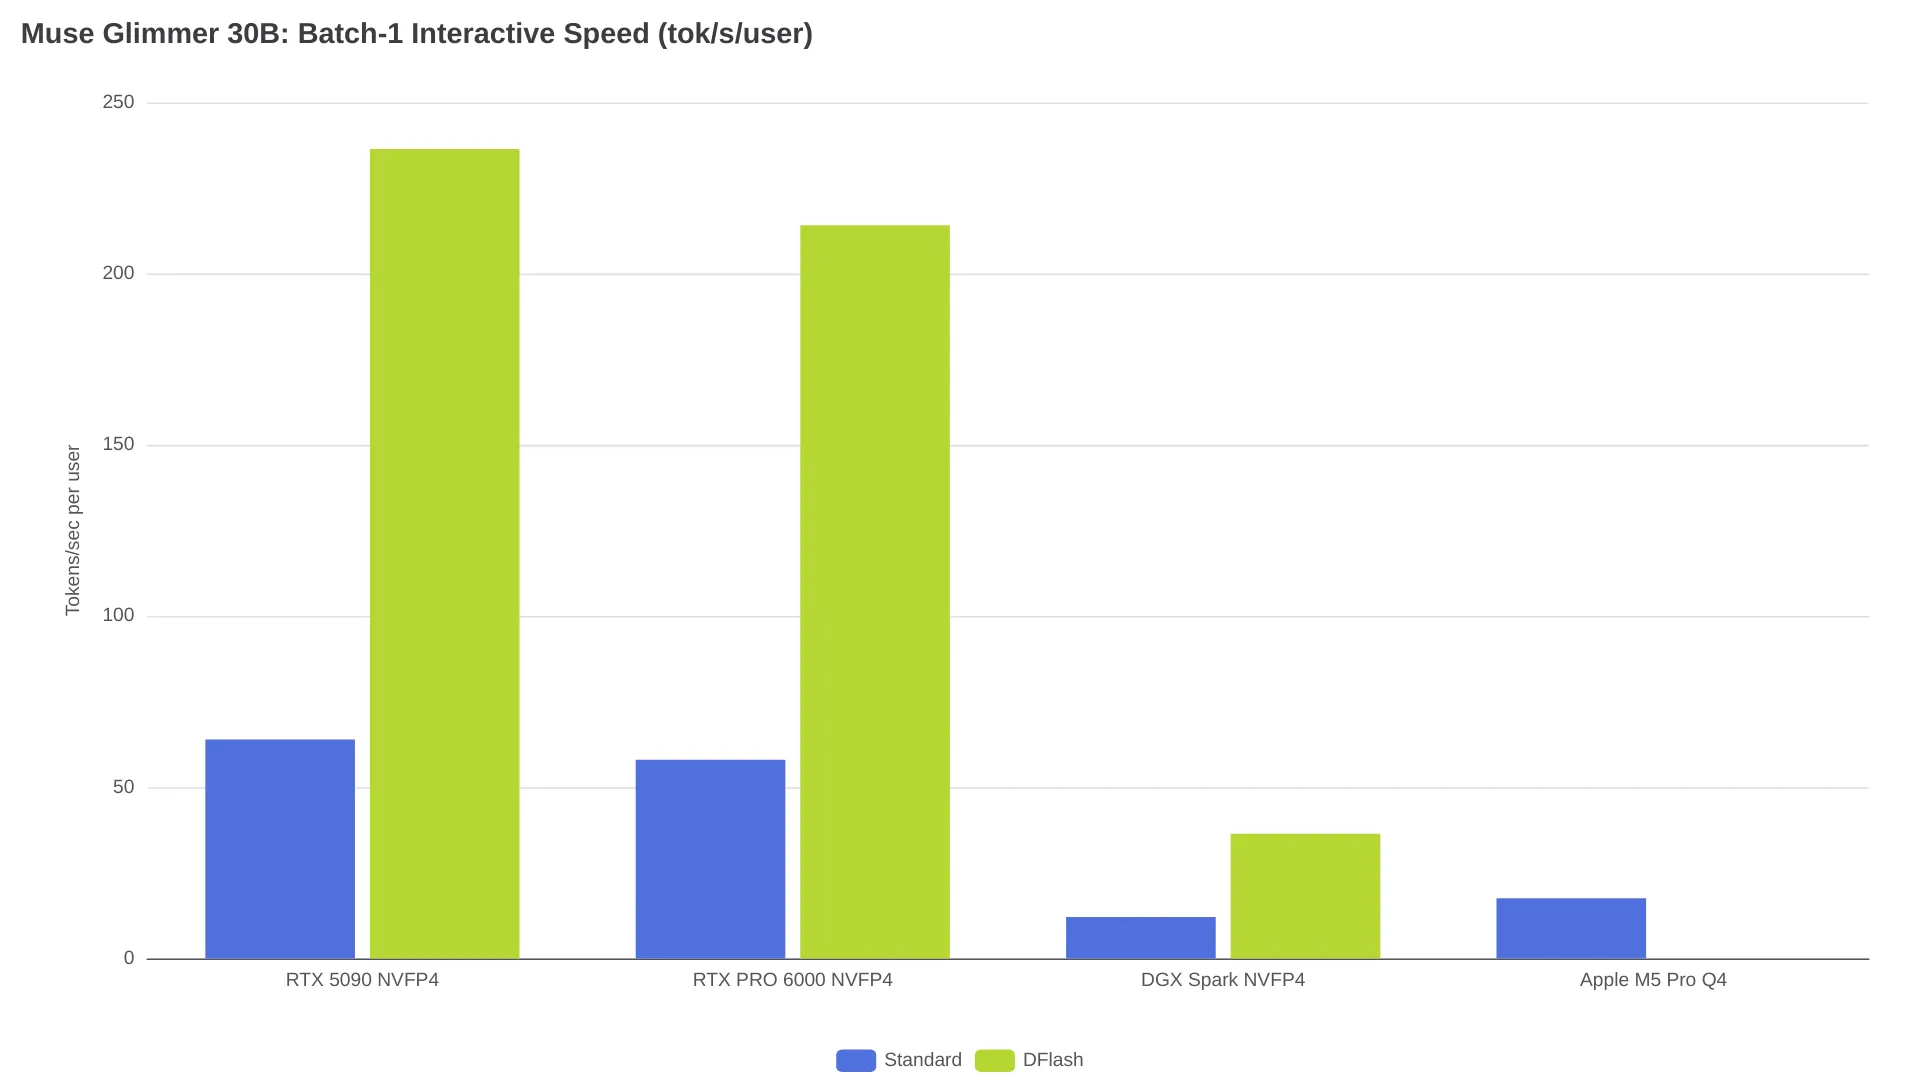
SGLang hat eine Benchmark-Tabelle für sieben Hardware-Konfigurationen veröffentlicht und dabei Batch-Größen von 1 bis 8 getestet. Spekulatives Decoding mit DFlash, aktiviert über --speculative-algorithm DFLASH, beschleunigt den interaktiven Durchsatz bei Batch 1 auf NVIDIA-Plattformen um das 1,9- bis 4,3-Fache.
Die wichtigsten SGLang-Benchmarkwerte
| Plattform | Präzision | Decoding | Batch-1 tok/s/Nutzer | Batch-8 tok/s |
|---|---|---|---|---|
| NVIDIA B300 | BF16 | DFlash | 308.51 | 261 |
| RTX 5090 | NVFP4 | DFlash | 236.4 | 1,452 |
| RTX 5090 | Q4_K_M | DFlash | 140.7 | 332 |
| RTX PRO 6000 | NVFP4 | DFlash | 214.11 | 403 |
| DGX Spark | NVFP4 | DFlash | 36.4 | 301 |
| Apple M5 Pro | Q4 | Standard | 17.6 | 56.9 |
Die 1.452 Output-Token/s bei Batch 8 auf einer RTX 5090 sind ein aggregierter Durchsatz. Für lokale Inferenz mit einem einzelnen Nutzer ist der Wert von 236 tok/s mit DFlash und NVFP4 maßgeblich. Ohne DFlash fällt dieselbe Konfiguration auf 63.9 tok/s. Das deckt sich mit Community-Berichten: Ein Nutzer mit RTX 5090 meldete mit Unsloths Q5_K_M-Quantisierung 220–253 Token/s.
Die Leistung von DFlash hängt von der Akzeptanzrate der Drafts ab. Nutzer mit Vulkan/RX 7900 XTX und SYCL/B70 berichteten beide von niedrigen Draft-Akzeptanzraten und einem geringeren Gesamtdurchsatz.
Muse Glimmer oder Qwen 3.6 27B: Welches Modell passt besser?
Ergebnisse in TerminalBench 2.1
| Modell | TerminalBench 2.1 | Kontext auf RTX 3090 (F16 KV) |
|---|---|---|
| Qwen 3.6 27B | 60.7 | ~70K Token |
| Muse Glimmer 30B | 51.7 | ~262K Token |
| Gemma 4 31B | 43.4 | ~52K Token |
TerminalBench-2.1-Werte aus einer Community-Diskussion. Kontextwerte aus Tests auf einer RTX 3090.
Qwen 3.6 27B liegt in TerminalBench 2.1 mit 9 Punkten vorn. Viele in der Community halten diesen Benchmark für entscheidend, um zu beurteilen, ob ein Modell über längere Aufgaben hinweg zuverlässige Terminal-Befehle ausführen kann. Auch in direkten Coding-Tests zeigt sich derselbe Abstand: In der privaten Evaluierung eines Nutzers erzielte Qwen 12/13 gegenüber Glimmer mit 11/13. Qwen erstellte zudem beim ersten Anlauf korrekt eine 953 Zeilen lange Tokyo-Tourismus-Seite, während Glimmer unter 200 Zeilen blieb (vollständiger Thread).
„Nicht einmal annähernd auf dem Niveau von Qwen 3.6 27B“ – Reddit-Nutzer BarberIcy366, nachdem Glimmer für ein 8-Ball-Pool-Spiel nur 220 Zeilen HTML erzeugt und dabei 21.000 Token verbraucht hatte (r/LocalLLaMA). Im selben Thread wird berichtet, dass Qwen 3.6 27B eine Tetris-Implementierung mit aktiviertem MTP 1,7-mal schneller abschloss.
In einigen Bereichen bringt Glimmer allerdings echte Vorteile mit:
- Kontextkapazität: 262K Token auf einer einzelnen RTX 3090 gegenüber 70K bei Qwen mit derselben F16-KV-Einstellung – ein 3,7-facher Vorteil für die Arbeit mit großen Codebases.
- Effizienter KV-Cache: Das 16:1-GQA-Verhältnis macht Glimmers KV-Cache deutlich kleiner und lässt mehr VRAM für Kontext übrig.
- Bildverständnis: Glimmer ist ab Werk multimodal, während Qwen 3.6 27B in der Basisversion nur Text verarbeitet.
- MCP und Tool-Q&A: Ein Nutzer berichtete, dass Glimmer beim Terminal-Coding zwar hinter Qwen liegt, aber für MCP-gestützte Codebase-Suche und Frage-Antwort-Workflows vielversprechend sei.
- Schreibqualität: Mehrere Nutzer bevorzugten Glimmers natürlichsprachliche Ausgaben gegenüber denen von Qwen.
Ein Kommentator fasste den Tausch so zusammen: Glimmer sei „Qwen 3.6 27B plus 5 % Schreibstil und minus 5 % agentische Fähigkeiten“.
Fazit
Für One-Shot-Coding oder autonome Terminal-Agenten bleibt Qwen 3.6 27B die stärkere Wahl: Es erzielte in TerminalBench 2.1 9 Punkte mehr und zeigt nicht die Safety-Verweigerungen, die Glimmer bei Automatisierung auf Betriebssystemebene ausbremsen. Wenn du auf einer einzelnen Consumer-GPU Informationen aus langem Kontext abrufen, multimodale Eingaben verarbeiten oder MCP-gestützte Workflows nutzen willst, ist Muse Glimmer einen Test wert. Für zuverlässige Terminal-Automatisierung solltest du auf Community-Fine-Tunes warten.
Bekannte Probleme und Fallstricke
Die max_tokens-Falle
Muse Glimmer verwendet einen beträchtlichen Teil seines Token-Budgets für internes Reasoning, bevor es eine Ausgabe erzeugt. Ist max_tokens zu niedrig gesetzt, kann das Modell sein Budget mitten im Gedankengang aufbrauchen und eine leere Antwort zurückgeben. Ein Nutzer kam in seiner Evaluierung zunächst auf 6/13 für Glimmer; nachdem er das Budget für Output-Token erhöht hatte, stieg der Wert auf 11/13 (Quellthread). Setze max_tokens hoch genug an, um den Reasoning-Overhead abzudecken, sonst können Antworten mitten im Gedankengang abbrechen.
Safety-Verweigerungen bei OS-Automatisierung
Mehrere Nutzer berichten, dass Muse Glimmer Aufgaben mit Maussteuerung, Tastaturautomatisierung oder anderen Tool-Calls auf Betriebssystemebene verweigert. Selbst bei üblichen Python-Bibliotheken bewertet das Modell solche Anfragen als potenzielles Sicherheitsrisiko.
„Das programmgesteuerte Bewegen einer Maus kann für Automatisierung, Clickjacking oder das Umgehen von Sicherheitsabfragen missbraucht werden.“ – Ablehnung von Muse Glimmer, berichtet von Reddit-Nutzer Cold_Tree190 (r/LocalLLaMA)
Ein neuer Chat mit mehr Kontext zum vorgesehenen Einsatz kann die Verweigerung manchmal auflösen. Hat das Modell eine Anfrage innerhalb einer Sitzung jedoch bereits abgelehnt, bleibt es meist bei dieser Position.
Unzuverlässiges Tool Calling
Die Community-Berichte zur Zuverlässigkeit beim Tool Calling reichen von „nicht ein einziges Mal fehlgeschlagen“ in einer C-Codebase bis zu Endlosschleifen und leeren API-Antworten in anderen Setups. Bei Unsloth-Q4- und -Q5-Quantisierungen wurden in manchen Konfigurationen starke Schleifen beim Tool Calling beobachtet, während offizielle GGUFs für 24 GB und 32 GB VRAM zuverlässiger funktionieren könnten (Quellthread).
Regionale Download-Beschränkungen
Auf der offiziellen Hugging-Face-Seite sind Downloads Berichten zufolge in Hongkong, Macau und China deaktiviert. Als Alternative bleiben GGUF-Distributionen von Drittanbietern wie Unsloth verfügbar.
Weiterführend: Muse Spark 1.2 API pricing guide | Best free OpenRouter models for programming 2026