 AIREITER
Late Interaction ist jetzt offiziell Teil von Sentence Transformers: Am 18. August 2026 erschien Version 6.0 mit MultiVectorEncoder – gleichrangig neben Dense-, Sparse- und Reranker-Modellen. Die eigenen Launch-Benchmarks von Hugging Face dämpfen allerdings den Hype: Gegen ein baugleiches Dense-Pendant gewann Late Interaction 9 von 13 NanoBEIR-Datensätzen, im Mittel aber nur um etwa einen NDCG@10-Punkt. Dem steht ein erheblicher Speicherpreis gegenüber: Im durchgerechneten Beispiel ist der Rohindex 42-mal so groß wie der 384-dimensionale MiniLM-Index und selbst gegenüber einem gleich großen Dense-Modell noch 21-mal größer. Ob sich das lohnt, entscheidet fast vollständig die Struktur der Suchanfragen.
So funktionieren Multi-Vector-Embeddings mit Late Interaction
Ein Multi-Vector-Modell verdichtet ein Dokument nicht zu einem einzigen gepoolten Vektor. Stattdessen bleibt pro Token ein eigener Vektor erhalten. Bei den von Hugging Face unterstützten Modellen sind diese Token-Vektoren üblicherweise 128-dimensional; klassische Dense-Embeddings liegen typischerweise bei 384, 768 oder 1.024 Dimensionen. Beim Scoring sucht MaxSim für jedes Query-Token das ähnlichste Dokument-Token und addiert anschließend diese Maximalwerte: MaxSim(Q,D) = Σᵢ maxⱼ(qᵢ · dⱼ). Da die Modelle L2-normalisiert sind, liegt jede Komponente in [-1, 1]; der Gesamtscore wächst mit der Länge der Anfrage.
Damit liegt Late Interaction architektonisch zwischen den beiden Verfahren, aus denen es Elemente übernimmt:
| Architektur | Dokumentseite | Scoring | Kostenprofil |
|---|---|---|---|
| Dense Bi-Encoder | Ein vorab berechneter, gepoolter Vektor | Ein einzelnes Skalarprodukt | Schnellstes Retrieval; beim Pooling gehen Token-Details verloren |
| Late Interaction | Ein vorab berechneter Vektor pro Token | MaxSim über Token-Paare | Ausdrucksstarkes Matching; der Index wächst mit der Dokumentlänge |
| Cross-Encoder | Nichts wird vorab berechnet | Vollständiger Forward Pass für jedes Query-Dokument-Paar | Laut Hugging Faces Launch-Beitrag die höchste Genauigkeit pro Paar; als erste Stufe zu teuer |
Das ursprüngliche ColBERT-Paper prägte dafür den Begriff „contextualized late interaction“.
Der Vorteil wird auf Token-Ebene sichtbar. Im Beispiel von Hugging Face mit lightonai/mLateOn trifft das Query-Token „live“ mit 0,94 Ähnlichkeit auf das Dokument-Token „inhabit“ – eine semantische Zuordnung ohne jede lexikalische Überschneidung.
Für diese Suchaufgaben spielt Multi-Vector seine Stärken aus
Kurze Passage-Benchmarks zeigen nur einen Teil der Fälle, in denen sich diese Modelle wirklich lohnen. Über die fünf für diesen Artikel verglichenen Quellen hinweg – den Launch-Beitrag von Hugging Face, TopK, Qdrants Engineering-Analyse, den Produktionsleitfaden von Data AI Hub und Suhas Bhairavs Vergleich für die Produktionssuche – treten dieselben Einsatzfälle hervor:
- Exakte Kennungen in einer semantischen Suche. Produktcodes, Funktionsnamen, Nachnamen, Fehlermeldungen oder Klauselnummern. Ein gepoolter Vektor verwischt solche Details, Token-Vektoren halten sie gezielt auffindbar.
- Anfragen mit mehreren Bedingungen. Bei „X mit Y und Z“ kann jedes Query-Token eigenständig ein passendes Dokument-Token finden. Keine Bedingung wird beim Pooling wegmittelt.
- Lange Dokumente, in denen die Antwort nur in einer kleinen Passage steckt. Auf dem mehrsprachigen Langdokument-Benchmark MLDR erreichte Multi-Vector-
mLateOn77,92 gegenüber 51,59 fürmDenseOn. Das ist ein Abstand, der um eine Größenordnung über den Mittelwerten kurzer Passagen liegt. - PDFs, Tabellen und gescannte Seiten. Modelle der ColPali-Familie indexieren Seitenbilder direkt und lassen sich mit Textanfragen durchsuchen – ohne OCR. Hugging Face bezeichnet visuelles Document Retrieval im Launch-Beitrag als Late Interactions State-of-the-Art-Gebiet. Die Analyse von TopK berichtet zudem, dass ein kompaktes Multi-Vector-Retrieval-Modell auf ViDoRe v3 ein Single-Vector-Modell mit der 80-fachen Größe bei Recall um +34% übertraf; bei Industriedokumenten stieg der Recall von etwa 42% auf 76%.
- Vokabular außerhalb der Trainingsdomäne. Laut Hugging Faces Launch-Beitrag gibt es Zugewinne bei Out-of-Domain-Daten, weil die gelernte Kompression eines Dense-Modells Details verwerfen kann, die Produktionsanfragen benötigen.
Die Zahlen von Hugging Face deuten an, warum visuelles Retrieval hier so gut passt: Eine gerenderte Seite erzeugt bei colqwen2.5-v0.2 rund 755 Token-Vektoren, eine durchschnittliche Textpassage etwa 125. Je reichhaltiger die Seite mit Diagrammen, Layout und Tabellen ist, desto mehr müsste ein einzelner gepoolter Vektor verwerfen.
Der Qualitätsgewinn ist da – aber kleiner als der Hype
Den saubersten Vergleich liefert das abgestimmte Paar von LightOn: LateOn und DenseOn nutzen beide denselben ModernBERT-Backbone mit 149M Parametern und dieselben Trainingsdaten. Nur der Kopf unterscheidet sich: 128-dimensionale Token-Vektoren gegen einen 768-dimensionalen Dokumentvektor.
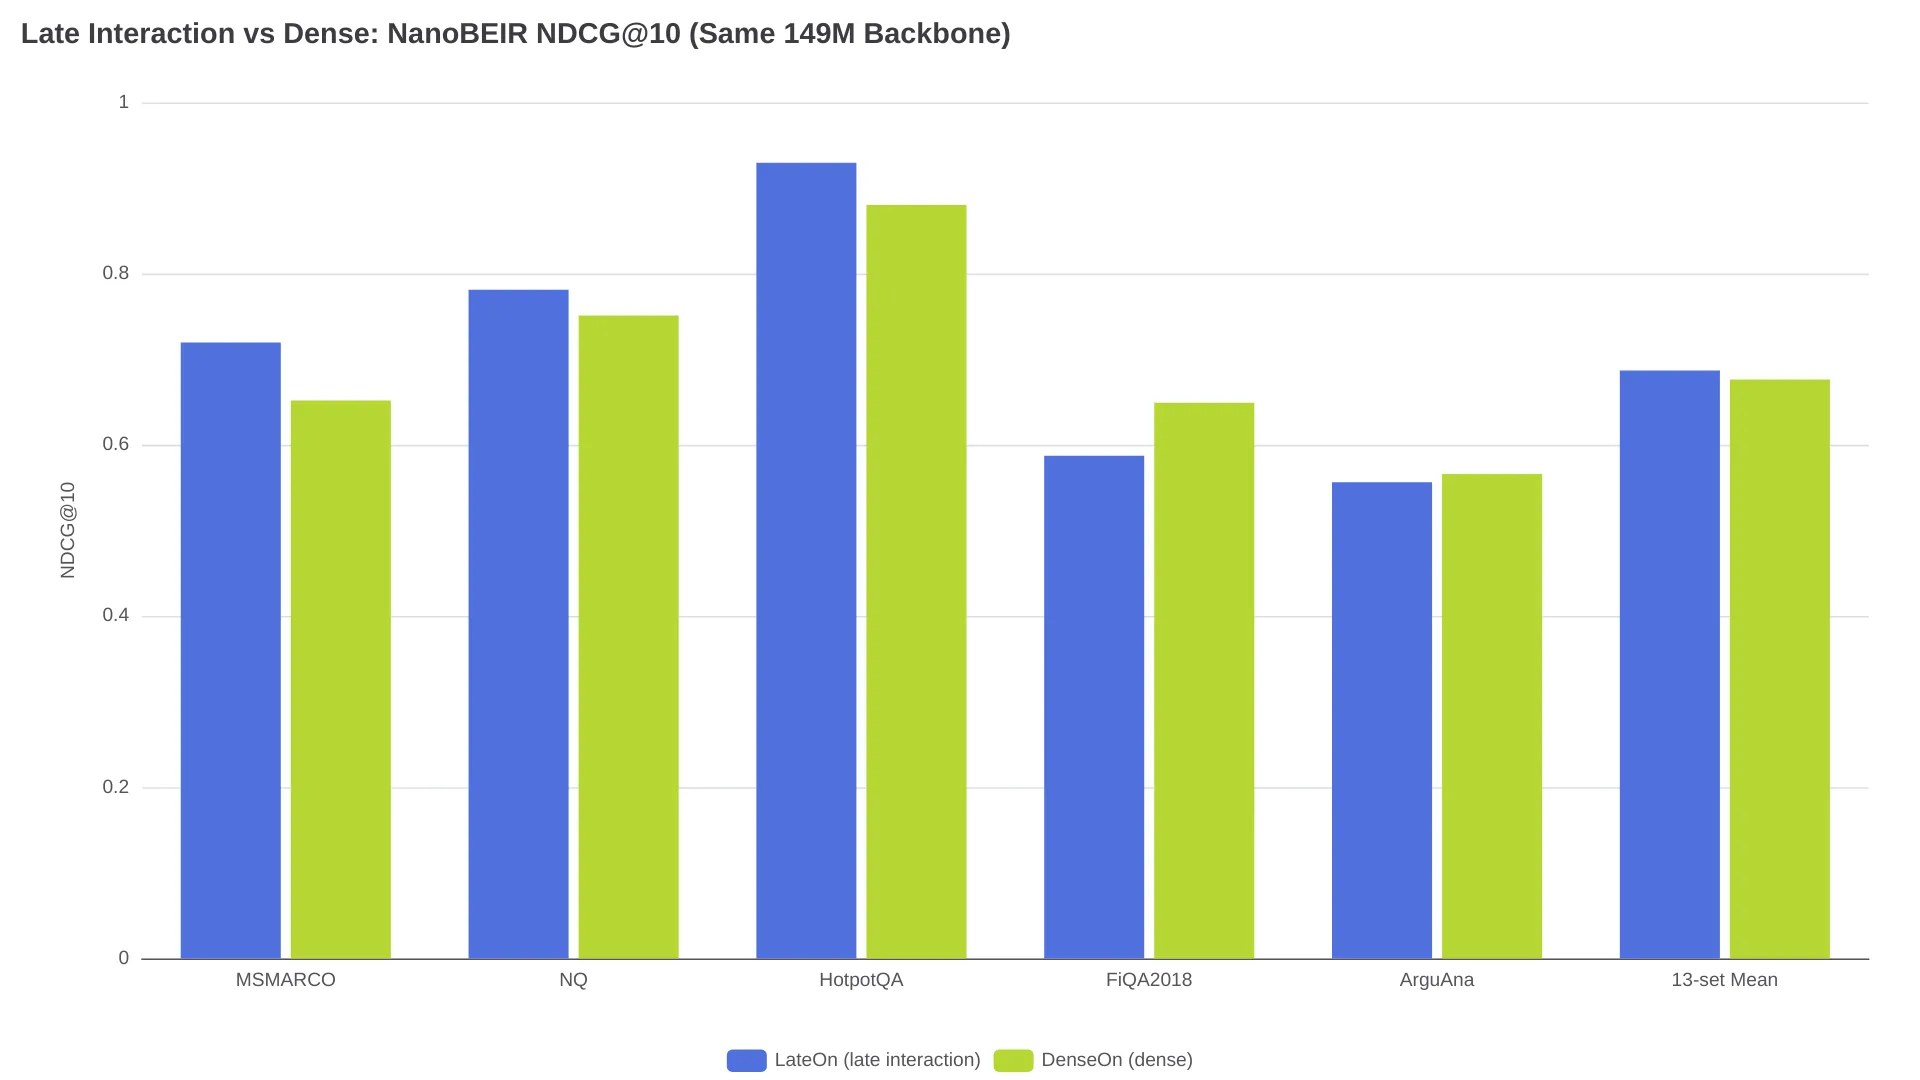
LateOn gewinnt 9 von 13 NanoBEIR-Datensätzen sowie den Mittelwert: 0,6868 gegenüber 0,6764 NDCG@10. Auf dem vollständigen BEIR mit 15 Datensätzen steht es 57,22 zu 56,20. Bei ArguAna, FiQA2018, SCIDOCS und SciFact liegt DenseOn dagegen klar vorn. Das ist die nüchterne Einordnung: ein relevanter durchschnittlicher Vorteil bei identischer Modellgröße, aber kein Sprung in eine andere Kategorie.
Nachdem Maintainer Tom Aarsen v6.0 angekündigt hatte, stellte Entwickler @saen_dev die Frage, die Praktiker immer wieder aufwarfen: „How does it benchmark against bi-encoders on domain-specific corpora?“ (Thread). Die ehrliche Antwort lautet: im Schnitt etwa ein Punkt, mit großen Gewinnen vor allem bei langen Dokumenten. Auch Hugging Face selbst empfiehlt im Launch-Beitrag, auf dem eigenen Retrieval-Task zu evaluieren, weil die Unterschiede je Datensatz stark schwanken.
Der Speicherpreis: 42x ohne Kompression
Hugging Face rechnet einen Index für 4.874 Natural-Questions-Passagen vor. lightonai/LateOn erzeugt daraus 608.414 Token-Vektoren, durchschnittlich 124,8 Vektoren pro Passage.
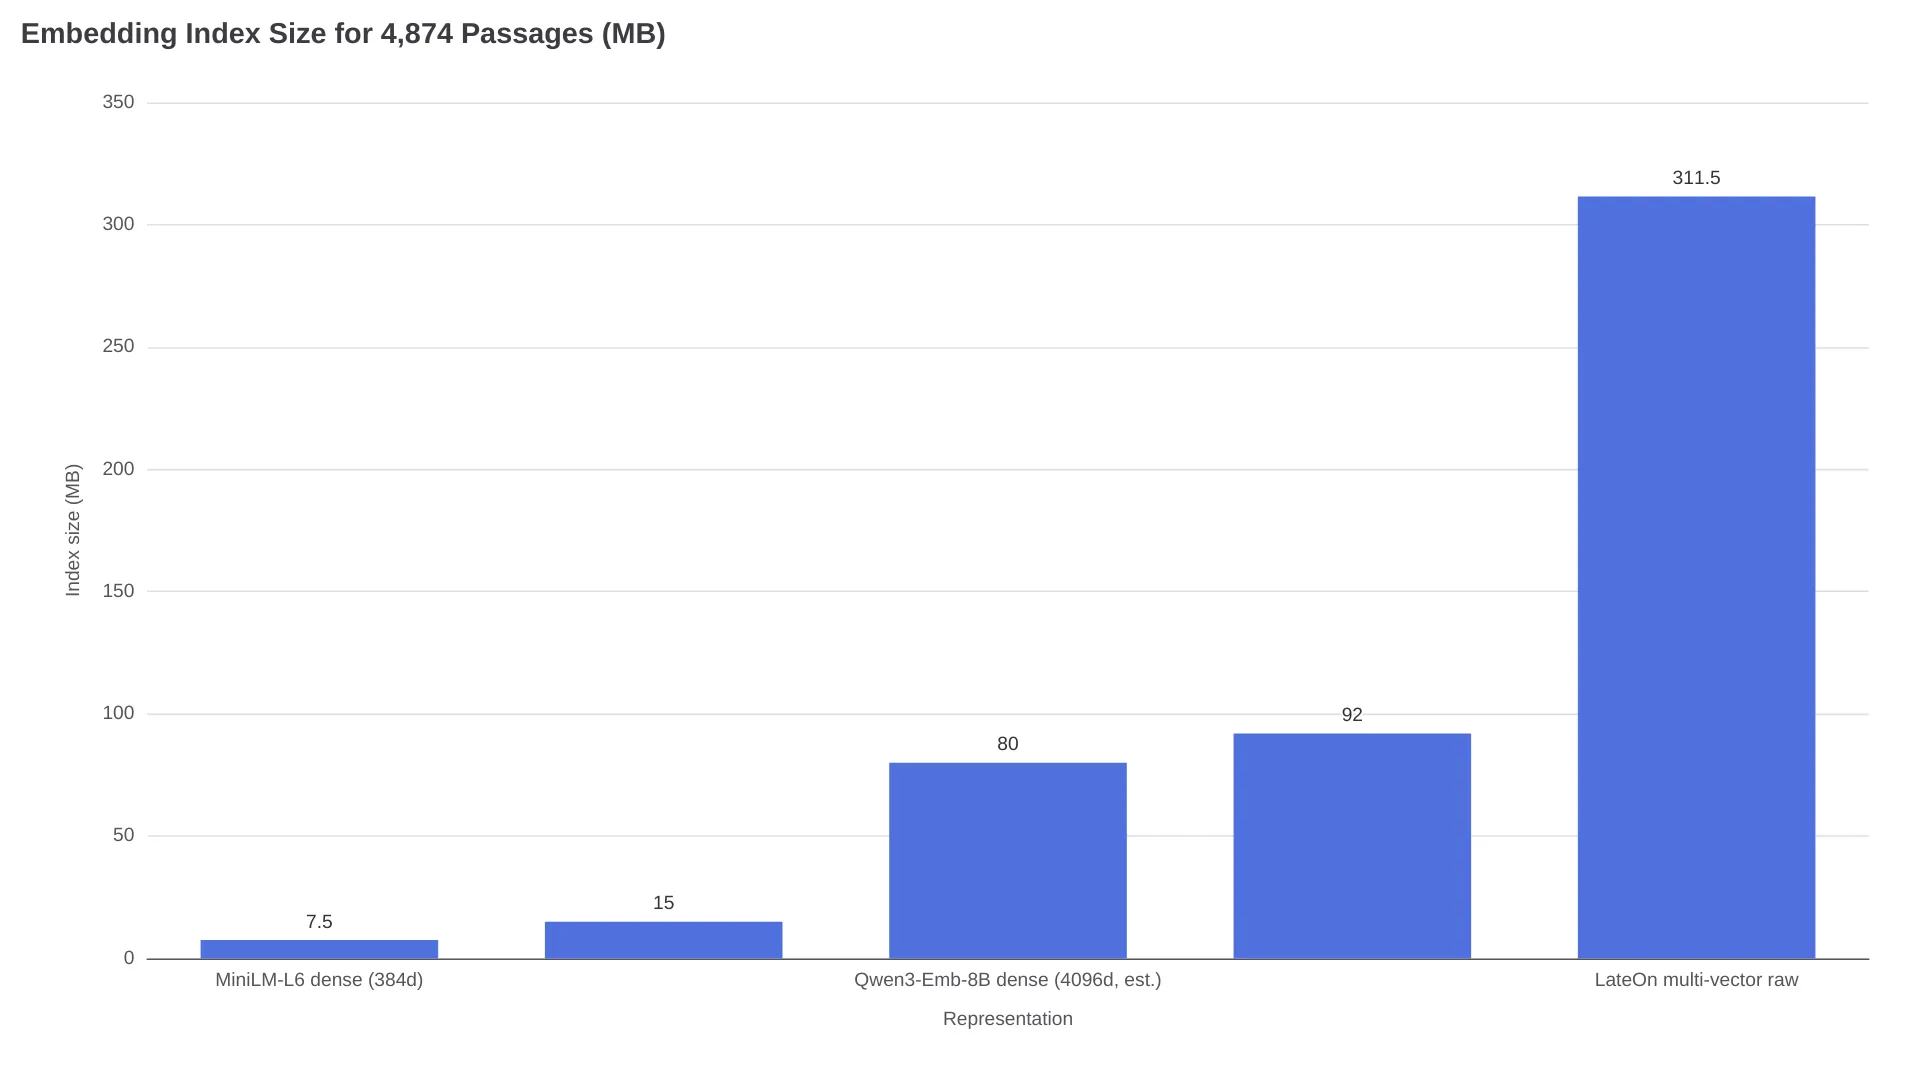
Der rohe Multi-Vector-Index in float32 belegt 311,5 MB. Dieselben Passagen benötigen mit dem Dense-Modell all-MiniLM-L6-v2 nur 7,5 MB – ein Faktor von 42 beziehungsweise 62 KiB pro Passage. Gegenüber gte-modernbert-base, einem Dense-Modell derselben Klasse mit 768 Dimensionen, beträgt der Faktor 21 (15 MB). TopK nennt abhängig von Dokumentlänge und Präzision eine Spanne von 10–100x und schätzt den Scoring-Aufwand pro Anfrage auf Tausende Male höher als bei einem Single-Vector-Vergleich.
Am Tag des Releases formulierte ein Entwickler die Produktionssorge unmissverständlich:
Token pooling is the part that decides if this ships. Late interaction usually dies on index size and memory, not on accuracy. - @JudeJobs on X
Zum Vergleich: Ein Dense-Index mit Qwen3-Embedding-8B und 4.096 Dimensionen belegt für denselben Korpus rund 80 MB – und liegt damit nahe am unten genannten komprimierten Late-Interaction-Index mit 92 MB.
Drei Hebel gegen den riesigen Index
1. Token-Pooling. Sentence Transformers v6.0 bringt HierarchicalTokenPooling mit. Das Verfahren clustert Dokument-Token-Vektoren mit Ward-Linkage über Kosinusdistanz und ersetzt jeden Cluster durch seinen Mittelwert. Standardmäßig werden nur Dokumente gepoolt, weil Anfragen kurz und empfindlich gegenüber Verzerrungen sind. Für den Korpus mit 608.414 Vektoren gilt:
| Pooling-Faktor | Token-Vektoren | float32-Index | Berichtene Retrieval-Erhaltung |
|---|---|---|---|
| 1 (keines) | 608.414 | 311,5 MB | 100% |
| 2 | 305.438 | 156,4 MB | 100,6% |
| 3 | 204.407 | 104,7 MB | 99,0% |
| 4 | 153.936 | 78,8 MB | ~98%-Trend |
Das Pooling des vollständigen Korpus dauerte etwa 6 Sekunden. Die regularisierte Variante von LightOn erreicht laut Hugging-Face-Beitrag bei 5x Kompression noch 99,4% Qualität. Hugging Face weist jedoch darauf hin, dass das Training mit diesem Regularisierer zum Release von v6.0 noch nicht in die Bibliothek integriert war.
2. Komprimierte Indizes. Ein fast-plaid-Index auf Basis von Rust PLAID belegt für dieselben Vektoren 92 MB, wurde in 5 Sekunden gebaut und antwortete auf einer RTX 3090 + i7-13700K in 11 ms. Das Verfahren ist approximativ: In Hugging Faces Test verschoben sich Spitzenscores von 11,92 auf 11,88, das Ranking blieb aber erhalten. Weaviates MUVERA machte die Ingestion 3x schneller und Anfragen 1,8x schneller, verlor im Testkorpus allerdings ein korrektes Ergebnis aus den Top 50.
3. Quantisierung und Inferenz-Tuning. Qdrants Experimente mit uint8-Scalar-Quantisierung für Token-Embeddings reduzierten den Speicherbedarf um 4x, während sich SciFact NDCG@10 nur von 0,70724 auf 0,70297 veränderte – praktisch vernachlässigbar. Hugging Face berichtet für fp16 plus Flash Attention einen 2,44x höheren Encoding-Durchsatz als bei fp32 ohne gemessenen Qualitätsverlust; int8 auf der CPU kostet etwa 0,4% Genauigkeit.
Kombiniert man Pooling mit Faktor 2–3 und einen komprimierten Index, schrumpft der effektive Abstand zu Dense von 42x auf einen einstelligen Faktor. Dafür kommen zwei weitere Stellschrauben hinzu, die abgestimmt werden müssen.
Standard in der Praxis: erst Retrieval, dann Reranking
Erschöpfendes MaxSim-Scoring über alle 4.874 Dokumente brauchte auf einer einzelnen RTX 3090 98 ms, Ende-zu-Ende 122,7 ms. Für einige Tausend Dokumente ist das völlig in Ordnung, bei Millionen wird die lineare Skalierung zum Problem. Die drei hier verglichenen Deployment-Guides landen bei derselben Architektur: Eine günstige Dense- oder Sparse-Stufe holt Kandidaten, Late Interaction sortiert sie nach.
- Hugging Face zieht im Beispiel die Dense-Top-50 und ordnet sie dann mit MaxSim neu. Dokumente werden einmal als Batch encodiert und per Matrixmultiplikation bewertet – erheblich günstiger als ein Forward Pass des Cross-Encoders für jedes Paar.
- Qdrant unterstützt Multi-Vector nativ seit v1.10 und empfiehlt Late Interaction vor allem zum Reranking einiger hundert Kandidaten, nicht für vollständige Scans.
- Der Produktionsleitfaden von Data AI Hub empfiehlt hybrides Retrieval der Top 150, Late-Interaction-Reranking auf 20 und optional einen Cross-Encoder für die finalen 5 Ergebnisse, die ans LLM gehen.
Das reine Reranking hat eine harte Grenze: Dokumente, die die erste Stufe verfehlt, kann es nicht zurückholen. Zudem ist die gesamte Pipeline keineswegs abschließend geklärt:
there is hardly a universally good chunking, retrieval and re-ranking strategy. - u/gamerx88, r/MachineLearning
Welche Datenbanken Multi-Vector unterstützen
Hugging Face vergleicht im Launch-Beitrag die wichtigsten Engines auf demselben Korpus mit 4.874 Passagen. Die folgenden Werte stammen aus diesem Test, nicht aus Hersteller-Marketing:
| Engine | Native Multi-Vector-Unterstützung seit | Ingest / Query im Test | Einschränkungen |
|---|---|---|---|
| Qdrant | v1.10 | 26,3 s / 18 ms | Exaktes MAX_SIM; Server empfohlen |
| Weaviate | v1.29 | 41 s / 17 ms | MUVERA schneller, verlor aber ein korrektes Ergebnis; kein Embedded-Modus unter Windows |
| Vespa | „seit Jahren“ | ~80 s / 75 ms warm | MaxSim als Tensor-Ausdruck; die standardmäßige zweite Phase sortiert nur 100 Kandidaten neu und verfehlte 2 der korrekten Top 3 |
fast-plaid | - | 5 s / 11 ms | Kein Server; approximative Scores, Ranking blieb erhalten |
| LanceDB | v0.15.0 | nicht getestet | Natives MaxSim |
| Milvus | v2.6.4 | nicht getestet | Array-of-structs-Speicherung |
| VectorChord | - | nicht getestet | MaxSim-Operator für PostgreSQL |
| Elasticsearch / OpenSearch | - | - | Nur Rescoring; die ES-Funktion ist im Enterprise-Tarif eine Technical Preview |
Late-Interaction-Indexing von turbopuffer war in Hugging Faces Vergleichstabelle als private Beta aufgeführt.
Was Sentence Transformers v6.0 konkret verändert
Vor dem 18. August 2026 bedeuteten Modelle der ColBERT-Familie separate Frameworks: PyLate, das Stanford-ColBERT-Repository oder colpali-engine. Mit Version 6.0 wird MultiVectorEncoder zum vierten Modelltyp erster Klasse in der Bibliothek – inklusive Training, Inferenz und integrierter Interpretierbarkeit. Die Bibliothek lädt Checkpoints von Sentence Transformers, PyLate, Stanford ColBERT und ColPali. Auch ein nackter Transformer lässt sich laden, nutzt dann aber eine zufällige Projektion und muss trainiert werden. Voraussetzung sind transformers v5.x, torch 2.2+ und huggingface-hub v1.x.
Drei Fallstricke aus der Launch-Dokumentation:
- Queries und Dokumente sind asymmetrisch.
encode_query()undencode_document()verwenden unterschiedliche Prompts, Längenlimits und Scoring-Masken. Wer für beides das generischeencode()aufruft, verschlechtert die Ergebnisse besonders leicht unbemerkt. - Trunkierung erfolgt still. Eine Passage mit 662 Tokens erzeugte unter dem Dokumentlimit von 300 Tokens bei LateOn 273 Vektoren – der Rest wurde verworfen. Das Limit auf 512 zu erhöhen funktioniert, verschiebt das Modell jedoch aus seiner Trainingsverteilung und vergrößert den Index.
- Flash Attention funktioniert nicht immer. Modelle mit nicht-attendierender Query Expansion, darunter
colbert-ir/colbertv2.0undanswerai-colbert-small-v1, benötigen stattdessen"sdpa".
Nach den veröffentlichten Scores von Hugging Face decken die unterstützten Modelle zwei Größenordnungen ab:
| Klasse | Beispielmodell (Parameter) | Score (mittleres NDCG@10) |
|---|---|---|
| Text für Edge-Geräte | mxbai-edge-colbert-v0-17m (17M) | 0,6407 NanoBEIR |
| Kleines Textmodell | answerai-colbert-small-v1 (33M) | 0,6550 NanoBEIR |
| Text-Spitzenmodell | LateOn-Familie (149M) | 0,6868–0,6897 NanoBEIR |
| Visuelle Dokumente | colqwen2.5-v0.2 (3.8B) / webAI-ColVec1.1-8b (8.4B) | 0,5402 / 0,6580 NanoViDoRe |
Wann ein einzelner Dense-Vektor weiterhin die bessere Wahl ist
Der Fehler wäre, Multi-Vector für Aufgaben einzuführen, die davon nicht profitieren. Verzichten sollte man darauf bei breiten, thematischen Anfragen wie „articles about supply chains“, bei kurzen Texten wie Titeln, FAQ-Paaren oder Tweets sowie bei Clustering, Deduplizierung und Empfehlungen – also überall dort, wo die Ähnlichkeit des gesamten Objekts zählt. Gleiches gilt, wenn eine Dense-plus-Reranker-Pipeline die Recall-SLOs bereits erfüllt und Kosten die eigentliche Begrenzung sind. Der Leitfaden von Data AI Hub ergänzt: Englischzentrierte ColBERT-Checkpoints können bei mehrsprachigen Korpora schlechter abschneiden als ein mehrsprachiger Bi-Encoder plus Reranker; außerdem passen schreibintensive Echtzeit-Korpora schlecht zu Token-Indizes.
Häufige Fragen – mit konkreten Zahlen
Lässt sich ein normales Dense-Modell als Multi-Vector-Modell einsetzen?
Mitunter erstaunlich gut. Qdrant nahm die Output-Token-Embeddings von BAAI/bge-small-en, einem Dense-Modell mit 33M Parametern, und bewertete sie mit MaxSim: Auf SciFact ergab das 0,73696 NDCG@10. Das übertraf colbert-ir/colbertv2.0 mit 0,69579 und auch den eigenen gepoolten Vektor von bge-small mit 0,68213. Bei ArguAna drehte sich die Reihenfolge um, dort gewann gepooltes Dense. Das ist ein sinnvoller Kniff, um ohne neues Modell eine Reranking-Stufe zu ergänzen – aber keine Garantie.
Wie viel schneller ist ein komprimierter Multi-Vector-Index?
Auf dem Korpus mit 4.874 Passagen: erschöpfendes MaxSim 98 ms gegenüber fast-plaid mit 11 ms, bei 92 MB statt 311,5 MB.
Ersetzen Multi-Vector-Modelle Cross-Encoder-Reranker?
Ökonomisch gesehen ja: Dokumentrepräsentationen werden vorab berechnet und per Matrixmultiplikation bewertet, statt für jedes Query-Dokument-Paar einen Forward Pass auszuführen. Hugging Face ordnet den Cross-Encoder im Launch-Beitrag pro Paar dennoch weiterhin als genaueste Option ein. Anspruchsvolle Pipelines behalten ihn deshalb für die finalen Top 5–20.
Lohnt sich Late Interaction für RAG?
Als Reranking-Stufe über hybriden oder Dense-Kandidaten: Das ist das Muster, das alle drei oben genannten Deployment-Guides empfehlen. Als Retriever der ersten Stufe nur dann, wenn gemessener First-Stage-Recall das Problem ist und der Token-Vektor-Index ins Budget passt.
Entscheidungshilfe für typische Workloads
| Ihr Workload | Empfehlung |
|---|---|
| Anfragen mit vielen Kennungen oder Bedingungen, lange Dokumente, Rechts- und Techniktexte | Multi-Vector-Retrieval oder -Reranking – das ist das Gebiet des +26-Punkte-Vorsprungs auf MLDR |
| PDFs, gescannte Seiten, Tabellen und Diagramme als Seitenbilder | Multi-Vector aus der ColPali-Familie; keine OCR-Pipeline erforderlich |
| Breite thematische Suche, kurze Texte, Clustering/Deduplizierung/Empfehlungssysteme | Einzelne Dense-Vektoren; Pooling-Verluste spielen hier keine Rolle |
| Qualität fast ausreichend, Budget knapp | Dense als erste Stufe beibehalten, MaxSim-Reranking für die Top 50–150 ergänzen |
| Millionen Dokumente, Kosten entscheidend | Dense plus Cross-Encoder-Reranker oder komprimierte Late Interaction nach Messung einsetzen (Pooling-Faktor 2–3 + fast-plaid) |
Der offene Zielkonflikt, auf den @JudeJobs hinweist: Die Qualitätserhaltung durch Kompression wird auf Benchmarks gemessen, nicht auf unordentlichen Produktionskorpora. Starten Sie mit Pooling-Faktor 2 und lassen Sie den auf den eigenen Daten gemessenen Recall entscheiden, wie weit Sie auf der Kompressionskurve gehen.