 AIREITER
Bei einem Multi-Node-Job auf Modal wird die komplette Ressourcenbelegung abgerechnet – nicht etwa ein separates Cluster-Abo. Modal Clusters ist allgemein verfügbar, doch auf der Rechnung landen weiterhin die GPUs, CPUs, der Arbeitsspeicher, Storage und Netzwerkverkehr, die von jedem Container genutzt werden.
Modal-Clusters-Preise in einer Minute erklärt
Die offizielle Modal-Preisseite und die Ankündigung der allgemeinen Verfügbarkeit beschreiben die nutzungsbasierte Abrechnung sowie den Einstiegspunkt @modal.clustered, mit dem sich mehrere Container gemeinsam starten lassen. RDMA verändert optional den Kommunikationsweg, nicht aber die grundlegende Preisformel.
GPU-Anzahl × GPU-Sekunden × GPU-Tarif + CPU-Sekunden + GiB-Sekunden Arbeitsspeicher + Storage + gegebenenfalls ausgehender Traffic
Diese Formel ist entscheidend, weil ein Cluster die komplette Node-Belegung vervielfacht. Fordert ein Job vier Nodes mit jeweils acht H100-GPUs an, werden 32 H100s berechnet – nicht ein Koordinator plus „kostenlose“ Worker.
Was Modal Clusters zur Preisliste hinzufügt
Mit dem GA-Release vom 1. Oktober 2026 macht Modal die Ausführung über mehrere Nodes zu einer verwalteten Funktion. Über size wird die Anzahl der Container festgelegt, während rdma=True den schnellen Kommunikationspfad aktiviert, sofern dieser unterstützt wird (Modal-Ankündigung).
Die Dokumentation beschreibt ein sogenanntes Gang Scheduling: Modal versucht, die angeforderte Gruppe gemeinsam zu platzieren, statt einen unvollständigen Job zu starten, der ohnehin keinen Fortschritt machen kann. Zu den unterstützten Workloads gehören verteiltes Training, Fine-Tuning, modellparallele Inferenz sowie Prefill-/Decode-Architekturen mit synchronisierter GPU-Kommunikation.
Die Cluster-Dokumentation setzt außerdem praktische Grenzen: GPUs werden als komplette Nodes zugewiesen, CPU-only-Cluster werden nicht unterstützt, und ein ausgefallener oder präemptierter Container kann den gesamten Cluster-Aufruf fehlschlagen lassen. Zurückgegeben wird nur die Ausgabe von Rank 0. Bei langen Jobs sind Checkpoints außerhalb des Containers daher Pflicht.
Die GPU-Tarife hinter einer Modal-Clusters-Rechnung
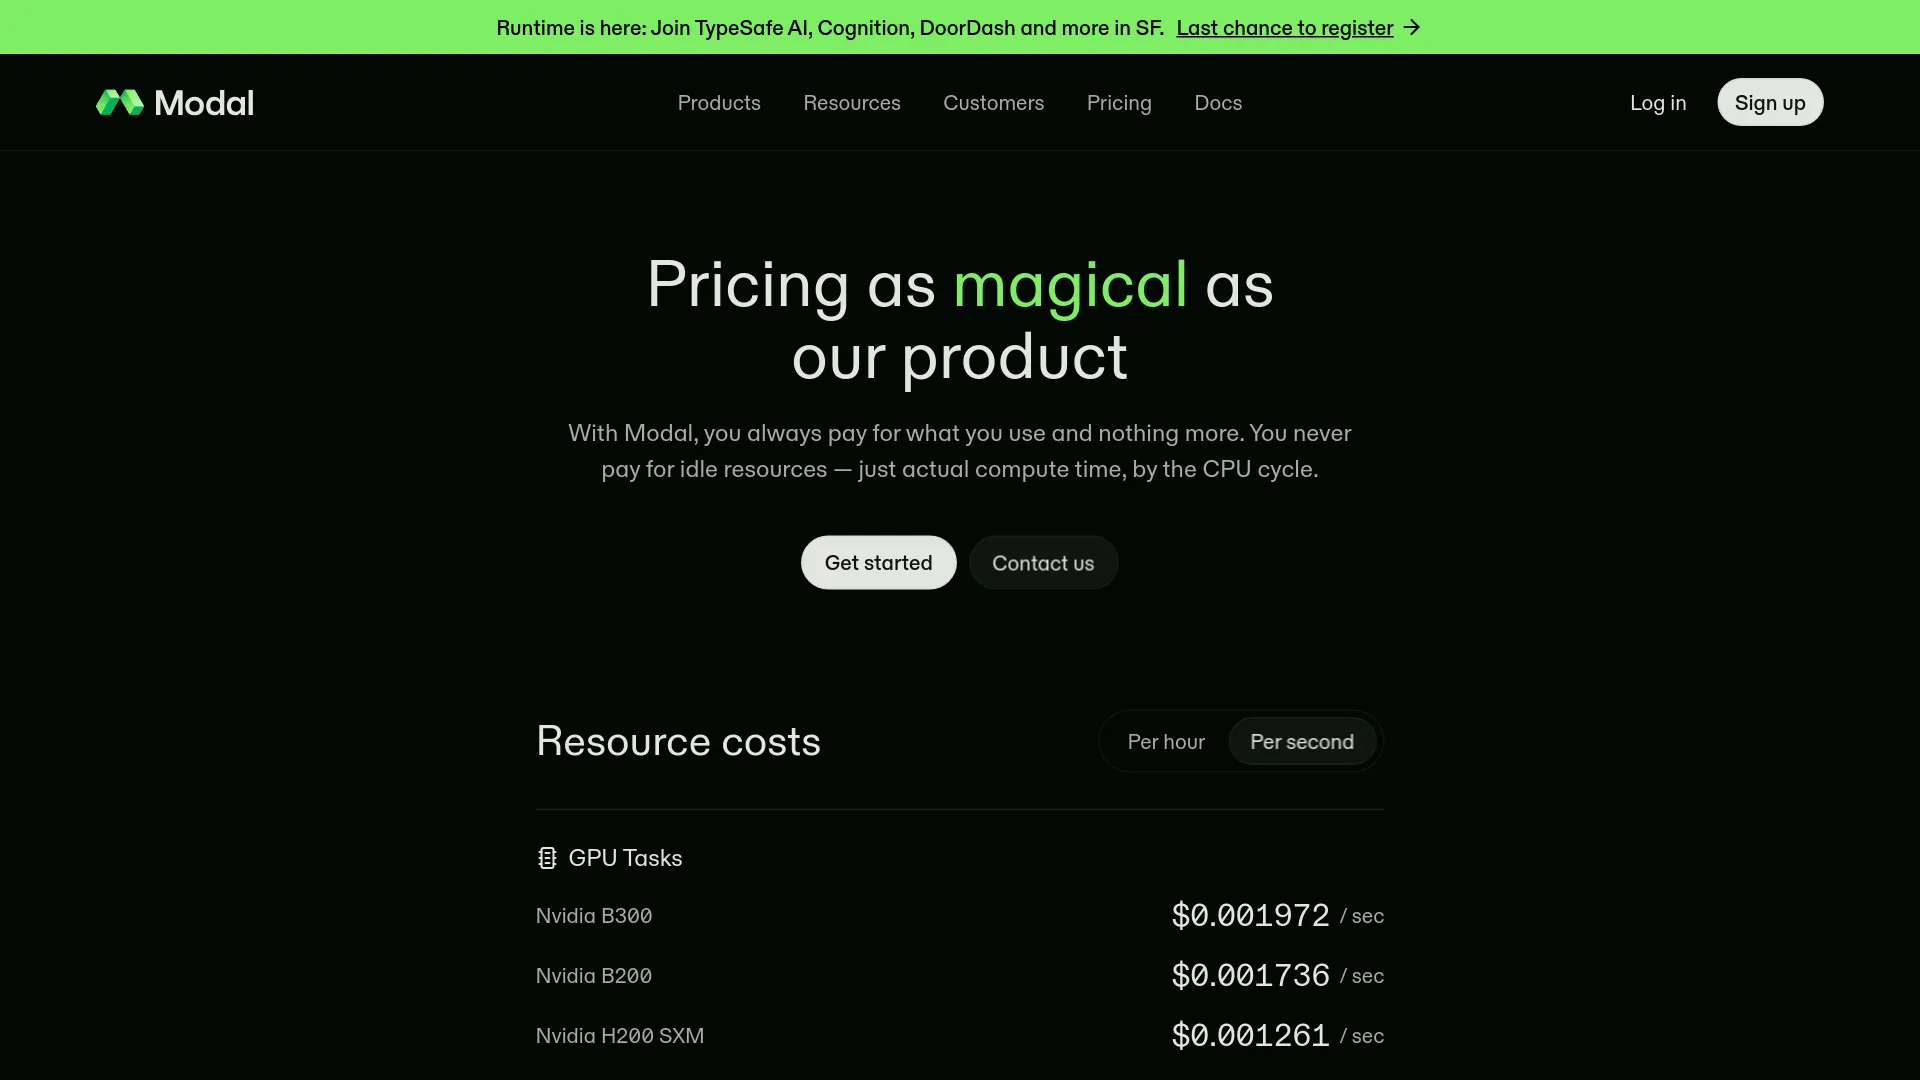
Die folgenden öffentlichen Tarife sind ein sinnvoller Ausgangspunkt für eine Schätzung. Die Stundenwerte wurden aus den Preisen pro Sekunde berechnet und enthalten weder CPU, Arbeitsspeicher, Storage noch mögliche regionale Multiplikatoren.
| GPU | Pro Sekunde | Ca. pro GPU-Stunde |
|---|---|---|
| B300 | $0.001972 | $7.10 |
| B200 | $0.001736 | $6.25 |
| H200 SXM | $0.001261 | $4.54 |
| H100 SXM5 | $0.001097 | $3.95 |
| A100 80 GB | $0.000694 | $2.50 |
| L4 | $0.000222 | $0.80 |
Modal berechnet CPUs außerdem mit $0.0000131 pro physischem Core-Sekunde und Arbeitsspeicher mit $0.00000222 pro GiB-Sekunde. Volumes kosten $0.09 pro GiB und Monat, wobei die ersten 1 TiB kostenlos sind. Für ausgehenden Netzwerkverkehr werden jenseits des enthaltenen Kontingents $0.04 pro GiB ausgewiesen. Vor dem Start eines großen Jobs sollten die aktuellen Werte auf der offiziellen Preisliste geprüft werden.
Beispielrechnung: vier Nodes mit jeweils acht H100s
Angenommen, ein verteiltes Training fordert size=4 und pro Node H100:8 an.
- Vier Nodes × acht GPUs = 32 H100-GPUs.
- 32 × $3.95 pro Stunde = rund $126.40 GPU-Kosten pro Stunde.
- $126.40 ist lediglich die GPU-Untergrenze; CPU, Arbeitsspeicher, Storage und ausgehender Traffic kommen noch hinzu.
Das ist die Zahl, die mit reservierter oder dedizierter Kapazität verglichen werden sollte. Der Vorteil des serverlosen Ansatzes: Nach dem Burst kann der Cluster wieder auf null skaliert werden. Ein vollständig belegter Cluster wird dadurch allerdings nicht automatisch günstig.
Plan-Limits können wichtiger sein als der GPU-Tarif
Eine allgemein verfügbare Funktion bedeutet nicht automatisch unbegrenzte Kapazität. Die von Modal veröffentlichten Workspace-Tarife enthalten Concurrency- und Plattformgrenzen, die einen großen Cluster blockieren können, bevor der Preis überhaupt zum Problem wird.
| Plan | Plattformgebühr | Enthaltenes Compute-Guthaben | Veröffentlichte GPU-Concurrency |
|---|---|---|---|
| Starter | $0/month | $30/month | 10 GPUs |
| Team | $250/month | $100/month | 50 GPUs |
| Enterprise | Custom | Custom | Custom / höhere Limits |
Ein Experiment mit 32 H100s belegt bereits 32 GPUs. Der Starter-Tarif kann das obige Beispiel unter einem Concurrency-Limit von 10 GPUs daher nicht unterstützen. Team reicht auf dem Papier für diese GPU-Anzahl aus, doch tatsächliche Verfügbarkeit, Region und angeforderte Hardware beeinflussen die Planung weiterhin.
Die $30 Starter-Gutschrift sollte nicht mit 30 kostenlosen GPU-Stunden verwechselt werden. Zum angegebenen H100-Tarif entspricht sie ungefähr 7,6 H100-GPU-Stunden – und dabei sind die übrigen Ressourcen des Jobs noch nicht berücksichtigt.
Wann sich Modal Clusters wirtschaftlich lohnt
Modal Clusters spielt seine Stärken aus, wenn ein Job groß und unregelmäßig ist und der dauerhafte Betrieb einer eigenen Umgebung unverhältnismäßig viel Aufwand verursacht. Ein Trainings-Burst, der einige Stunden läuft und danach wieder verschwindet, profitiert stärker von Scale-to-zero als ein Cluster, der wochenlang durchläuft.
Geeignet ist die Lösung für:
- Verteiltes Fine-Tuning, bei dem alle Nodes gemeinsam starten müssen.
- Kurze Trainings-Bursts mit teurer GPU-Kapazität.
- Multi-Node-Inferenz mit RDMA- oder modellparallelen Anforderungen.
- Python-Teams, die andernfalls Kubernetes, SLURM oder eine manuelle RDMA-Konfiguration betreiben müssten.
Passt das Modell auf eine einzelne Maschine, ist eine Modal-Funktion mit nur einem Node meist die bessere Wahl. Dedizierte oder reservierte Infrastruktur sollte ernsthaft verglichen werden, wenn die Auslastung vorhersehbar ist, der Workload ein festes SLA benötigt oder vor allem die niedrigsten dauerhaft anfallenden GPU-Stundenkosten zählen.
Auch eine Diskussion aus der Praxis markiert eine sinnvolle Grenze. In einem Computer-Vision-Thread empfahl u/Substantial_Camel735, die Vektorsuche auf einem VPS zu belassen, statt diesen Teil auf Modal-Workern auszuführen (Reddit-Diskussion). Das ist als Architekturpräferenz eines einzelnen Praktikers zu verstehen, nicht als plattformweiter Benchmark.
„Wir werden Modal bald verlassen, aber dieses Design klingt grundsätzlich richtig. Für die Suche würde ich allerdings keine Modal-Worker verwenden, sondern sie einfach auf deinem VPS gegen deine Vektordatenbank ausführen.“ — u/Substantial_Camel735, r/computervision
Diese Checks sollten vor einem großen Launch erledigt sein
- Die komplette Belegung multiplizieren.
size × GPUs pro Nodeberechnen und die Summe anschließend mit der Workspace-Concurrency vergleichen. - Mit dem kleinsten sinnvollen Cluster starten. Ein Test mit zwei Nodes kann Probleme bei Image, NCCL, Ranks und Rendezvous aufdecken, bevor ein Launch mit 32 GPUs die Rechnung vervielfacht.
- RDMA und Anwendungs-Debugging getrennt betrachten. Den verteilten Job zunächst ohne RDMA validieren, sofern der Workload das erlaubt. Anschließend
rdma=Trueaktivieren und den kommunikationssensitiven Teil messen. - Checkpoints in dauerhaftem Storage ablegen. Ein ausgefallener oder präemptierter Rank kann den gesamten Aufruf fehlschlagen lassen. Ein Retry ohne Checkpoint wiederholt unter Umständen den kompletten teuren Lauf.
- CPU, Arbeitsspeicher und ausgehenden Traffic budgetieren. Die GPU-Rechnung ist nur die erste Zeile der Abrechnung – besonders dann, wenn Datasets oder Ergebnisse Regionen verlassen.
- Prüfen, ob eine regionale Einschränkung erforderlich ist. Eine enge Standortvorgabe kann den verfügbaren Scheduling-Pool und den Preismultiplikator verändern. Locality sollte daher als messbare Anforderung behandelt und mit der aktuellen Dokumentation zur regionalen Preisgestaltung abgeglichen werden.
RDMA wird in den offiziellen Modal-Preisen nicht als eigener Kostenpunkt aufgeführt. Der Mehrwert liegt in der Performance: Synchronisiertes Training und große KV-Cache-Transfers können über gewöhnliches TCP zum Netzwerk-Bottleneck werden. Der Nachteil: RDMA-fähige Hardware und passende Platzierung können die Verfügbarkeit einschränken.
Modal Clusters: Häufige Fragen
Gibt es eine separate API-Gebühr für Modal Clusters?
Eine separate Cluster-Gebühr wird nicht ausgewiesen. Modal berechnet die von den einzelnen Containern genutzten Ressourcen: GPUs, CPU, Arbeitsspeicher, Storage und gegebenenfalls Netzwerkverkehr.
Wie groß kann ein Cluster maximal sein?
Die GA-Unterlagen nennen öffentliche Cluster mit bis zu 32 Nodes oder 256 GPUs. Größere Anforderungen werden über Modal abgewickelt (GA-Ankündigung). Workspace-Concurrency und verfügbare Kapazität gelten trotzdem.
Kann Modal Clusters für Inferenz genutzt werden?
Ja, sofern der Workload zum Ausführungsmodell des Clusters passt. Multi-Node- oder modellparallele Inferenz ist ein stärkerer Anwendungsfall als ein gewöhnlicher HTTP-Endpunkt. Für geclusterte Web-Funktionen gelten Einschränkungen, unter anderem wird der Traffic an Rank 0 zugestellt (Cluster-Dokumentation).
Die praktische Entscheidung
| Dein Workload | Guter Ausgangspunkt |
|---|---|
| Modell passt auf eine GPU oder einen Node | Normale Modal-Funktion |
| Kurzer, synchronisierter Multi-Node-Trainings-Burst | Modal Clusters nach einem kleinen Test |
| Lang andauernde, vorhersehbare Vollauslastung | Dedizierte oder reservierte GPU-Kapazität vergleichen |
| Such- oder Datenbank-Workload neben GPU-Inferenz | Datendienst getrennt betreiben, sofern Messungen keine gemeinsame Platzierung rechtfertigen |
| Strikte Anforderungen an privates Netzwerk oder Self-Hosting | Anderes Bereitstellungsmodell prüfen |
Modal Clusters macht die Orchestrierung von Multi-Node-GPUs einfacher – per Definition aber nicht günstiger. Serverlose Platzierung und die Python-Integration können Engineering-Zeit sparen. Bei dauerhaft hoher Auslastung, regionalen Einschränkungen und Retries des gesamten Clusters können diese Faktoren die Rechnung jedoch dominieren. Zuerst die vollständige Node-Anzahl berechnen, dann den Komfortaufschlag mit dedizierter Kapazität vergleichen.