 AIREITER
Eine Million Token Kontext und ein Input-Preis von 0,68 US-Dollar lassen Mistral Large 4 für ein Modell mit einer Billion Parametern erstaunlich günstig erscheinen. Der Haken: Das Modell befindet sich noch in der öffentlichen Preview. Für den Rabatt gibt es kein klares Enddatum, die Limits unterscheiden sich je nach Gateway von den offiziellen Eckdaten und die geplante Lizenz für die Modellgewichte ist noch nicht veröffentlicht.
Die Entscheidung in einer Minute
Mistral Large 4 ist schon jetzt einen Test wert, wenn du eine günstige API mit langem Kontext für Dokumente, Code-Repositories oder Workflows mit Tools suchst. Als stabilen Ersatz für den eigenen Betrieb oder als erwiesenen Spitzenreiter bei Coding-Benchmarks solltest du die Preview aber noch nicht betrachten.
| Anforderung | Entscheidung |
|---|---|
| Lange Dokumente oder große Codebasen per API testen | Jetzt ausprobieren und dabei Cache-Treffer sowie Output-Kosten messen |
| Planbare Preise auf lange Sicht | Warten oder mit dem höheren Tarif kalkulieren: 1,36 US-Dollar für Input und 4,18 US-Dollar für Output |
| Privates Deployment erforderlich | Auf Gewichte, Lizenz, Quantisierung und Serving-Hinweise warten |
| Der beste Coding-Score erforderlich | Nicht allein nach den Launch-Zahlen entscheiden; denselben Test-Harness mit den eigenen Aufgaben ausführen |
Das ist eine Entscheidung zur öffentlichen API-Preview, kein abschließendes Modellurteil. Mistral hat die Preview am 6. Oktober 2026 angekündigt. Nach Angaben des Unternehmens sollen die Gewichte bis Ende Oktober erscheinen. (Mistral-Ankündigung)
Was am 6. Oktober tatsächlich verfügbar ist
Mistral Large 4 ist als öffentliche Preview-API über Mistral Studio verfügbar. Mistral beschreibt das Modell als nativ multimodales Mixture-of-Experts-Modell mit insgesamt 1,05 Billionen Parametern und 49 Milliarden aktiven Parametern pro Token. In der offiziellen Ankündigung werden außerdem Function Calling, strukturierte Ausgaben, Fragen und Antworten zu Dokumenten, Batch-Verarbeitung, Agents und integrierte Tools genannt.
Das Modell ist außerdem unter mistralai/mistral-large-4-0 auf OpenRouter gelistet. Der OpenRouter-Zugriff ist damit nicht mehr nur ein Gerücht vom Launch-Tag. Limits, Latenz, Abrechnung und Fallback-Regeln können sich je nach Route unterscheiden.
Die API ist live, die herunterladbaren Gewichte und die endgültige Lizenz sind es noch nicht. „Open Weight“ sollte daher nicht mit uneingeschränkter kommerzieller Open-Source-Nutzung gleichgesetzt werden, solange Mistral die Model Card und die Nutzungsbedingungen nicht veröffentlicht hat.
Warum es beim Preis zwei unterschiedliche Zahlen gibt
Die aktuellen Preview-Tarife in der Modelldokumentation von Mistral sind attraktiv:
| Tokentyp | Preview-Tarif | Möglicher Tarif nach der Preview laut Launch-Material |
|---|---|---|
| Input | 0,68 US-Dollar / 1 Mio. Token | 1,36 US-Dollar / 1 Mio. Token |
| Gecachter Input | 0,07 US-Dollar / 1 Mio. Token | 0,14 US-Dollar / 1 Mio. Token |
| Output | 2,09 US-Dollar / 1 Mio. Token | 4,18 US-Dollar / 1 Mio. Token |
Die niedrigeren Werte werden im Gateway-Verzeichnis von Vercel und auf anderen Zugriffsseiten als 50-prozentiger Preview-Preis ausgewiesen. Ein Enddatum gibt es allerdings nicht. Behandle 0,68 US-Dollar und 2,09 US-Dollar daher als aktuelle Tarife – nicht als dauerhaft garantierte Vertragspreise.
Bei einem Workload mit 500.000 nicht gecachten Input-Token und 100.000 Output-Token läge die Preview-Rechnung bei etwa 0,55 US-Dollar: 0,34 US-Dollar für den Input plus 0,209 US-Dollar für den Output. Ist der Input gecacht, sind es ungefähr 0,244 US-Dollar: 0,035 US-Dollar für den gecachten Input plus 0,209 US-Dollar für den Output. Bevor du Produktiv-Traffic umstellst, solltest du Cache-Wiederverwendung, Output-Volumen und die Haltbarkeit des Rabatts bewerten.
Kontext und Funktionen hängen von der Route ab
In der Modelldokumentation von Mistral ist ein Kontextfenster mit 1 Million Token angegeben. Das ist eine Angabe auf Modellebene und nicht zwingend das Limit, das jedes Gateway bereitstellt.
Die AI-Gateway-Seite von Vercel führt derzeit ein gemeinsames Kontextfenster von 524K und eine maximale Output-Länge von 262K für den Mistral-Provider auf. Außerdem nennt sie eine P50-Zeit bis zum ersten Token von 0,9 Sekunden, 38 Token pro Sekunde und eine Cache-Trefferquote von 74 Prozent auf Basis des Gateway-Traffics.
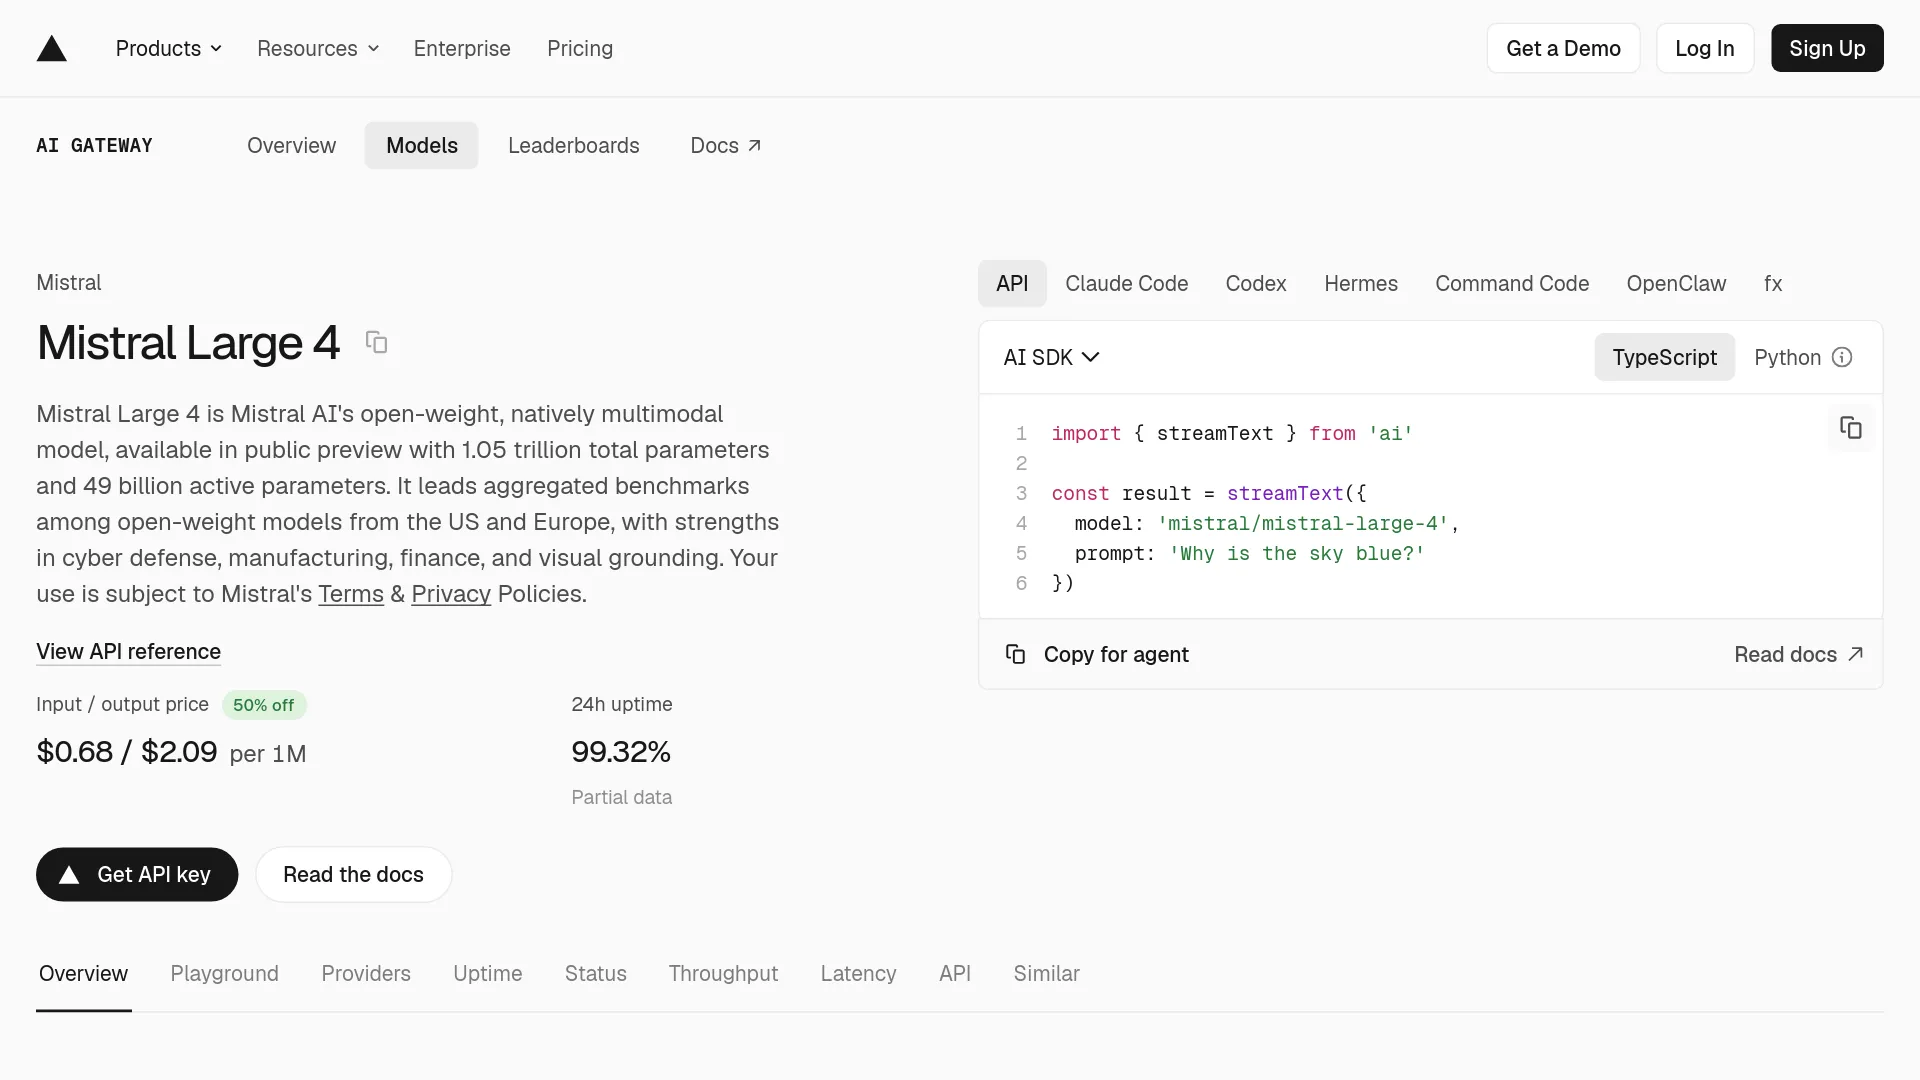
Das sind Angaben zur jeweiligen Route und keine universellen Garantien des Modells. Die Seite dokumentiert Bildeingaben, Tool Calling, OpenAI-kompatible Chat-Completions- und Responses-APIs sowie den Anthropic-kompatiblen Messages-Zugriff. Die Gateway-ID lautet mistral/mistral-large-4 und unterscheidet sich damit von der Provider-spezifischen ID bei OpenRouter.
Prüfe für jede Integration das gemeinsame Kontextlimit des Endpunkts, die maximale Output-Länge, die Abrechnung von Bildern und Token, das Tool-Verhalten, die Cache-Regeln, das Provider-Routing und die Fallback-Regeln. Die 1-Million-Token-Angabe ist für eine Vorauswahl hilfreich, reicht aber nicht aus, um eine Anwendung zu dimensionieren.
Was die Benchmark-Daten tatsächlich belegen
Die Launch-Analyse von TechsCurrent berichtet Mistrals Werte von 61,7 Prozent bei DeepSWE v1.1, 28,3 Prozent bei Terminal-Bench 4 und 59,9 Prozent bei AutomationBench. Der Launch-Vergleich von CellCog nennt für DeepSeek V4.1 Flash 74,2 bei DeepSWE und für Mistral Large 4 61,7. Gleichzeitig liegt Mistrals AutomationBench-Wert über den Vergleichswerten. Das sind von Anbietern gemeldete oder quellenübergreifende Signale, aber keine Ergebnisse aus einer einheitlichen Rangliste.
Bevor du das Modell für Produktiv-Agents einsetzt, solltest du eine standardisierte Evaluation durchführen:
- Verwende für Mistral Large 4 und das bisher eingesetzte Modell dasselbe Repository, denselben Prompt, dieselben Tools und dasselbe Timeout.
- Miss Aufgabenerfüllung, Fehler bei Tool-Argumenten, Wiederholungen, Latenz, Output-Token und Kosten.
- Ergänze Fälle mit langem Kontext, bei denen die gesuchte Antwort in der Mitte und nahe am Ende der Eingabe steht.
- Wiederhole den Test mit gecachtem und nicht gecachtem Kontext.
- Halte Ergebnisse der Preview getrennt von den Ergebnissen eines späteren Releases der Modellgewichte.
Für wen sich der Einsatz jetzt lohnt
API-first-Teams mit viel wiederkehrendem Kontext: Teste Mistral Large 4 jetzt. Der Tarif von 0,07 US-Dollar für gecachten Input kann relevant sein, wenn ein Agent dasselbe Regelwerk, Repository oder Dokumentpräfix wiederholt sendet. Begrenze das Budget des Experiments, denn der höhere Tarif bleibt möglich.
Teams für bildgestützte Dokumenten-Workflows: Teste Bildeingaben und Dokumentenextraktion auf der Route, die du später einsetzen willst. Das Modell unterstützt Bildeingaben, aber routenspezifische Dateilimits und Abrechnungsdetails müssen weiterhin geprüft werden.
Teams für Coding-Agents: Behandle Mistral Large 4 als Kandidaten, nicht automatisch als Sieger. Die verfügbaren Benchmark-Daten fallen gemischt aus, und die tatsächliche Zuverlässigkeit hängt von Tool-Aufrufen, Wiederholungen und der Abschlussquote ab.
Datenschutzsensible Teams und Self-Hosting-Teams: Warte auf die Gewichte und die Lizenz. Die Angabe von 49 Milliarden aktiven Parametern bedeutet nicht, dass der vollständige Checkpoint klein ist; das Gesamtmodell muss weiterhin gespeichert und betrieben werden. Hardwarebedarf, Quantisierung, Durchsatz und Weitergaberechte sind noch offen.
Häufige Fragen zu Mistral Large 4 API
Ist Mistral Large 4 bereits Open Source?
Nein. Zum Launch waren weder eine endgültige Lizenz noch herunterladbare Gewichte verfügbar. Mistral plante die Veröffentlichung der Gewichte bis Ende Oktober 2026. „Open Weight“ allein sagt jedoch nichts über kommerzielle Nutzungs- oder Weitergaberechte aus.
Bleibt der Preis von 0,68 US-Dollar dauerhaft bestehen?
Ein Enddatum ist nicht angegeben. Kalkuliere Tests zunächst mit dem aktuellen Input-Preis von 0,68 US-Dollar und dem Output-Preis von 2,09 US-Dollar, berücksichtige aber auch 1,36 US-Dollar und 4,18 US-Dollar.
Beträgt das Kontextfenster 1M oder 524K?
Mistral dokumentiert einen Modellkontext von 1M Token. Vercel nennt für seine Gateway-Route ein gemeinsames Kontextfenster von 524K. Prüfe das Limit für den Provider und das API-Format, die du tatsächlich aufrufen willst.
Ist das Modell bereits auf OpenRouter verfügbar?
Ja. OpenRouter führt derzeit mistralai/mistral-large-4-0. Prüfe die aktuelle Seite vor dem Deployment, da sich das Routing einer Preview ändern kann.
Kann das Modell Bilder und Tools verarbeiten?
Die offizielle Dokumentation und die Gateway-Dokumentation beschreiben Bildeingaben und Tool Calling. Teste das Anfrageformat, Bildlimits, Token-Abrechnung und das Verhalten bei fehlerhaften Tool-Aufrufen auf der von dir gewählten Route.
Sollte ich das Modell nach dem Release der Gewichte selbst hosten?
Nicht automatisch. Warte auf die Lizenz, Checkpoint-Formate, Quantisierungsoptionen, Speicheranforderungen, Durchsatzdaten und eine Referenzkonfiguration für das Serving.
Der nächste Test
Erstelle vor der Weiterleitung echten Traffics eine Evaluation mit 20 Aufgaben: fünf Aufgaben zum Abruf aus langem Kontext, fünf Coding-Änderungen, fünf Fragen zu Bildern und Dokumenten sowie fünf Aufgaben für Tool Calling. Protokolliere Erfolgsquote, Wiederholungen, Zeit bis zum ersten Token, Gesamtlatenz, Input-, Cache- und Output-Token sowie die effektiven Kosten pro erfolgreich abgeschlossener Aufgabe.
Quellen: Mistral Modelldokumentation, Mistral-Ankündigung, Vercel AI Gateway, OpenRouter-Modellseite, TechsCurrent, CellCog.