 AIREITER
Sechs Modelle, rund 2 Milliarden Parameter und Unterstützung für Text, Bilder, Audio sowie multimodale Interaktion: Liquid AI bündelt all das in der LFM3-Familie. Einen eigenen LFM3-Tarif nennt Liquids Preisseite am 27. Oktober 2026 allerdings noch nicht. Damit bleibt offen, ob LFM3 derzeit vor allem als günstiger Edge-Spezialist oder zunächst nur als Download für den Eigenbetrieb gedacht ist.
LFM3 kurz erklärt: sechs 2B-Spezialisten, aber noch kein API-Preis
LFM3 ist keine einzelne Checkpoint-Datei, sondern Liquids dritte Generation von Foundation-Modellen für spezialisierte On-Device-Intelligenz. Als gemeinsames Fundament dient der mit 22 Billionen Tokens vortrainierte LFM3-1.7B-Base-Backbone. Darauf baut die Familie mit sechs Varianten auf: LFM3-1.7B, LFM3-VL-2B, LFM3-Audio-2B, LFM3-Omni-2B, d1-2B und d1-Omni-2B (Ankündigung).
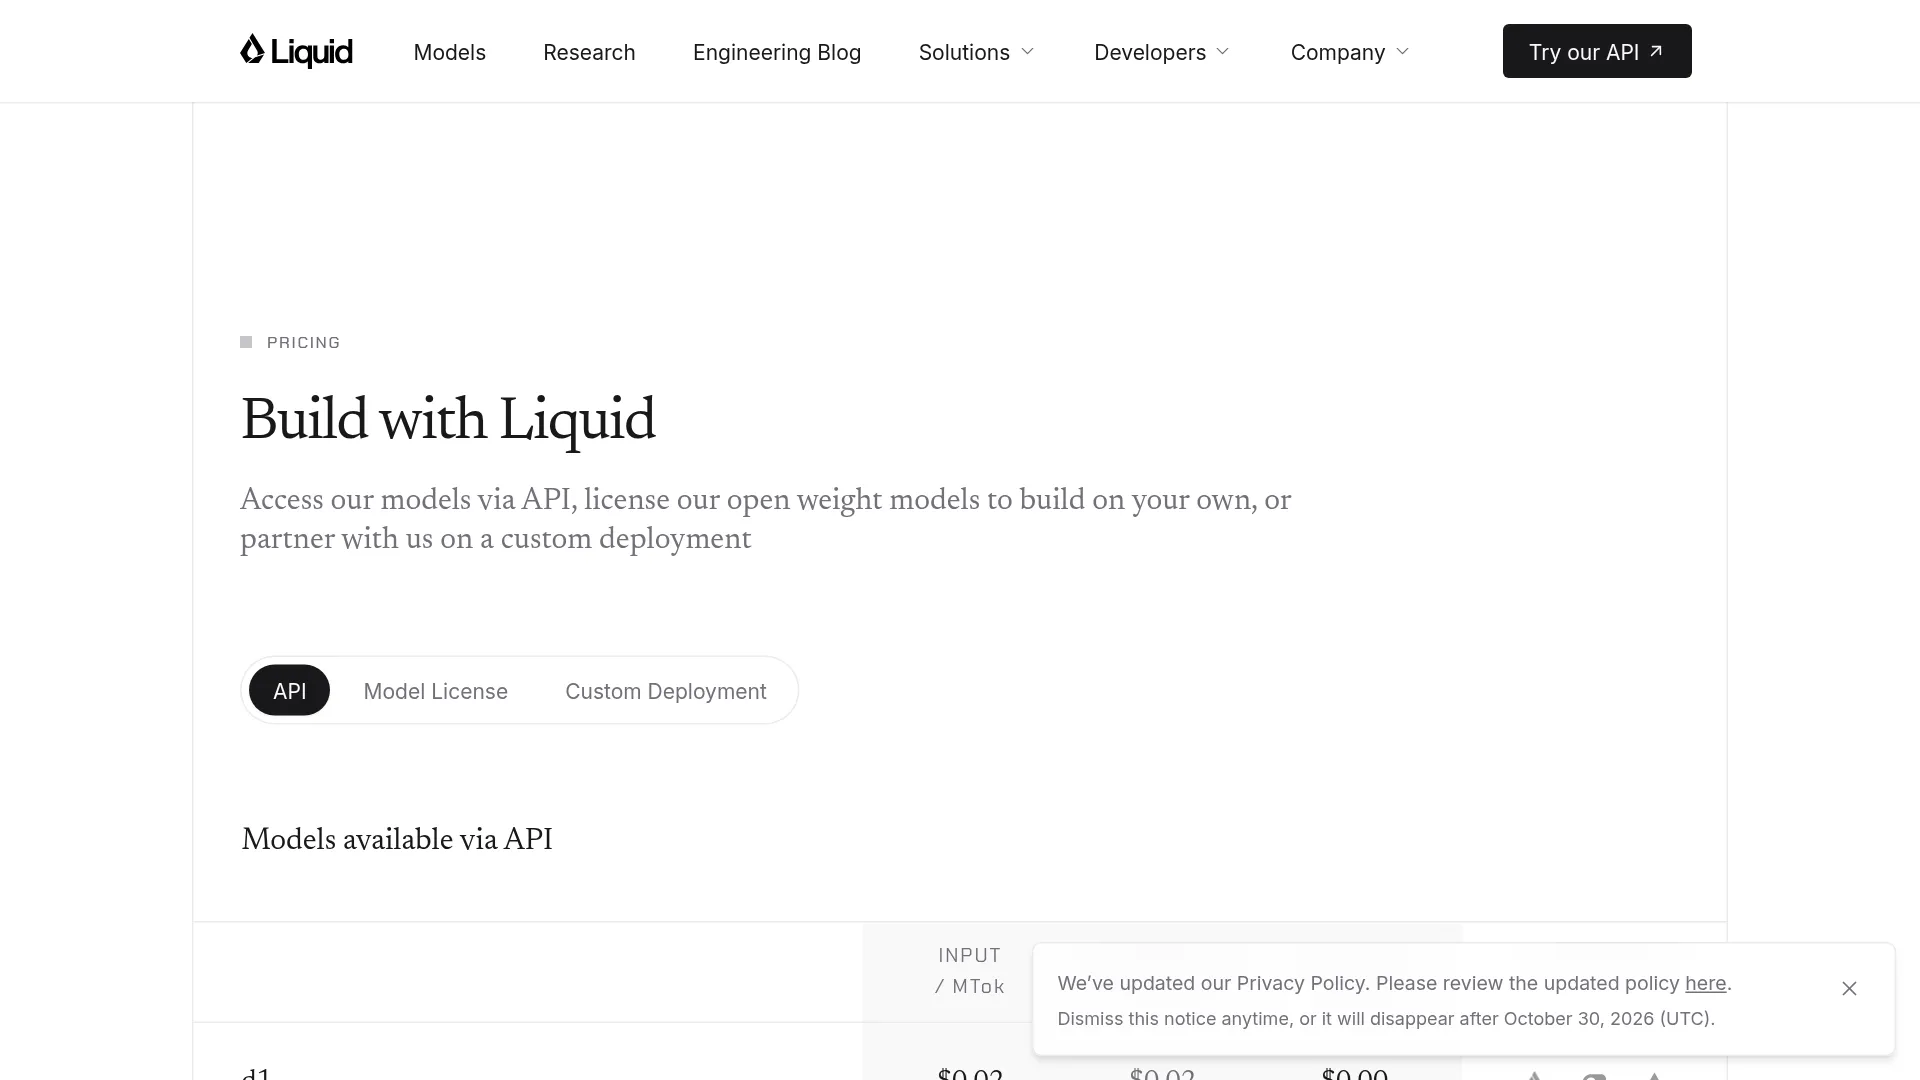
Ich habe am 27. Oktober einen Blick auf Liquids Preisseite geworfen: Dort fehlen LFM3-Tarife bislang vollständig. Aufgeführt sind nur die unten stehenden Preise für d1, d1-ultra und LFM2.5. In der LFM3-Ankündigung heißt es, dass die Gewichte über Hugging Face, den Liquid Playground und die Liquid API verfügbar sind. Direkt überprüfen lassen sich derzeit allerdings nur die ersten beiden Wege. Neue Organisationen erhalten weiterhin $2 Startguthaben für die Liquid Console (Preise).
Die sechs Modelle: Welche Variante passt zu welcher Aufgabe?
Alle sechs LFM3-Checkpoints verwenden denselben Backbone, unterscheiden sich aber bei Eingaben und Ausgaben.
| Modell | Ungefähre Größe | Eingaben | Ausgaben | Geeignet für |
|---|---|---|---|---|
| LFM3-1.7B | 1.7B | Text | Text | Lokale Agenten, Tool-Aufrufe, strukturierte Ausgaben |
| LFM3-VL-2B | 1.9B | Text, Bilder, Video | Text | Bild- und Videoverständnis, visuelle Agenten |
| LFM3-Audio-2B | 2B | Text, Audio | Text, Sprache | Sprachchats, Erkennung, Synthese und Übersetzung in 18 Sprachen |
| LFM3-Omni-2B | 2B | Text, Bilder, Video, Audio | Text, Sprache | Einheitlicher multimodaler Assistent |
| d1-2B | 2B | Text, Bilder, Video | Kalibrierte Antworten | Klassifizierung, Extraktion, Entscheidungen in einem Durchlauf |
| d1-Omni-2B | 2B | Text, Bilder, Video, Audio | Kalibrierte Antworten | Multimodale Erfassung mit Konfidenzwerten |
LFM3-1.7B bietet ein Kontextfenster von 256K Tokens und einen dreifach hybriden Aufbau mit 24 Schichten: 13 gated Short-Convolution-Schichten, 5 Sliding-Window-Attention-Schichten mit einem Fenster von 256 Tokens sowie 6 Global-Attention-Schichten (Ankündigung). In der abschließenden Mid-Training-Phase mit 3,5 Billionen Tokens kamen Agenten-Trajektorien und Tool-Aufrufe hinzu. Das erklärt, warum Liquid das Textmodell für Umgebungen wie Hermes Agent, Pi und OpenClaw positioniert (Ankündigung). LFM3-VL-2B ist Liquids erstes Vision-Modell mit Videoeingabe. LFM3-Omni-2B ist das erste Omni-Modell des Unternehmens, das Tonspur und Videobilder gemeinsam verarbeitet (Ankündigung).
Die d1-Modelle funktionieren anders als die übrigen Varianten. d1-2B und d1-Omni-2B überspringen die autoregressive Generierung und liefern in einem einzigen Forward Pass kalibrierte Antworten samt Wahrscheinlichkeiten (Ankündigung). Die von Liquid angegebenen Latenzen für d1-2B liegen bei 5.7 ms auf einer NVIDIA H100 und 3.8 ms auf einer AMD MI325X. Bei d1-Omni-2B steigen sie mit einem 10-Sekunden-Audioclip auf 12.4 ms beziehungsweise 8.2 ms (Ankündigung).
Liquids Messwerte – und was sich davon unabhängig prüfen lässt
Die Benchmark-Zahlen von Liquid AI stammen vom Hersteller. Bis unabhängige Tests vorliegen, sollten sie daher als Herstellerangaben gelten. Alle folgenden Werte stammen aus Liquids Ankündigung.
| Modell | Vom Hersteller angegebene Metrik | LFM3-Wert | Vorgänger / Konkurrenzwert |
|---|---|---|---|
| LFM3-1.7B | WebArena-Verified | 38.42 | 3.02 (LFM2.5-2.6B) |
| LFM3-1.7B | Größe / Geschwindigkeit | 35 % weniger Parameter, bei 8K rund 25 % schneller pro Parameter als LFM2-1.2B | — |
| LFM3-VL-2B | 62 Vision Avg / Encoder | 71.4 Durchschnitt; 164M-Encoder mit 2.2x weniger FLOPs | 57.6 Durchschnitt; Encoder-Parität mit Qwen3.5-2B behauptet |
| LFM3-Audio-2B | UTMOSv2 / Latenz | 3.83; 50 ms bis zum ersten Token; 87-fache Echtzeit auf einer M4-Max-CPU | 3.22 (LFM2.5-Audio-1.5B) |
| d1-2B | ImajevBench | 75.5 | 64.0 (d1-3B) |
Direkt verifizieren konnte ich Folgendes: Die LiquidAI-LFM3-Sammlung auf Hugging Face führt alle sechs Builds inklusive quantisierter, MLX- und ONNX-Varianten. Auch LM Studios Katalog bietet bereits LFM3-Varianten für Desktop-Systeme an. Die Scores sind trotzdem eher als Richtung denn als Garantie zu verstehen. Durchschnittswerte verschleiern Unterschiede bei OCR, Grounding und Video. Außerdem berücksichtigt die 4-Bit-Angabe von 1 GB weder den KV-Cache noch den Speicherbedarf der Anwendung.
„Schon verrückt, wie schnell man heutzutage Dinge bauen kann.“ — @Nklockiewicz, der LFM3 per MLX/ExecuTorch mit 40 tok/s auf einem iPhone im Flugmodus ausführt (Quelle)
„Gemessen an Geschwindigkeit und Intelligenz liegen sie typischerweise über ihrer Gewichtsklasse. In meiner Erfahrung sind sie aber noch nicht klug genug für ‚echte Arbeit‘.“ — u/spaceman_, r/LocalLLaMA (Quelle)
Die $10M-Lizenzgrenze sollte vor dem Produktivstart klar sein
Liquids Open-Weights-Lizenz bleibt kostenlos, bis der Jahresumsatz eines Unternehmens die Marke von $10 Millionen überschreitet (Preise). Entwickler, Forschungseinrichtungen, gemeinnützige Organisationen und Unternehmen mit weniger als $10M Jahresumsatz dürfen jedes offene LFM herunterladen, ausführen, feinabstimmen und produktiv einsetzen. Fine-Tunes dürfen privat bleiben; auch Bereitstellungen auf Mobilgeräten, am Edge oder On-Premises sind ohne Copyleft-Pflicht erlaubt (Preise).
Unternehmen mit mehr als $10M benötigen eine kostenpflichtige Enterprise-Lizenz. Die Preise richten sich nach dem Umfang des Deployments und werden über den Vertrieb festgelegt. Forschung, Bildung und gemeinnützige Nutzung bleiben ohne Umsatzgrenze kostenlos (Preise). Die LFM Open License beendet ihre kostenlose kommerzielle Nutzungserlaubnis ab dieser Schwelle. Vor der Integration der Gewichte in eine kommerzielle Anwendung sollten insbesondere Vorgaben zu Attribution, Weitergabe und Export mit der Rechtsabteilung geklärt werden.
LFM3 lokal betreiben: Was die 1-GB-Angabe in der Praxis bedeutet
LFM3-1.7B benötigt in 4-Bit-Ausführung ungefähr 1 GB. Diese Zahl bezieht sich allerdings nur auf die Gewichte (Ankündigung). Der laufende Prozess braucht zusätzlich Speicher für Runtime, KV-Cache bei langen Kontexten sowie Bild- oder Audio-Encoder. Gerade bei VL- und Omni-Varianten, die Videobilder oder Audioclips verarbeiten, sollte daher zusätzlicher RAM eingeplant werden.
Am sinnvollsten ist der Einstieg mit LFM3-1.7B. VL, Audio oder Omni kommen erst dazu, wenn der jeweilige Anwendungsfall sie wirklich verlangt. Vor dem Benchmarking sollten außerdem die zusätzlichen Abhängigkeiten in der jeweiligen Model Card geprüft werden. Für LFM3 werden Wege über Ollama, LM Studio, llama.cpp, MLX und ONNX in der Hugging-Face-Sammlung und im LM-Studio-Katalog genannt.
Wenn ein Beispiel in der Model Card trust_remote_code=True voraussetzt, sollte ein Commit-Hash festgeschrieben, der Repository-Code geprüft oder der erste Lauf in einer isolierten Umgebung durchgeführt werden. Das Flag führt Code aus, der im Repository mitgeliefert wird. Liquid nennt in seiner Ankündigung 18 Audiosprachen, liefert dort aber keine Qualitätsübersicht pro Sprache. Nicht-englische Ausgaben sollten deshalb mit eigenen Daten geprüft werden.
API-Zugriff aktuell: Wo sich LFM3 nutzen lässt – und was abgerechnet wird
Liquid hat den API-Zugriff auf LFM3 angekündigt, führt dafür auf der öffentlichen Preisseite aber noch keinen eigenen Tarif. Die dort genannten Zugangswege laufen über Liquid Console, OpenRouter und Vercel AI Gateway (Preise).
| Am 27. Oktober aufgeführtes API-Modell | Eingabe / MTok | Gecachte Eingabe / MTok | Ausgabe / MTok |
|---|---|---|---|
| d1 | $0.02 | $0.02 | $0.00 |
| d1-ultra | $0.042 | $0.042 | $0.00 |
| LFM2.5-24B-A2B | $0.05 | $0.025 | $0.70 |
| LFM3-1.7B / VL / Audio / Omni Texttarife | Nicht aufgeführt | Nicht aufgeführt | Nicht aufgeführt |
Die fehlenden Tarife sind derzeit die entscheidende Preis-Information: LFM3 sollte vorerst als selbst gehostete Rechenlast plus Entwicklungsaufwand kalkuliert werden, nicht als Posten mit festen Kosten pro Token. Wer heute von einem Anbieter LFM3-Tokens angeboten bekommt, sollte sie mit den genannten d1- und LFM2.5-Basispreisen vergleichen und klären, ob der Dienst die Liquid Console durchreicht oder eigene Gewichte betreibt. Der aufgeführte d1-Ausgabepreis von $0.00 pro einer Million Tokens könnte d1 für Prüf- und Inspektionspipelines mit hohem Volumen interessant machen.
LFM3-FAQ
Wie viel kostet die LFM3-API?
Liquid AI nennt am 27. Oktober 2026 keinen separaten LFM3-Preis pro Token. Auf der öffentlichen Preisseite stehen nur Tarife für d1, d1-ultra und LFM2.5-24B-A2B.
Ist LFM3 für die kommerzielle Nutzung kostenlos?
Für Unternehmen mit weniger als $10M Jahresumsatz ist der produktive kommerzielle Einsatz unter der LFM Open License kostenlos. Größere Unternehmen benötigen eine kostenpflichtige Enterprise-Lizenz.
Läuft LFM3 auf einem Smartphone oder Laptop?
Ja, die Textvariante benötigt in 4-Bit-Ausführung ungefähr 1 GB zuzüglich Runtime-Overhead. Dafür gibt es Wege über Ollama, LM Studio, llama.cpp, MLX und ONNX. VL-, Audio- und Omni-Varianten brauchen wegen ihrer Encoder und Medienverarbeitung mehr Speicher.
Ist LFM3 für Edge-Agenten besser als Qwen oder Gemma?
In den von mir geprüften Ergebnissen vom Starttag fand ich keinen unabhängigen Vergleich. Liquids behauptete Vorteile gegenüber Qwen3.5-2B und Qwen2.5-Omni-7B stammen aus Herstellerangaben (Ankündigung). Vor einem Wechsel sollte LFM3 daher mit Gemma und Qwen im eigenen Agenten-Setup getestet werden.
Kann ich LFM3 auf einer GPU feinabstimmen?
Liquid stellt Notebooks für SFT, DPO, GRPO und Continued Pretraining bereit und sagt, dass sich jedes Modell auf einer einzelnen GPU feinabstimmen lässt (Ankündigung). Angaben zu VRAM- oder Datensatzanforderungen veröffentlicht das Unternehmen jedoch nicht.
Günstiger privater Spezialist oder kleiner Generalist für dein eigenes Setup?
LFM3 passt gut, wenn Daten auf dem Gerät bleiben müssen, Medien lokal verarbeitet werden sollen oder hohe Anfragevolumen die Kosten einer Token-Abrechnung in der Cloud unattraktiv machen. Für breites Allgemeinwissen, langes kreatives Schlussfolgern oder sofort überzeugende Ergebnisse ohne Anpassung des Agenten-Setups ist die Familie weniger geeignet. Am besten wird eine Variante heruntergeladen und mit den eigenen Prompts und der eigenen Hardware vermessen. Dieses Ergebnis sollte entscheiden – nicht die Launch-Grafik.