 AIREITER
Wer am 19. August 2026 im LFM2.5-2.6B-Repo nach der neuen Q4_0-Version sucht, muss genau hinsehen: Neben der bisherigen 1,59-GB-Datei liegt dort eine zweite mit derselben Größe und fast identischem Namen. Inhaltlich unterscheiden sie sich trotzdem deutlich. QAD – kurz für quantization-aware distillation – fängt einen Großteil der Qualitätsverluste von 4-Bit-Quantisierung bereits während des Trainings ab. Wer die falsche der beiden Dateien lädt, verwendet weiterhin die unkorrigierte Variante.
Was QAD beim Training anders macht
QAD steht für quantization-aware distillation. Liquid AI hat die vier Modelle LFM2.5-230M, LFM2.5-350M, LFM2.5-1.2B-Instruct und LFM2.5-2.6B darauf trainiert, mit der Rundung auf Q4_0 umzugehen. Während des Trainings distilliert ein hochpräzises Lehrermodell Wissen in den quantisierten Schüler. Die Gewichte bekommen den Quantisierungsfehler also gewissermaßen vorher zu sehen und können sich darauf einstellen.
Die alten Q4_0-Dateien in denselben Repositories basieren dagegen auf Post-Training Quantization (PTQ): Ein fertiges BF16-Modell wird nachträglich heruntergerundet, ohne dass das Training den dabei entstehenden Fehler ausgleicht. Laut Liquid AIs Ankündigung erreichen alle vier QAD-Checkpoints über eine Testreihe hinweg „rund 97 % ihrer BF16-Durchschnittswerte“. Berücksichtigt wurden Reasoning, Befolgen von Anweisungen, Tool-Nutzung und agentisches Verhalten; angegeben ist der Mittelwert aus fünf Durchläufen. QAD ist also eine Änderung am Training, kein neues Dateiformat. Das Ergebnis bleibt ein gewöhnliches GGUF im Format Q4_0, das llama.cpp bereits unterstützt.
Die Dateinamen-Falle – mit den richtigen Befehlen
Im Repository von LFM2.5-2.6B liegen sowohl LFM2.5-2.6B-Q4_0.gguf als auch LFM2.5-2.6B-QAD-Q4_0.gguf; beide sind mit 1,59 GB gelistet. Die Standardbeispiele des Repos verweisen allerdings auf Q4_K_M. Wer sie einfach kopiert, lädt somit keine der beiden QAD-Dateien. Der Dateiname muss ausdrücklich angegeben werden.
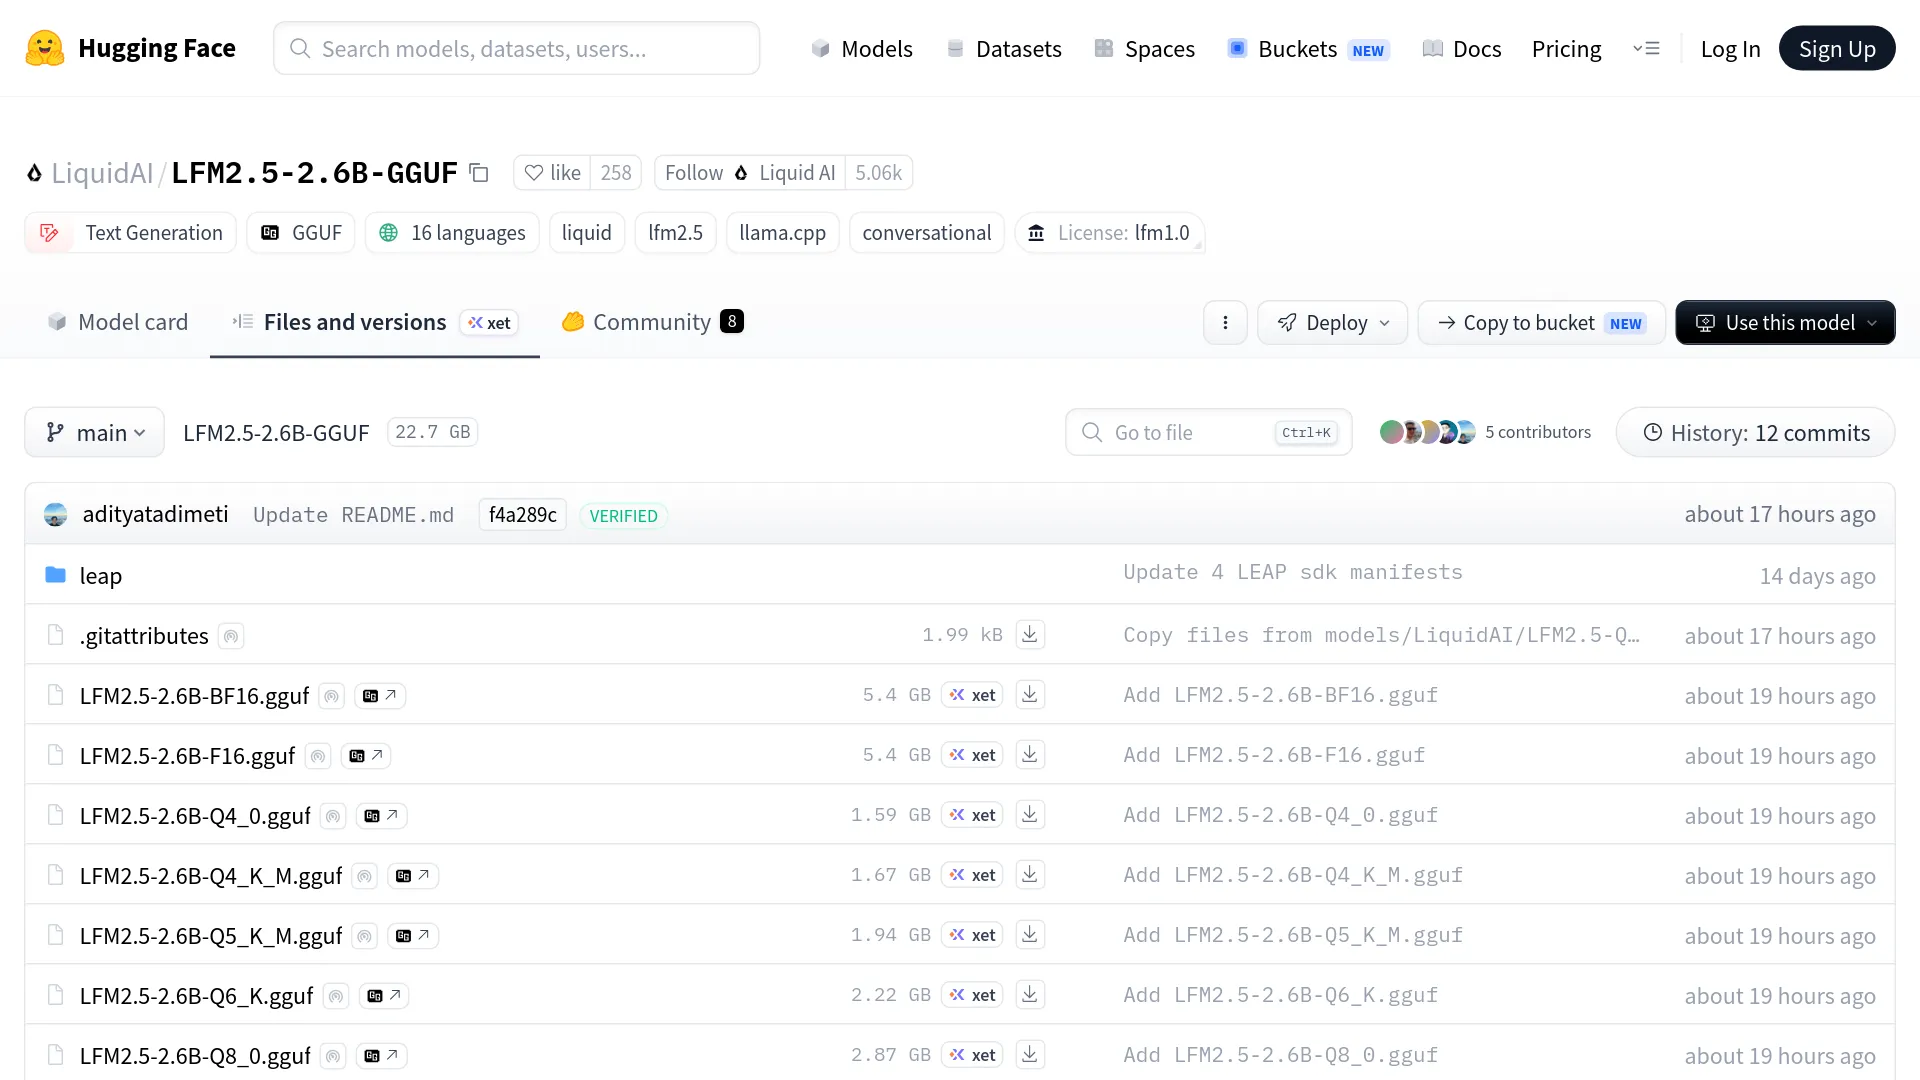
Die Verwirrung war schon wenige Stunden nach der Veröffentlichung sichtbar:
„Wo kann man die Datei herunterladen? Ich sehe sie auf Hugging Face, bin mir aber nicht sicher, ob es die normale Version oder QAD ist. Könnt ihr das bitte erklären?“ – @Chitacc72 auf X
Ein früher Nutzer, @MarMarLabs, verglich die Dateien im Repository und stellte fest, dass sich die alte und die neue Q4_0-Version um etwa 4 KB unterscheiden – in einem Dateimanager praktisch nicht zu erkennen. Die Lösung: --hf-file muss auf den exakten QAD-Dateinamen zeigen:
# official example from Liquid AI's release post
llama-cli -hf LiquidAI/LFM2.5-350M \
  --hf-file LFM2.5-350M-QAD-Q4_0.gguf \
  -p "What is C. elegans?"

# 2.6B, with the sampling flags from the official model card
llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-QAD-Q4_0.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1
Dasselbe Muster mit --hf-file gilt für die Repositories von 230M und 1.2B-Instruct. Für den Serverbetrieb veröffentlichte @nicolasembleton nach unvollständigen, von Hugging Face erzeugten Befehlen die funktionierende Kurzform: llama serve -hf LiquidAI/LFM2.5-2.6B-GGUF:QAD-Q4_0. Der Zusatz nach dem Doppelpunkt wählt die QAD-Version aus.
Was die offiziellen Zahlen zeigen – und was nicht
In Liquid AIs Benchmark-Tabelle behalten die QAD-Checkpoints zwischen 96,5 % und 97,4 % ihrer BF16-Baseline. Die Testreihe umfasst GPQA Diamond, MMLU-Pro, IFEval, IFBench, Multi-IF und BFCLv4. Für die beiden kleineren Modelle kommt GSM8K hinzu, für die beiden größeren AIME25. Alle Werte sind Mittelwerte aus fünf Durchläufen.
| Checkpoint | Erhaltene BF16-Qualität | Qualitätsaussage | Decodier-Durchsatz |
|---|---|---|---|
| LFM2.5-230M | 97,1 % | innerhalb der Streuung gleichauf mit Q5_K_M | +4–33 % gegenüber Q5_K_M |
| LFM2.5-350M | 96,5 % | innerhalb der Streuung gleichauf mit Q5_K_M | +4–33 % gegenüber Q5_K_M |
| LFM2.5-1.2B-Instruct | 97,4 % | gleichauf mit Q4_K_M | +3–14 % gegenüber Q4_K_M |
| LFM2.5-2.6B | 96,6 % | gleichauf mit Q4_K_M | +3–14 % gegenüber Q4_K_M |
Gemessen wurde der Durchsatz auf vier Zielplattformen: MacBook Pro und NucBox EVO-X2 mit GPU sowie Samsung Galaxy S26 Ultra und Raspberry Pi 5 mit Arm-CPU. Für die Modelle 230M und 1.2B meldet Liquid AI außerdem, dass QAD Q4_0 mit Unsloths UD-Q4_K_XL gleichzieht – im Beitrag als starker externer PTQ-Checkpoint bezeichnet.
Was die Veröffentlichung nicht liefert: Einzelwerte pro Benchmark, rohe Tokens-pro-Sekunde-Werte je Gerät, Dateigrößen, RAM-Angaben oder Streuungsbalken. Stattdessen gibt es Prozentbereiche und Aussagen zur Gleichwertigkeit. Die Community rechnete die Größenordnung sofort durch:
„Heißt das, ich kann mein lokales LFM2.5-2.6B von F16 auf QAD Q4_0 umstellen und komme von: 5,4 GB auf 1,6 GB, von 21 auf 64 Tok/s … und behalte dabei rund 97 % der BF16-Leistung?“ – @firedUp_Neyu, beim Lesen von Liquids Launch-Charts
Die Rechnung bei der Dateigröße stimmt: F16 belegt im offiziellen Repository 5,4 GB, QAD Q4_0 1,59 GB. Die Tok/s-Werte stammen dagegen aus seiner Interpretation der Diagramme und wurden von Liquid AI nicht als Textwerte veröffentlicht.
Die offenen Punkte der Veröffentlichung
Wenn du entscheiden willst, ob sich eine Umstellung lohnt, sind vor allem drei Lücken relevant.
Es gibt exakt vier Checkpoints. Für LFM2.5-VL-450M und LFM2.5-8B-A1B existieren zum Veröffentlichungszeitpunkt keine QAD-Builds. Im X-Thread zur Veröffentlichung fragen Nutzer bereits nach einer 8B-Version. Für Geräte, auf denen eines dieser Modelle zum Einsatz kommt, ändert QAD heute also nichts.
Die Imatrix-Frage ist ungeklärt. Die QAD-Dateien wurden für Q4_0 trainiert, aber ohne Importance Matrix erzeugt. Beobachter der Quantisierung wiesen sofort darauf hin:
„Das QAD-Q4_0-GGUF wurde ohne Imatrix erstellt. Eine solche Matrix hätte die Qualität der QAD-trainierten Modelle zusätzlich verbessert.“ – u/Chromix_, r/LocalLLaMA
Ein Modell unter 3B bleibt ein Modell unter 3B. Eine bessere Quantisierung hebt die Leistungsgrenze des Basismodells nicht an. Das zeigt auch der LocalLLaMA-Thread. Ein NPU-Nutzer berichtet:
„Ich habe LFM2.5 2.6B gerade auf meiner NPU für Besprechungszusammenfassungen implementiert. Für die Größe ist das beeindruckend, aber die Zusammenfassungen sind deutlich schlechter als das, was größere Modelle liefern.“ – u/DerDave
Diese Grenze liegt beim Modell, nicht bei der Quantisierung: Der Quantisierungsbericht von KikoCis verzeichnete bei Q8_0 0 von 6 gelösten SWE-bench-Verified-Aufgaben. Nutzer der 1.2B-Variante berichten außerdem stark schwankende Qualität je nach Runtime – in einer Ollama-Konfiguration waren 9 von 10 Prompts Kauderwelsch, während das Modell auf einem Einplatinencomputer in einer anderen Umgebung produktiv mit weniger als 5 W lief. Wenn für eine Aufgabe Frontier-Qualität zählt, kannst du lokale Ausgaben für einen vollständigen Testsatz über eine günstige LLM-API gegen ein großes Modell prüfen; das kostet nur wenige Cent.
QAD Q4_0 oder Q4_K_M: Welche Datei ist die richtige?
Für llama.cpp-Deployments mit knappem RAM und einem dieser vier Checkpoints ist QAD Q4_0 die vom Anbieter unterstützte 4-Bit-Variante, die du zuerst testen solltest. Sie belegt genauso 1,59 GB wie das einfache Q4_0, wurde aber darauf trainiert, bei 1.2B und 2.6B die Qualität von Q4_K_M sowie bei 230M und 350M die Qualität von Q5_K_M zu erreichen – bei 3–14 % beziehungsweise 4–33 % höherem Decodier-Durchsatz. Läuft Q4_K_M bei dir bereits problemlos und ist noch RAM übrig, gibt es keinen zwingenden Grund zum Wechsel. 80 MB lösen dann nicht dein eigentliches Problem.
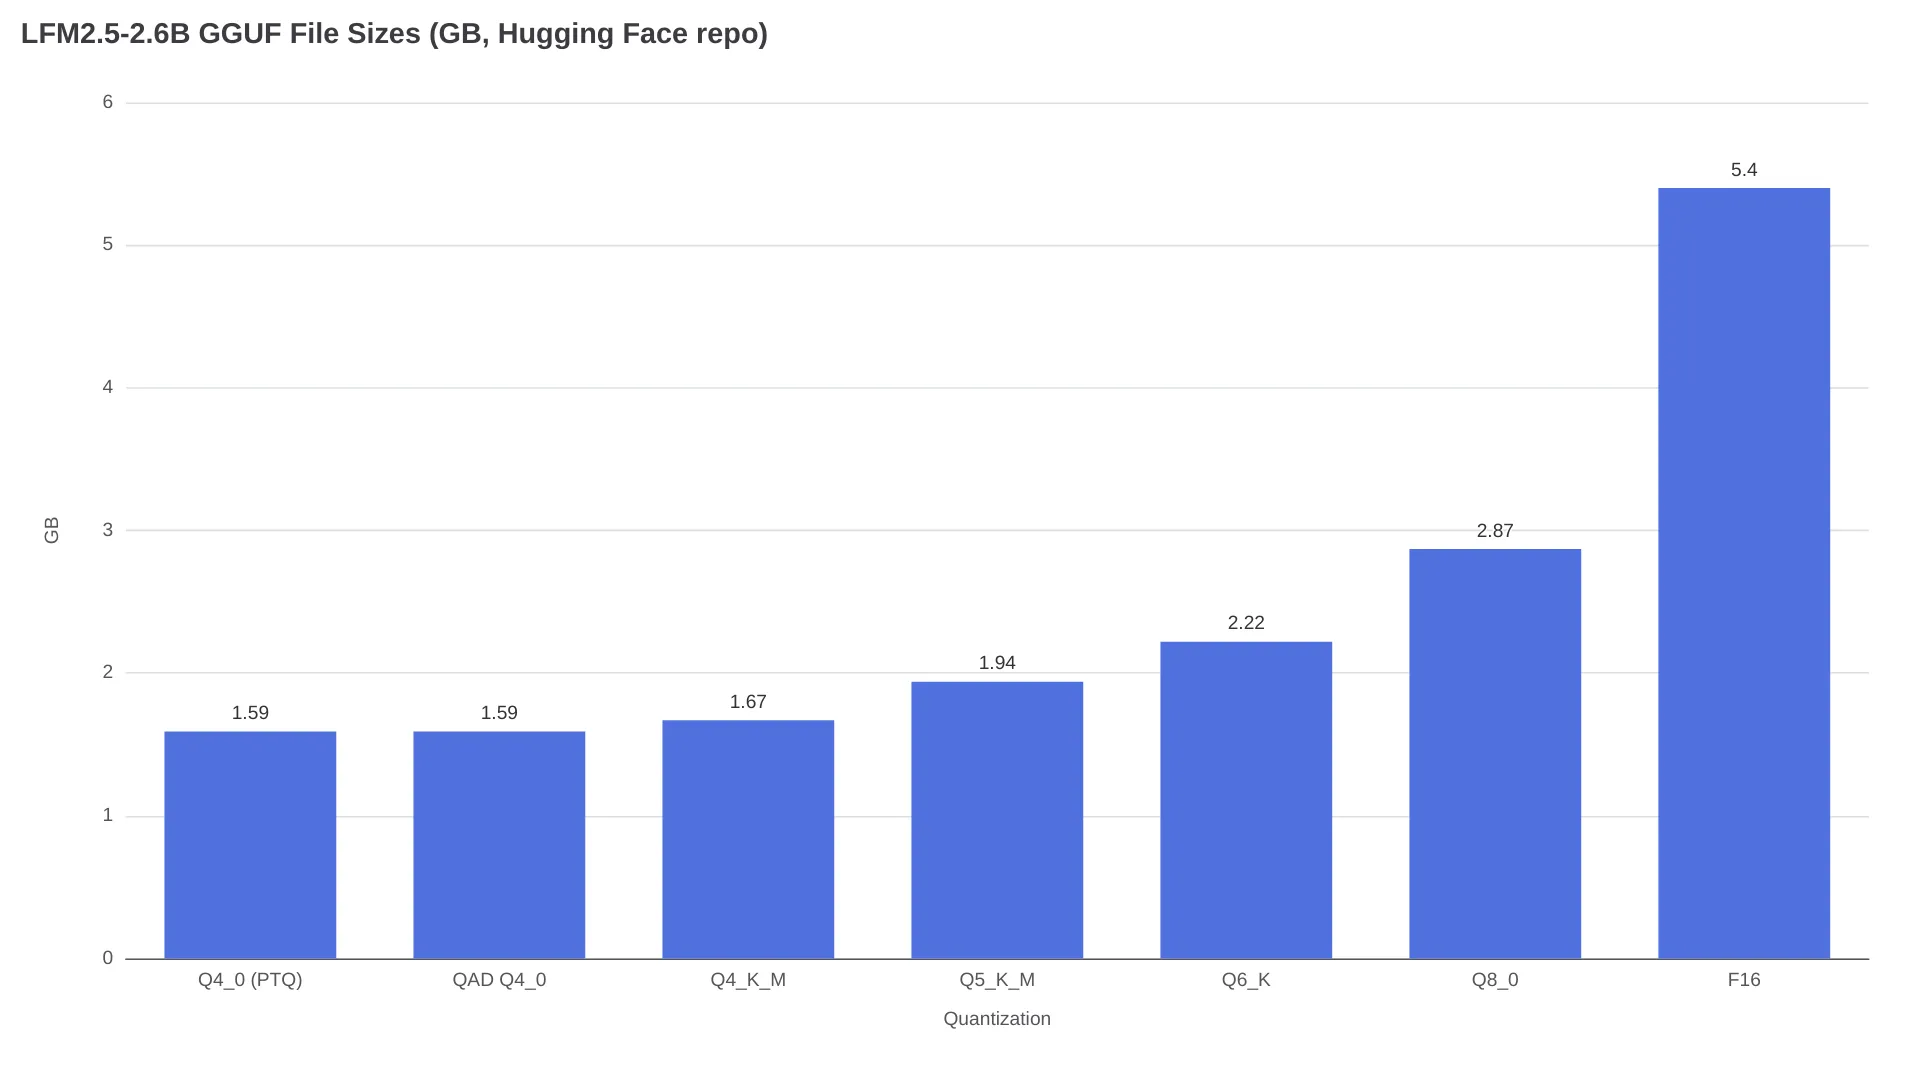
| Datei (2.6B) | Größe | Einordnung | Geeignet, wenn |
|---|---|---|---|
| Q4_0 (altes PTQ) | 1,59 GB | unkorrigierte Baseline | überspringen, QAD ist jetzt verfügbar |
| QAD Q4_0 | 1,59 GB | 96,6 % von BF16, gleichauf mit Q4_K_M | 3–4 GB RAM, CPU-Decodierung, Smartphones, Pi |
| Q4_K_M | 1,67 GB | Standardempfehlung der Liquid-Dokumentation | deine Runtime kann die QAD-Datei nicht auswählen |
| Q5_K_M | 1,94 GB | 91,4 % Top-1 gegenüber F16, laut KikoCis | 6 GB oder mehr RAM |
| Q6_K / Q8_0 | 2,22 / 2,87 GB | nahezu verlustfrei | 8 GB oder mehr, Qualität vor Speicherbedarf |
Zur Einordnung dieser Gleichwertigkeitsangaben: In der PTQ-Vergleichsreihe von KikoCis erreichte Q4_K_M bei diesem Modell eine Top-1-Token-Übereinstimmung von 84,36 % gegenüber F16. Q6_K kam auf 95,07 %, Q8_0 auf 98,23 %. Liquid AI behauptet, dass QAD die Lücke bei 4-Bit-Qualität bei gleicher Dateigröße schließt – nach den eigenen Zahlen, fünf Durchläufen und bislang ohne unabhängige Reproduktion. Eine wichtige Einordnung aus der Diskussion am Veröffentlichungstag:
„Es geht nicht darum, dass Q4_0 die K-Quants schlägt. Diese vier Checkpoints wurden für Q4_0 trainiert.“ – @MarMarLabs
Verallgemeinern solltest du das Ergebnis nicht. Q4_0-Dateien anderer Modelle sind weiterhin gewöhnliche PTQ-Quantisierungen.
Zum Speicherbedarf nennt der Launch-Beitrag keine RAM-Werte. Deshalb bleiben die Berechnungen aus dem KikoCis-Repository die beste Orientierung: Beim 2.6B-Modell benötigt der KV-Cache in f16 etwa 16 KB pro Token, rund 0,54 GB bei 32K Kontext und 2,15 GB beim nativen 128K-Fenster. Mit --cache-type-k q8_0 --cache-type-v q8_0 halbiert sich der Cache-Bedarf. Die 1,59-GB-Gewichte von QAD Q4_0 plus ein 32K-Fenster ergeben vor dem zusätzlichen Runtime-Overhead etwa 2,13 GB. Bei 128K steigt der Wert auf über 3,7 GB. 4 GB solltest du daher als knapp bemessen betrachten und die tatsächliche Speicherzuweisung auf deiner Ziel-Runtime prüfen.
FAQ
Ist QAD Q4_0 besser als Q4_K_M?
Für diese vier Checkpoints besagen die Zahlen von Liquid AI, dass QAD Q4_0 die Qualität von Q4_K_M erreicht – bei den beiden kleinsten Modellen sogar Q5_K_M – und dabei schneller decodiert sowie weniger Speicherplatz benötigt. Bei knappem RAM lautet die Antwort also: ja. Die Werte stammen aus fünf Durchläufen des Anbieters; eine unabhängige Reproduktion gibt es bislang nicht.
Wählen Ollama oder LM Studio die QAD-Datei automatisch?
Nein. Der dokumentierte Weg in Ollama lautet laut offizieller Repository-Seite ollama run hf.co/LiquidAI/LFM2.5-2.6B-GGUF:Q4_K_M. Auch die Standard-Snippets von Hugging Face zeigen auf Q4_K_M. Jede Runtime mit GGUF-Unterstützung kann die QAD-Datei laden, aber du musst sie über den exakten Dateinamen oder den Zusatz :QAD-Q4_0 auswählen.
Wie viel RAM braucht LFM2.5-2.6B QAD Q4_0?
Die Gewichte belegen 1,59 GB. Nach den Berechnungen von KikoCis benötigt der f16-KV-Cache bei 32K Kontext etwa 0,54 GB und bei 128K etwa 2,15 GB. Gewichte und Cache zusammen ergeben vor dem Runtime-Overhead ungefähr 2,13 GB bei 32K und 3,74 GB bei 128K. Eine Q8_0-Quantisierung des KV-Caches halbiert dessen Speicherbedarf.
Für welche LFM2.5-Modelle gibt es QAD-Checkpoints?
Am 19. August 2026 sind das ausschließlich LFM2.5-230M, LFM2.5-350M, LFM2.5-1.2B-Instruct und LFM2.5-2.6B. Für die Varianten VL-450M und 8B-A1B gibt es keine QAD-Checkpoints. Nutzer haben im Veröffentlichungsthread allerdings bereits nach einer 8B-Version gefragt.
Darf ich LFM2.5-QAD-Checkpoints kommerziell einsetzen?
Die Repositories sind mit LFM Open License v1.0 gekennzeichnet. Community-Repositories fassen die Bedingungen so zusammen, dass kommerzielle Nutzung für Unternehmen mit weniger als 10 Mio. USD Jahresumsatz erlaubt ist. Ab dieser Schwelle ist eine separate kommerzielle Lizenz von Liquid AI erforderlich (Zusammenfassung von KikoCis). Vor dem Produktiveinsatz solltest du den Lizenztext selbst prüfen.
Ist die 97-%-Angabe unabhängig bestätigt?
Noch nicht. Die Retentionswerte von 96,5–97,4 % sind die von Liquid AI veröffentlichten Mittelwerte aus fünf Durchläufen. Zum Zeitpunkt der Erstellung dieses Beitrags lag noch kein Benchmark einer unabhängigen Stelle für die QAD-Dateien vor; auch die Imatrix-Frage ist im r/LocalLLaMA-Subreddit weiterhin offen.
Heute Abend selbst den A/B-Test machen
Entscheidend ist nicht der Benchmark-Mittelwert, sondern die Fehlerrate bei deiner konkreten Aufgabe. Nimm zehn echte Prompts aus deinem Alltag – etwa Tool-Call-JSON, dein Extraktionsschema und deine Sprache – und lass beide Dateien mit identischen Einstellungen laufen:
llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-QAD-Q4_0.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1 \
  -p "<your prompt>"

llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-Q4_K_M.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1 \
  -p "<your prompt>"
Zähle pro Datei Parsing-Fehler und falsche Tool-Auswahlen, statt dich auf ein Bauchgefühl zu verlassen. Der Zielkonflikt bleibt real: Auf dem Papier spricht die Qualität pro Gigabyte für QAD Q4_0. In deiner Umgebung hängen die Fehlerbilder – etwa leere Antworten, wenn das Reasoning das Token-Budget auffrisst, oder Formatabweichungen bei höherer Temperatur – jedoch von Runtime und Aufgabe ab. Nur deine eigenen zehn Prompts zeigen, welchen Preis dieser Unterschied in der Praxis hat.