 AIREITER
Für Coding-Agenten mit weniger als rund 150K Token Kontext ist Hy3 meist die klügere Wahl: Der Preis pro Eingabe-Token liegt ungefähr auf Flash-Niveau, beim Reasoning ist das Modell aber etwas stärker. Werden Sitzungen länger, Repositories größer oder muss eine Produktionsumgebung viele parallele Anfragen stemmen, dreht sich das Bild zugunsten von DeepSeek V4 Flash. Entscheidend sind drei Werte, die Hy3 nicht erreicht: 1M Token Kontext, ein dokumentierter Preis von $0.0028 für Cache-Treffer und ein Concurrency-Limit von 2.500 Requests. Das ist die Kurzfassung des Vergleichs Hy3 vs. DeepSeek V4 Flash. Grundlage sind am 14. Juli 2026 geprüfte Preise aus den offiziellen DeepSeek-Dokumenten und den aktuellen OpenRouter-Listings, externe Benchmark-Daten sowie Berichte von Entwicklern auf Hacker News und Reddit, die beide Modelle täglich einsetzen.
Zwei Modelle mit unterschiedlichen Prioritäten
Tencent veröffentlichte Hy3 in der finalen Version am 6. Juli 2026. Sie löste die seit dem 23. April verfügbare Preview ab. Laut Ankündigung handelt es sich um ein Mixture-of-Experts-Modell mit 295B Parametern insgesamt und 21B aktiven Parametern. Tencent setzt auf ein „hybrides schnelles und langsames Denken“: Das Modell entscheidet pro Anfrage selbst, wie viel Reasoning-Aufwand sinnvoll ist. Das Kontextfenster endet bei 256K Token. Die Gewichte stehen unter Apache 2.0, die API läuft über Tencent Cloud TokenHub.
DeepSeek V4 Flash erschien im April 2026 als schnelle Variante der V4-Familie. Auch hier handelt es sich um ein Open-Weights-MoE-Modell, laut Artificial Analysis mit 284B Parametern insgesamt und 13B aktiven Parametern. Die MIT-Lizenz und die Ausrichtung sind jedoch anders: Flash soll 1M Token Kontext möglichst günstig bedienen. Es bietet Thinking- und Non-Thinking-Modi, wobei Thinking standardmäßig aktiv ist, und kann maximal 384K Token ausgeben.
Bei den Parameterzahlen liegen beide nah beieinander, bei den Entwicklungszielen nicht. Hy3 investiert stärker in Reasoning-Qualität pro Token, Flash in Kontextlänge, Cache-Effizienz und Durchsatz. Daraus ergeben sich die meisten praktischen Unterschiede.
| Spezifikation (geprüft am 2026-07-14) | Hy3 | DeepSeek V4 Flash |
|---|---|---|
| Parameter | 295B insgesamt / 21B aktiv | 284B insgesamt / 13B aktiv |
| Kontextfenster | 256K | 1M (384K maximale Ausgabe) |
| Reasoning | Hybrides schnelles/langsames Denken | Thinking- und Non-Thinking-Modi |
| Lizenz | Apache 2.0 | MIT |
| Veröffentlicht | 6. Juli 2026 (Preview 23. Apr.) | April 2026 |
| Offizielle API | Tencent Cloud TokenHub | api.deepseek.com (OpenAI- und Anthropic-Formate) |
Was die Benchmarks tatsächlich hergeben
Im Artificial Analysis Intelligence Index v4.1 erreicht Hy3 41 Punkte gegenüber 37 für DeepSeek V4 Flash im Reasoning-Modus mit hohem Aufwand. Vier Punkte sind in diesem Index ein spürbarer Abstand, ungefähr so groß wie der zwischen Flash und den Modellen eine Stufe darunter. Ein Klassenunterschied ist es aber nicht: Beide Modelle liegen im Bereich „sehr leistungsfähig, aber nicht Frontier“.
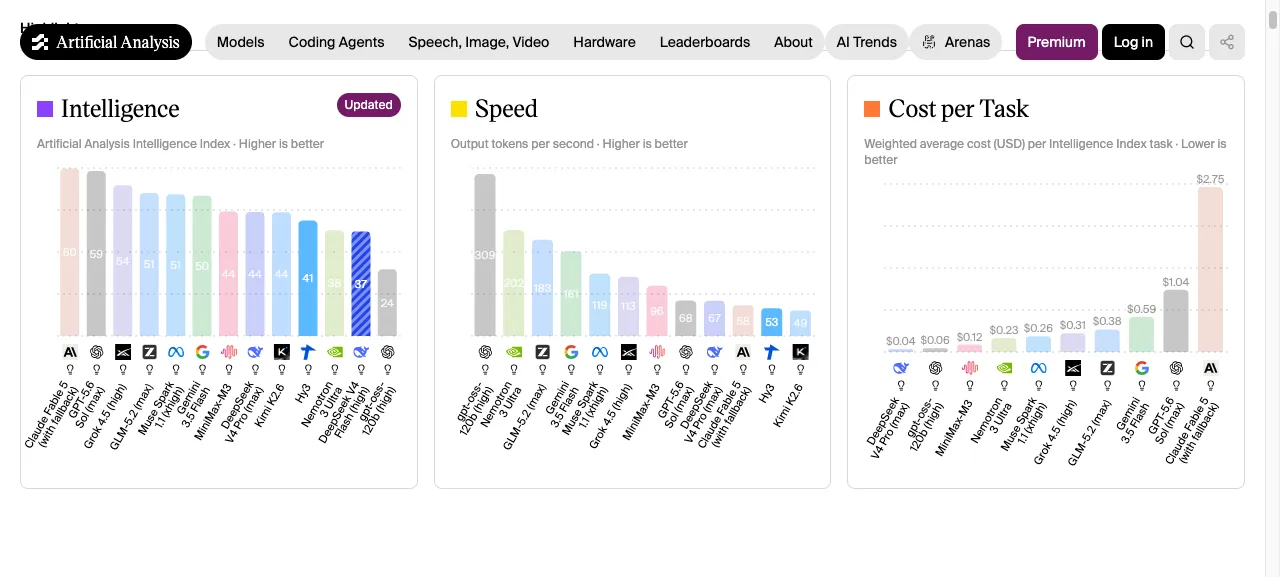
Bevor man diesem Wert zu viel Gewicht gibt, sind zwei Einschränkungen wichtig.
Erstens zeichnen agentische Coding-Benchmarks für beide Modelle ein härteres Bild. Ein Kommentator im Hacker-News-Thread zum Launch fand für Hy3 ein DeepSWE-Ergebnis von 28%, gegenüber 52% für GPT-5.4 bei maximalem Aufwand. Keines der beiden chinesischen Modelle kommt beim agentischen Coding an die Frontier heran. Sie konkurrieren miteinander, nicht mit der Spitze des Leaderboards.
Zweitens sollte man Benchmark-Tabellen, die von einem der beiden Anbieter selbst veröffentlicht werden, mit der üblichen Skepsis lesen. Hy3s Launch-Zahlen lösten im HN-Thread sofort Vorwürfe aus, das Modell sei auf Benchmarks optimiert worden. DeepSeek zeigt in seinen Tabellen naturgemäß nur Evaluierungen, die das Unternehmen selbst ausgewählt hat. Ich würde mich daher an den externen Werten oben orientieren: Hy3 ist etwas intelligenter, aber der Abstand ist klein genug, dass Preis und Kontextfenster die Entscheidung umkehren können.
Preise: Nicht der Listenpreis entscheidet
Es gibt zwei Preislisten, die am 14. Juli 2026 geprüft wurden und getrennt betrachtet werden sollten. DeepSeek nennt in seiner API-Dokumentation exakte First-Party-Preise pro Token. Tencent veröffentlicht für das finale Hy3 keine vergleichbare englische Preisliste; die Pressemitteilung beziffert Hy3 Preview auf TokenHub mit ungefähr $0.18 pro einer Million Eingabe-Token. Die Hy3-Spalte unten basiert deshalb auf den gelisteten OpenRouter-Tarifen – also auf Marketplace- statt First-Party-Preisen.
| Pro 1M Token | Hy3 (OpenRouter-Marketplace) | DeepSeek V4 Flash (First-Party-API) |
|---|---|---|
| Eingabe | $0.14 | $0.14 (Cache-Miss) |
| Eingabe, gecacht | $0.035 | $0.0028 (Cache-Hit) |
| Ausgabe | $0.58 | $0.28 |
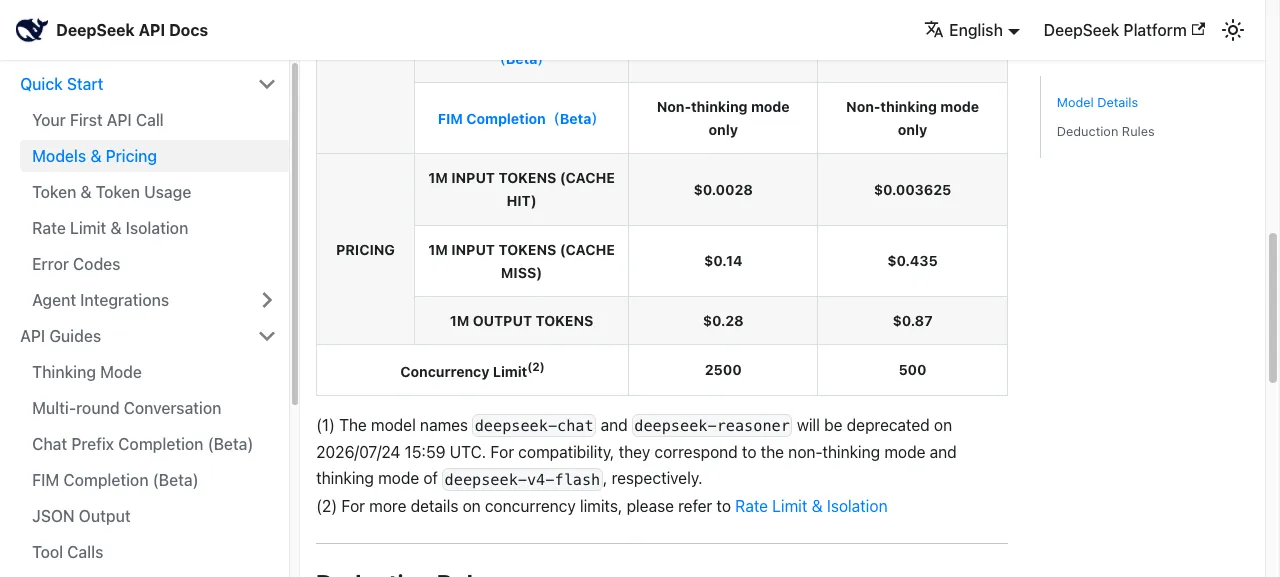
Bei den Eingabe-Tokens herrscht Gleichstand. Die Entscheidung fällt in den beiden anderen Zeilen.
Der Hebel bei Cache-Treffern
Ein Cache-Hit bei DeepSeek kostet 50-mal weniger als ein Cache-Miss und 12,5-mal weniger als ein gecachter Token bei Hy3 über OpenRouter. Die beiden Cache-Tarife sind nicht strikt vergleichbar: DeepSeek nennt einen First-Party-API-Preis, während Hy3 bei OpenRouter von den Preisen der jeweiligen zugrunde liegenden Provider abhängt. Es sind aber die Tarife, die heute tatsächlich anfallen. Für Agenten ist das wichtiger als jede andere Zahl auf dieser Seite. In einer Agent-Schleife wird pro Zug ein immer größer werdender Kontext erneut gesendet: System-Prompt, Tool-Definitionen, Datei-Inhalte und Gesprächsverlauf. Bei einer Sitzung mit 40 Zügen besteht der Großteil der Eingabe-Tokens aus Wiederholungen. Bei 90% Cache-Hit-Rate sinkt Flashs effektiver Eingabepreis von $0.14 auf rund $0.017 pro einer Million Token. Bei Hy3 fällt er auf etwa $0.045. Das ist weiterhin günstig, aber fast dreimal so viel – und der Unterschied wächst mit der Sitzungsdauer.
Bei Ausgabe-Tokens wird Hy3 teuer
Beide sind Reasoning-Modelle und rechnen ihre Thinking-Tokens daher als Ausgabe ab. Hy3 verlangt $0.58 für Output, Flash $0.28. Längere Reasoning-Ketten kosten bei Hy3 also ungefähr doppelt so viel. Flash hat außerdem eine Option, die Hy3 fehlt: Für mechanische Aufgaben wie Formatierung, Extraktion oder einfache Änderungen lässt sich in den Non-Thinking-Modus wechseln. Dann bezahlt man nicht für Reasoning, das nicht benötigt wird. Der Vergleich deepseek-v4-flash-vs-deepseek-v4-pro erklärt, wie dieser Moduswechsel in der Praxis funktioniert.
Der kostenlose Tarif
Hier hat Hy3 einen echten Vorteil: OpenRouter führt die Variante tencent/hy3:free kostenlos. Sie ist rate-limitiert, aber real nutzbar. Zum Testen vor einer Festlegung ist das besser als Flash, das keinen kostenlosen API-Tarif hat. Hy3 Preview ist weiterhin für $0.063/$0.21 gelistet und damit günstiger als die finale Version – sofern der Checkpoint vom April genügt.
Der Preis eines kleineren Kontextfensters
256K Token Kontext klingen großzügig, bis ein Agent mit einer echten Codebasis arbeitet. Ein Reddit-Nutzer in r/hermesagent, der beide Modelle im selben Harness einsetzte, beschrieb Hy3 als „fast identisch, abgesehen von der Kontextgröße – daher häufige Komprimierung“. Das ist mehr als lästig: Jeder Komprimierungszyklus verbraucht Ausgabe-Tokens für Zusammenfassungen, verliert Details und invalidiert den Prompt-Cache. Anschließend wird zum Cache-Miss-Preis wieder aufgebaut.
Beim Self-Hosting wird die Lücke strukturell. Die Sparse-Attention-Architektur von V4 – DeepSeek nennt den Mechanismus „lightning indexer“ – macht den KV-Cache deutlich leichter als bei Hy3 mit konventioneller Attention. Das sind Einzelberichte und keine Benchmarks, doch die Zahlen im HN-Thread sind deutlich: Ein Kommentator, der beide Modelle auf einem Paar DGX Sparks betreibt, berichtete von 3M Token KV-Cache neben DeepSeek V4 Flash, gegenüber ungefähr 130K Token mit auf FP4 quantisiertem Hy3. Ein anderer schätzte, dass Flash mit vollständiger llama.cpp-Unterstützung für den Indexer für den vollen 1M-Kontext nur etwa 6GB RAM benötigen sollte. Flash hat zudem gezeigt, dass es starke Quantisierung gut übersteht: Mehrere Nutzer im selben Thread berichten von kohärenten Ergebnissen selbst bei 2 Bit. Für Hy3 wurde das bislang nicht demonstriert.
Bleibt der Anwendungsfall deutlich unter 200K Token, verursacht dieser Punkt keine zusätzlichen Kosten – und die vier Intelligence-Punkte Vorsprung von Hy3 gibt es gratis dazu. Darüber summiert sich die Kontextsteuer: mehr Komprimierung, mehr Cache-Invalidierungen und mehr Speicherbedarf pro Sitzung.
Erfahrungen aus dem Alltag seit dem Launch
Das aufschlussreichste Signal findet sich nicht in Benchmark-Tabellen, sondern in den Charakterunterschieden, die Entwickler beim Einsatz beider Modelle in Coding-Agenten beschreiben.
Ein Nutzer im selben Hacker-News-Thread wechselte nach der Kündigung seines Anthropic-Abonnements zu DeepSeek V4 Flash und Pro als tägliche Modelle und testete später Hy3. Über Flash schrieb er: Die Geschwindigkeit sei hervorragend, aber es baue „oft ein völlig falsches mentales Modell auf und läuft dann in die falsche Richtung“, weshalb regelmäßige Korrekturen und Komprimierung des Verlaufs nötig seien. Hy3 sei nach seiner Erfahrung „nicht so schnell, bleibt bislang aber viel zuverlässiger auf Kurs“ und verliere bei wachsendem Kontext weniger an Qualität. Andere Teilnehmer desselben Threads lobten bei Hy3 zudem Weltwissen und Textqualität gegenüber Flash in dieser Modellgröße.
Bei rohem Coding-Output neigt das Reddit-Bild eher zu Flash. Ein Vergleich derselben Aufgabe in r/LLMDevs ordnete „DeepSeek V4 Flash > Hy3 > GLM“ ein, nannte Hy3 aber weiterhin „vielversprechend für praktische Coding-Workflows“. In r/opencode wiederholt sich die Einschätzung, Flash sei für alltägliche Agent-Aufgaben „mehr als ausreichend“.
Auch die Betriebserfahrung zählt. Die Nachfrage zum Hy3-Launch überstieg Tencents Serving-Kapazität: Nutzer im HN-Thread berichteten von starken Rate Limits. Einer, der die öffentlichen Nutzungsrankings von OpenRouter verfolgt, beobachtete innerhalb eines Monats einen Absturz des Modells von der Spitze auf Platz 8–9 und führte diesen direkt auf die Limits zurück. DeepSeek dokumentiert dagegen für Flash in der offiziellen API ein Concurrency-Limit von 2.500 Requests – das Fünffache dessen, was für V4 Pro erlaubt ist. Für Produktionsverkehr hat einer der beiden Anbieter veröffentlichte Kapazitätsgarantien, der andere eine Vorgeschichte mit Engpässen.
Welches Modell passt zu welchem Einsatz?
- Agentisches Coding, Sitzungen unter etwa 150K Token: Hy3. Höhere Reasoning-Qualität, zuverlässigeres Arbeiten an der Aufgabe und derselbe Eingabe-Listenpreis wie Flash. Die Grenze liegt bei 150K statt bei vollen 256K, weil Agent-Kontext schnell wächst und vor der ersten Komprimierung Reserven nötig sind.
- Lange Sitzungen, große Repositories, RAG über umfangreiche Dokumente: Flash ist meist die bessere Wahl. Das 1M-Fenster samt 50-fachem Cache-Rabatt spielt in einer anderen Kostenklasse, während Hy3s Komprimierungsaufwand seinen Intelligenzvorsprung aufzehrt.
- Produktions-APIs mit hohem Volumen: Flash. Dokumentierte Concurrency von 2.500, eine stabile Serving-Historie und ein Non-Thinking-Modus für günstige Bulk-Aufrufe.
- Texte, Recherche und Aufgaben mit Weltwissen: Hy3. Sowohl Community-Berichte als auch die AA-Wissens-Evaluierungen sehen es in dieser Modellgröße vorn.
- Lokale Bereitstellung: Flash für die meiste Hardware. Für dessen KV-Cache-Effizienz und Quantisierungsrobustheit gibt es wesentlich mehr Praxiserfahrungen; Tencents eigene Serving-Empfehlung für Hy3, die im Launch-Thread zitiert wird, lautet acht GPUs der H20-Klasse.
- Test vor der Festlegung: Hy3s kostenloser OpenRouter-Tarif lässt sich ohne Kosten ausprobieren. Die eigenen Aufgaben damit zu testen, ist sinnvoller als jeder Benchmark-Tabelle blind zu vertrauen – auch dieser hier.
Wo sich die Modelle nutzen lassen
DeepSeek V4 Flash: Die offizielle API bietet Endpunkte im OpenAI-Format unter api.deepseek.com und im Anthropic-Format unter api.deepseek.com/anthropic. Damit lässt sich das Modell mit einer Änderung der Base-URL in Claude-kompatible Tools einhängen. Wichtig ist die auf derselben Preisseite genannte Migrationsfrist: Die alten Modellnamen deepseek-chat und deepseek-reasoner werden am 24. Juli 2026 eingestellt und entsprechen dann Flashs Non-Thinking- beziehungsweise Thinking-Modus. OpenRouter führt Flash für $0.09/$0.18, also leicht unter dem offiziellen Tarif, allerdings ohne die Cache-Hit-Preise der offiziellen API.
Hy3: Tencent Cloud TokenHub ist der First-Party-Weg. OpenRouter führt die finale Version, den günstigeren Preview-Checkpoint und den kostenlosen Tarif. SiliconFlow bot zum Start Promotions an. Unter Apache 2.0 ist auch Self-Hosting möglich, wenn die nötigen GPUs vorhanden sind. Der Hy3 API setup guide zeigt, wie sich ein Key beschaffen und der erste Aufruf durchführen lässt.
FAQ
Ist Hy3 kostenlos nutzbar?
Teilweise. OpenRouter listet den rate-limitierten Tarif tencent/hy3:free kostenlos. Auch Tencents Consumer-Produkte Yuanbao und ima verwenden Hy3 ohne Gebühr. Produktionszugang per API über TokenHub oder den kostenpflichtigen OpenRouter-Tarif wird dagegen pro Token abgerechnet.
Ist Hy3 dasselbe wie Tencent Hunyuan?
Ja. Hy3 ist die dritte Generation von Tencents Hunyuan-Modellreihe, die Tencent inzwischen als „Tencent Hy“ vermarktet. Die Preview startete am 23. April 2026, die finale Veröffentlichung folgte am 6. Juli 2026.
Was eignet sich besser fürs Coding: Hy3 oder DeepSeek V4 Flash?
Die Community-Ergebnisse unterscheiden sich je nach Aufgabenform. Reddit-Vergleiche mit derselben Aufgabe stuften den rohen Output von Flash über Hy3 ein, während Nutzer von Agenten mit langen Sitzungen berichten, Hy3 bleibe zuverlässiger bei der Aufgabe. Kurze, klar abgegrenzte Aufgaben profitieren von Flashs Tempo. Bei mehrstündigen Agent-Sitzungen, in denen ein Abdriften teuer wird, spricht mehr für Hy3 – solange der Kontext bequem innerhalb seines 256K-Fensters bleibt.
Kann ich DeepSeek V4 Flash lokal ausführen?
Ja, und praktischer als Hy3. Die Gewichte stehen unter MIT-Lizenz, der KV-Cache der Architektur ist ungewöhnlich schlank, und Nutzer berichten selbst bei 2-Bit-Quantisierung auf Maschinen mit rund 96GB RAM von brauchbarer Qualität.
Warum ist der Preisvergleich Hy3 vs. DeepSeek V4 Flash so unübersichtlich?
Weil mindestens vier Preislisten im Spiel sind: Tencent TokenHub, die OpenRouter-Listings für Hy3 final und Preview sowie DeepSeeks offizielle API mit einem separaten Cache-Hit-Tarif. Entscheidend ist der effektive Preis für das eigene Traffic-Muster. Bei Agent-Workloads dominieren gecachte Eingaben – und dort ist DeepSeeks Tarif von $0.0028 schwer zu schlagen.
Fazit
Nach den verfügbaren externen Daten ist Hy3 das stärkere Modell; DeepSeek V4 Flash ist der stärkere Dienst. Für Produktions-API-Workloads wäre Flash meine Standardwahl: Cache-Ökonomie, Kontextfenster und veröffentlichte Concurrency verstärken sich auf eine Weise, die ein Benchmark-Vorsprung von vier Punkten nicht ausgleicht. Hy3 passt besser, wenn Reasoning-Qualität pro Prompt wichtiger ist als Skalierung. Der kostenlose Tarif sollte dabei der erste Test sein, denn der Abgleich mit den eigenen Aufgaben kostet nichts.