 AIREITER
Im Subreddit r/codex taucht immer wieder dieselbe Frage auf: „Ich habe GPT-5.5 auf extra-high genutzt – entspricht das bei 5.6 eher Sol oder Terra?“ Die Kurzfassung: GPT-5.6 Sol hat exakt dieselben API-Listenpreise wie GPT-5.5, schneidet bei Agent-Benchmarks aber besser ab. Für lang laufende Agenten und Browsing-Aufgaben ist das Upgrade damit fast kostenlos.
Ganz so einfach ist „gleicher Preis“ allerdings nicht. Sol berechnet Cache-Schreibvorgänge, die bei GPT-5.5 gratis waren. Zudem denkt das Modell länger nach. Der Tarif bleibt zwar unverändert, die Kosten pro Aufgabe können sich dennoch vervielfachen.
Gleicher Tarif, andere Kostenstruktur
GPT-5.6 Sol und GPT-5.5 haben bei der Standard-API dieselben Preise: $5.00 pro Million Input-Token, $30.00 pro Million Output-Token und $0.50 für gecachten Input. Beide Einträge habe ich am 29. Juli 2026 auf der OpenAI-Preisseite geprüft:
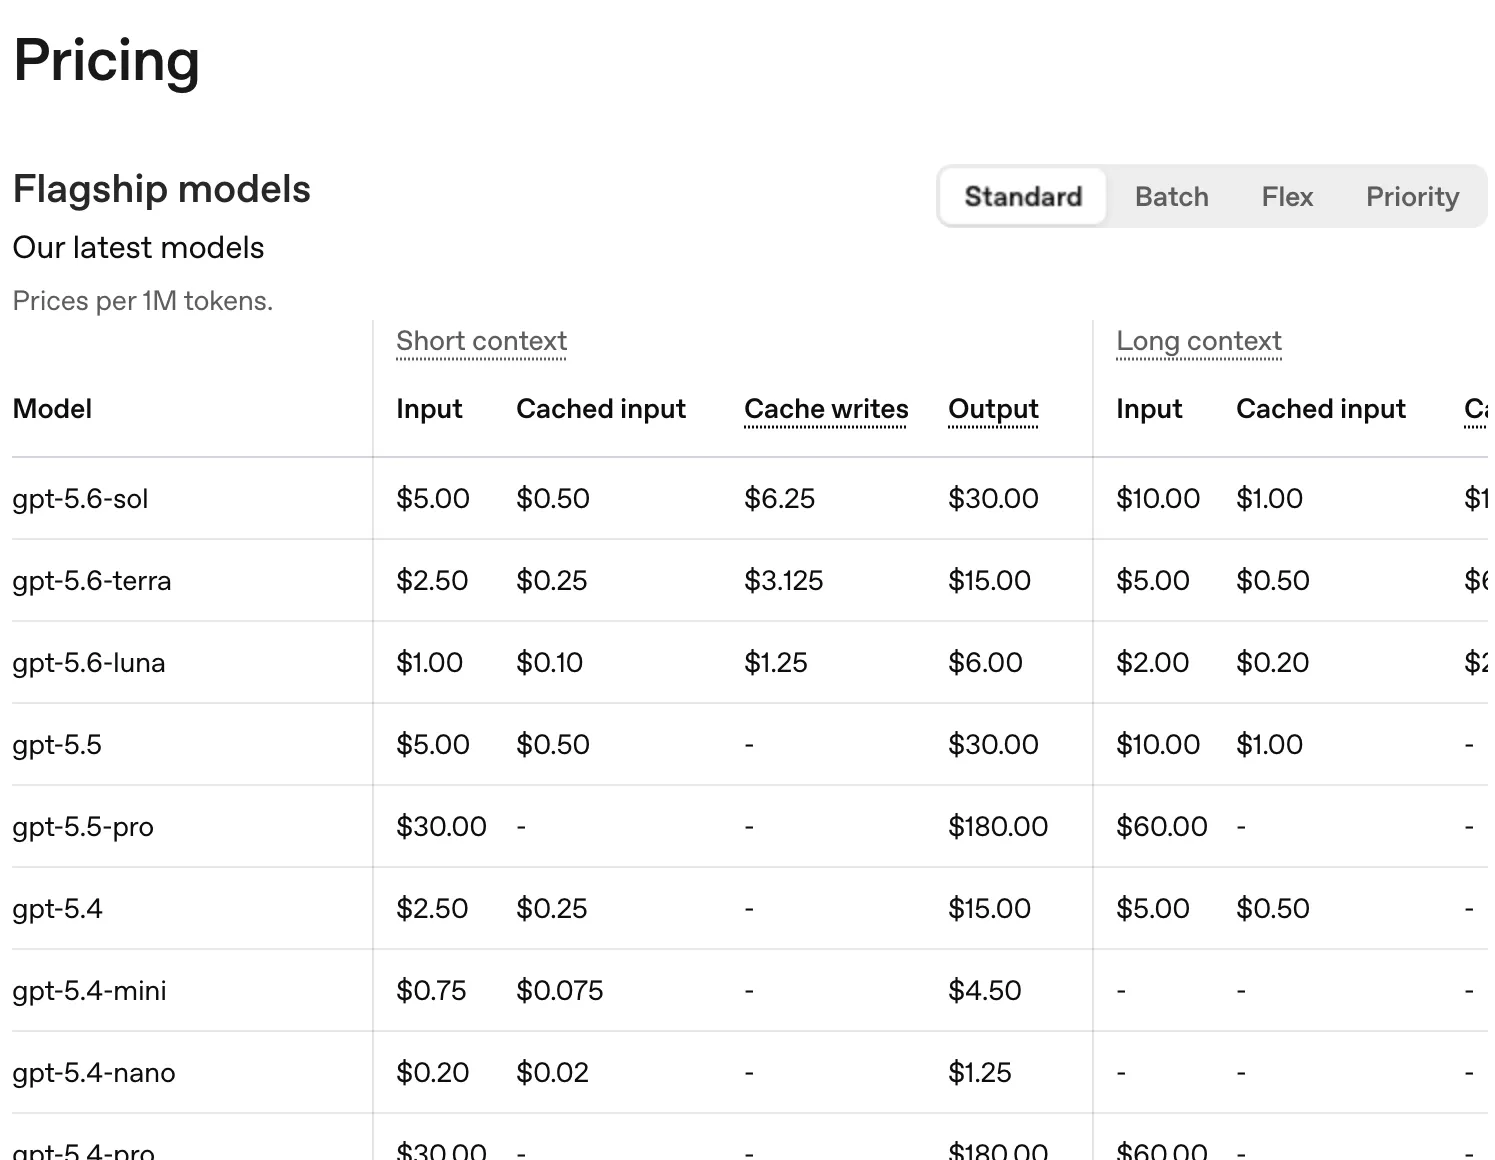
Drei Positionen in der Tabelle unterscheiden die Modelle:
| Position | GPT-5.6 Sol | GPT-5.5 |
|---|---|---|
| Input / Output (pro 1 Mio. Token) | $5.00 / $30.00 | $5.00 / $30.00 |
| Gecachter Input | $0.50 | $0.50 |
| Cache-Schreibvorgänge | $6.25 | nicht berechnet |
| Langer Kontext (>272K) Input / Output | $10.00 / $45.00 | $10.00 / $45.00 |
Bei Migrationen ist vor allem die Zeile für Cache-Schreibvorgänge relevant. GPT-5.6 führt explizite Cache-Breakpoints mit einer Mindestlaufzeit von 30 Minuten ein; Vellums Aufschlüsselung erklärt die Mechanik. Das Schreiben kostet das 1,25-Fache des ungecachten Input-Preises, während Lesezugriffe weiter mit 90% Rabatt abgerechnet werden. Konkret aus der Tabelle: Ein gecachtes Segment kostet $6.25 beim Schreiben und $0.50 je Lesezugriff, während ein erneutes ungecachtes Senden $5.00 kostet. Ab der zweiten Wiederverwendung rechnet sich Caching. Eine Pipeline, die öfter schreibt als liest, zahlt dagegen eine Gebühr, die GPT-5.5 nie erhoben hat.
Der zweite Kostenfaktor hängt an der Denkzeit. Sol nimmt sich vor der Antwort mehr Zeit fürs Reasoning, und Reasoning-Token werden als Output abgerechnet. Codex-Nutzer, die migriert sind, berichten genau davon:
„5.6 sol medium ist dreimal so teuer wie 5.5-xhigh, liefert aber dieselbe Codequalität – zumindest zum Launch von 5.5.“ — r/codex, „GPT 5.5 and 5.6 conversion table“
Gleicher Tarif, dreifache Kosten pro Aufgabe – weil das Modell dreimal so viele Token verbraucht, um zum Ergebnis zu kommen. OpenAIs Ankündigung zu GPT-5.6 nennt zugleich 22% weniger Input- und 23% weniger Output-Token als bei GPT-5.5 in internen Vergleichen. Beides kann gleichzeitig stimmen: Die Effizienz pro Denkschritt ist gestiegen, doch hohe Effort-Stufen denken deutlich länger nach. Was in der Praxis ankommt, hängt also von der gewählten Effort-Stufe ab.
Was sich laut Benchmarks wirklich verbessert hat
Bei der reinen Modellintelligenz liegen GPT-5.6 Sol und GPT-5.5 in unabhängigen Auswertungen fast gleichauf: Artificial Analysis bewertet Sol auf medium mit 54 Punkten im Intelligence Index v4.1, GPT-5.5 auf high mit 53 Punkten. Die gewichteten Kosten sind mit $4.35 pro Million Token identisch. Die wesentlichen Fortschritte liegen an anderer Stelle:
- Zeit bis zum ersten Token: Sol benötigt 4.13 Sekunden, GPT-5.5 auf high 16.67 Sekunden – ein Faktor 4. Bei interaktiven Tools und Agent-Schleifen mit Dutzenden aufeinanderfolgenden Calls ist das im Alltag die deutlichste Verbesserung.
- Agent-Benchmarks: Sol erreicht 88.8% bei Terminal-Bench 2.1 und 92.2% bei BrowseComp. Die größten Fortschritte dieses Releases zeigen sich bei lang laufender Tool-Nutzung.
- Kontextfenster: Sol bietet 1 Mio. Token statt 922K bei GPT-5.5. Hinzu kommt Reasoning, das über Gesprächsrunden hinweg erhalten bleibt, wie in der oben verlinkten Vellum-Analyse dokumentiert.
- Output-Geschwindigkeit: Hier gibt es den Rückschritt. Sol streamt mit 65 Token/Sekunde, GPT-5.5 mit 77.3. Bulk-Generierung wird also langsamer statt schneller.
In der Long-Horizon-Coding-Suite von CodeRabbit mit mehr als 100 Aufgaben in fünf Sprachen erreicht Sol eine Erfolgsquote von 63.7%. Beim Code-Review-Benchmark findet Sol gegenüber einer Basisintegration 7.4 Prozentpunkte mehr. Es gibt jedoch einen Haken: Die gemessene Präzision der Reviews liegt bei 31.6%. Sol entdeckt also mehr echte Probleme, erzeugt aber auch mehr Rauschen. Dieselben Tester beobachteten, wie Sol bei einer einfachen Änderung acht Runden lang einem falschen Ansatz folgte. Stark bei Marathonaufgaben heißt nicht immun gegen Sackgassen.
Drei identische Prompts im Direktvergleich
Benchmarks belohnen Aufgaben mit langem Horizont, die meisten API-Calls sind jedoch kurz. Deshalb habe ich am 29. Juli 2026 dieselben drei Prompts an gpt-5.6-sol und gpt-5.5 geschickt: einen Bugfix für die Datumshandhabung in Python, ein Logikrätsel mit exakt zwei gültigen Lösungen sowie eine strikte JSON-Extraktion mit Falle. Dabei fehlte bei einem Datum das Jahr, das gemäß Regel zu null werden musste und nicht geraten werden durfte. Pro Aufgabe gab es jeweils einen API-Call, Standard-Reasoning-Effort, keine Tools und keine Wiederholungen. Das ist eine kleine Stichprobe, kein Benchmark.
Beide Modelle lösten alle drei Aufgaben. GPT-5.5 behob den Dezember-Crash mit calendar.monthrange; Sol implementierte selbst eine korrekte Schaltjahr-Tabelle. Beide fanden exakt die zwei zulässigen Deployment-Reihenfolgen, lieferten bei der Extraktion byte-identisches JSON und erfanden für „den 14. Juli“ kein Jahr.
Bei Tokenverbrauch und Geschwindigkeit zeigte sich ein gemischtes Bild:
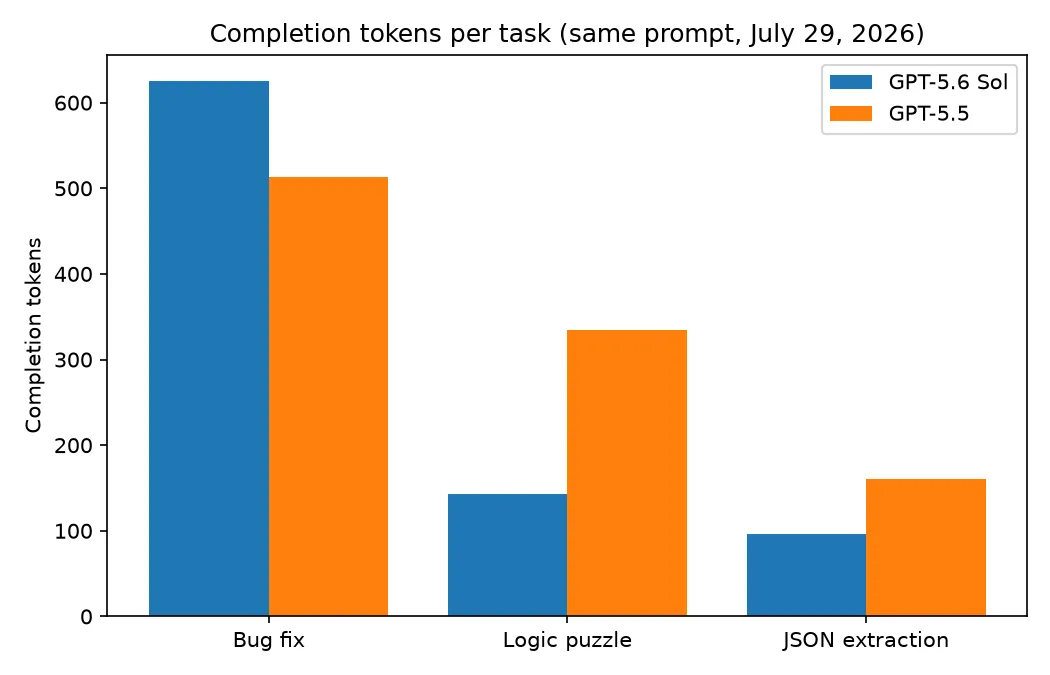
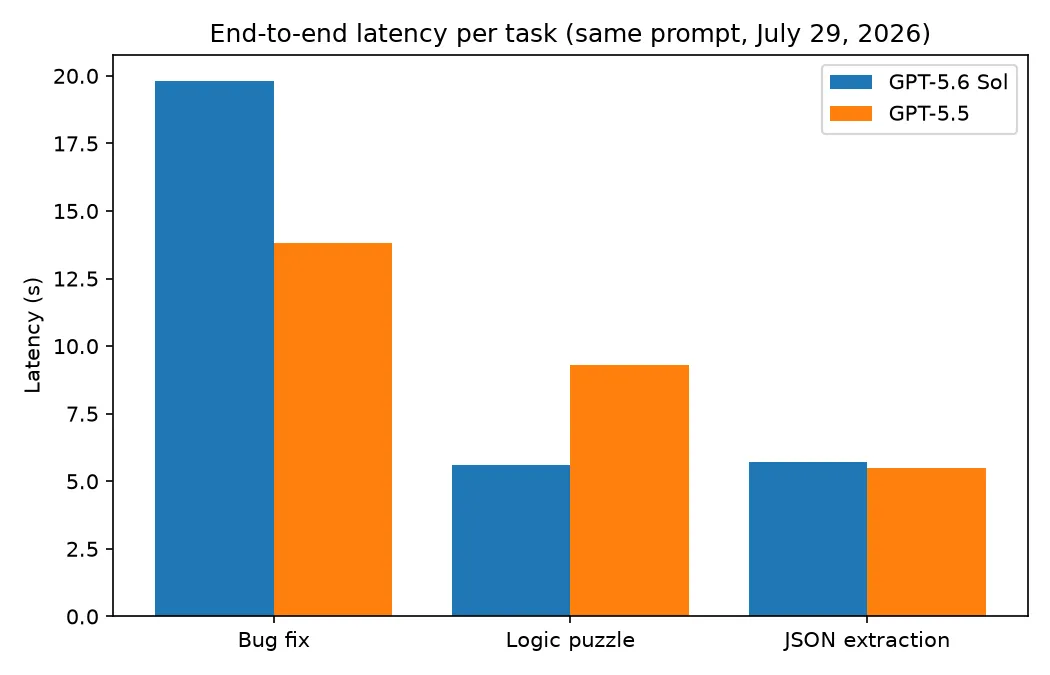
Über alle Aufgaben verbrauchte Sol weniger Completion-Token, 864 gegenüber 1,007, war beim Code-Task aber langsamer und ausführlicher: 19.8 Sekunden und 625 Token gegenüber 13.8 Sekunden und 513. Beim Logikrätsel drehte sich das Bild: Sol antwortete nach 5.6 Sekunden mit 143 Token, GPT-5.5 brauchte 9.3 Sekunden und 334 Token. Mein Eindruck nach dem Vergleich: Bei kurzen, klar spezifizierten Aufgaben sind beide Modelle austauschbar. Dieser Test allein wäre kein Grund für eine Migration. Das Argument für das Upgrade liegt vollständig bei den Agent- und Langkontext-Aufgaben aus dem Benchmark-Abschnitt.
Welche GPT-5.5-Effort-Stufe entspricht 5.6?
Die Modell-ID gpt-5.6 verweist laut der oben verlinkten Vellum-Aufschlüsselung standardmäßig auf gpt-5.6-sol. Wer beim Upgrade einfach nur den Alias austauscht, landet also beim Flaggschiff – und dessen Kostenstruktur –, ohne es bewusst ausgewählt zu haben. Für eine gezielte Migration sind drei Punkte entscheidend:
- GPT-5.5 xhigh → Sol medium gilt in der Community als praktikable Zuordnung. Der oben zitierte r/codex-Bericht sah bei vergleichbarer 5.5-Qualität rund dreifache Kosten pro Aufgabe zum Launch. Das ist eine Arbeitshypothese, die Sie mit Ihren eigenen Prompts prüfen sollten, keine Garantie. Preisbewusste Workloads, die bisher auf 5.5 high liefen, liegen wirtschaftlich näher bei GPT-5.6 Terra mit $2.50/$15 – der Hälfte von Sols Tarif.
- Auf der höchsten Stufe wächst die Denkzeit stark. ChatGPT-Pro-Nutzer berichten, dass GPT-5.6 für Aufgaben 20–50 Minuten benötigt, für die 5.5 Pro 5–10 Minuten brauchte. Das ist eine Beobachtung aus ChatGPT, aber derselbe Reasoning-Stack wird in der API als Output-Token abgerechnet. Die Einstellung
reasoning.mode: "pro"ist bei allen drei 5.6-Tiers verfügbar; die Obergrenze wird also bewusst aktiviert. - Alte Prompts können das neue Modell ausbremsen. Das Testteam von Every.to stellte fest, dass Sol deutlich bessere Ergebnisse lieferte, nachdem es defensive Anweisungen für ältere Modelle entfernt hatte. Regeln wie „prüfe X immer doppelt“ verleiten Sol zu übermäßiger Kontrolle und unnötig komplexen Lösungen. Nach der Modellmigration sollte deshalb auch der System-Prompt überprüft werden: Das Sicherheitsgerüst, das GPT-5.5 brauchte, wird nun zum Kostenfaktor.
Für wen sich der Wechsel lohnt – und für wen nicht
Wechseln Sie zu GPT-5.6 Sol, wenn Ihr Workload agentisch ist: mehrstufige Tool-Nutzung, Browsing-Recherche oder Coding-Sessions über ganze Repositories hinweg. Dort spielen die 88.8% bei Terminal-Bench und 92.2% bei BrowseComp ihre Stärke aus, und die um Faktor 4 niedrigere Zeit bis zum ersten Token summiert sich über jede Schleifeniteration. Bei demselben $5/$30-Tarif kostet der Fähigkeitssprung zunächst nichts extra – sofern zusätzliche Reasoning-Token und Cache-Schreibvorgänge den Vorteil nicht aufzehren. Das Kontextfenster von 1 Mio. Token und persistentes Reasoning über Gesprächsrunden hinweg beseitigen zudem zwei Workarounds, die 5.5-Pipelines bisher benötigten.
Bleiben Sie vorerst bei GPT-5.5, wenn Ihr Traffic aus kurzen, klar definierten Calls besteht: Extraktion, Klassifikation, einmalige Bugfixes oder Generierung in hohen Volumina. Mein Test mit drei Prompts sah bei genau diesem Aufgabenprofil keinen Qualitätsunterschied, während Sol beim Streaming langsamer ist: 65 statt 77.3 Token pro Sekunde. Bulk-Jobs werden damit eindeutig schlechter. Pipelines mit vielen Cache-Schreibvorgängen sollten die $6.25-Position vor einem Wechsel unbedingt einpreisen. Und falls ein Upgrade bei ähnlicher Qualität vor allem die Rechnung senken soll, lautet die Antwort Terra, nicht Sol.
Meinen Direktvergleich habe ich über AIReiter durchgeführt. Dort stehen gpt-5.6-sol und gpt-5.5 hinter einem API-Key bereit. Für einen A/B-Test muss also nur der Modell-String ausgetauscht werden – vergleichen Sie Erfolgsquote, End-to-End-Latenz und Completion-Token pro Aufgabe auf Ihrem eigenen Traffic.
FAQ
Ist GPT-5.6 Sol besser als GPT-5.5?
Bei Agent-Aufgaben klar: 88.8% bei Terminal-Bench 2.1, 92.2% bei BrowseComp und eine viermal niedrigere Zeit bis zum ersten Token. Bei kurzen Einzelaufgaben liegen die Modelle in unabhängigen Scores nur einen Punkt auseinander, 54 zu 53 bei Artificial Analysis. Auch meine Tests mit identischen Prompts zeigten keinen Unterschied bei der Korrektheit.
Kostet GPT-5.6 Sol mehr als GPT-5.5?
Der Listenpreis ist identisch: $5 für Input und $30 für Output pro Million Token. Sol berechnet zusätzlich $6.25 für Cache-Schreibvorgänge, die GPT-5.5 nie berechnet hat. Bei höheren Effort-Stufen verbraucht Sol zudem mehr Reasoning-Token pro Aufgabe; r/codex-Nutzer maßen bei vergleichbarer Qualität zu 5.5 xhigh rund dreifache Kosten pro Aufgabe.
Was entspricht GPT-5.5 xhigh bei GPT-5.6?
Sol mit medium Effort liefert vergleichbare Codequalität bei etwa dreifachen Kosten pro Aufgabe. Wenn Kostenparität wichtiger ist als die maximale Leistungsgrenze, ist Terra wirtschaftlich die nähere Entsprechung.
Kann ich GPT-5.5 nach dem Upgrade weiter nutzen?
Ja. GPT-5.5 steht weiterhin zu unveränderten Tarifen auf OpenAIs Preisseite, geprüft am 29. Juli 2026 – siehe Screenshot oben. Eine Migration wird also noch nicht erzwungen.
Die Entscheidung auf einen Blick
| Ihr Workload | Empfehlung | Entscheidender Punkt |
|---|---|---|
| Mehrstufige Agenten, Browsing, Coding auf Repository-Ebene | GPT-5.6 Sol | 88.8% Terminal-Bench, viermal niedrigere Zeit bis zum ersten Token, gleicher Tarif |
| Kurze Extraktion / Klassifikation / einmalige Bugfixes | GPT-5.5 (vorerst) | Gleichstand in Tests mit identischen Prompts; 5.5 streamt 19% schneller |
| Viele Prompt-Cache-Schreibvorgänge | GPT-5.5 oder erst Architektur anpassen | Sols Gebühr von $6.25/1 Mio. Token für Cache-Schreibvorgänge ist neu |
| Ähnliche Qualität, niedrigere Rechnung | GPT-5.6 Terra | $2.50/$15, halb so teuer wie Sol; siehe den obigen Vergleich Terra vs. 5.5 |
| Maximale Reasoning-Tiefe | Sol mit reasoning.mode: "pro" | 20–50 Minuten Denkzeit, wo 5.5 5–10 benötigte |