 AIREITER
In 1.715 Codex-Sitzungen verbrauchte GPT-5.6 Sol durchschnittlich 16,45 Millionen Tokens pro Sitzung. Das sind 2,25x so viele wie die 7,30 Millionen Tokens von GPT-5.5, ermittelt über ein vergleichbares Zeitfenster mit 1.667 Sitzungen. Der Preis je Token bleibt gleich, der Verbrauch liegt aber bei mehr als dem Doppelten. Hinzu kommt ein dokumentierter Fehler in der Responses API, der die abgerechneten output_tokens bei Sol offenbar um das Sechsfache oder mehr aufbläht. Wirkt Ihre GPT-5.6-Rechnung falsch, liegt das wahrscheinlich nicht an Ihnen.
So viele Tokens verbraucht GPT-5.6 Sol tatsächlich
Entwickler Vincent Schmalbach hat den Tokenverbrauch erfasst und dabei zwei 14-Tage-Zeiträume mit Codex-Nutzung verglichen: GPT-5.5 xhigh gegen GPT-5.6 Sol xhigh bei nahezu identischer Sitzungszahl.
| Kennzahl | GPT-5.5 xhigh | GPT-5.6 Sol xhigh |
|---|---|---|
| Sitzungen | 1.667 | 1.715 |
| Tokens gesamt | 12,17 Mrd. | 28,22 Mrd. |
| Tokens pro Sitzung | 7,30 Mio. | 16,45 Mio. |
Die Zahl der Sitzungen stieg um 2,9 %. Die Tokens pro Sitzung legten um 125 % zu. Der Gesamtverbrauch sprang von 12,17 Milliarden auf 28,22 Milliarden Tokens – das 2,32-Fache bei grob vergleichbarer Arbeitslast.
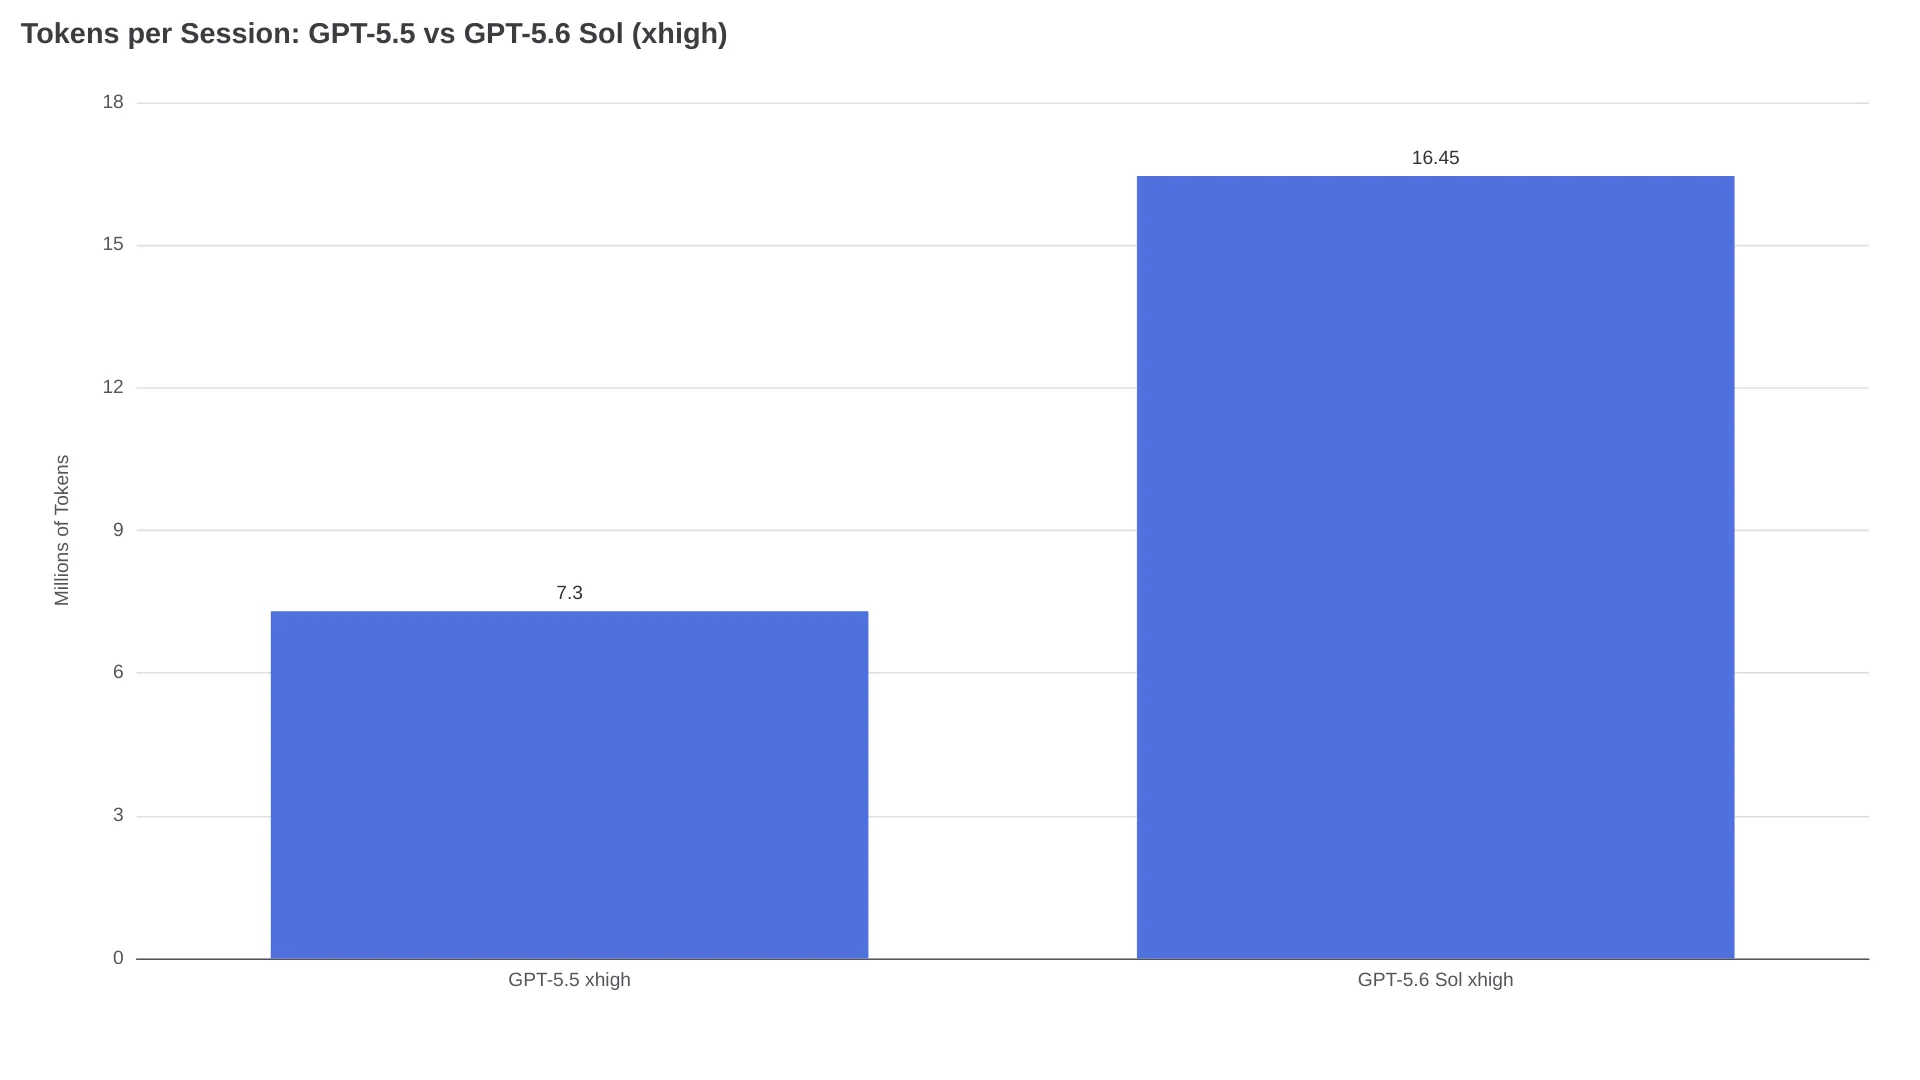
Auf der Preisseite von OpenAI kostet GPT-5.6 Sol $5/1M für Input und $30/1M für Output – genau wie GPT-5.5. Bei gleichem Satz bedeuten 2,25x so viele Tokens auch etwa 2,25x höhere Kosten je Aufgabe. Außerdem hat GPT-5.6 Sol einen Aufschlag für Cache-Schreibvorgänge eingeführt: das 1,25-Fache des Input-Preises. Bei GPT-5.5 gab es diesen Posten nicht.
„GPT 5.6 Sol ist ein Token-Ofen. Selbst Sol auf medium oder high scheint Tokens zu verschlingen. 5.6 wird nur für komplexe Planung oder knifflige Bugs eingesetzt.“ — r/codex-Nutzer
Schmalbachs drei Abonnements, die bei intensiver Arbeit früher eine Woche reichten, sind nun nach etwa einem Tag mittlerer Nutzung aufgebraucht.
Warum Sol mehr Tokens braucht
Gemessen pro Benchmark-Punkt arbeitet Sol effizienter als konkurrierende Modelle. Im Artificial Analysis Coding Agent Index erreicht es vergleichbare Werte mit weniger Output-Tokens als Claude Fable 5. In echten Sitzungen geht Sol jedoch aggressiver beim Reasoning vor: Es plant, geht Schritte zurück, validiert und prüft Alternativen. Der Preis dafür ist ein höherer Tokenverbrauch pro Aufgabe – auch wenn jeder einzelne Token nützlichere Arbeit leistet.
Gemeldeter Abrechnungsfehler bläht Output-Token-Zahlen auf
Neben dem real höheren Verbrauch scheint ein dokumentierter Abrechnungsfehler in der Responses API das Feld output_tokens aufzublähen – und genau dieses Feld dient als Grundlage für die Abrechnung. OpenAI untersucht den Vorgang, hat die Ursache aber öffentlich noch nicht bestätigt.
Ein Entwickler hat das Problem anhand von 710 GPT-5.6-Aufrufen und 22.922 Reasoning-Aufrufen insgesamt dokumentiert. GPT-5.6 ist die erste Modelfamilie, die pro Antwort mehrere reasoning-Elemente ausgibt: Bei Sol liegt der Median bei k=9, bei Terra bei k=4. Ein Akkumulator in der API addiert während der Generierung die laufende Reasoning-Summe einmal pro Reasoning-Element – zusätzlich zum korrekten Endwert.
Die Formel:
output_tokens ≈ R × (k + 3) / 2R steht für die tatsächlichen Reasoning-Tokens, k für die Zahl der Reasoning-Elemente. Bei Sol mit einem Median von k=9 wird der abgerechnete Wert damit ungefähr um das Sechsfache aufgebläht. Bei Terra mit k=4 sind es etwa 3,6x.
So zeigt sich der Fehler auf einer echten Rechnung
Das extremste dokumentierte Beispiel: Ein einzelner GPT-5.6-Terra-Aufruf lieferte die vier Zeichen lange Antwort d1d4, berechnet wurden jedoch 466.818 Output-Tokens – bei nur 21.064 tatsächlichen Reasoning-Tokens.
| Von der API gemeldet | Wert |
|---|---|
output_tokens (abgerechnet) | 466.818 |
reasoning_tokens (tatsächlich) | 21.064 |
| Sichtbarer Output | d1d4 (4 Zeichen) |
| Reasoning-Elemente (k) | 41 |
Bei k=41 ergibt die Formel R × (41+3)/2 = 21.064 × 22 = 463.408 – nur 0,7 % unter dem abgerechneten Betrag. Der Verfasser des Berichts prüfte dies anhand seines Abrechnungs-Dashboards: Die Summe der output_tokens aus der API, berechnet mit den veröffentlichten Preisen, reproduzierte die Dashboard-Kosten bis auf einen Zehntel-Cent. Über seine GPT-5.6-Aufrufe hinweg waren rund $284 von rund $320 berechnetem Betrag eine Überberechnung.
Der Fehler existiert schon vor GPT-5.6
Bei k=1 – einem Reasoning-Element, wie es Modelle vor 5.6 ausgeben – vereinfacht sich die Formel auf R × 4/2 = 2R: eine konstante Überberechnung um das Zweifache. Der Verfasser bestätigte das anhand von OpenAIs eigenem Nutzungs-Export für Mai 2026:
| Modell | Abgerechnete Output-Tokens | Tatsächliche Zahl | Verhältnis |
|---|---|---|---|
| o3-mini | 25.408.973 | 12.376.132 | 2,02x |
| gpt-5.4-nano | 11.718.610 | 5.844.140 | 2,00x |
| o1 | 778.989 | 335.944 | 2,01x |
| o4-mini (Kontrollwert) | 12.054.680 | 9.160.567 | 1,01x |
GPT-5.6 hat den Fehler also nicht eingeführt. Es ist lediglich das erste Modell, das Reasoning in viele Elemente aufteilt – und aus einer unauffälligen Überberechnung um das Zweifache einen deutlich größeren Multiplikator macht. Der Grund: Reasoning wird in Blöcken von etwa 512 Tokens ausgegeben, also k ≈ ceil(R/512). Setzt man dies in die Formel ein, erhält man output_tokens ≈ R²/1024 + 3R/2. Die Überberechnung wächst damit quadratisch mit der Länge des Reasonings: Doppelt so viel Nachdenken bedeutet ungefähr die vierfache Rechnung.
Zum Zeitpunkt der Veröffentlichung dieses Artikels, im August 2026, haben OpenAI-Mitarbeiter auf den Fehlerbericht reagiert und zusätzliche Daten angefordert. Eine Korrektur oder Anpassung der Abrechnung wurde jedoch öffentlich noch nicht bestätigt.
Aktuelle GPT-5.6-Preise nach der Senkung vom 30. Juli
Am 30. Juli 2026 hat OpenAI den Preis von Luna um 80 % und den von Terra um 20 % gesenkt. Die Preise für Sol blieben unverändert. Die aktuellen Sätze laut OpenAIs Preisseite:
| Modell | Input (kurz) | Input aus Cache | Cache-Schreibvorgänge | Output (kurz) | Output (lang) |
|---|---|---|---|---|---|
| GPT-5.6 Sol | $5.00 | $0.50 | $6.25 | $30.00 | $45.00 |
| GPT-5.6 Terra | $2.00 | $0.20 | $2.50 | $12.00 | $18.00 |
| GPT-5.6 Luna | $0.20 | $0.02 | $0.25 | $1.20 | $1.80 |
| GPT-5.5 | $5.00 | $0.50 | — | $30.00 | $45.00 |
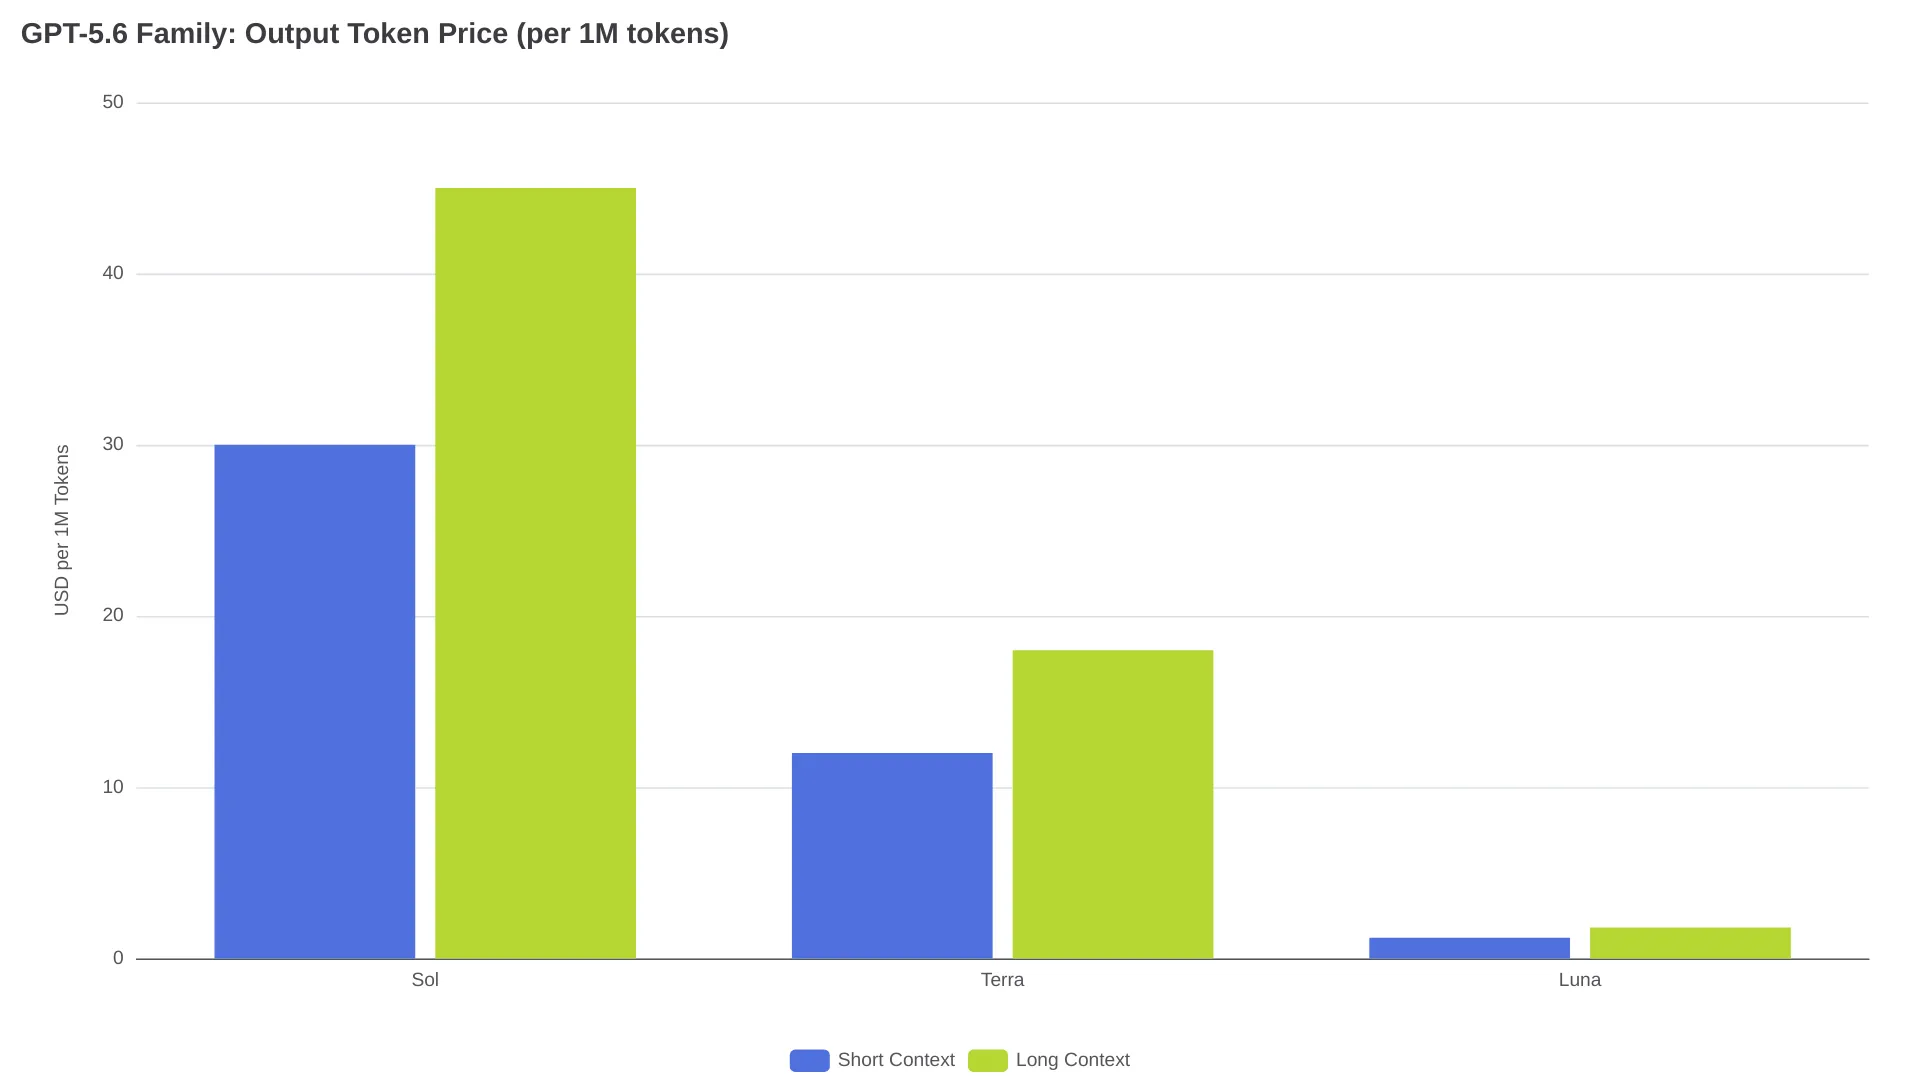
Sol kostet pro Token genauso viel wie GPT-5.5, benötigt pro Aufgabe aber 2,25x so viele Tokens. Effektiv verdoppeln sich die Kosten je Aufgabe damit ungefähr.
Cache-Schreibvorgänge sind ein neuer Kostenposten. GPT-5.6 berechnet dafür das 1,25-Fache des Input-Preises ($6.25/1M bei Sol). GPT-5.5 kannte keine Cache-Schreibgebühr. Bei Workloads mit niedriger Cache-Trefferquote kommt somit ein Aufschlag von 25 % auf die Input-Kosten hinzu, den es zuvor nicht gab.
Luna ist nun günstiger als GPT-5.4 nano. Mit $0.20/$1.20 gegenüber $0.20/$1.25 für nano ist Luna nach der Preissenkung das günstigste Modell in OpenAIs Angebot.
Drei Wege, Ihre GPT-5.6-Tokenrechnung zu senken
Für Routineaufgaben auf Terra wechseln
Terras Output-Preis liegt bei $12/1M und damit 60 % unter Sols $30/1M. Im Artificial Analysis Coding Agent Index liegt Terra knapp über Claude Fable 5. Nach der Preissenkung um 20 % im Juli ist Terra mit $2.00/$12.00 auch günstiger als der frühere GPT-5.5-Tarif.
Wann ist Sol weiterhin sinnvoll? Bei Debugging-Sitzungen mit vielen Schritten, Architekturplanung über große Codebasen hinweg und Sicherheitsanalysen. Solche Aufgaben profitieren von längeren Reasoning-Ketten. Für Standard-Coding, Analysen und Content-Erstellung liefert Terra vergleichbare Ergebnisse bei einem Bruchteil des Tokenverbrauchs.
Niedrigere Effort-Einstellungen wählen
Der Parameter reasoning.effort steuert, wie viele Reasoning-Tokens das Modell erzeugt. Der gemeldete Abrechnungsfehler skaliert direkt mit der Zahl der Reasoning-Elemente (k). Bei medium erzeugt Sol weniger dieser Elemente als bei xhigh; entsprechend sinkt auch die Aufblähung der Abrechnung.
„Ich nutze Terra Ultra, und der Tokenverbrauch scheint tatsächlich deutlich effizienter als bei GPT 5.5.“ — r/codex-Nutzer
Das Token-Ofen-Verhalten konzentriert sich auf Sol mit hohen Effort-Stufen. Statt xhigh oder max für reasoning.effort die Einstellung medium oder high zu wählen, ist die wirkungsvollste einzelne Änderung.
Cache-Treffer maximieren
GPT-5.6 führt explizite Cache-Breakpoints und eine Mindestlebensdauer des Caches von 30 Minuten ein. Cache-Lesevorgänge erhalten 90 % Rabatt und senken Sols Input-Kosten von $5.00 auf $0.50 pro 1M. Cache-Schreibvorgänge kosten dagegen das 1,25-Fache des Input-Preises ($6.25/1M bei Sol).
Strukturieren Sie Prompts so, dass Systemnachricht und statischer Kontext vor einem Cache-Breakpoint stehen. Ab wann sich das lohnt, hängt vom konkreten Workload ab: Der Aufschlag für das Schreiben beträgt 25 % des Input-Preises, während Lesevorgänge 90 % sparen. Sie benötigen also eine Trefferquote, bei der die Einsparungen beim Lesen den Schreibaufschlag übersteigen. Bei Workloads, deren Anfragen überwiegend einen langen gemeinsamen System-Prompt nutzen, kippt die Rechnung schnell zu Ihren Gunsten.
FAQ
Hat OpenAI den Abrechnungsfehler bestätigt?
Ein OpenAI-Mitarbeiter, Mark G., reagierte im Community-Forum auf den Bericht und bat am 12. Juli 2026 zur Untersuchung um Request-IDs und Zeitstempel. Bis August 2026 wurde weder ein Fix noch eine rückwirkende Anpassung der Abrechnung öffentlich bestätigt.
Wie prüfe ich, ob der Abrechnungsfehler mein Konto betrifft?
Addieren Sie bei jeder Antwort mit mehreren Reasoning-Elementen usage.output_tokens_details.reasoning_tokens und die sichtbaren Completion-Tokens. Übersteigt usage.output_tokens diese Summe um mehr als einige Prozent, betrifft Ihre Rechnung wahrscheinlich das im Forumsbericht dokumentierte kumulative erneute Summieren. Laden Sie Ihre Nutzungs-CSV aus dem OpenAI-Dashboard herunter und prüfen Sie die Werte je Modell.
Sollte ich von Sol auf Terra wechseln?
Für die meisten API-Workloads ist Terra günstiger und erzielt bei Coding-Benchmarks konkurrenzfähige Ergebnisse. Sol spielt seine Stärke bei den schwierigsten Aufgaben aus: OpenAIs eigene Benchmarks zeigen den größten Vorsprung von Sol gegenüber Terra bei mehrstufigem Reasoning und Sicherheitsforschung, wo längere Denkzeit den höchsten Nutzen bringt.