 AIREITER
Seit dem 30. Juli 2026 hat sich die Rechnung klar verschoben: OpenAI hat den API-Preis von GPT-5.6 Luna um rund 80 % gesenkt – von ursprünglich $1/$6 auf $0.20 Input / $1.20 Output pro einer Million Tokens. Damit kostet Luna etwa 73 % weniger als GPT-5.4 mini mit $0.75/$4.50, lieferte in unseren Coding- und Reasoning-Tests bei identischen Prompts aber gleichwertige Antworten. Einen Vorteil behält mini dennoch: Die Antworten kamen etwa doppelt so schnell. Für Anwendungen, bei denen Latenz die harte Vorgabe ist, bleibt das ältere kleine Modell daher die bessere Wahl.
Die Preissenkung vom 30. Juli dreht den Vergleich um
GPT-5.6 Luna wurde am 9. Juli 2026 allgemein verfügbar und startete bei $1/$6 pro Million Tokens. Innerhalb der GPT-5.6-Familie war es als kosteneffiziente Variante positioniert, lag damit aber immer noch deutlich über dem günstigen gpt-5.4-mini mit $0.75/$4.50. Knapp drei Wochen später, am 30. Juli, reduzierte OpenAI Lunas Preis um rund 80 % auf $0.20/$1.20 und senkte den Preis von GPT-5.6 Terra um etwa 20 % auf $2/$12. Luna bewegt sich damit nun in derselben Preisklasse wie gpt-5.4-nano ($0.20/$1.25): Nano-Preis, aber ein Modell der aktuellen Generation.
Falls Sie noch Preise von $1/$6 für Luna sehen: Dieser Einführungspreis galt nur bis zum 30. Juli 2026. Der aktuelle Standard-Tarif beträgt $0.20/$1.20 und wurde am 31. Juli 2026 verifiziert.
Luna und mini: Preise im direkten Vergleich
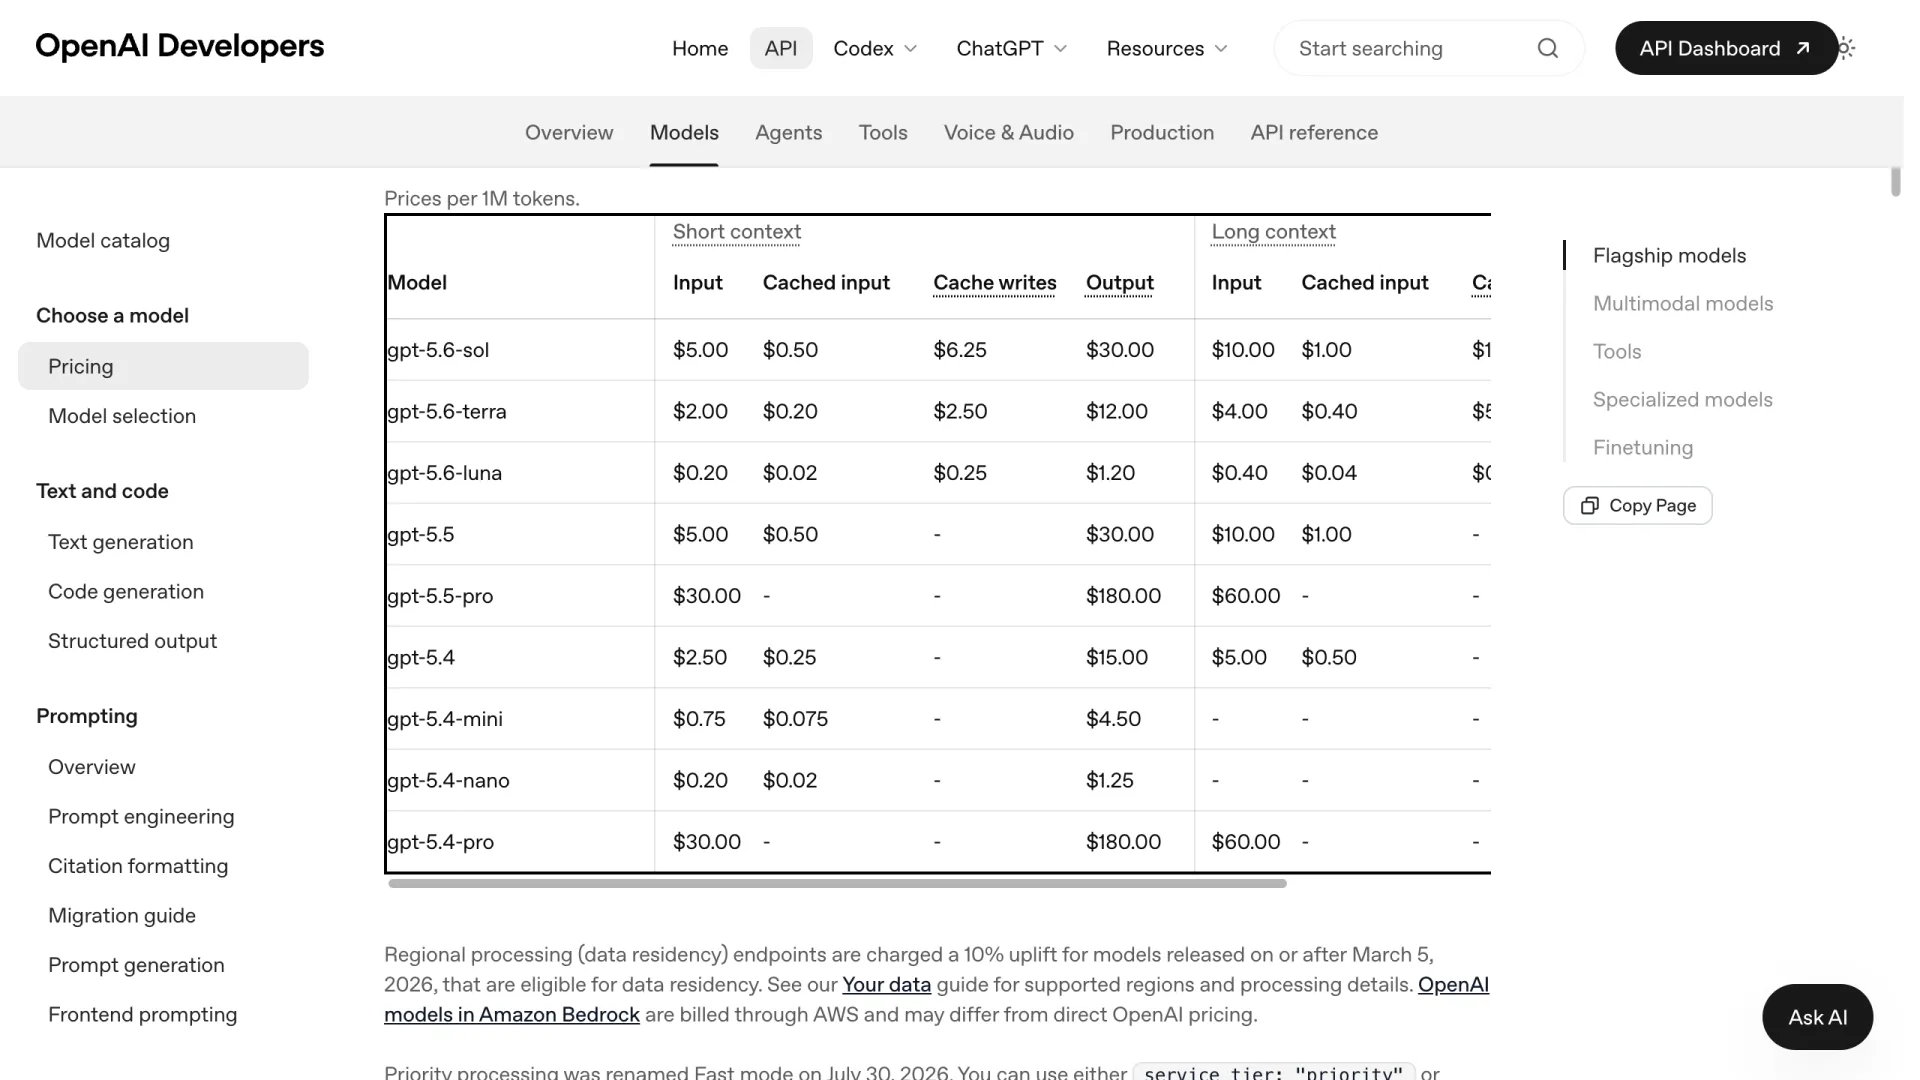
Zu den aktuellen Standard-Preisen ist Luna bei Input und Output günstiger als mini. Das gilt unabhängig davon, ob Ihre Prompts kurz oder lang sind. Außerdem bietet Luna ein Kontextfenster von 1.050K Tokens, während mini bei 400K liegt.
| Modell (Standard, pro 1 Mio. Tokens) | Input | Gecachter Input | Output | Kontext |
|---|---|---|---|---|
| gpt-5.6-luna (kurzer Kontext) | $0.20 | $0.02 | $1.20 | 1,050K |
| gpt-5.6-luna (langer Kontext, >200K) | $0.40 | $0.04 | $1.80 | 1,050K |
| gpt-5.4-mini | $0.75 | $0.075 | $4.50 | 400K |
Quelle: developers.openai.com/api/docs/pricing, verifiziert am 2026-07-31. Zum Vergleich: gpt-5.4-nano wird mit $0.20/$1.25 geführt – genau die Preiszone, in der Luna jetzt liegt.
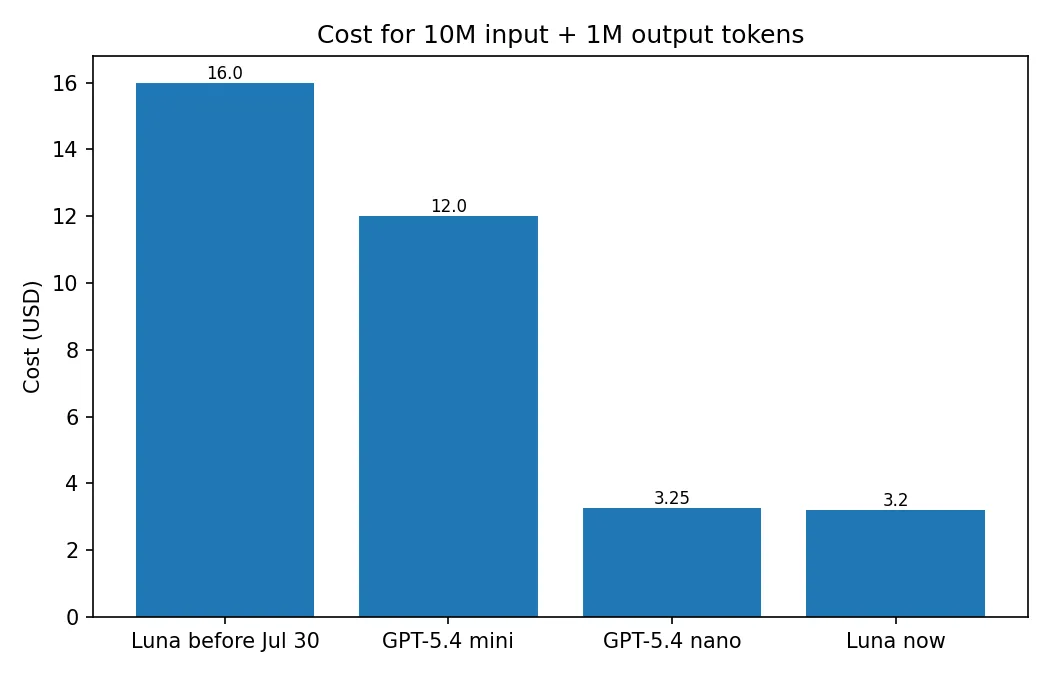
Bei einer moderaten Auslastung von 10M Input- plus 1M Output-Tokens kostet Luna $3.20, mini dagegen $12.00; nano liegt bei $3.25. Bei 1M plus 1M Tokens sind es $1.40 gegenüber $5.25. Oberhalb von 200K Input-Tokens verlangt Luna zwar den doppelten Tarif ($0.40/$1.80 für langen Kontext), bleibt aber auch dann unter minis einheitlichem Preis von $0.75/$4.50. mini kennt keine separate Langkontext-Stufe: Für sein 400K-Fenster gilt durchgehend der Kurzkontext-Tarif. Eine ausführlichere Aufschlüsselung der Preise innerhalb der Modellfamilie gibt es im GPT-5.6 pricing guide.
Identische Prompts: Qualität, Tokens und Tempo
Beide Modelle erhielten über denselben API-Endpunkt exakt dieselben Prompts: eine Coding-Aufgabe zur längsten gültigen Klammer-Teilzeichenfolge sowie eine Reasoning-Aufgabe mit dem Schnecken-im-Brunnen-Problem, das dreimal ausgeführt wurde. Beide lösten alle Aufgaben korrekt. Für das Klammerproblem lieferten sie denselben stackbasierten Ansatz, und beim Schneckenproblem lautete die Antwort in allen drei Durchgängen jeweils „28 Tage“. Die Unterschiede lagen nicht bei der Richtigkeit, sondern bei Geschwindigkeit und Ausführlichkeit.
Qualität und Korrektheit
Beim Coding-Prompt erzeugten Luna und mini funktional identische O(n)-Stack-Lösungen mit einem Sentinel-Basisindex; Fehler machte keines der beiden Modelle. Auch beim Reasoning-Prompt kamen beide korrekt auf 28 Tage und erklärten zutreffend, dass die Schnecke am 28. Tag entkommt, bevor sie wieder zurückrutschen kann. Bei diesen zwei einfachen Aufgaben liegen die Modelle praktisch gleichauf; anspruchsvolleres Reasoning haben wir nicht belastbar getestet.
Geschwindigkeit und Latenz
mini war Ende-zu-Ende etwa doppelt so schnell. Über drei Reasoning-Durchläufe lag minis Durchschnitt bei ~2.8s, Luna benötigte ~5.5s. Beim einzelnen Coding-Lauf brauchte mini 4.0s gegenüber 4.6s für Luna. Die längere Laufzeit von Luna passt zu den ausführlicheren Antworten: 168 Tokens beim Reasoning-Prompt gegenüber 76 Tokens bei mini. Luna priorisiert Vollständigkeit statt einer besonders schnellen Antwort.
„Es ist im Grunde so schnell wie 5.4 mini bei medium thinking und argumentiert wirklich gut, auf einem Niveau über 5.4.“ — r/codex, Thread „GPT-5.6 Luna is really underrated“
Mit den Standardeinstellungen ist mini die schnellere Option.
Kosten pro Aufgabe
Die ausführlicheren Antworten von Luna werden durch den niedrigeren Tokenpreis mehr als ausgeglichen. Beim Reasoning-Prompt erzeugte Luna durchschnittlich 168 Output-Tokens, mini 76. Zu den aktuellen Preisen kostete die Antwort mit Luna dennoch nur rund $0.001, gegenüber $0.004 bei mini. Das sind Werte unter einem Cent aus einer kleinen Stichprobe (ausgeführt am 2026-07-31 über die AIReiter API mit gpt-5.6-luna und gpt-5.4-mini, Standardaufwand, US-Endpunkt; gemessen wurden die vollständige Wall-Clock-Antwortzeit und die von der API gemeldeten Completion-Tokens). Sie sind daher als Tendenz und nicht als Benchmark zu verstehen. Die Richtung ist allerdings eindeutig: Pro korrekter Antwort ist Luna günstiger.
Warum der Streit um das „intelligentere“ Modell meist an den Einstellungen scheitert
In den reinen Scorecard-Werten schlägt Luna mini bei Coding und Reasoning: SWE-Bench Pro 62.7 gegenüber 54.4, GPQA Diamond 92.3 gegenüber 88.0 und Toolathlon 53.4 gegenüber 42.9. Die Werte stammen aus OpenAIs Model Scorecards. Das oft zitierte Ergebnis, das das Bild umdreht, kommt vom Artificial Analysis Intelligence Index: Dort erreicht GPT-5.4 einen Wert von 51, Luna dagegen 46. Der Vergleich setzt Luna jedoch mit hohem Aufwand gegen GPT-5.4 mit xhigh Aufwand. Damit steht auf beiden Seiten ein unterschiedliches Reasoning-Budget – kein fairer Direktvergleich.
| Benchmark | GPT-5.6 Luna | GPT-5.4 mini | Hinweis |
|---|---|---|---|
| SWE-Bench Pro | 62.7 | 54.4 | Luna höher |
| GPQA Diamond | 92.3 | 88.0 | Luna höher |
| MMMU Pro | 78.4 | 76.6 | Knapp |
| Toolathlon | 53.4 | 42.9 | Luna höher |
| Terminal-Bench | 84.7 (v2.1) | 60.0 (v2.0) | Unterschiedliche Versionen |
| OSWorld | 45.6 (v2.0) | 72.1 (Verified) | Unterschiedliche Protokolle |
Werte aus den veröffentlichten Model Scorecards von OpenAI, gegengeprüft mit docsbot.ai.
Beim Lesen dieser Werte sind zwei Einschränkungen wichtig. Erstens die Aufwandsstufe: mini bietet die fein abgestuften Optionen None / Low / Medium / High / XHigh, während Luna standardmäßig auf einer hohen Reasoning-Stufe arbeitet. Wird mini auf xhigh gestellt und mit Luna in der Standardeinstellung verglichen, verbessert das minis Schlagzeilenwert künstlich. Zweitens sind nicht alle Zeilen streng vergleichbar. docsbot.ai weist darauf hin, dass die Zahlen für Terminal-Bench und OSWorld unterschiedliche Benchmark-Versionen und Protokolle kombinieren. Daher kann minis OSWorld-Wert von 72.1 höher wirken als Lunas 45.6, obwohl jeweils leicht unterschiedliche Dinge getestet werden.
Abseits der Scores hat Luna einen Wissens-Cutoff von Februar 2026, mini dagegen von August 2025. Dazu kommt bei Luna ein Kontextfenster von 1.05M statt 400K Tokens.
Der Thread „Luna kostet 96 % mehr“ ist überholt
Ein viel geteilter Test aus der OpenAI-Community kam zu dem Ergebnis, Luna koste pro Unterhaltung mit sechs Turns 96 % mehr als mini. Die Zahl war korrekt, stammt aber aus der Zeit vor der Preissenkung: Gemessen wurde am 11. Juli zu Lunas Einführungspreis von $1/$6. Der größte Teil des Unterschieds lag zudem nicht am Modell, sondern an einem Fehler bei der Cache-Invalidierung in der Test-App. Nachdem der Autor die übergeordneten Instruktionen nicht mehr in jedem Turn veränderte, sank Lunas Aufpreis auf 16.7 %. Gleichzeitig war Luna 9.9 % schneller und erzielte bei der Blindbewertung einen höheren Qualitätswert (4.80 gegenüber 4.28).
Zum aktuellen Preis von $0.20/$1.20 ist Luna schon ohne Caching günstiger als mini. Das Cache-Argument entscheidet den Vergleich zwischen Luna und mini daher nicht mehr. Für die Kostenoptimierung bleibt der Mechanismus aber relevant: OpenAI berechnet Cache-Schreibvorgänge mit dem 1.25-Fachen des Input-Preises ($0.25/M für Luna aktuell), während Cache-Lesezugriffe 90 % günstiger sind. Die Mindestlaufzeit eines Cache beträgt 30 Minuten. Schreibt Ihre Anwendung den System-Prompt bei jedem Turn neu, wird das Cache-Präfix ungültig und statt des Lese- der Schreibpreis fällig. Genau diese Falle erzeugte die 96-%-Zahl.
Welches Modell Sie einsetzen sollten
Für die meisten Workloads lautet die Antwort jetzt Luna: Es ist in beiden Kontextstufen günstiger, bei der Qualität mindestens gleichauf oder besser, hat einen neueren Wissens-Cutoff und ein 2.6× größeres Kontextfenster. Zu mini sollten Sie greifen, wenn Latenz die entscheidende Vorgabe ist oder wenn Sie eine fein abgestufte Aufwandseinstellung brauchen, die Luna nicht bietet.
| Wenn Sie wollen … | Wahl | Warum |
|---|---|---|
| Niedrigste Kosten pro korrekter Antwort | Luna | $0.20/$1.20, ~73 % unter mini |
| Niedrigste Latenz | mini | Ende-zu-Ende ~2× schneller (~2.8s vs. ~5.5s beim Reasoning) |
| Feingranulare None/XHigh-Aufwandssteuerung | mini | Luna ist nur in der High-Stufe verfügbar |
| Prompts mit mehr als 400K Tokens | Luna | 1.05M-Fenster; mini endet bei 400K |
| Möglichst knappe Antworten | mini | Bei identischen Aufgaben etwa halb so viele Tokens |
Praktisch bietet sich eine Aufteilung an: mini als Standardmodell dort, wo sein Latenzvorteil zählt, Luna als Eskalations- und Langkontextmodell, wenn Qualität und Kontextfenster wichtiger sind. Beide lassen sich über eine einheitliche API als gpt-5.6-luna und gpt-5.4-mini aufrufen, beispielsweise über den AIReiter GPT-5.6 Luna endpoint. Ein Routing-Fallstrick: Das Flaggschiff Sol kostet $5/$30, also etwa das 25-Fache von Luna. Falls Ihr Endpunkt eine bloße gpt-5.6-ID auf Sol abbildet, sollten Sie die vollständige ID gpt-5.6-luna fest angeben.
FAQ
Ist GPT-5.6 Luna günstiger als GPT-5.4 mini?
Ja, bei den aktuellen Preisen rund 73 % günstiger. Seit der Senkung vom 30. Juli 2026 kostet Luna $0.20 Input / $1.20 Output pro Million Tokens, mini dagegen $0.75 / $4.50. Das gilt für Input wie Output.
Ist GPT-5.6 Luna schneller oder langsamer als 5.4 mini?
Langsamer, in unserem Test mit identischen Prompts ungefähr um den Faktor 2. mini lag beim Reasoning im Schnitt bei ~2.8s, Luna bei ~5.5s. Luna tauscht Tempo gegen ausführlicheres Reasoning; bei geringerem Aufwand wird der Abstand kleiner.
Ersetzt GPT-5.6 Luna die mini-Klasse?
Nein. Luna ist die kosteneffiziente Stufe innerhalb der GPT-5.6-Generation; gpt-5.4-mini ist ein separates, älteres kleines Modell, das weiterhin angeboten und unterstützt wird.
GPT-5.4 nano vs. Luna: Welches Modell ist günstiger?
Praktisch Gleichstand. Luna kostet $0.20/$1.20, nano $0.20/$1.25. Luna ist beim Output minimal günstiger, eine Generation neuer und hat einen späteren Wissens-Cutoff.
Wann wurden Luna und mini veröffentlicht?
Luna startete am 9. Juli 2026 und erhielt am 30. Juli 2026 den aktuellen Preis. GPT-5.4 mini wurde am 17. März 2026 veröffentlicht.
Quellen
- Aktuelle Preise, verifiziert am 2026-07-31: developers.openai.com/api/docs/pricing
- GPT-5.6-Start, Modellstufen und Regeln für Cache-Schreibvorgänge: openai.com/index/gpt-5-6/
- Kontrollierter Multi-Turn-Kostentest vor der Preissenkung: community.openai.com
- Benchmark- und Capability-Aggregate: artificialanalysis.ai, docsbot.ai